# t01 KI-Journal › KI-Praxis für Entscheider und Praktiker
> KI-Praxis und kein Hype. Prompt Engineering, Automatisierung. Ohne Jubel, dafür meine Erfahrung und Meinung.
Public Ghost content for AI and LLM tooling. This file includes a bounded export of public pages first, then recent public posts.
Append `.md` to any post or page URL to get the content in Markdown (for example, `/example-post.md`).
## Pages
### Praktiker. Kein Evangelist. Und warum das hier existiert.
URL: https://t01.li/ueber-t01/
Last updated: 2026-07-29T19:32:59.000Z
Ich bin Tobias Glawe und 2012 bin ich in den Online-Marketing-Topf gefallen – E-Commerce, Performance-Marketing, SEO. Irgendwann kam KI dazu. Nicht weil ich dachte, das wird groß. Sondern weil es meine Arbeit leise und stetig verändert hat.
Heute arbeite ich bei [klartxt](https://klartxt.de/?ref=t01.li) mit einem immer größer werdenden Fokus auf Prompt- und Context-Engineering, KI-Agenten und die Automatisierung von Agenturprozessen. Was ich dort täglich anwende, landet hier – ungefiltert, mit Meinung, ohne Verkaufsabsicht.
## Was ich konkret tue
Kein Demo-Niveau. Ich meine: echte Projekte, echte Prozesse.
Beispiel: Für einen Automobilhändler im Premium-Segment haben wir eine komplette Website-Strategie mit generativer KI entwickelt und umgesetzt – Personas, Zielgruppenanalyse, Tonalität, Content-Planung, SEO- und GEO-Struktur. Alles in einem durchgängigen Workflow, nicht als Einzelmaßnahmen. Das Ergebnis ist live. Und es funktioniert.
Die Grundlage dafür war kein KI-Tool das auf einen Knopfdruck eine Website ausspuckt – sondern ein strukturierter Prozess in dem KI an den richtigen Stellen die richtige Arbeit übernimmt. Das ist der Unterschied zwischen KI ausprobieren und KI implementieren. Genau darum geht es mir hier.
Wo ich konkrete Projekte erwähne, sind Namen und Details anonymisiert – nicht weil die Ergebnisse nicht für sich sprechen, sondern weil Diskretion zur Arbeit dazugehört. Was ich schreibe, kommt trotzdem aus echten Prozessen, nicht aus der Theorie.
Ein Teil dessen, was hier erscheint – die wöchentlichen Picks, Einschätzungen zu Tools und Modellen – ist schlicht das, was ich ohnehin verfolge. Wer in Agenturen und KMU-Projekten täglich mit KI arbeitet, entwickelt ein Gespür dafür, was relevant ist und was Lärm. Das teile ich hier.
## Wofür dieser Blog steht
t01.li ist kein Nachrichtenkanal und kein Tutorial-Friedhof. Es ist ein Arbeitsjournal – für Menschen, die wissen wollen, was generative KI im echten Einsatz taugt, was maßlos überschätzt wird, und wo die Grenze zwischen Versprechen und Realität liegt.
Ich schreibe für zwei Lesende: den Entscheidern, die wissen möchten, ob und wie KI ihre Prozesse verändert – und die Praktiker, die wissen wollen, wie genau. Manchmal im selben Artikel.
Was du hier nicht findest: Jubelmeldungen über neue Modelle und unreflektierte Hype-Übernahme.
### Du möchtest ein Wort mit mir wechseln
Wenn du generative KI in deinem Unternehmen oder deiner Agentur einführen willst – und jemanden suchst, der das aus der Praxis kennt und nicht mit einer PowerPoint-Folie über „Transformationspotenziale“ glänzen möchte: [LinkedIn](https://www.linkedin.com/in/tglawe/?ref=t01.li) oder per [Mail](mailto:tobias@t01.li) sind der direkteste Weg.
Kommentare sind offen – eine kurze Registrierung – 10 Sekunden – ist dafür nötig. Danach: kein Passwort, kein Aufwand. Widerspruch ausdrücklich willkommen.
## Wochenrückblick abonnieren
Jeden Montag – die KI-Woche eingeordnet: Was generative KI in echten Projekten taugt, was maßlos überschätzt wird und wo Versprechen auf Realität trifft.
Abonnieren
Email sent! Check your inbox to complete your signup.
Kein Spam. Abmeldung jederzeit möglich.
### Impressum
URL: https://t01.li/impressum/
Last updated: 2026-07-16T15:11:25.000Z
## Diensteanbieter
Tobias Glawe
Im Mitteldorf 15
30938 Burgwedel
Deutschland
### Kontaktmöglichkeiten
E-Mail-Adresse: info@t01.li
Telefon: +49 152 27313075
### Journalistisch-redaktionelle Angebote
Inhaltlich verantwortlich: Tobias Glawe
### Social Media und andere Onlinepräsenzen
Dieses Impressum gilt auch für die folgenden Social-Media-Präsenzen und Onlineprofile:
- [https://www.linkedin.com/in/tglawe/](https://www.linkedin.com/in/tglawe/?ref=t01.li)
- [https://x.com/abbottis\_](https://x.com/abbottis%5F?ref=t01.li)
- [https://bsky.app/profile/hello.t01.li.ap.brid.gy](https://bsky.app/profile/hello.t01.li.ap.brid.gy?ref=t01.li)
- [https://bsky.app/profile/abbottis.bsky.social](https://bsky.app/profile/abbottis.bsky.social?ref=t01.li)
[Erstellt mit kostenlosem Datenschutz-Generator.de von Dr. Thomas Schwenke](https://datenschutz-generator.de/?ref=t01.li)
### Datenschutzerklärung
URL: https://t01.li/datenschutz/
Last updated: 2026-05-19T19:16:38.000Z
## Präambel
Mit der folgenden Datenschutzerklärung möchte ich Sie darüber aufklären, welche Arten Ihrer personenbezogenen Daten (nachfolgend auch kurz als "Daten" bezeichnet) ich zu welchen Zwecken und in welchem Umfang verarbeite. Die Datenschutzerklärung gilt für alle von mir durchgeführten Verarbeitungen personenbezogener Daten, sowohl im Rahmen der Erbringung meiner Leistungen als auch insbesondere auf meinen Webseiten, in mobilen Applikationen sowie innerhalb externer Onlinepräsenzen, wie z. B. meiner Social-Media-Profile (nachfolgend zusammenfassend bezeichnet als "Onlineangebot").
Die verwendeten Begriffe sind nicht geschlechtsspezifisch.
Stand: 28\. April 2026
## Verantwortlicher
Tobias Glawe
Im Mitteldorf 15
30938 Burgwedel
E-Mail-Adresse: [info@t01.li](mailto:info@t01.li)
Impressum:
## Übersicht der Verarbeitungen
Die nachfolgende Übersicht fasst die Arten der verarbeiteten Daten und die Zwecke ihrer Verarbeitung zusammen und verweist auf die betroffenen Personen.
### Arten der verarbeiteten Daten
- Bestandsdaten.
- Kontaktdaten.
- Inhaltsdaten.
- Nutzungsdaten.
- Meta-, Kommunikations- und Verfahrensdaten.
- Protokolldaten.
### Kategorien betroffener Personen
- Nutzer.
### Zwecke der Verarbeitung
- Erbringung vertraglicher Leistungen und Erfüllung vertraglicher Pflichten.
- Kommunikation.
- Sicherheitsmaßnahmen.
- Reichweitenmessung.
- Organisations- und Verwaltungsverfahren.
- Feedback.
- Bereitstellung meines Onlineangebotes und Nutzerfreundlichkeit.
- Informationstechnische Infrastruktur.
- Direktkommunikation (Newsletter).
- Öffentlichkeitsarbeit und Informationszwecke.
## Maßgebliche Rechtsgrundlagen
**Maßgebliche Rechtsgrundlagen nach der DSGVO:** Im Folgenden erhalten Sie eine Übersicht der Rechtsgrundlagen der DSGVO, auf deren Basis ich personenbezogene Daten verarbeite. Bitte nehmen Sie zur Kenntnis, dass neben den Regelungen der DSGVO nationale Datenschutzvorgaben in Ihrem bzw. meinem Wohn- oder Sitzland gelten können. Sollten ferner im Einzelfall speziellere Rechtsgrundlagen maßgeblich sein, teile ich Ihnen diese in der Datenschutzerklärung mit.
- **Einwilligung (Art. 6 Abs. 1 S. 1 lit. a) DSGVO)** \- Die betroffene Person hat ihre Einwilligung in die Verarbeitung der sie betreffenden personenbezogenen Daten für einen spezifischen Zweck oder mehrere bestimmte Zwecke gegeben.
- **Vertragserfüllung und vorvertragliche Anfragen (Art. 6 Abs. 1 S. 1 lit. b) DSGVO)** \- Die Verarbeitung ist für die Erfüllung eines Vertrags, dessen Vertragspartei die betroffene Person ist, oder zur Durchführung vorvertraglicher Maßnahmen erforderlich, die auf Anfrage der betroffenen Person erfolgen.
- **Rechtliche Verpflichtung (Art. 6 Abs. 1 S. 1 lit. c) DSGVO)** \- Die Verarbeitung ist zur Erfüllung einer rechtlichen Verpflichtung erforderlich, der der Verantwortliche unterliegt.
- **Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO)** \- die Verarbeitung ist zur Wahrung der berechtigten Interessen des Verantwortlichen oder eines Dritten notwendig, vorausgesetzt, dass die Interessen, Grundrechte und Grundfreiheiten der betroffenen Person, die den Schutz personenbezogener Daten verlangen, nicht überwiegen.
**Nationale Datenschutzregelungen in Deutschland:** Zusätzlich zu den Datenschutzregelungen der DSGVO gelten nationale Regelungen zum Datenschutz in Deutschland. Hierzu gehört insbesondere das Gesetz zum Schutz vor Missbrauch personenbezogener Daten bei der Datenverarbeitung (Bundesdatenschutzgesetz – BDSG). Das BDSG enthält insbesondere Spezialregelungen zum Recht auf Auskunft, zum Recht auf Löschung, zum Widerspruchsrecht, zur Verarbeitung besonderer Kategorien personenbezogener Daten, zur Verarbeitung für andere Zwecke und zur Übermittlung sowie automatisierten Entscheidungsfindung im Einzelfall einschließlich Profiling. Ferner können Landesdatenschutzgesetze der einzelnen Bundesländer zur Anwendung gelangen.
## Sicherheitsmaßnahmen
Ich treffe nach Maßgabe der gesetzlichen Vorgaben unter Berücksichtigung des Stands der Technik, der Implementierungskosten und der Art, des Umfangs, der Umstände und der Zwecke der Verarbeitung sowie der unterschiedlichen Eintrittswahrscheinlichkeiten und des Ausmaßes der Bedrohung der Rechte und Freiheiten natürlicher Personen geeignete technische und organisatorische Maßnahmen, um ein dem Risiko angemessenes Schutzniveau zu gewährleisten.
Zu den Maßnahmen gehören insbesondere die Sicherung der Vertraulichkeit, Integrität und Verfügbarkeit von Daten durch Kontrolle des physischen und elektronischen Zugangs zu den Daten als auch des sie betreffenden Zugriffs, der Eingabe, der Weitergabe, der Sicherung der Verfügbarkeit und ihrer Trennung. Des Weiteren habe ich Verfahren eingerichtet, die eine Wahrnehmung von Betroffenenrechten, die Löschung von Daten und Reaktionen auf die Gefährdung der Daten gewährleisten. Ferner berücksichtige ich den Schutz personenbezogener Daten bereits bei der Entwicklung bzw. Auswahl von Hardware, Software sowie Verfahren entsprechend dem Prinzip des Datenschutzes, durch Technikgestaltung und durch datenschutzfreundliche Voreinstellungen.
Sicherung von Online-Verbindungen durch TLS-/SSL-Verschlüsselungstechnologie (HTTPS): Um die Daten der Nutzer, die über meine Online-Dienste übertragen werden, vor unerlaubten Zugriffen zu schützen, setze ich auf die TLS-/SSL-Verschlüsselungstechnologie. Secure Sockets Layer (SSL) und Transport Layer Security (TLS) sind die Eckpfeiler der sicheren Datenübertragung im Internet. Diese Technologien verschlüsseln die Informationen, die zwischen der Website oder App und dem Browser des Nutzers (oder zwischen zwei Servern) übertragen werden, wodurch die Daten vor unbefugtem Zugriff geschützt sind. TLS, als die weiterentwickelte und sicherere Version von SSL, gewährleistet, dass alle Datenübertragungen den höchsten Sicherheitsstandards entsprechen. Wenn eine Website durch ein SSL-/TLS-Zertifikat gesichert ist, wird dies durch die Anzeige von HTTPS in der URL signalisiert. Dies dient als ein Indikator für die Nutzer, dass ihre Daten sicher und verschlüsselt übertragen werden.
## Übermittlung von personenbezogenen Daten
Im Rahmen meiner Verarbeitung von personenbezogenen Daten kommt es vor, dass diese an andere Stellen, Unternehmen, rechtlich selbstständige Organisationseinheiten oder Personen übermittelt beziehungsweise ihnen gegenüber offengelegt werden. Zu den Empfängern dieser Daten können z. B. mit IT-Aufgaben beauftragte Dienstleister gehören oder Anbieter von Diensten und Inhalten, die in eine Website eingebunden sind. In solchen Fällen beachte ich die gesetzlichen Vorgaben und schließe insbesondere entsprechende Verträge bzw. Vereinbarungen, die dem Schutz Ihrer Daten dienen, mit den Empfängern Ihrer Daten ab.
## Allgemeine Informationen zur Datenspeicherung und Löschung
Ich lösche personenbezogene Daten, die ich verarbeite, gemäß den gesetzlichen Bestimmungen, sobald die zugrundeliegenden Einwilligungen widerrufen werden oder keine weiteren rechtlichen Grundlagen für die Verarbeitung bestehen. Dies betrifft Fälle, in denen der ursprüngliche Verarbeitungszweck entfällt oder die Daten nicht mehr benötigt werden. Ausnahmen von dieser Regelung bestehen, wenn gesetzliche Pflichten oder besondere Interessen eine längere Aufbewahrung oder Archivierung der Daten erfordern.
Insbesondere müssen Daten, die aus handels- oder steuerrechtlichen Gründen aufbewahrt werden müssen oder deren Speicherung notwendig ist zur Rechtsverfolgung oder zum Schutz der Rechte anderer natürlicher oder juristischer Personen, entsprechend archiviert werden.
Unsere Datenschutzhinweise enthalten zusätzliche Informationen zur Aufbewahrung und Löschung von Daten, die speziell für bestimmte Verarbeitungsprozesse gelten.
Bei mehreren Angaben zur Aufbewahrungsdauer oder Löschungsfristen eines Datums, ist stets die längste Frist maßgeblich. Daten, die nicht mehr für den ursprünglich vorgesehenen Zweck, sondern aufgrund gesetzlicher Vorgaben oder anderer Gründe aufbewahrt werden, verarbeite ich ausschließlich zu den Gründen, die ihre Aufbewahrung rechtfertigen.
Aufbewahrung und Löschung von Daten: Die folgenden allgemeinen Fristen gelten für die Aufbewahrung und Archivierung nach deutschem Recht:
- 10 Jahre - Aufbewahrungsfrist für Bücher und Aufzeichnungen, Jahresabschlüsse, Inventare, Lageberichte, Eröffnungsbilanz sowie die zu ihrem Verständnis erforderlichen Arbeitsanweisungen und sonstigen Organisationsunterlagen (§ 147 Abs. 1 Nr. 1 i.V.m. Abs. 3 AO, § 14b Abs. 1 UStG, § 257 Abs. 1 Nr. 1 i.V.m. Abs. 4 HGB).
- 8 Jahre - Buchungsbelege, wie z. B. Rechnungen und Kostenbelege (§ 147 Abs. 1 Nr. 4 und 4a i.V.m. Abs. 3 Satz 1 AO sowie § 257 Abs. 1 Nr. 4 i.V.m. Abs. 4 HGB).
- 6 Jahre - Übrige Geschäftsunterlagen: empfangene Handels- oder Geschäftsbriefe, Wiedergaben der abgesandten Handels- oder Geschäftsbriefe, sonstige Unterlagen, soweit sie für die Besteuerung von Bedeutung sind, z. B. Stundenlohnzettel, Betriebsabrechnungsbögen, Kalkulationsunterlagen, Preisauszeichnungen, aber auch Lohnabrechnungsunterlagen, soweit sie nicht bereits Buchungsbelege sind und Kassenstreifen (§ 147 Abs. 1 Nr. 2, 3, 5 i.V.m. Abs. 3 AO, § 257 Abs. 1 Nr. 2 u. 3 i.V.m. Abs. 4 HGB).
- 3 Jahre - Daten, die erforderlich sind, um potenzielle Gewährleistungs- und Schadensersatzansprüche oder ähnliche vertragliche Ansprüche und Rechte zu berücksichtigen sowie damit verbundene Anfragen zu bearbeiten, basierend auf früheren Geschäftserfahrungen und üblichen Branchenpraktiken, werden für die Dauer der regulären gesetzlichen Verjährungsfrist von drei Jahren gespeichert (§§ 195, 199 BGB).
Fristbeginn mit Ablauf des Jahres: Beginnt eine Frist nicht ausdrücklich zu einem bestimmten Datum und beträgt sie mindestens ein Jahr, so startet sie automatisch am Ende des Kalenderjahres, in dem das fristauslösende Ereignis eingetreten ist. Im Fall laufender Vertragsverhältnisse, in deren Rahmen Daten gespeichert werden, ist das fristauslösende Ereignis der Zeitpunkt des Wirksamwerdens der Kündigung oder sonstige Beendigung des Rechtsverhältnisses.
## Rechte der betroffenen Personen
Rechte der betroffenen Personen aus der DSGVO: Ihnen stehen als Betroffene nach der DSGVO verschiedene Rechte zu, die sich insbesondere aus Art. 15 bis 21 DSGVO ergeben:
- **Widerspruchsrecht: Sie haben das Recht, aus Gründen, die sich aus Ihrer besonderen Situation ergeben, jederzeit gegen die Verarbeitung der Sie betreffenden personenbezogenen Daten, die aufgrund von Art. 6 Abs. 1 lit. e oder f DSGVO erfolgt, Widerspruch einzulegen; dies gilt auch für ein auf diese Bestimmungen gestütztes Profiling. Werden die Sie betreffenden personenbezogenen Daten verarbeitet, um Direktwerbung zu betreiben, haben Sie das Recht, jederzeit Widerspruch gegen die Verarbeitung der Sie betreffenden personenbezogenen Daten zum Zwecke derartiger Werbung einzulegen; dies gilt auch für das Profiling, soweit es mit solcher Direktwerbung in Verbindung steht.**
- **Widerrufsrecht bei Einwilligungen:** Sie haben das Recht, erteilte Einwilligungen jederzeit zu widerrufen.
- **Auskunftsrecht:** Sie haben das Recht, eine Bestätigung darüber zu verlangen, ob betreffende Daten verarbeitet werden und auf Auskunft über diese Daten sowie auf weitere Informationen und Kopie der Daten entsprechend den gesetzlichen Vorgaben.
- **Recht auf Berichtigung:** Sie haben entsprechend den gesetzlichen Vorgaben das Recht, die Vervollständigung der Sie betreffenden Daten oder die Berichtigung der Sie betreffenden unrichtigen Daten zu verlangen.
- **Recht auf Löschung und Einschränkung der Verarbeitung:** Sie haben nach Maßgabe der gesetzlichen Vorgaben das Recht, zu verlangen, dass Sie betreffende Daten unverzüglich gelöscht werden, bzw. alternativ nach Maßgabe der gesetzlichen Vorgaben eine Einschränkung der Verarbeitung der Daten zu verlangen.
- **Recht auf Datenübertragbarkeit:** Sie haben das Recht, Sie betreffende Daten, die Sie mir bereitgestellt haben, nach Maßgabe der gesetzlichen Vorgaben in einem strukturierten, gängigen und maschinenlesbaren Format zu erhalten oder deren Übermittlung an einen anderen Verantwortlichen zu fordern.
- **Beschwerde bei Aufsichtsbehörde:** Sie haben unbeschadet eines anderweitigen verwaltungsrechtlichen oder gerichtlichen Rechtsbehelfs das Recht auf Beschwerde bei einer Aufsichtsbehörde, insbesondere in dem Mitgliedstaat ihres gewöhnlichen Aufenthaltsorts, ihres Arbeitsplatzes oder des Orts des mutmaßlichen Verstoßes, wenn Sie der Ansicht sind, dass die Verarbeitung der Sie betreffenden personenbezogenen Daten gegen die Vorgaben der DSGVO verstößt.
## Bereitstellung des Onlineangebots und Webhosting
Ich verarbeite die Daten der Nutzer, um ihnen meine Online-Dienste zur Verfügung stellen zu können. Zu diesem Zweck verarbeite ich die IP-Adresse des Nutzers, die notwendig ist, um die Inhalte und Funktionen meiner Online-Dienste an den Browser oder das Endgerät der Nutzer zu übermitteln.
- **Verarbeitete Datenarten:** Nutzungsdaten (z. B. Seitenaufrufe und Verweildauer, Klickpfade, Nutzungsintensität und -frequenz, verwendete Gerätetypen und Betriebssysteme, Interaktionen mit Inhalten und Funktionen); Meta-, Kommunikations- und Verfahrensdaten (z. B. IP-Adressen, Zeitangaben, Identifikationsnummern, beteiligte Personen). Protokolldaten (z. B. Logfiles betreffend Logins oder den Abruf von Daten oder Zugriffszeiten.).
- **Betroffene Personen:** Nutzer (z. B. Webseitenbesucher, Nutzer von Onlinediensten).
- **Zwecke der Verarbeitung und berechtigte Interessen:** Bereitstellung meines Onlineangebotes und Nutzerfreundlichkeit; Informationstechnische Infrastruktur (Betrieb und Bereitstellung von Informationssystemen und technischen Geräten (Computer, Server etc.)). Sicherheitsmaßnahmen.
- **Aufbewahrung und Löschung:** Löschung entsprechend Angaben im Abschnitt "Allgemeine Informationen zur Datenspeicherung und Löschung".
- **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
**Weitere Hinweise zu Verarbeitungsprozessen, Verfahren und Diensten:**
- **Bereitstellung Onlineangebot auf gemietetem Speicherplatz:** Für die Bereitstellung meines Onlineangebotes nutze ich Speicherplatz, Rechenkapazität und Software, die ich von einem entsprechenden Serveranbieter (auch "Webhoster" genannt) miete oder anderweitig beziehe; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
- **Erhebung von Zugriffsdaten und Logfiles:** Der Zugriff auf mein Onlineangebot wird in Form von sogenannten "Server-Logfiles" protokolliert. Zu den Serverlogfiles können die Adresse und der Name der abgerufenen Webseiten und Dateien, Datum und Uhrzeit des Abrufs, übertragene Datenmengen, Meldung über erfolgreichen Abruf, Browsertyp nebst Version, das Betriebssystem des Nutzers, Referrer URL (die zuvor besuchte Seite) und im Regelfall IP-Adressen und der anfragende Provider gehören. Die Serverlogfiles können zum einen zu Sicherheitszwecken eingesetzt werden, z. B. um eine Überlastung der Server zu vermeiden (insbesondere im Fall von missbräuchlichen Angriffen, sogenannten DDoS-Attacken), und zum anderen, um die Auslastung der Server und ihre Stabilität sicherzustellen; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO). **Löschung von Daten:** Logfile-Informationen werden für die Dauer von maximal 30 Tagen gespeichert und danach gelöscht oder anonymisiert. Daten, deren weitere Aufbewahrung zu Beweiszwecken erforderlich ist, sind bis zur endgültigen Klärung des jeweiligen Vorfalls von der Löschung ausgenommen.
- **Hetzner:** Leistungen auf dem Gebiet der Bereitstellung von informationstechnischer Infrastruktur und verbundenen Dienstleistungen (z. B. Speicherplatz und/oder Rechenkapazitäten); **Dienstanbieter:** Hetzner Online GmbH, Industriestr. 25, 91710 Gunzenhausen, Deutschland; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO); **Website:** [https://www.hetzner.com](https://www.hetzner.com/?ref=t01.li); **Datenschutzerklärung:** [https://www.hetzner.com/de/rechtliches/datenschutz](https://www.hetzner.com/de/rechtliches/datenschutz?ref=t01.li). **Auftragsverarbeitungsvertrag:** [https://docs.hetzner.com/de/general/general-terms-and-conditions/data-privacy-faq/](https://docs.hetzner.com/de/general/general-terms-and-conditions/data-privacy-faq/?ref=t01.li).
- **jsDelivr (cdn.jsdelivr.net):** Für die Bereitstellung der Registrierungs- und Kommentarfunktion (Ghost Membership Portal) wird ein JavaScript-Skript von dem Content Delivery Network jsDelivr geladen (`cdn.jsdelivr.net`). Beim Laden dieses Skripts wird die IP-Adresse des Nutzers an die Server von jsDelivr übermittelt. jsDelivr betreibt ein weltweites CDN-Netzwerk; die Datenverarbeitung kann dabei auch außerhalb der EU erfolgen. Der Einsatz erfolgt auf Grundlage meiner berechtigten Interessen an einer zuverlässigen und performanten Bereitstellung der Webseitefunktionen; **Dienstanbieter:** Prospect One sp. z o.o., Królewska 65A/1, 30-081 Kraków, Polen; **Website:** [https://www.jsdelivr.com](https://www.jsdelivr.com/?ref=t01.li); **Datenschutzerklärung:** [https://www.jsdelivr.com/privacy-policy-jsdelivr-net](https://www.jsdelivr.com/privacy-policy-jsdelivr-net?ref=t01.li); **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
## Einsatz von Cookies
Unter dem Begriff „Cookies" werden Funktionen, die Informationen auf Endgeräten der Nutzer speichern und aus ihnen auslesen, verstanden. Cookies können ferner in Bezug auf unterschiedliche Anliegen Einsatz finden, etwa zu Zwecken der Funktionsfähigkeit, der Sicherheit und des Komforts von Onlineangeboten sowie der Erstellung von Analysen der Besucherströme. Ich verwende Cookies gemäß den gesetzlichen Vorschriften. Dazu hole ich, wenn erforderlich, vorab die Zustimmung der Nutzer ein. Ist eine Zustimmung nicht notwendig, setze ich auf meine berechtigten Interessen. Dies gilt, wenn das Speichern und Auslesen von Informationen unerlässlich ist, um ausdrücklich angeforderte Inhalte und Funktionen bereitstellen zu können. Dazu zählen etwa die Speicherung von Einstellungen sowie die Sicherstellung der Funktionalität und Sicherheit meines Onlineangebots. Die Einwilligung kann jederzeit widerrufen werden. Ich informiere klar über deren Umfang und welche Cookies genutzt werden.
**Hinweise zu datenschutzrechtlichen Rechtsgrundlagen:** Auf dieser Website werden ausschließlich technisch notwendige Cookies eingesetzt. Eine Einwilligung der Nutzer ist hierfür gemäß § 25 Abs. 2 TTDSG nicht erforderlich. Die Rechtsgrundlage für die Verarbeitung personenbezogener Daten im Zusammenhang mit diesen Cookies ist mein berechtigtes Interesse an der technischen Bereitstellung und Funktionsfähigkeit des Onlineangebots (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
**Speicherdauer:** Es werden ausschließlich temporäre Cookies (Session-Cookies) eingesetzt. Diese werden spätestens gelöscht, nachdem ein Nutzer das Onlineangebot verlassen und sein Endgerät (z. B. Browser oder mobile Applikation) geschlossen hat. Es werden keine permanenten Cookies gesetzt.
**Allgemeine Hinweise zum Widerspruch (Opt-out):** Nutzer können den Einsatz von Cookies in den Privatsphäre-Einstellungen ihres Browsers einschränken oder deaktivieren. Dies kann jedoch die Funktionsfähigkeit des Onlineangebots beeinträchtigen.
## Registrierung, Anmeldung und Nutzerkonto
Nutzer können ein Nutzerkonto anlegen. Im Rahmen der Registrierung werden den Nutzern die erforderlichen Pflichtangaben mitgeteilt und zu Zwecken der Bereitstellung des Nutzerkontos auf Grundlage vertraglicher Pflichterfüllung verarbeitet. Zu den verarbeiteten Daten gehören insbesondere die Login-Informationen (Anzeigename sowie eine verifizierte E-Mail-Adresse). Die Angabe einer gültigen E-Mail-Adresse ist Pflicht; sie wird zur Identifikation des Kontos sowie für systemseitige Benachrichtigungen (z. B. Magic-Link-Anmeldung) verwendet. Als Anzeigename kann ein Pseudonym gewählt werden.
Im Rahmen der Inanspruchnahme meiner Registrierungs- und Anmeldefunktionen sowie der Nutzung des Nutzerkontos speichere ich die IP-Adresse und den Zeitpunkt der jeweiligen Nutzerhandlung. Die Speicherung erfolgt auf Grundlage meiner berechtigten Interessen als auch jener der Nutzer an einem Schutz vor Missbrauch und sonstiger unbefugter Nutzung. Eine Weitergabe dieser Daten an Dritte erfolgt grundsätzlich nicht, es sei denn, sie ist zur Verfolgung meiner Ansprüche erforderlich oder es besteht eine gesetzliche Verpflichtung hierzu.
Die Nutzer können über Vorgänge, die für deren Nutzerkonto relevant sind, wie z. B. technische Änderungen, per E-Mail informiert werden. Der E-Mail-Versand erfolgt über den selbst betriebenen Mailserver des Verantwortlichen; es werden keine externen E-Mail-Dienstleister eingesetzt.
- **Verarbeitete Datenarten:** Bestandsdaten (Anzeigename, E-Mail-Adresse); Kontaktdaten (E-Mail-Adresse); Inhaltsdaten (z. B. verfasste Kommentare); Nutzungsdaten (z. B. Zeitpunkt der Anmeldung, Seitenaufrufe). Protokolldaten (z. B. Logfiles betreffend Logins oder den Abruf von Daten oder Zugriffszeiten.).
- **Betroffene Personen:** Nutzer (z. B. Webseitenbesucher, Nutzer von Onlinediensten).
- **Zwecke der Verarbeitung und berechtigte Interessen:** Erbringung vertraglicher Leistungen und Erfüllung vertraglicher Pflichten; Sicherheitsmaßnahmen; Organisations- und Verwaltungsverfahren. Bereitstellung meines Onlineangebotes und Nutzerfreundlichkeit.
- **Aufbewahrung und Löschung:** Löschung entsprechend Angaben im Abschnitt "Allgemeine Informationen zur Datenspeicherung und Löschung". Löschung nach Kündigung.
- **Rechtsgrundlagen:** Vertragserfüllung und vorvertragliche Anfragen (Art. 6 Abs. 1 S. 1 lit. b) DSGVO). Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
**Weitere Hinweise zu Verarbeitungsprozessen, Verfahren und Diensten:**
- **Registrierung mit Pseudonymen:** Nutzer dürfen als Anzeigenamen Pseudonyme verwenden. Die Angabe einer gültigen E-Mail-Adresse bleibt jedoch Pflicht und kann nicht durch ein Pseudonym ersetzt werden; **Rechtsgrundlagen:** Vertragserfüllung und vorvertragliche Anfragen (Art. 6 Abs. 1 S. 1 lit. b) DSGVO).
- **Sichtbarkeit von Nutzerdaten in Kommentaren:** Der bei der Registrierung gewählte Anzeigename ist bei abgegebenen Kommentaren für alle Besucher des Onlineangebots öffentlich sichtbar. Die E-Mail-Adresse wird nicht veröffentlicht.
- **Löschung von Daten nach Kündigung:** Wenn Nutzer ihr Nutzerkonto gekündigt haben, werden deren Daten im Hinblick auf das Nutzerkonto, vorbehaltlich einer gesetzlichen Erlaubnis, Pflicht oder Einwilligung der Nutzer, gelöscht; **Rechtsgrundlagen:** Vertragserfüllung und vorvertragliche Anfragen (Art. 6 Abs. 1 S. 1 lit. b) DSGVO).
- **Keine Aufbewahrungspflicht für Daten:** Es obliegt den Nutzern, ihre Daten bei erfolgter Kündigung vor dem Vertragsende zu sichern. Wir sind berechtigt, sämtliche während der Vertragsdauer gespeicherte Daten des Nutzers unwiederbringlich zu löschen; **Rechtsgrundlagen:** Vertragserfüllung und vorvertragliche Anfragen (Art. 6 Abs. 1 S. 1 lit. b) DSGVO).
## Newsletter
Auf diesem Onlineangebot besteht die Möglichkeit, den kostenlosen Newsletter des t01 AI-Journals zu abonnieren. Mit der Anmeldung zum Newsletter willige ich ein, regelmäßig redaktionelle Inhalte zu KI, Automatisierung und digitalem Arbeiten per E-Mail zu erhalten.
- **Verarbeitete Datenarten:** Vorname; E-Mail-Adresse; Zeitpunkt der Anmeldung; IP-Adresse zum Zeitpunkt der Anmeldung.
- **Betroffene Personen:** Interessenten, Abonnentinnen und Abonnenten des Newsletters.
- **Zwecke der Verarbeitung:** Direktkommunikation (Versand des Newsletters); Nachweis der Einwilligung; Missbrauchsprävention.
- **Aufbewahrung und Löschung:** Die gespeicherten Daten werden nach Widerruf der Einwilligung bzw. nach Abmeldung vom Newsletter unverzüglich gelöscht, soweit keine gesetzlichen Aufbewahrungspflichten entgegenstehen. Einwilligungsnachweise (Zeitpunkt der Anmeldung, IP-Adresse) werden für den Zeitraum einer möglichen Inanspruchnahme aufbewahrt, längstens drei Jahre nach Abmeldung (§ 195 BGB).
- **Rechtsgrundlage:** Einwilligung (Art. 6 Abs. 1 S. 1 lit. a) DSGVO).
### Anmeldeverfahren
Die Anmeldung erfolgt über ein Double-Opt-In-Verfahren: Nach Eingabe von Vorname und E-Mail-Adresse erhalte ich eine Bestätigungs-E-Mail mit einem Aktivierungslink. Die Eintragung in den Verteiler wird erst mit dem Klick auf diesen Link wirksam. Dieses Verfahren stellt sicher, dass ausschließlich die Inhaberin oder der Inhaber der angegebenen E-Mail-Adresse das Abonnement aktivieren kann.
Die Anmeldedaten (E-Mail-Adresse, Zeitpunkt der Anmeldung, IP-Adresse) werden zum Nachweis der erteilten Einwilligung gespeichert.
### Widerruf und Abmeldung (Opt-out)
Die Einwilligung zum Empfang des Newsletters kann jederzeit und ohne Angabe von Gründen widerrufen werden. Der Widerruf berührt nicht die Rechtmäßigkeit der bis dahin erfolgten Verarbeitung.
Es stehen folgende Abmeldemöglichkeiten zur Verfügung:
- **Abmeldelink:** Jede Newsletter-E-Mail enthält im Footer einen Link zur sofortigen Abmeldung. Ein Klick auf diesen Link genügt; eine Anmeldung ist nicht erforderlich.
- **Per E-Mail:** Eine formlose Abmeldeanfrage an [info@t01.li](mailto:info@t01.li) ist ebenfalls jederzeit möglich.
Nach der Abmeldung wird die E-Mail-Adresse aus dem aktiven Verteiler entfernt. Die zur Einwilligungsdokumentation gespeicherten Daten (Anmeldezeitpunkt, IP-Adresse) werden nach Ablauf der oben genannten Aufbewahrungsfrist ebenfalls gelöscht.
### Versanddienstleister: Mailgun (EU-Region)
Der Versand der Newsletter-E-Mails erfolgt über den technischen Dienstleister Mailgun. Es wird ausschließlich die EU-Region von Mailgun genutzt; die Verarbeitung und Speicherung der Daten findet auf Servern innerhalb der Europäischen Union statt. Eine Übermittlung personenbezogener Daten in Drittstaaten außerhalb der EU findet nicht statt.
Mit Mailgun wurde ein Auftragsverarbeitungsvertrag gemäß Art. 28 DSGVO abgeschlossen, der den Schutz der Abonnentendaten sicherstellt.
- **Dienstanbieter:** Sinch Email (EU) AB, Lindhagensgatan 74, 112 18 Stockholm, Schweden (Betreiberin der EU-Region von Mailgun)
- **Website:** [https://www.mailgun.com](https://www.mailgun.com/?ref=t01.li)
- **Datenschutzerklärung:** [https://www.mailgun.com/legal/privacy-policy/](https://www.mailgun.com/legal/privacy-policy/?ref=t01.li)
- **Rechtsgrundlage der Übermittlung:** Einwilligung (Art. 6 Abs. 1 S. 1 lit. a) DSGVO); Auftragsverarbeitung (Art. 28 DSGVO).
## Blogs und Publikationsmedien
Ich nutze dieses Blog oder ein vergleichbares Mittel der Onlinekommunikation und Publikation (nachfolgend "Publikationsmedium"). Die Daten der Leser werden für die Zwecke des Publikationsmediums nur insoweit verarbeitet, als es für dessen Darstellung und die Kommunikation zwischen Autor und Lesern oder aus Gründen der Sicherheit erforderlich ist. Im Übrigen verweise ich auf die Informationen zur Verarbeitung der Besucher meines Publikationsmediums im Rahmen dieser Datenschutzhinweise.
- **Verarbeitete Datenarten:** Bestandsdaten (Anzeigename, E-Mail-Adresse); Kontaktdaten (E-Mail-Adresse); Inhaltsdaten (z. B. textliche Nachrichten und Kommentare sowie die sie betreffenden Informationen, wie z. B. Angaben zur Autorenschaft oder Zeitpunkt der Erstellung); Nutzungsdaten (z. B. Seitenaufrufe und Verweildauer, verwendete Gerätetypen und Betriebssysteme). Meta-, Kommunikations- und Verfahrensdaten (z. B. IP-Adressen, Zeitangaben).
- **Betroffene Personen:** Nutzer (z. B. Webseitenbesucher, Nutzer von Onlinediensten).
- **Zwecke der Verarbeitung und berechtigte Interessen:** Feedback (z. B. Sammeln von Feedback via Kommentarfunktion); Bereitstellung meines Onlineangebotes und Nutzerfreundlichkeit; Kommunikation; Organisations- und Verwaltungsverfahren. Sicherheitsmaßnahmen.
- **Aufbewahrung und Löschung:** Löschung entsprechend Angaben im Abschnitt "Allgemeine Informationen zur Datenspeicherung und Löschung".
- **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
**Weitere Hinweise zu Verarbeitungsprozessen, Verfahren und Diensten:**
- **Kommentare und Beiträge:** Wenn Nutzer Kommentare oder sonstige Beiträge hinterlassen, können ihre IP-Adressen auf Grundlage meiner berechtigten Interessen gespeichert werden. Das erfolgt zu meiner Sicherheit, falls jemand in Kommentaren und Beiträgen widerrechtliche Inhalte hinterlässt (Beleidigungen, verbotene politische Propaganda etc.). In diesem Fall kann ich selbst für den Kommentar oder Beitrag belangt werden und bin daher an der Identität des Verfassers interessiert.
Des Weiteren behalte ich mir vor, auf Grundlage meiner berechtigten Interessen die Angaben der Nutzer zwecks Spamerkennung zu verarbeiten.
Die im Rahmen der Kommentare und Beiträge mitgeteilten Informationen zur Person sowie die inhaltlichen Angaben werden von mir bis zum Widerspruch der Nutzer dauerhaft gespeichert; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
- **Profilbilder von Gravatar:** Wir setzen innerhalb meines Onlineangebotes und insbesondere im Blog den Dienst Gravatar ein.
Gravatar ist ein Dienst, bei dem sich Nutzer anmelden und Profilbilder und ihre E-Mail-Adressen hinterlegen können. Wenn Nutzer mit der jeweiligen E-Mail-Adresse auf anderen Onlinepräsenzen (vor allem in Blogs) Beiträge oder Kommentare hinterlassen, können deren Profilbilder neben den Beiträgen oder Kommentaren dargestellt werden. Hierzu wird die von den Nutzern mitgeteilte E-Mail-Adresse an Gravatar zwecks Prüfung, ob zu ihr ein Profil gespeichert ist, verschlüsselt übermittelt. Dies ist der einzige Zweck der Übermittlung der E-Mail-Adresse. Sie wird nicht für andere Zwecke verwendet, sondern danach gelöscht.
Die Nutzung von Gravatar erfolgt auf Grundlage meiner berechtigten Interessen, da ich mit Hilfe von Gravatar den Kommentarverfassern die Möglichkeit biete, ihre Beiträge mit einem Profilbild zu personalisieren.
Durch die Anzeige der Bilder bringt Gravatar die IP-Adresse der Nutzer in Erfahrung, da dies für eine Kommunikation zwischen einem Browser und einem Onlineservice notwendig ist.
Wenn Nutzer nicht möchten, dass ein mit ihrer E-Mail-Adresse bei Gravatar verknüpftes Benutzerbild in den Kommentaren erscheint, sollten sie zum Kommentieren eine E-Mail-Adresse nutzen, welche nicht bei Gravatar hinterlegt ist. Nutzer können die Übertragung der Daten komplett verhindern, indem sie die Kommentarfunktion nicht nutzen; **Dienstanbieter:** Aut O'Mattic A8C Irland Ltd., Grand Canal Dock, 25 Herbert Pl, Dublin, D02 AY86, Irland; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO); **Website:** [https://automattic.com](https://automattic.com/?ref=t01.li); **Datenschutzerklärung:** [https://automattic.com/privacy](https://automattic.com/privacy?ref=t01.li); **Auftragsverarbeitungsvertrag:** Wird vom Dienstanbieter bereitgestellt. **Grundlage Drittlandtransfers:** Data Privacy Framework (DPF), Standardvertragsklauseln (Werden vom Dienstanbieter bereitgestellt).
## Webanalyse, Monitoring und Optimierung
Die Webanalyse (auch als „Reichweitenmessung" bezeichnet) dient der Auswertung der Besucherströme meines Onlineangebots. Mithilfe der Reichweitenanalyse kann ich zum Beispiel erkennen, zu welcher Zeit mein Onlineangebot oder dessen Inhalte am häufigsten genutzt werden, und nachvollziehen, welche Bereiche der Optimierung bedürfen.
Ich setze zu diesem Zweck **Plausible Analytics** ein, eine datenschutzfreundliche Open-Source-Analysesoftware. Die Plausible-Instanz wird **selbst gehostet auf demselben Server wie dieses Onlineangebot** (Hetzner, Deutschland). Es findet keine Übermittlung von Daten an externe Dritte oder an Server außerhalb der EU statt.
Plausible Analytics arbeitet **ohne Cookies** und ohne dauerhafte Speicherung personenbezogener Daten auf den Endgeräten der Nutzer. IP-Adressen werden weder gespeichert noch in Protokolldateien geschrieben. Zur Erkennung eindeutiger Besucher innerhalb eines Tages wird ein täglich wechselnder, gesalteter Hash aus IP-Adresse, User-Agent und einer zufälligen täglichen Salt-Zeichenkette gebildet. Dieser Hash ist nicht umkehrbar und ermöglicht keine Identifikation einzelner Personen. Nach Ablauf des Tages wird er verworfen.
Da Plausible Analytics keine Cookies setzt und keine dauerhaften personenbezogenen Daten verarbeitet, ist für dessen Einsatz keine Einwilligung der Nutzer erforderlich.
- **Verarbeitete Datenarten:** Nutzungsdaten (z. B. Seitenaufrufe, Verweildauer, Klickpfade, verwendete Gerätetypen und Betriebssysteme, Referrer-URLs). Meta- und Verfahrensdaten (z. B. anonymisierte Geräteinformationen, Zeitangaben; keine persistenten Identifikatoren).
- **Betroffene Personen:** Nutzer (z. B. Webseitenbesucher).
- **Zwecke der Verarbeitung und berechtigte Interessen:** Reichweitenmessung (z. B. Zugriffsstatistiken, Erkennung populärer Inhalte); Verbesserung des Onlineangebots.
- **Aufbewahrung und Löschung:** Aggregierte Statistikdaten werden unbefristet gespeichert. Tagesweise berechnete Hashes werden nach Ablauf des jeweiligen Tages verworfen. Es werden keine personenbezogenen Rohdaten dauerhaft gespeichert.
- **Sicherheitsmaßnahmen:** Keine Cookie-Nutzung; kein dauerhaftes Speichern von IP-Adressen; tagesweise gesaltetes Hashing zur Besuchererkennung.
- **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
**Weitere Hinweise zu Verarbeitungsprozessen, Verfahren und Diensten:**
- **Plausible Analytics (self-hosted):** Datenschutzfreundliche Webanalyse ohne Cookies und ohne externe Datenübertragung; **Betrieb:** Self-hosted auf eigenem Server (Hetzner, Deutschland); kein Drittanbieter, kein Drittlandtransfer; **Website:** [https://plausible.io](https://plausible.io/?ref=t01.li); **Datenschutzerklärung des Softwareherstellers:** [https://plausible.io/privacy](https://plausible.io/privacy?ref=t01.li); **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
## Präsenzen in sozialen Netzwerken (Social Media)
Ich unterhalte Onlinepräsenzen innerhalb sozialer Netzwerke und verarbeite in diesem Rahmen Nutzerdaten, um mit den dort aktiven Nutzern zu kommunizieren oder Informationen über mich anzubieten.
Ich weise darauf hin, dass dabei Nutzerdaten außerhalb des Raumes der Europäischen Union verarbeitet werden können. Hierdurch können sich für die Nutzer Risiken ergeben, weil so zum Beispiel die Durchsetzung der Nutzerrechte erschwert werden könnte.
Ferner werden die Daten der Nutzer innerhalb sozialer Netzwerke im Regelfall für Marktforschungs- und Werbezwecke verarbeitet. So können beispielsweise anhand des Nutzungsverhaltens und sich daraus ergebender Interessen der Nutzer Nutzungsprofile erstellt werden. Letztere finden möglicherweise wiederum Verwendung, um etwa Werbeanzeigen innerhalb und außerhalb der Netzwerke zu schalten, die mutmaßlich den Interessen der Nutzer entsprechen. Daher werden im Regelfall Cookies auf den Rechnern der Nutzer gespeichert, in denen das Nutzungsverhalten und die Interessen der Nutzer gespeichert werden. Zudem können in den Nutzungsprofilen auch Daten unabhängig der von den Nutzern verwendeten Geräten gespeichert werden (insbesondere, wenn sie Mitglieder der jeweiligen Plattformen und dort eingeloggt sind).
Für eine detaillierte Darstellung der jeweiligen Verarbeitungsformen und der Widerspruchsmöglichkeiten (Opt-out) verweise ich auf die Datenschutzerklärungen und Angaben der Betreiber der jeweiligen Netzwerke.
Auch im Fall von Auskunftsanfragen und der Geltendmachung von Betroffenenrechten weise ich darauf hin, dass diese am effektivsten bei den Anbietern geltend gemacht werden können. Nur Letztere haben jeweils Zugriff auf die Nutzerdaten und können direkt entsprechende Maßnahmen ergreifen und Auskünfte geben. Sollten Sie dennoch Hilfe benötigen, dann können Sie sich an mich wenden.
**Hinweis zu Share-Buttons:** Auf einzelnen Seiten dieses Onlineangebots sind Schaltflächen zum Teilen von Inhalten auf X (Twitter), Facebook und LinkedIn eingebunden. Diese Schaltflächen sind als einfache Verlinkungen realisiert und laden beim Seitenaufruf keinerlei externe Skripte oder Tracking-Ressourcen der jeweiligen Plattformen. Eine Datenübertragung an die genannten Netzwerke findet ausschließlich dann statt, wenn ein Nutzer aktiv auf eine dieser Schaltflächen klickt und dadurch die entsprechende Plattform aufruft.
- **Verarbeitete Datenarten:** Kontaktdaten (z. B. Post- und E-Mail-Adressen oder Telefonnummern); Inhaltsdaten (z. B. textliche oder bildliche Nachrichten und Beiträge sowie die sie betreffenden Informationen, wie z. B. Angaben zur Autorenschaft oder Zeitpunkt der Erstellung); Nutzungsdaten (z. B. Seitenaufrufe und Verweildauer, Klickpfade, Nutzungsintensität und -frequenz, verwendete Gerätetypen und Betriebssysteme, Interaktionen mit Inhalten und Funktionen). Meta-, Kommunikations- und Verfahrensdaten (z. B. IP-Adressen, Zeitangaben, Identifikationsnummern, beteiligte Personen).
- **Betroffene Personen:** Nutzer (z. B. Webseitenbesucher, Nutzer von Onlinediensten).
- **Zwecke der Verarbeitung und berechtigte Interessen:** Kommunikation; Öffentlichkeitsarbeit und Informationszwecke.
- **Aufbewahrung und Löschung:** Löschung entsprechend Angaben im Abschnitt "Allgemeine Informationen zur Datenspeicherung und Löschung".
- **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO).
**Weitere Hinweise zu Verarbeitungsprozessen, Verfahren und Diensten:**
- **Bluesky:** Dezentralisiertes Social-Media-Netzwerk – ich unterhalte dort eine eigene Präsenz und ermögliche das Erstellen, Teilen und Kommentieren von Inhalten sowie das Folgen von Nutzerprofilen; **Dienstanbieter:** Bluesky, PBLLC., Seattle, USA, [support@bsky.app](mailto:support@bsky.app); **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO); **Website:** [https://bsky.social/](https://bsky.social/?ref=t01.li); **Datenschutzerklärung:** [https://bsky.social/about/support/privacy-policy](https://bsky.social/about/support/privacy-policy?ref=t01.li).
- **Facebook:** Soziales Netzwerk – über die auf dieser Website eingebundenen Share-Buttons können Inhalte auf Facebook geteilt werden. Eine Datenübertragung erfolgt ausschließlich bei aktivem Klick auf die Schaltfläche; **Dienstanbieter:** Meta Platforms Ireland Limited, Merrion Road, Dublin 4, D04 X2K5, Irland; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO); **Website:** [https://www.facebook.com](https://www.facebook.com/); **Datenschutzerklärung:** ; **Grundlage Drittlandtransfers:** Data Privacy Framework (DPF).
- **LinkedIn:** Soziales Netzwerk – ich unterhalte dort eine eigene Präsenz. Ich bin gemeinsam mit LinkedIn Irland Unlimited Company für die Erhebung (jedoch nicht die weitere Verarbeitung) von Daten der Besucher verantwortlich, die zur Erstellung der „Page-Insights" (Statistiken) meiner LinkedIn-Profile genutzt werden. Zu diesen Daten gehören Informationen über die Arten von Inhalten, die Nutzer sich ansehen oder mit denen sie interagieren, sowie die von ihnen vorgenommenen Handlungen. Außerdem werden Details über die genutzten Geräte erfasst, wie z. B. IP-Adressen, Betriebssystem, Browsertyp, Spracheinstellungen und Cookie-Daten, sowie Angaben aus den Nutzerprofilen, wie Berufsfunktion, Land, Branche, Hierarchieebene, Unternehmensgröße und Beschäftigungsstatus. Datenschutzinformationen zur Verarbeitung von Nutzerdaten durch LinkedIn können den Datenschutzhinweisen von LinkedIn entnommen werden: [https://www.linkedin.com/legal/privacy-policy](https://www.linkedin.com/legal/privacy-policy?ref=t01.li).
Ich habe mit LinkedIn Irland eine spezielle Vereinbarung geschlossen („Page Insights Joint Controller Addendum", [https://legal.linkedin.com/pages-joint-controller-addendum](https://legal.linkedin.com/pages-joint-controller-addendum?ref=t01.li)), in der insbesondere geregelt wird, welche Sicherheitsmaßnahmen LinkedIn beachten muss und in der LinkedIn sich bereit erklärt hat, die Rechte der Betroffenen zu erfüllen (d. h. Nutzer können z. B. Auskunfts- oder Löschungsanfragen direkt an LinkedIn richten). Die Rechte der Nutzer (insbesondere das Recht auf Auskunft, Löschung, Widerspruch und Beschwerde bei der zuständigen Aufsichtsbehörde) werden durch die Vereinbarungen mit LinkedIn nicht eingeschränkt. Die gemeinsame Verantwortlichkeit beschränkt sich auf die Erhebung und Übermittlung der Daten an LinkedIn Irland Unlimited Company, ein Unternehmen mit Sitz in der EU. Die weitere Verarbeitung der Daten obliegt ausschließlich LinkedIn Irland Unlimited Company, insbesondere was die Übermittlung der Daten an die Muttergesellschaft LinkedIn Corporation in den USA betrifft; **Dienstanbieter:** LinkedIn Ireland Unlimited Company, Wilton Plaza, Dublin 2, Irland; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO); **Website:** [https://www.linkedin.com](https://www.linkedin.com/?ref=t01.li); **Datenschutzerklärung:** [https://www.linkedin.com/legal/privacy-policy](https://www.linkedin.com/legal/privacy-policy?ref=t01.li); **Grundlage Drittlandtransfers:** Data Privacy Framework (DPF), Standardvertragsklauseln ([https://legal.linkedin.com/dpa](https://legal.linkedin.com/dpa?ref=t01.li)). **Widerspruchsmöglichkeit (Opt-Out):** [https://www.linkedin.com/psettings/guest-controls/retargeting-opt-out](https://www.linkedin.com/psettings/guest-controls/retargeting-opt-out?ref=t01.li).
- **X:** Soziales Netzwerk – ich unterhalte dort eine eigene Präsenz. Über die auf dieser Website eingebundenen Share-Buttons können Inhalte auf X (ehemals Twitter) geteilt werden. Eine Datenübertragung erfolgt ausschließlich bei aktivem Klick auf die Schaltfläche; **Dienstanbieter:** X Internet Unlimited Company, One Cumberland Place, Fenian Street, Dublin 2 D02 AX07, Irland; **Rechtsgrundlagen:** Berechtigte Interessen (Art. 6 Abs. 1 S. 1 lit. f) DSGVO); **Website:** [https://x.com](https://x.com/?ref=t01.li); **Datenschutzerklärung:** [https://x.com/de/privacy](https://x.com/de/privacy?ref=t01.li).
## Änderung und Aktualisierung
Ich bitte Sie, sich regelmäßig über den Inhalt meiner Datenschutzerklärung zu informieren. Ich passe die Datenschutzerklärung an, sobald die Änderungen der von mir durchgeführten Datenverarbeitungen dies erforderlich machen. Ich informiere Sie, sobald durch die Änderungen eine Mitwirkungshandlung Ihrerseits (z. B. Einwilligung) oder eine sonstige individuelle Benachrichtigung erforderlich wird.
Sofern ich in dieser Datenschutzerklärung Adressen und Kontaktinformationen von Unternehmen und Organisationen angeben, bitte ich zu beachten, dass die Adressen sich über die Zeit ändern können und bitte, die Angaben vor Kontaktaufnahme zu prüfen.
### Redaktionelle Richtlinien
URL: https://t01.li/redaktionelle-richtlinien/
Last updated: 2026-07-08T14:30:08.000Z
## Exzerpt
Wie auf t01.li gearbeitet wird – von der Recherche bis zur Korrektur. Welche Rolle KI im Prozess spielt, welche nicht. Wo Quellen herkommen, wie alt sie sein dürfen, und was passiert, wenn sich ein Fehler einschleicht.
t01.li ist ein persönlicher Blog, kein Newsroom. Trotzdem oder gerade deshalb gelten hier ein paar Regeln, die ich mir selbst auferlegt habe – damit klar ist, woran Beiträge entstehen und woran nicht.
## Inhalt
Diese Seite beschreibt den Maschinenraum: wie ein Artikel von der ersten Idee zur Veröffentlichung kommt, welche Quellen ich akzeptiere, wie KI in den Prozess eingebunden ist und was passiert, wenn etwas Falsches im Text steht. Verantwortlich für alles, was hier erscheint, bin ich – [Tobias Glawe](https://t01.li/autor/tobias/).
## Wie Artikel entstehen
Jeder Beitrag durchläuft fünf Stationen. Das klingt nach Großverlag, ist aber schlicht der Versuch, in einem Ein-Mann-Betrieb die gleichen Rollen wahrzunehmen, die in einer Redaktion mehrere Personen erledigen – ohne dass die Disziplin dabei verloren geht.
**Recherche:** Am Anfang steht das Sammeln. Primärquellen, Pressemitteilungen, Studien, eigene Beobachtungen, eigene Workflows und Projekte, Notizen aus meinem Obsidian Vault. Was reinkommt, wird festgehalten, bevor es interpretiert wird.
**Verfassen:** Hier entsteht der Text. Argumentation, Tonalität, Position. Wenn ich etwas für schwach oder überverkauft halte, steht das auch so im Text – mit Begründung, nicht als Bauchgefühl.
**Fakten-Check:** Jeder überprüfbare Fakt wird gegen Quellen abgeglichen. Zahlen, Modellangaben, Eigennamen, Zitate. Bestätigt, fragwürdig oder nicht haltbar – die Markierung entscheidet, ob ein Satz so bleibt, umgeschrieben wird oder rausfliegt.
**SEO:** Title-Tag, Meta-Description, URL-Slug, interne Verlinkung. Keine Keyword-Akrobatik, keine Phrasenoptimierung um ihrer selbst willen. Sprache geht vor Suchmaschine.
**Eigen-Lektorat:** Letzte Station. Stil, Typografie, Rhythmus, Konsistenz.
## Welche Rolle KI spielt
Klar, ohne Beschönigung: KI ist Teil dieses Workflows. Genauer gesagt: [Claude](https://www.anthropic.com/claude?ref=t01.li) von Anthropic.
Für die Recherche nutze ich klassisch die Suchmaschine und KI, um Links und Quellen zu finden – schneller, als ich es meistens per Google könnte. Was relevant ist und was Bullshit, entscheide ich selbst. Die Selektion ist händisch. Eine generierte Quellenliste ohne menschliche Prüfung wäre genau das Pressemitteilungs-Echo, das ich vermeiden will.
Für den Fakten-Check lasse ich Claude im Rahmen des oben beschriebenen Workflows gegen Quellen abgleichen. Das heißt: Jede überprüfbare Aussage wird systematisch geprüft, bevor sie veröffentlicht wird. Die finale redaktionelle Verantwortung trage aber ich. Wenn hier etwas Falsches steht, ist das mein Fehler – nicht der eines Modells.
Für Beitragsbilder und Info-Grafiken nutze ich [ChatGPT Images 2.0](https://openai.com/index/introducing-chatgpt-images-2-0/?ref=t01.li). Die Bildmotive werden von mir gebrieft, ausgewählt und freigegeben – generiert, aber nicht ungeprüft veröffentlicht. KI-generierte Bilder werden als solche kenntlich gemacht, sofern das nicht ohnehin offensichtlich ist.
Was KI hier ausdrücklich nicht ist: ein Ersatz für eigenen Text, eigene Meinung oder eigenes Urteil. Ein Beitrag, der nur aus generierten Inhalten bestünde, würde sich beim ersten Absatz selbst entlarven.
## Quellen-Policy
Quellen sind dazu da, Behauptungen zu tragen. Sie sollen prüfbar sein, einigermaßen aktuell und nicht aus dem Hut gezaubert.
**Bevorzugt:** Primärquellen. Herstellerdokumentation, Studien, Originalpapiere, offizielle Statements. Wenn ein Modell ein bestimmtes Context-Window hat, steht das in der Doku des Anbieters – nicht in einem Sammler-Blog.
**Hersteller-Behauptungen werden markiert.** Benchmarks, „Game-Changer“-Claims und PR-Aussagen sind keine unabhängige Wahrheit. Wenn ich sie zitiere, wird das offen ausgeschildert – „herstellereigene Werte, keine unabhängige Drittmessung“ ist hier ein wiederkehrendes Standard-Pattern.
**Aktualität.** Studien sind im Regelfall nicht älter als zwölf Monate zum Zeitpunkt der Beitragserstellung. Andere Quellen so aktuell wie möglich – im Regelfall nicht älter als sechs Monate. Ausnahmen gibt es bei Grundlagenwerken oder wenn eine ältere Quelle nachweislich noch der Stand der Dinge ist. In dem Fall steht das auch im Text.
**Was nicht zitiert wird:** anonyme Boulevard-Berichte, Threads ohne Beleg, selbst ernannte Gurus. Wenn eine Behauptung nirgendwo seriös belegt ist, gehört sie hier nicht hin.
Quellen werden in den Beiträgen direkt im Kontext verlinkt – nicht als Anhangsliste am Ende.
## Sponsoring und bezahlte Inhalte
t01.li ist keine kommerzielle Plattform. Aktuell gibt es weder Affiliate-Links noch bezahlte Beiträge.
Sollte sich daran irgendwann etwas ändern, gilt: jede Form von bezahlter oder gesponserter Zusammenarbeit wird im Beitrag selbst eindeutig gekennzeichnet. Keine versteckte Werbung, keine „freundliche Erwähnung“ gegen Provision, kein Native-Content-Theater.
Das ist keine moralische Pose, sondern eine Bedingung dafür, dass Kritik an Herstellern hier überhaupt etwas wert ist.
## Korrekturen
Fehler passieren. Wenn dir einer auffällt, schreib mir an [tobias@t01.li](mailto:tobias@t01.li) – kurz die Stelle, kurz worum es geht, gerne mit Quelle.
**Tippfehler, Grammatikfehler, kleinere sprachliche Ausrutscher** korrigiere ich still. Niemand braucht eine Korrektur-Notiz dafür, dass aus „der“ mal „den“ wurde.
**Inhaltliche oder faktische Korrekturen** bekommen einen sichtbaren Hinweis im Beitrag. Was ursprünglich dastand, was jetzt dasteht, und das Datum der Änderung. Transparenz ist hier wichtiger als das Vermeiden einer kleinen Peinlichkeit – ein nachträglich heimlich umgeschriebener Faktenfehler ist schlimmer als der ursprüngliche Fehler selbst.
Ein Zeitfenster für Reaktion gibt es nicht. Ich gehe Korrekturhinweise an, wenn ich sie sehe.
## Kontakt
Alles, was die redaktionelle Arbeit betrifft – Hinweise, Korrekturen, Widerspruch – läuft über [tobias@t01.li](mailto:tobias@t01.li). Wer dahintersteckt, steht auf meiner [Autorenseite](https://t01.li/autor/tobias/).
## Jetzt anmelden und KI-Know-how mitnehmen
Was generative KI in echten Projekten taugt, was maßlos überschätzt wird und wo Versprechen auf Realität trifft.
Jetzt abonnieren
Email sent! Check your inbox to complete your signup.
Kein Spam. Abmeldung jederzeit möglich.
### Glossar
URL: https://t01.li/glossar/
Last updated: 2026-07-09T12:31:44.000Z
KI-Vokabular verändert sich schneller, als es sich einbürgert. Hier stehen die Begriffe, die in meinen Artikeln vorkommen – kurz erklärt, und mit einem zweiten Blick darauf, wann sie tatsächlich etwas aussagen und wann sie nur gut klingen. Fehlt ein Begriff, den du hier erwartet hättest? [Schreib mir](mailto:tobias@t01.li) einfach.
#### AEO (Answer Engine Optimization)
Die Optimierung von Inhalten dafür, in den direkten Antworten von KI-Systemen (Answer Engines wie ChatGPT, Perplexity, Google AI Overviews) zitiert oder wörtlich verwendet zu werden.
****Buzzword-Bingo:** Wird oft synonym mit GEO benutzt – die Abgrenzung ist unscharf, weil beide Begriffe dasselbe Grundphänomen beschreiben. Wer „AEO“ sagt, sollte klarmachen, ob Answer Engine Optimization oder Agentic Engine Optimization gemeint ist (siehe eigener Eintrag) – im Zweifel nachfragen, bevor man den Begriff selbst übernimmt.
#### AEO (Agentic Engine Optimization)
Ein neuerer, weniger etablierter Begriff für die Optimierung von Inhalten und Schnittstellen dafür, dass autonome KI-Agenten – nicht nur Antwort-generierende Systeme – sie zuverlässig verarbeiten, nutzen oder ansteuern können, etwa über strukturierte Daten, APIs oder WebMCP-ähnliche Mechanismen.
****Buzzword-Bingo:** Der Begriff ist neu genug, dass er teils vor der eigentlichen Praxis auftaucht – „Agentic Engine Optimization“ wird manchmal genutzt, um eine Zukunftsvision zu verkaufen, für die es noch kaum belastbare Umsetzungsbeispiele gibt. Prüf, ob dahinter eine konkrete technische Maßnahme steht oder nur eine Ankündigung.
Ausführlich in: [Agentisches SEO: Türen für Gäste, die kaum kommen](https://t01.li/geo-seo/agentisches-seo-strukturierte-daten-agenten/)
#### Agentic AI
Ein System, das mehrschrittig eigenständig Werkzeuge aufruft, Zwischenergebnisse bewertet und den nächsten Schritt selbst wählt – ohne dass für jeden Schritt neu ein Mensch promptet.
****Buzzword-Bingo:** Ein Chatbot mit einem Tool-Call ist kein Agent. Achte darauf, ob tatsächlich eine Schleife aus Plan → Aktion → Bewertung existiert, oder ob „Agent“ nur ein aufgehübschtes Single-Turn-Feature ist.
#### Agentic Framework
Software-Bibliothek (LangGraph, CrewAI, AutoGen u. a.), die Struktur für den Bau von Multi-Agenten-Systemen liefert – Zustandsverwaltung, Kommunikation zwischen Agenten, Ablaufsteuerung. Orchestrierung bezeichnet dabei konkret die Koordination: wer macht wann was, in welcher Reihenfolge, mit welchen Übergaben.
****Buzzword-Bingo:** Ein Framework macht aus einem einzelnen LLM-Call noch kein Multi-Agenten-System. Prüf, ob tatsächlich mehrere spezialisierte Agenten mit eigenen Rollen zusammenarbeiten, oder ob „Framework“ nur eine Prompt-Kette mit Namen ist.
#### Agent Instruction File
Eine Datei (z. B. CLAUDE.md, AGENTS.md, .cursorrules), die einem Coding-Agenten projektspezifischen Kontext und Verhaltensregeln vorgibt, bevor er überhaupt einen Prompt bekommt.
****Buzzword-Bingo:** Wird oft mit einem System-Prompt verwechselt. Der Unterschied: Sie liegt im Projekt selbst, wird bei jeder Session neu geladen und ist typischerweise versioniert – kein Ad-hoc-Text, sondern Teil des Repos.
Ausführlich in: [CLAUDE.md: Eine Datei reicht selten, eine lange nie](https://t01.li/ai-dev/claude-md-best-practice-2026/)
#### Agent-Loop (Loop-Engineering)
Die wiederholte Abfolge aus Planen, Handeln, Beobachten und Neubewerten, die einen Agenten von einem einmaligen Prompt-Response-Zyklus unterscheidet. Loop-Engineering bezeichnet das bewusste Gestalten dieser Schleife – Abbruchbedingungen, Zwischenprüfungen, Fehlerbehandlung.
****Buzzword-Bingo:** Wie bei Agentic AI: Ein einzelner Tool-Call ist keine Loop. Die Schleife muss tatsächlich mehrfach durchlaufen werden und auf eigenen Zwischenergebnissen aufbauen, sonst ist es nur ein umständlich benanntes Skript.
#### AI Citation / Citation
Die Erwähnung oder Verlinkung einer Quelle innerhalb einer KI-generierten Antwort – etwa wenn eine Answer Engine eine Website als Beleg für eine Aussage nennt.
****Buzzword-Bingo:** Eine Citation ist kein Klick. Zitiert zu werden fühlt sich nach Sichtbarkeit an, bringt aber nicht zwangsläufig Traffic oder Conversion – der Nutzer bekommt seine Antwort oft direkt in der KI-Oberfläche und muss die Quelle gar nicht mehr besuchen.
Ausführlich in: [GEO-Citations bringen keine Conversions](https://t01.li/geo-seo/geo-citations-bringen-keine-conversions/)
#### Benchmark
Ein standardisiertes Testset mit fester Aufgabenstellung und Bewertungsmetrik (z. B. MMLU, HumanEval, GPQA), mit dem Modelle untereinander vergleichbar gemacht werden sollen.
****Buzzword-Bingo:** Hohe Benchmark-Werte sagen wenig über Praxistauglichkeit für eine konkrete Aufgabe aus – viele Benchmarks sind längst Teil der Trainingsdaten oder werden gezielt optimiert („Benchmark-Overfitting“). Ein Modell, das bei MMLU vorne liegt, muss bei deinem tatsächlichen Anwendungsfall nicht besser sein.
Ausführlich in: [Wenn Benchmarks lügen – warum der LLM-Vergleich kaputt ist](https://t01.li/ki-systemdesign/wenn-benchmarks-lugen-warum-der-llm-vergleich-kaputt-ist/)
#### BYOK
Bring Your Own Key – Nutzer verwenden einen eigenen API-Key eines Modellanbieters innerhalb eines Drittanbieter-Produkts, statt über den Anbieter des Produkts abzurechnen.
****Buzzword-Bingo:** Wird oft als reines Kostenargument verkauft. Relevanter ist meist die Kontrolle über Datenverarbeitung und Ratenlimits – wer nur auf den Preis schaut, verpasst den eigentlichen Punkt.
#### Chunking
Das Aufteilen längerer Dokumente in kleinere Textabschnitte vor dem Einbetten (Embedding) und Speichern in einer Vektor-Datenbank – notwendig, weil zu große Textblöcke schlechtere, unpräzisere Embeddings ergeben.
****Buzzword-Bingo:** Chunk-Größe und -Strategie (nach Sätzen, Absätzen, fester Zeichenzahl) beeinflussen die Retrieval-Qualität stark – „wir chunken die Dokumente“ ohne Angabe der Strategie ist eine unvollständige technische Aussage, kein Qualitätsmerkmal.
#### CLI
Command Line Interface – die textbasierte Bedienung eines Programms über ein Terminal, ohne grafische Oberfläche. Für Coding-Agenten oft die primäre Ausführungsumgebung.
****Buzzword-Bingo:** Kein Bingo-Kandidat, reines Grundvokabular – aufgenommen, weil viele Anleitungen zu Coding-Agenten CLI-Kenntnisse stillschweigend voraussetzen.
#### Coding-Agent
Ein KI-System, das eigenständig Code liest, schreibt, ausführt und testet – über mehrere Schritte hinweg, mit Zugriff auf Terminal, Dateisystem und ggf. Versionskontrolle.
****Buzzword-Bingo:** Nicht jedes Tool mit Code-Vervollständigung ist ein Coding-Agent. Entscheidend ist die Fähigkeit zu eigenständigen Zyklen aus Ausführen, Prüfen, Korrigieren – nicht nur Vorschläge zu unterbreiten, die ein Mensch übernimmt.
#### Constrained Decoding
Der zugrundeliegende technische Mechanismus, bei dem während der Token-für-Token-Generierung nur Ausgaben zugelassen werden, die einer vorgegebenen Grammatik oder einem Schema entsprechen – die Basis, auf der Features wie Structured Outputs oder JSON Mode aufbauen.
****Buzzword-Bingo:** Wird selten im Marketing verwendet, aber wenn doch, dann oft ungenau als Synonym für „das Modell hält sich an Regeln“ – tatsächlich beschreibt es einen sehr spezifischen Eingriff in den Generierungsprozess, keine Verhaltensregel im Sinne von Guardrails.
#### Constraints
Explizite Einschränkungen, die einem Modell im Prompt oder System-Prompt mitgegeben werden – Formatvorgaben, Längenbegrenzungen, Ausschlusskriterien, Verhaltensregeln.
****Buzzword-Bingo:** Constraints sind kein Ersatz für Guardrails. Ein Modell folgt einer Formatvorgabe zuverlässiger als einer Sicherheitsregel – wer beides gleich behandelt, überschätzt die Verbindlichkeit von Prompt-Anweisungen.
Ausführlich in: [Constraint-Based Prompting bei Reasoning-Modellen schadet mehr, als das es nützt](https://t01.li/ki-systemdesign/constraint-based-prompting-bei-reasoning-modellen-schadet-mehr-als-das-es-nutzt/)
#### Context Engineering
Das systematische Gestalten dessen, was ein LLM zum Zeitpunkt der Anfrage an Information sieht – Systemprompt, Tool-Definitionen, Retrieval-Ergebnisse, Gesprächsverlauf. Anders als Prompt Engineering geht es nicht um die einzelne Formulierung, sondern um die gesamte Informationsarchitektur einer Anfrage.
****Buzzword-Bingo:** Wenn „Context Engineering“ fällt und danach nur ein längerer Systemprompt kommt, ist es umbenanntes Prompt Engineering. Der Begriff trägt nur, wenn tatsächlich mehrere Informationsquellen orchestriert werden.
Ausführlich in: [Context Engineering: Warum der perfekte Prompt nur ein Baustein ist](https://t01.li/ki-systemdesign/context-engineering-prompt-engineering-baustein/)
#### Embeddings
Numerische Vektor-Repräsentationen von Text (oder anderen Daten), bei denen semantisch ähnliche Inhalte im Vektorraum nah beieinander liegen – Grundlage für semantische Suche und Retrieval.
****Buzzword-Bingo:** Kein Bingo-Kandidat im eigentlichen Sinn, aber wichtig zu wissen: Die Qualität eines Embedding-Modells ist aufgabenabhängig – gut für allgemeine Textsuche heißt nicht automatisch gut für Code oder mehrsprachige Inhalte.
#### Eval / Evaluation
Der systematische Prozess, ein Modell oder ein KI-System anhand eigener, oft aufgabenspezifischer Testfälle zu bewerten – im Unterschied zum Benchmark nicht zwingend standardisiert oder öffentlich vergleichbar.
****Buzzword-Bingo:** „Wir machen Evals“ ohne Angabe, was genau getestet wird und gegen welchen Maßstab, ist wenig aussagekräftig. Eine Eval ist nur so gut wie die Testfälle, die sie tatsächlich abdeckt.
#### Few Shot
Eine Prompting-Technik, bei der dem Modell mehrere Beispiele für die gewünschte Aufgabe direkt im Prompt mitgegeben werden, bevor es die eigentliche Anfrage bearbeitet.
****Buzzword-Bingo:** Kein Bullshit-Kandidat – aber die Qualität der Beispiele entscheidet mehr als ihre Anzahl. Drei schlecht gewählte Beispiele bringen weniger als ein einziges präzises.
#### Fine-Tuning
Das Nachtrainieren eines bereits vortrainierten Modells auf einem kleineren, spezifischeren Datensatz, um es an eine bestimmte Aufgabe, einen Ton oder eine Domäne anzupassen.
****Buzzword-Bingo:** Wird manchmal als Standardlösung für Probleme verkauft, die eigentlich mit besserem Prompting oder RAG günstiger lösbar wären. Fine-Tuning lohnt sich vor allem dort, wo Verhalten oder Stil konsistent verändert werden soll – nicht als erste Anlaufstelle für jedes Qualitätsproblem.
#### Foundation Model / Basismodell
Ein großes, breit trainiertes Modell, das als Ausgangsbasis für spezialisierte Anwendungen dient – über Fine-Tuning, Prompting oder zusätzliche Systeme angepasst, statt für jede Aufgabe von Grund auf neu trainiert zu werden.
****Buzzword-Bingo:** „Foundation Model“ wird manchmal genutzt, um jedes größere LLM aufzuwerten. Der Begriff trägt eigentlich nur die Eigenschaft „breit einsetzbare Basis für vielfältige nachgelagerte Anwendungen“ – nicht automatisch „besonders leistungsfähig“.
#### GEO
Generative Engine Optimization – die Optimierung von Content dafür, dass er in KI-generierten Antworten (ChatGPT, Perplexity, Google AI Overviews) zitiert oder verarbeitet wird, statt nur in klassischen Suchergebnislisten zu ranken.
****Buzzword-Bingo:** Wird oft synonym mit klassischem SEO verkauft, nur mit neuem Etikett. Trägt gemeinsam mit technischem SEO nur, wenn die Maßnahmen tatsächlich auf Zitierfähigkeit und Extrahierbarkeit zielen – Struktur, Prägnanz, Fakten-Dichte – statt auf Backlinks und Keywords.
Ausführlich in: [GEO ohne technisches SEO ist Kaffeesatzleserei](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/)
#### Grounding
Die Verknüpfung einer Modellantwort mit überprüfbaren, externen Quellen oder Daten – etwa durch Retrieval, Tool-Aufrufe oder Live-Suche – statt sich allein auf im Training gelerntes Wissen zu verlassen.
****Buzzword-Bingo:** „Gegroundet“ wird manchmal als Sicherheitsversprechen verkauft. Grounding senkt das Halluzinationsrisiko, eliminiert es aber nicht – ein Modell kann eine reale Quelle trotzdem falsch zusammenfassen oder falsch zuordnen.
#### Guardrails
Mechanismen, die die Ein- oder Ausgaben eines LLM-Systems auf unerwünschte Inhalte prüfen oder einschränken – von einfachen Regex-Filtern bis zu eigenen Klassifikations-Modellen.
****Buzzword-Bingo:** „Wir haben Guardrails“ sagt nichts darüber aus, wie robust sie sind. Ein einzelner Prompt-Zusatz wie „Antworte nicht zu X“ ist kein Guardrail im belastbaren Sinn, sondern eine Bitte an ein System, das nicht zuverlässig gehorcht.
#### Halluzination / Konfabulation
Eine vom Modell erzeugte Aussage, die faktisch falsch oder erfunden ist, aber sprachlich genauso selbstsicher und flüssig formuliert wird wie eine korrekte Aussage. „Konfabulation“ wird von manchen als präziserer Begriff bevorzugt, weil er nicht suggeriert, das Modell „sehe“ etwas, das nicht da ist.
****Buzzword-Bingo:** „Wir haben Halluzinationen im Griff“ ist eine Behauptung, die kaum vollständig einlösbar ist – das Phänomen lässt sich reduzieren (Grounding, RAG, Guardrails), aber bisher nicht zuverlässig auf null bringen. Skepsis ist bei absoluten Aussagen hier angebracht.
#### Harness
Die Ausführungsumgebung, die einem Agenten Werkzeuge, Grenzen und eine Feedback-Schleife bereitstellt – etwa wie Claude Code oder ein CI-Runner Tool-Calls entgegennimmt, ausführt und Ergebnisse zurückgibt.
****Buzzword-Bingo:** Wird manchmal fälschlich synonym mit „Framework“ verwendet. Unterschied: Ein Harness ist näher an der Laufzeitumgebung, ein Framework eher an der Struktur, in der Agentenlogik geschrieben wird.
#### Human-in-the-loop
Ein Systemdesign, bei dem an definierten Punkten ein Mensch eine KI-generierte Entscheidung oder Ausgabe prüft, bevor sie wirksam wird oder weiterläuft.
****Buzzword-Bingo:** „Human-in-the-loop“ wird manchmal als Sicherheitsversprechen genannt, ohne dass klar ist, wie viele Fälle der Mensch tatsächlich sieht und wie gründlich geprüft wird. Ein Freigabe-Klick ohne echte inhaltliche Prüfung ist Human-in-the-loop nur dem Namen nach.
#### Hyperscaler
Die großen Cloud-Anbieter – AWS, Microsoft Azure, Google Cloud –, die die Infrastruktur bereitstellen, auf der die meisten LLM-Anbieter trainieren und hosten.
****Buzzword-Bingo:** Kein Bingo-Kandidat, eher Infrastruktur-Vokabular – relevant im DSGVO-Kontext, weil Serverstandort und Auftragsverarbeitung daran hängen.
#### Jailbreak
Eine Formulierungstechnik, die versucht, die Sicherheitsregeln eines Modells über geschickte Prompt-Gestaltung zu umgehen – etwa durch Rollenspiel-Rahmung oder mehrstufige Umleitung.
****Buzzword-Bingo:** Siehe Prompt Injection – die Abgrenzung lohnt sich, weil beide unterschiedliche Gegenmaßnahmen brauchen.
#### JSON Mode
Eine oft ältere oder einfachere API-Funktion, die lediglich garantiert, dass die Ausgabe syntaktisch valides JSON ist – ohne Garantie, dass sie einem bestimmten Schema (Feldnamen, Typen) entspricht.
****Buzzword-Bingo:** JSON Mode wird häufig mit Structured Outputs verwechselt oder gleichgesetzt. Der Unterschied ist praktisch relevant: valides JSON ist kein Garant dafür, dass die erwarteten Felder überhaupt vorhanden sind.
Ausführlich in: [LLM-Datenformate: Wie man mit einem Modell spricht – und in welcher Sprache es antwortet](https://t01.li/ki-systemdesign/llm-datenformate-json-yaml-xml-toon-html-im-vergleich/)
#### KI-Crawler
Bots, die Websites im Auftrag von KI-Anbietern (GPTBot, ClaudeBot, PerplexityBot u. a.) besuchen, um Trainingsdaten zu sammeln oder Live-Antworten zu grounden. Unterscheiden sich von klassischen Suchmaschinen-Crawlern in Verhalten und Absicht.
****Buzzword-Bingo:** „Wir blockieren alle KI-Crawler“ klingt nach Kontrolle, ignoriert aber oft, dass manche Crawler – etwa für Live-Retrieval – Sichtbarkeit bringen, andere nur fürs Training sammeln. Pauschales Blocken ohne Differenzierung ist keine Strategie, sondern Bequemlichkeit.
#### Kontextfenster (Context Window)
Die maximale Menge an Text, gemessen in Tokens, die ein Modell in einer einzelnen Anfrage gleichzeitig verarbeiten kann – Eingabe, bisheriger Verlauf und Ausgabe zusammengenommen.
****Buzzword-Bingo:** Ein großes Kontextfenster garantiert nicht, dass das Modell alles darin gleich gut nutzt. Relevante Information am Anfang eines sehr langen Kontexts wird nachweislich schlechter berücksichtigt als Information am Ende – Größe ist nicht gleich Nutzung.
#### LLM / Large Language Model
Ein auf sehr großen Textmengen trainiertes neuronales Netz, das Wahrscheinlichkeiten für die Fortsetzung von Text vorhersagt – Grundlage praktisch aller aktuellen KI-Chat- und Assistenzsysteme.
****Buzzword-Bingo:** Kein Bingo-Kandidat im eigentlichen Sinn, aber ein Grundbegriff, der oft mit „KI“ gleichgesetzt wird, obwohl LLMs nur eine Teilmenge von KI-Systemen sind.
#### LLM-as-a-Judge
Der Einsatz eines – meist stärkeren – Sprachmodells, um die Ausgabe eines anderen Modells zu bewerten, etwa für automatisierte Qualitätsprüfung in großem Maßstab, wo menschliche Bewertung zu aufwendig wäre.
****Buzzword-Bingo:** Das bewertende Modell hat eigene Verzerrungen und Schwächen – „von einem LLM geprüft“ ist keine neutrale, objektive Qualitätsgarantie, sondern eine zweite, ebenfalls fehleranfällige Meinung.
#### LLM-Pipeline
Die Verkettung mehrerer Verarbeitungsschritte rund um einen oder mehrere LLM-Aufrufe – etwa Vorverarbeitung, Retrieval, Modellaufruf, Nachbearbeitung, Validierung.
****Buzzword-Bingo:** „Pipeline“ wird oft für einen einzelnen Prompt-Response-Aufruf verwendet, der gar keine Verkettung enthält. Der Begriff trägt nur, wenn tatsächlich mehrere unterscheidbare, nacheinander laufende Schritte existieren.
#### MCP
Model Context Protocol – ein offener Standard, über den LLMs strukturiert auf externe Tools und Datenquellen zugreifen, ohne dass für jede Integration ein eigenes Custom-Format nötig ist.
****Buzzword-Bingo:** Nicht jede Tool-Integration braucht MCP. Der Nutzen zeigt sich erst, wenn dieselbe Tool-Anbindung über mehrere Clients oder Modelle hinweg wiederverwendet wird – für eine einmalige Anbindung ist es oft Overhead.
#### Memory
Mechanismen, mit denen ein KI-System Informationen über eine einzelne Anfrage hinaus behält – von einfachem Gesprächsverlauf bis zu persistenten, strukturierten Fakten über einen Nutzer.
****Buzzword-Bingo:** „Das System hat Memory“ sagt nichts über Umfang, Persistenz oder Kontrollmöglichkeiten aus. Ein paar Zeilen Gesprächsverlauf im Kontextfenster ist etwas anderes als eine durchsuchbare, nutzerseitig einsehbare Faktenbasis.
#### Mixture-of-Experts (MoE)
Eine Modellarchitektur, bei der pro Anfrage nur ein Teil der insgesamt vorhandenen Parameter – „Experten“ – aktiv gerechnet wird, statt aller. Das erlaubt große Gesamtmodelle bei geringeren Rechenkosten pro Anfrage.
****Buzzword-Bingo:** „MoE“ wird manchmal als reines Effizienz-Gütesiegel verkauft, ohne dass klar ist, wie die Experten geroutet werden. Schlechtes Routing kann Qualitätsverluste verursachen, die die Effizienzgewinne wieder auffressen.
#### Model Card
Eine vom Anbieter veröffentlichte Dokumentation zu einem Modell – Trainingsdaten, soweit offengelegt, Limitierungen, empfohlene und nicht empfohlene Anwendungsfälle, Benchmark-Werte.
****Buzzword-Bingo:** Wird oft als reines Marketing-Datenblatt behandelt und ungeprüft übernommen. Benchmark-Werte einer Model Card sind selten unabhängig reproduziert – als alleinige Entscheidungsgrundlage zu dünn.
#### Modell-Parameter
Die trainierten Gewichte eines neuronalen Netzes – ihre Anzahl, oft in Milliarden angegeben, ist ein grober Indikator für Modellgröße, nicht für Qualität.
****Buzzword-Bingo:** „Mehr Parameter“ wird oft unreflektiert mit „besser“ gleichgesetzt. Kleinere, gezielt trainierte Modelle schlagen größere in spezifischen Aufgaben regelmäßig – Parameteranzahl allein ist ein schwacher Qualitätsproxy.
#### Observability / Tracing
Das Nachvollziehbarmachen, was in einem LLM-System bei einer Anfrage tatsächlich passiert ist – welche Prompts, Tool-Calls, Zwischenschritte und Kosten pro Schritt angefallen sind. Tracing bezeichnet konkret die Aufzeichnung des einzelnen Ausführungspfads.
****Buzzword-Bingo:** „Wir haben Observability“ ohne konkrete Aussage darüber, was geloggt und wie lange es aufbewahrt wird, ist wenig belastbar. Gerade bei mehrstufigen Agenten-Systemen ist Tracing keine Nice-to-have-Ergänzung, sondern oft die einzige Möglichkeit, Fehlverhalten überhaupt zu diagnostizieren.
#### Open Weights
Modelle, deren trainierte Parameter öffentlich zum Download verfügbar sind – im Gegensatz zu Modellen, die nur über eine API zugänglich sind. Sagt nichts über die Offenlegung der Trainingsdaten oder des Trainingscodes aus.
****Buzzword-Bingo:** Wird oft mit „Open Source“ gleichgesetzt. Ein Modell mit offenen Gewichten, aber unbekannten Trainingsdaten und proprietärer Trainingspipeline ist nicht im gleichen Sinn offen wie klassische Open-Source-Software.
#### Prompt Injection
Ein Angriff, bei dem über Eingabedaten – Nutzertext, abgerufene Dokumente, Tool-Ergebnisse – Anweisungen eingeschleust werden, die das Modell von seinem eigentlichen Auftrag ablenken oder gegen ihn richten.
****Buzzword-Bingo:** Wird oft mit Jailbreak verwechselt. Unterschied: Prompt Injection nutzt meist fremde, externe Inhalte als Vektor, Jailbreak zielt direkt über die Nutzereingabe auf die Systemregeln des Modells selbst.
#### Prompt Engineering
Das gezielte Formulieren einzelner Anfragen an ein LLM – Wortwahl, Beispiele, Rollenvorgaben, Ausgabeformat –, um eine bestimmte Antwortqualität zu erreichen. Im Unterschied zu Context Engineering bezieht es sich auf die einzelne Formulierung, nicht auf die gesamte Informationsarchitektur einer Anfrage.
****Buzzword-Bingo:** Wird oft als eigenständige Disziplin verkauft, obwohl es meist Trial-and-Error mit ein paar Heuristiken ist. Ein „Prompt-Engineering-Kurs“, der nur Formulierungstricks lehrt, aber nichts über Modellverhalten oder Evaluierung vermittelt, bleibt an der Oberfläche.
#### Quantisierung
Die Reduktion der Zahlengenauigkeit, mit der Modell-Parameter gespeichert werden – etwa von 16-Bit auf 4-Bit –, um Speicherbedarf und Rechenaufwand zu senken, meist bei geringem, aber nicht verschwindendem Qualitätsverlust.
****Buzzword-Bingo:** „Kein spürbarer Qualitätsverlust“ ist eine Behauptung, die von der konkreten Aufgabe abhängt. Bei einfachen Aufgaben stimmt das oft, bei komplexem Reasoning zeigt sich der Verlust deutlicher.
#### RAG
Retrieval-Augmented Generation – ein Modell ruft vor der Antwortgenerierung relevante Dokumente aus einer externen Wissensbasis ab und nutzt sie als zusätzlichen Kontext, statt sich nur auf Trainingswissen zu verlassen.
****Buzzword-Bingo:** „Wir haben RAG“ ohne Angaben zur Retrieval-Qualität ist wenig aussagekräftig – ein schlechter Retriever liefert dem Modell irrelevanten Kontext, und die Antwort wird dadurch nicht automatisch besser, nur anders falsch.
#### Reasoning Effort / Thinking Budget
Ein einstellbarer Parameter, der steuert, wie viel interne Rechenzeit bzw. wie viele Tokens ein Reasoning-Modell für seinen Denkprozess vor der Antwort verwenden darf.
****Buzzword-Bingo:** Mehr Reasoning Effort bedeutet nicht automatisch eine bessere Antwort – bei einfachen Aufgaben kann übermäßiges „Nachdenken“ sogar zu überkomplizierten oder inkonsistenten Ergebnissen führen. Die Einstellung sollte zur Aufgabenkomplexität passen, nicht pauschal maximiert werden.
#### Reasoning-Modell / Non-Reasoning-Modell
Reasoning-Modelle erzeugen vor der eigentlichen Antwort einen mehrschrittigen internen Denkprozess (Chain-of-Thought), der explizit für komplexere, mehrstufige Aufgaben optimiert ist. Non-Reasoning-Modelle antworten direkter, ohne diesen expliziten Zwischenschritt – meist schneller und günstiger, aber bei komplexen logischen Aufgaben tendenziell schwächer.
****Buzzword-Bingo:** „Reasoning“ wird oft mit „Qualität“ gleichgesetzt. Für einfache, gut definierte Aufgaben liefert ein Non-Reasoning-Modell oft ein vergleichbares Ergebnis, schneller und günstiger – Reasoning ist kein genereller Qualitätsmodus, sondern ein Werkzeug für eine bestimmte Aufgabenklasse.
Ausführlich in: [Reasoning ist kein Qualitätsmodus – wann Denkmodelle Geld sparen und wann sie nur langsam sind](https://t01.li/ki-systemdesign/reasoning-ist-kein-qualitaetsmodus/)
#### Repo oder Repository
Ein versioniertes Verzeichnis mit Code, meist unter Git verwaltet – die Arbeitsgrundlage, auf der Coding-Agenten operieren.
****Buzzword-Bingo:** Kein eigentlicher Bingo-Kandidat, eher Grundvokabular. Trägt seinen Platz im Glossar, weil viele Agent-Workflows stillschweigend voraussetzen, dass klar ist, was gemeint ist, wenn ein Agent „das Repo durchsucht“.
#### Reranking
Ein zweiter Bewertungsschritt nach dem initialen Retrieval, bei dem ein spezialisiertes Modell die zunächst gefundenen Kandidaten-Dokumente noch einmal genauer nach Relevanz zur Anfrage sortiert.
****Buzzword-Bingo:** Reranking wird manchmal als optionales Extra dargestellt, ist aber bei vielen RAG-Systemen der Schritt, der die Retrieval-Qualität am stärksten verbessert. Wer RAG ohne Reranking baut und trotzdem hohe Präzision verspricht, überspringt einen in der Praxis oft entscheidenden Schritt.
#### Self-Consistency
Eine Technik, bei der dieselbe Anfrage mehrfach unabhängig beantwortet und anschließend die häufigste oder konsistenteste Antwort ausgewählt wird, um die Zuverlässigkeit bei Aufgaben mit mehreren möglichen Lösungswegen zu erhöhen.
****Buzzword-Bingo:** Erhöht Rechenkosten proportional zur Anzahl der Durchläufe – „Self-Consistency einbauen“ klingt nach kostenlosem Qualitätsgewinn, ist aber ein bewusster Trade-off zwischen Zuverlässigkeit und Ressourcenverbrauch.
#### Semantic Search
Suche, die auf Bedeutungsähnlichkeit (über Embeddings) basiert statt auf exaktem Wort- oder Keyword-Abgleich – findet auch Ergebnisse, die anders formuliert sind, aber inhaltlich passen.
****Buzzword-Bingo:** Semantic Search ersetzt klassische Keyword-Suche nicht immer besser – bei sehr präzisen, eindeutigen Suchbegriffen (Produktnummern, Eigennamen) kann klassische Volltextsuche zuverlässiger sein. Hybrid-Ansätze sind oft die bessere Wahl als reines Entweder-oder.
#### Structured Outputs
Eine Modell- bzw. API-Funktion, die garantiert, dass die Ausgabe einem vorgegebenen Schema (z. B. JSON-Schema) entspricht – durchgesetzt auf Ebene des Generierungsprozesses, nicht nur durch Anweisung im Prompt.
****Buzzword-Bingo:** Zu unterscheiden von reinem „im Prompt nach JSON fragen“ – Structured Outputs im engeren Sinn erzwingt die Struktur technisch, statt nur darum zu bitten. Anbieter, die beides unter demselben Namen bewerben, verwischen einen relevanten Unterschied.
Ausführlich in: [LLM-Datenformate: Wie man mit einem Modell spricht – und in welcher Sprache es antwortet](https://t01.li/ki-systemdesign/llm-datenformate-json-yaml-xml-toon-html-im-vergleich/)
#### Tokenizer
Die Komponente, die Text in die kleineren Einheiten – Tokens – zerlegt, mit denen ein Modell tatsächlich rechnet. Nicht zwangsläufig ganze Wörter, oft Wortteile oder einzelne Zeichen.
Buzzword-Bingo: „Mehr Kontext-Tokens“ wird oft mit „mehr Text“ gleichgesetzt, ohne zu bedenken, dass unterschiedliche Sprachen und Tokenizer unterschiedlich viele Tokens pro Wort brauchen – ein Vergleich über Modelle oder Sprachen hinweg ohne Tokenizer-Kenntnis hinkt.
Ausführlich in: [Claude Sonnet 5 ist da – näher an Opus, aber mit Sternchen beim Preis](https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/)
#### Tool Calling (Function Calling)
Die Fähigkeit eines LLM, strukturierte Aufrufe an definierte Funktionen oder Tools zu generieren, statt nur Freitext zu produzieren – Grundlage für alles, was ein Modell tatsächlich „tun“ kann.
****Buzzword-Bingo:** Kein eigentlicher Bingo-Begriff, aber häufig missverstanden: Das Modell führt die Funktion nicht selbst aus, es generiert nur den Aufruf. Die Ausführung übernimmt die Anwendung drumherum.
#### Vektor-Datenbank
Eine Datenbank, die auf das effiziente Speichern und Durchsuchen von Embeddings spezialisiert ist – zentrale Infrastrukturkomponente für RAG-Systeme.
****Buzzword-Bingo:** „Wir nutzen eine Vektor-Datenbank“ sagt nichts über die Qualität des Retrievals aus. Gute Embeddings in einer schlecht konfigurierten Vektor-Datenbank liefern trotzdem irrelevante Ergebnisse, wenn Indexierung oder Ähnlichkeitsmetrik nicht zur Aufgabe passen.
#### WebMCP
Ein vorgeschlagener browserseitiger Standard, über den Websites selbst strukturierte Tools/Fähigkeiten bereitstellen, die KI-Agenten direkt im Browser ansteuern können – als Gegenstück zum serverseitigen MCP.
****Buzzword-Bingo:** Noch früher Entwicklungsstand – Vorsicht bei Formulierungen, die WebMCP als etablierten, breit unterstützten Standard darstellen, statt als Vorschlag/Entwurf.
#### Zero Shot
Eine Anfrage ohne mitgelieferte Beispiele – das Modell soll die Aufgabe allein aus der Beschreibung lösen.
****Buzzword-Bingo:** Eher Gegenstück zu Few Shot als eigener Bingo-Punkt. Erwähnenswert vor allem, wenn Zero-Shot-Fähigkeit als genereller Qualitätsbeweis verkauft wird – sie sagt nichts über Zuverlässigkeit bei komplexeren, unklar formulierten Aufgaben aus.
## Wochenrückblick abonnieren
Jeden Montag – die KI-Woche eingeordnet: Was generative KI in echten Projekten taugt, was maßlos überschätzt wird und wo Versprechen auf Realität trifft.
Abonnieren
Email sent! Check your inbox to complete your signup.
Kein Spam. Abmeldung jederzeit möglich.
### Security Policy
URL: https://t01.li/security-policy/
Last updated: 2026-08-20T19:04:39.000Z
## Geltungsbereich
Diese Policy gilt für t01.li und die darunter öffentlich erreichbaren Dienste. Dienste Dritter – insbesondere Mailversand, Zahlungsabwicklung und Hosting-Infrastruktur – fallen nicht darunter; bitte wende dich dafür direkt an den jeweiligen Anbieter.
## Nicht erwünscht
- DoS-, Last- oder Stresstests jeder Art
- Social Engineering oder Phishing gegen mich, Leser oder Dienstleister
- physischer Zugriff auf Infrastruktur
- Zugriff auf fremde Member-Konten oder -Daten. Falls du versehentlich auf Daten Dritter stößt: Test sofort abbrechen, nichts speichern oder weitergeben, mir Bescheid geben.
- reine Scanner-Ausgaben ohne belegten Impact – fehlende oder „zu schwache“ HTTP-Header, SPF-/DMARC-Härtungsgrade, Clickjacking auf Seiten ohne Formular, Versionsangaben in Bannern, TLS-Konfigurationsgrade
## Meldung
Per Mail an **security@t01.li**, gerne Deutsch oder Englisch. Hilfreich sind: betroffene URL, Reproduktionsschritte und eine kurze Einschätzung, was ein Angreifer damit konkret erreichen könnte.
## Was du erwarten kannst
Ich betreibe t01.li als Einzelperson in meiner Freizeit. Es gibt **keine garantierte Reaktionszeit und keinen SLA**. Ich lese jede Meldung, antworte aber nur auf solche mit nachvollziehbarem Impact.
## Kein Bounty
Für Meldungen wird **keine Vergütung** gezahlt – weder Geld noch Sachleistungen oder Gutscheine. Rechnungen, Zahlungsaufforderungen oder „Invoice“-Mails im Nachgang zu einer Meldung werden ohne Antwort verworfen. Auf Wunsch nenne ich dich nach Behebung namentlich auf dieser Seite.
## Safe Harbor
Wenn du dich an diese Policy hältst, gutgläubig handelst, keine Daten Dritter abgreifst, veröffentlichst oder zerstörst und mir vor einer Veröffentlichung angemessen Zeit zur Behebung gibst, betrachte ich deine Tests als autorisiert und werde keine rechtlichen Schritte gegen dich einleiten. Diese Zusage kann ich nur für mich selbst geben – nicht für Hoster, Dienstleister oder sonstige Dritte.
## Offenlegung
Bitte veröffentliche eine Schwachstelle nicht vor ihrer Behebung. Wenn ich 90 Tage nach deiner Meldung nicht reagiert habe, steht dir die Veröffentlichung frei.
*Stand: 20\. August 2026*
## English Version
*This is a translation for convenience. In case of discrepancies, the German version above prevails.*
### Scope
This policy covers t01.li and the services publicly reachable under it. Third-party services—in particular, email delivery, payment processing and hosting infrastructure—are not covered; please contact the respective provider directly for those.
### Out of bounds
- denial-of-service, load or stress testing of any kind
- social engineering or phishing targeting me, readers or service providers
- physical access to infrastructure
- accessing other people's member accounts or data. If you inadvertently come across third-party data: stop testing immediately, do not store or share anything, and let me know.
- raw scanner output without demonstrated impact—missing or "weak" HTTP headers, SPF/DMARC hardening levels, clickjacking on pages without forms, version banners, TLS configuration grades
### Reporting
By email to **security@t01.li**, in German or English. Helpful details: the affected URL, steps to reproduce, and a brief assessment of what an attacker could actually achieve with it.
### What to expect
I run t01.li as an individual in my spare time. There is **no guaranteed response time and no SLA**. I read every report, but I only reply to those with demonstrable impact.
### No bounty
Reports are **not compensated – no** money, no goods, no vouchers. Invoices, payment demands or "invoice" emails following a report are discarded without reply. On request, I will credit you by name on this page once the issue is fixed.
### Safe harbour
If you follow this policy, act in good faith, do not access, publish or destroy third-party data, and give me reasonable time to fix the issue before disclosing it, I will consider your testing authorised and will not pursue legal action against you. I can only give this assurance on my own behalf – not for hosting providers, service providers or any other third parties.
### Disclosure
Please do not publish a vulnerability before it has been fixed. If I have not responded within 90 days of your report, you are free to publish.
*Last updated: 2026-08-20*
### Generative Engine Optimization (GEO)
URL: https://t01.li/generative-engine-optimization-geo/
Last updated: 2026-09-11T21:47:50.000Z
Vor drei Jahren war „Generative Engine Optimization“ ein Begriff aus einem einzigen Forschungspapier. Heute ist es eine eigene Software-Kategorie, in die zwischen Sommer 2025 und Frühjahr 2026 über 300 Millionen $ Risikokapital geflossen sind. Dazwischen liegt der übliche Weg jeder neuen Marketing-Disziplin – erst die Substanz, dann die Tools, dann die Leute, die dir die Tools verkaufen, bevor du die Substanz verstanden hast.
Das Problem an GEO ist nicht, dass es Unfug wäre (Surprise: ist es nicht). Es ist, dass die belastbare Forschung ziemlich beiläufig dasselbe sagt wie gutes SEO seit Jahren, während die Szene parallel Abkürzungen anpreist, die messbar nichts bringen. Und die zweite kantige Sache: In KI-Antworten sichtbar zu sein, ist nicht dasselbe wie Besuch zu bekommen. Besuch ist noch lange keine Anfrage.
Diese Seite sortiert GEO einmal von unten nach oben – was dahintersteckt, wie die Modelle ihre Quellen auswählen, welche Maßnahmen wirklich etwas tun und ab wann sich der Aufwand für dein Unternehmen rechnet.
## TL;DR
GEO ist keine neue Disziplin neben SEO, sondern dessen Fortsetzung mit anderen Mitteln. Wer die Grundlagen überspringt und auf Tricks setzt, optimiert für ein Publikum, das gar nicht erscheint.
- Der Begriff wurde 2023 von Forschern geprägt. Wirksam sind Quellenangaben, Zahlen und Zitate – Keyword-Stuffing brachte nichts.
- LLMs bevorzugen Seiten mit extrahierbarer Evidenz: klare Definitionen, konkrete Zahlen, Vergleiche.
- llms.txt bringt für Sichtbarkeit derzeit nichts. Google liest die Datei nicht, die meisten KI-Bots fordern sie nicht mal an.
- Sichtbarkeit ist nicht Traffic. In KI-Antworten klickt kaum jemand auf die zitierte Quelle.
- Für KMU zählt GEO vor allem bei erklärungsbedürftigen B2B-Themen – nicht überall gleich stark.
## Was ist GEO?
[Generative Engine Optimization](https://t01.li/glossar/#geo) meint die Optimierung von Inhalten darauf, in den Antworten generativer Systeme aufzutauchen – in *ChatGPT*, *Perplexity*, *Gemini*, *Claude* oder den AI Overviews von Google. Der Unterschied zur klassischen Suche steckt im Wort „Antwort“. Eine Suchmaschine liefert eine Liste von Links, aus der du wählst. Ein generatives System liefert eine fertige Antwort, in die es mehrere Quellen einschmilzt – und entscheidet dabei selbst, welche davon überhaupt vorkommen.
Der Begriff stammt aus einem Papier von Forschern aus Princeton, Georgia Tech, dem Allen Institute for AI und dem IIT Delhi, veröffentlicht im November 2023\. Die Kernaussage war schon damals bemerkenswert bodenständig: Gezielte Optimierung kann die Sichtbarkeit in generativen Antworten um bis zu 40 % erhöhen. Was wirkte, waren [Quellenangaben](https://t01.li/glossar/#ai-citation), eingebaute Statistiken, Zitate von Fachleuten und eine klare, autoritative Sprache. Was nicht wirkte: Keyword-Stuffing. Das getestete Zauberwort-Prinzip aus zwei Jahrzehnten SEO fiel als Erstes durch.
Abgekürzt formuliert: GEO belohnt Inhalte, die eine Maschine sauber zerlegen und weiterverwenden kann. Nicht mehr, nicht weniger.
## GEO vs. SEO – und wo AEO reinpasst
Die häufigste Fehlannahme kommt von Kunden, die sagen: „Wir brauchen jetzt eine GEO-Strategie“, und damit meinen, GEO sei etwas Getrenntes neben SEO. Getrennt ist es aber nicht: Techniken wie Quellen zitieren, Zahlen belegen und Aussagen präzise formulieren sind Erweiterungen dessen, was gutes SEO ohnehin verlangt. Wenn ein Mensch, der Googlebot und ein LLM dieselbe Seite besuchen, sollten alle drei mit demselben Verständnis wieder herausgehen.
| | SEO | GEO |
| ------------------ | -------------------------------------------------------- | ----------------------------------------------------------- |
| **Ziel** | Ranking in der Ergebnisliste, Klick auf die eigene Seite | Erwähnung oder Zitat in der generierten Antwort |
| **Auswahl-Logik** | Relevanz, Autorität, Links – über den Index, dauerhaft | Retrieval im Moment der Anfrage, dann Auswahl und Übernahme |
| **Erfolgsmessung** | Position, Klicks, organischer Traffic | Share of Model, Citations – 2026 noch lückenhaft messbar |
| **Zeithorizont** | stabil über Wochen und Monate | volatil, Zitate flüchtig (10,6 % über 28 Tage stabil) |
Dann gibt es noch [AEO](https://t01.li/glossar/#aeo-answer-engine-optimization), Answer Engine Optimization. Gemeint ist die Optimierung auf direkte Antworten – Featured Snippets, „Ähnliche Fragen“, zunehmend die AI Overviews. Die Grenze zu GEO ist fließend und die Kürzel werden in der Praxis ohnehin durcheinandergeworfen. Für dich ist die korrekte Trennung weniger wichtig als das gemeinsame Fundament: Alle drei leben von Struktur, Autorität und überprüfbaren Fakten.
Der praktische Schluss aus dieser Abgrenzung ist unbequem für alle, die sich ein separates GEO-Budget erhofft haben. Es gibt keine GEO-Maßnahme, die ein kaputtes SEO-Fundament repariert.
## Wie LLMs Quellen auswählen
Hier wird es konkret, denn die Auswahl läuft anders, als man so denken könnte. Die Modelle raten nicht aus dem Gedächtnis, welche Seite gut ist. Sie suchen im Moment der Anfrage – und zwar mehrfach.
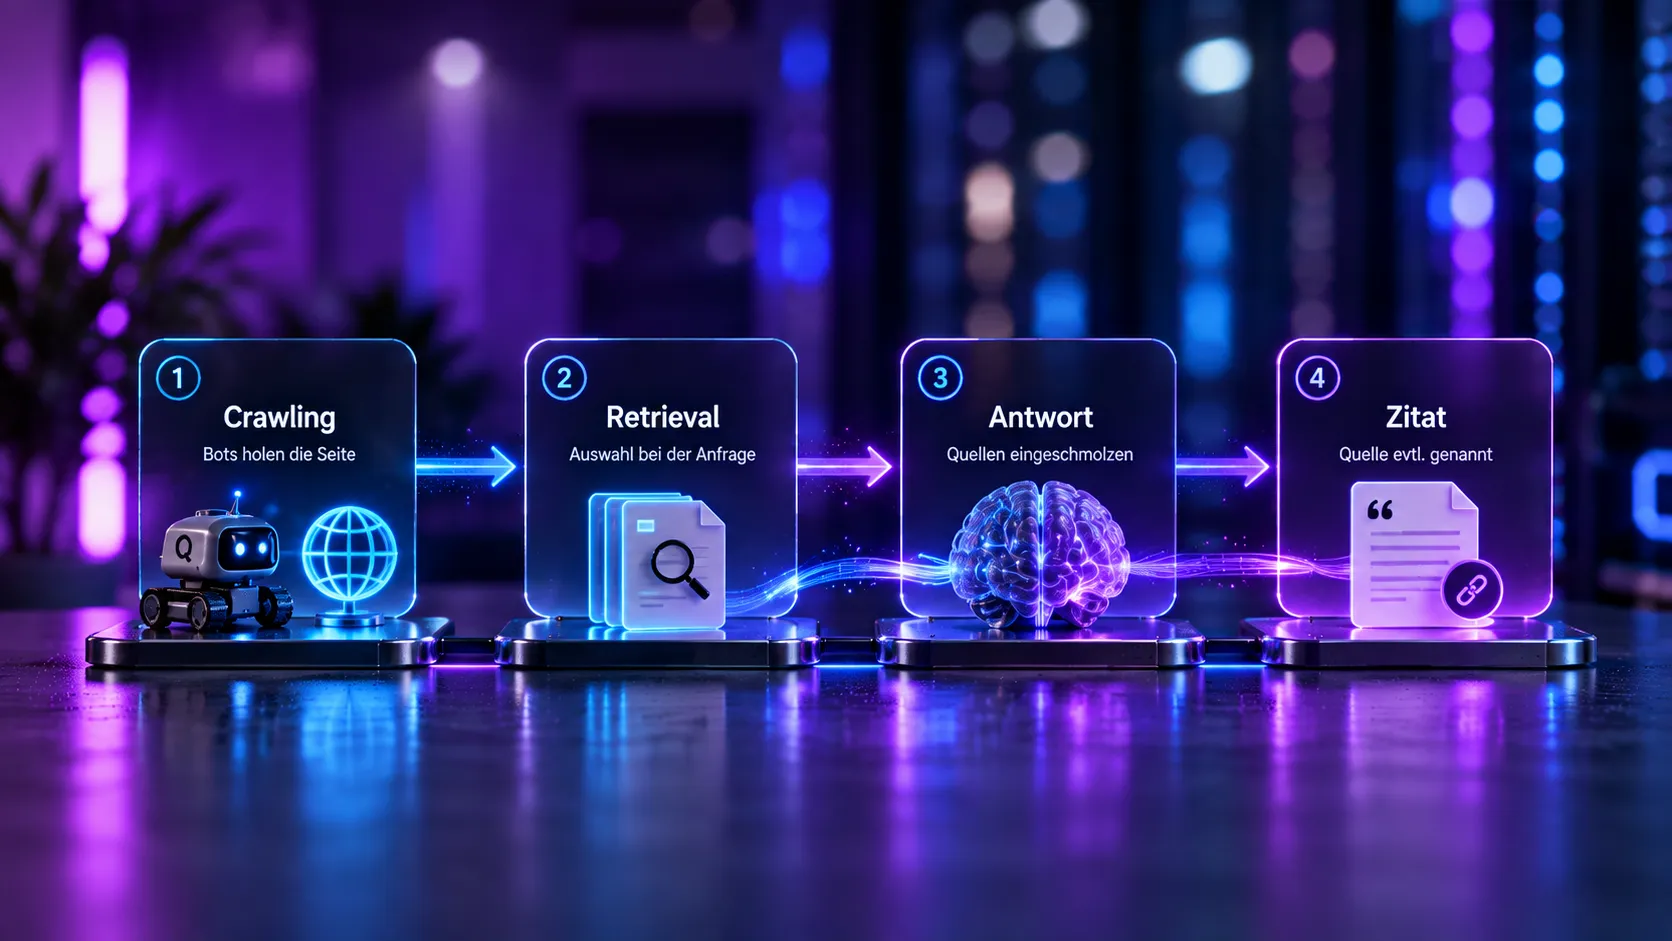
*ChatGPT* zerlegt einen einzelnen Prompt in [fünf bis fünfzehn Unterabfragen](https://blog.chatfeatured.com/how-ai-models-choose-sources-what-gets-cited-in-chatgpt-perplexity-and-gemini?ref=t01.li), schickt die an Bing und baut aus den Treffern seine Antwort. Es gibt mittlerweile Indizien, dass OpenAI für ChatGPT derzeit auch einen eigenen Index aufbaut. Bevorzugt werden Seiten, bei denen die entscheidende Information in den ersten 200 bis 500 Wörtern steht, nicht erst nach dem dritten Zwischenkapitel. *Perplexity* arbeitet breiter und zieht pro Antwort oft zwanzig und mehr Quellen heran. Google wiederum spannt für die AI Overviews sein bestehendes Ranking mit ein. Drei Systeme, drei Temperamente – aber ein gemeinsamer Filter davor.
Der Filter heißt Auffindbarkeit über die klassische Suche. Wer dort nicht auftaucht, taucht auch in der [retrieval-gestützten](https://t01.li/glossar/#rag) Antwort nicht auf. Ein belastbares [technisches SEO-Fundament](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/) ist damit keine Schönwetteraufgabe, sondern die Bedingung dafür, dass GEO überhaupt greift.
Relevanter als die reine Auswahl ist die Frage, welche Seiten am Ende wirklich etwas zur Antwort beitragen. Eine [aktuelle Analyse von über 600 Prompts und mehr als 21.000 Citations](https://arxiv.org/pdf/2604.25707?ref=t01.li) zeigt ein klares Muster. Hoch-einflussreiche Seiten sind länger, modular aufgebaut und enthalten extrahierbare Evidenz – Definitionen, Zahlen, Vergleiche, Schritt-für-Schritt-Abläufe. Ein Befund verdient besondere Aufmerksamkeit, weil er einer beliebten GEO-Empfehlung widerspricht: Reines Frage-Antwort-Format allein verbessert die Übernahme nicht. Eine Seite, die nur in FAQ-Optik daherkommt, aber keine belastbare Substanz liefert, wird zitiert wie jede andere dünne Quelle – also eher selten. (Der Datensatz stammt aus einem Preprint, ist also noch nicht durch ein Peer-Review gelaufen – das ist also nicht das letzte Wort in dieser Angelegenheit.)
Zwei Zahlen zur Einordnung, die den Boden unter der GEO-Euphorie leicht schwanken lassen. Erstens: Bei *ChatGPT* ist [Wikipedia mit 7,8 % die meistzitierte Einzelquelle, Reddit macht rund 12 % aus](https://discoveredlabs.com/blog/chatgpt-claude-perplexity-and-google-ai-overviews-how-each-platform-cites-sources-differently?ref=t01.li). Ein erheblicher Teil dessen, was die Modelle als Wahrheit ausgeben, kommt also aus Enzyklopädie und Forum, nicht von optimierten Unternehmensseiten. Zweitens: Die Citations sind flüchtig. Eine [Längsschnittmessung fand nur 10,6 %](https://everything-pr.com/how-ai-engines-cite-the-web-the-six-studies-that-define-the-2026-evidence-base?ref=t01.li) der zitierten URLs über einen Zeitraum von 28 Tagen stabil wieder. Was heute deine Antwort stützt, kann in vier Wochen verschwunden sein, ohne dass du etwas falsch gemacht hast.
## Maßnahmen: technische Basis, llms.txt, Schema, E-E-A-T
Kaum ein GEO-Thema wurde 2026 so heiß gekocht wie die Idee, eine Markdown-Datei namens [llms.txt](https://t01.li/geo-seo/llms-txt-liest-kein-bot/) ins Wurzelverzeichnis zu legen, damit KI-Systeme die Seite besser verstehen. Google nutzt die Datei nicht und plant es absehbar nicht; [John Mueller verglich sie öffentlich mit dem keywords-Meta-Tag](https://www.searchenginejournal.com/googles-mueller-says-llms-txt-cant-help-llms-differentiate-sites/579304/?ref=t01.li) – jenem selbst gemeldeten Signal, dem Suchmaschinen vor über einem Jahrzehnt das Vertrauen entzogen haben, weil jede Seite von sich behauptet, die beste zu sein. Eine Ahrefs-Auswertung von 137.000 Seiten fand, dass 97 % der llms.txt-Dateien im Mai 2026 null Traffic bekamen. Die Bots forderten sie überwiegend gar nicht erst an.
Einen schmalen Nutzen gibt es schon – bei Developer-Tooling und eigenen RAG-Pipelines, wo du selbst kontrollierst, was ein Modell liest. Für Sichtbarkeit in der KI-Suche liefert die Datei heute nichts Nachweisbares.
### Schema und strukturierte Daten
[Strukturierte Daten](https://t01.li/glossar/#structured-output) helfen Maschinen, den Inhalt einer Seite eindeutig zu lesen. Drei Schema-Typen sind hier sinnvoll: [Article](https://schema.org/Article?ref=t01.li) für den Beitrag selbst, [FAQPage](https://schema.org/FAQPage?ref=t01.li) für den Frageblock, [BreadcrumbList](https://schema.org/BreadcrumbList?ref=t01.li) für die Navigation. Das ist gute Praxis und schadet nie. Nur sollte niemand Schema mit einem Zauberknopf verwechseln – es macht deinen Inhalt lesbarer, nicht automatisch zitierwürdiger. Substanz kann Schema nicht ersetzen, es kann sie nur besser auszeichnen.
### E-E-A-T als Eintrittskarte
Damit eine Seite überhaupt in die engere Auswahl kommt, braucht sie erkennbare Autorität – basierend auf Erfahrung, Fachkenntnis, Reputation, Vertrauen. Die Modelle bevorzugen Quellen, die sie einordnen können. Ein namenloser Text ohne Autor, ohne Beleg, ohne Wiedererkennung startet mit einem Handicap, das keine technische Maßnahme aufwiegt. E-E-A-T ist kein Zertifikat, das man beantragt, sondern etwas, das über Zeit entsteht.
## Messung und Monitoring
Sobald GEO Budget kostet, kommt die Frage nach der Wirkung. Die neue Metrik heißt je nach Anbieter „Share of Model“ oder Visibility-Index – gemeint ist der Anteil der relevanten Prompts, in denen deine Marke auftaucht. Dazu kommen Citation-Tracking, Sentiment und Prompt-Level-Monitoring über mehrere Engines hinweg.
Der Werkzeugmarkt hat sich rasant sortiert. Am oberen Ende steht *Profound*, mit [über 150 Millionen $ Funding](https://www.surmado.com/blog/best-ai-visibility-tools-2026?ref=t01.li) und Enterprise-Ausrichtung. Im Mittelfeld spielt *Peec AI*, für den Einstieg gibt es *Otterly* ab 29 $ im Monat. Wer ohnehin in einer SEO-Suite lebt, findet Aufsätze wie das *Semrush AI Visibility Toolkit* oder *Ahrefs Brand Radar*. Ein Hinweis, den kein Tool-Anbieter gern hört: Viele der beworbenen Effektzahlen sind herstellereigene Werte ohne unabhängige Gegenmessung. Behandle sie entsprechend.
Eine unterschätzte, kostenlose Datenquelle liegt direkt auf deinem Server – das Logfile. Dort lässt sich [nachvollziehen, welche KI-Crawler die eigenen Seiten abgreifen](https://t01.li/geo-seo/logwerk-weil-ich-nur-sehen-wollte-welche-bots-den-log-vollmullen/), etwa GPTBot oder ClaudeBot, bevor irgendein Dashboard eine Zahl daraus macht.
## Lohnt sich GEO für dein Unternehmen? Ein ehrlicher Kassensturz
Jetzt die Rechnung, die in den allermeisten GEO-Guides fehlt: Sichtbarkeit klingt gut, aber sie zahlt keine Rechnungen. Sehen wir uns also an, was am Ende dabei ankommt.
Die Klick-Zahlen sind recht eindeutig. Laut einer [Verhaltensstudie von Pew Research](https://www.similarweb.com/blog/marketing/geo/zero-click-marketing/?ref=t01.li) klicken Nutzer bei vorhandener AI Overview nur noch in 8 % der Fälle auf ein organisches Ergebnis, ohne Overview sind es 15 %. Auf die zitierten Quellen in der Overview selbst klickt gerade mal 1 %. Für den deutschsprachigen Raum zeigt eine [Sistrix-Auswertung](https://www.sistrix.de/news/ai-overviews-in-deutschland-so-stark-sinken-die-klickraten-wirklich/?ref=t01.li) dasselbe Bild. Die Klickrate auf Position 1 fällt mit AI Overview von 27 % auf 11 %.
Und wer glaubt, die KI-Chats gleichen das aus, sollte einen Blick auf die [Verweis-Zahlen von Cloudflare Radar](https://blog.cloudflare.com/agentic-internet-bot-report/?ref=t01.li) werfen. Google liefert weiterhin rund 88 % des Such-Referral-Traffics, *ChatGPT* als schnellster KI-Aufsteiger kam im Juli 2026 auf nicht einmal 1 %. Von Google kommt also fast hundertmal so viel Verweis-Traffic wie vom größten KI-Chat.
Für Seiten, die von Anfragen leben, ist die [reine Citation die falsche KPI](https://t01.li/geo-seo/geo-citations-bringen-keine-conversions/) – eine Erwähnung ohne Klick bringt keine Anfrage. Das heißt nicht, dass Sichtbarkeit wertlos ist. [Seer Interactive fand](https://www.omnibound.ai/blog/zero-click-search-statistics?ref=t01.li), dass in AI Overviews zitierte Marken auf derselben Query 35 % mehr organische Klicks bekommen. Der Effekt ist real, nur eben kleiner und indirekter, als die Tool-Prospekte suggerieren.
Am stärksten lohnt sich GEO dort, wo Kaufentscheidungen erklärungsbedürftig sind und lange vor dem eigentlichen Kontakt vorbereitet werden. [Bain hat es in einer Studie zugespitzt](https://www.omnibound.ai/blog/zero-click-search-statistics?ref=t01.li): 85 % der B2B-Käufer kaufen von ihrer „Tag-eins“-Anbieterliste – der Liste, die im Kopf entsteht, bevor jemand überhaupt zu suchen anfängt. Wenn du auf diese Liste willst, ist Präsenz in KI-Antworten ein echter Vorteil. Betreibst du dagegen ein lokales oder rein transaktionales Geschäft, in dem der organische Klick weiterhin die Anfrage bringt, steht GEO weit hinten in der Prioritätenliste.
Und die agentische Zukunft, in der KI-Agenten selbst auf deiner Seite handeln? Die Technik dafür steht, aber [agentisches SEO](https://t01.li/geo-seo/agentisches-seo-strukturierte-daten-agenten/) bleibt vorerst eine Nische – interessant zu beobachten, kein Grund, heute Ressourcen umzuschichten.
Mein Take: GEO ist kein neues Spiel, sondern gutes SEO mit einem erweiterten Publikum. Bau das Fundament, schreib zitierfähige Substanz, miss nüchtern. Und lass dir die Vanity-Metrik Citation nicht als Umsatz verkaufen.
## FAQ
#### Was ist Generative Engine Optimization?
GEO ist die Optimierung von Inhalten darauf, in den Antworten generativer KI-Systeme wie **ChatGPT*, **Perplexity* oder den AI Overviews von Google zitiert und übernommen zu werden. Der Begriff wurde 2023 in einem Forschungspapier geprägt.
#### Ersetzt GEO klassisches SEO?
Nein. GEO ist die Fortsetzung von SEO, kein Ersatz. Ohne technisches Fundament und auffindbare Inhalte kommt eine Seite in generativen Antworten gar nicht erst vor.
#### Brauche ich eine llms.txt-Datei?
Für Sichtbarkeit in der KI-Suche derzeit nicht. Google nutzt die Datei nicht, und Studien finden keinen Zusammenhang zwischen llms.txt und häufigeren Citations. Einen schmalen Nutzen gibt es bei Developer-Tooling und eigenen RAG-Pipelines. Es schadet aber auch nicht.
#### Wie messe ich GEO-Erfolg?
Über den Anteil der Prompts, in denen deine Marke auftaucht („Share of Model“), über Citation-Tracking und Sentiment. Tools reichen von **Otterly* (ab 29 $) bis **Profound* im Enterprise-Segment. Ergänzend lohnt der Blick ins Server-Logfile, um KI-Crawler direkt zu sehen.
#### Bringt eine Citation in der KI-Antwort automatisch Traffic?
Nein. In KI-Antworten klickt nur ein kleiner Teil der Nutzer auf die zitierte Quelle. Sichtbarkeit und Besuch sind zwei verschiedene Dinge – für Seiten, die von Anfragen leben, zählt am Ende die Conversion, nicht die Erwähnung.
#### Wie schnell wirkt GEO?
Nicht über Nacht. Realistisch sind mehrere Monate konsistenter Arbeit an Substanz und Autorität. Und die Citations selbst sind volatil – ein Teil dessen, was heute zitiert wird, ist in vier Wochen wieder verschwunden.
## Posts
### llms.txt: Der Standard, den kein Bot abholt
URL: https://t01.li/geo-seo/llms-txt-liest-kein-bot/
Last updated: 2026-09-10T06:33:25.000Z
Das Sichtbarkeit in generativen Systemen ([GEO](https://t01.li/generative-engine-optimization-geo/)), ohne sauberes technisches Fundament reine Spekulation bleibt, hatte ich [hier schon mal](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/) erwähnt. Ein Baustein, der in jeder zweiten LinkedIn-Predigt zu dem Thema auftauchte, ist die `llms.txt`. Ohne die, so der Tenor über Monate, bist du bei der KI-Sichtbarkeit komplett raus.
Also habe ich das Diskutieren sein lassen und stattdessen in die Logs geschaut. Drei Monate, fünf Websites, ein Auswertungstool. Das Ergebnis schon mal vorab: Auf keiner einzigen der beobachteten Seiten hat sich ein Bot für die `llms.txt `interessiert, kein einziger.
## TL;DR
Die `llms.txt` soll KI-Systemen zeigen, welche Seiten deiner Website die wichtigen sind. Nur holt sie kaum jemand ab.
- Vorgeschlagen im September 2024 von Jeremy Howard (Answer.AI), aber kein von IETF oder W3C ratifizierter Standard, sondern eine Konvention.
- Google ignoriert die Datei offiziell; OpenAI und Anthropic steuern ihre Crawler über die `robots.txt` und pflegen eine `llms.txt` nur für die eigene Doku.
- In drei Monaten Server-Logs über fünf Websites: kein einziger Zugriff eines Search- oder AI-Bots auf die `llms.txt`. Ahrefs misst über 137.000 Domains dasselbe Muster.
- Realen Nutzen hat sie nur, wenn du einem Coding-Agenten deine Doku direkt übergibst, nicht für die organische AI-Sichtbarkeit deiner Seite.
## Woher die llms.txt kommt und was sie eigentlich sein will
Die `llms.txt` wurde am 3\. September 2024 von Jeremy Howard vorgeschlagen, Mitgründer von Answer.AI. Die Spezifikation liegt bis heute unter [llmstxt.org](https://llmstxt.org/?ref=t01.li). Was aber oft untergeht: Es handelt sich um einen Community-Vorschlag und nicht um einen ratifizierten Standard. Weder IETF noch W3C haben hier etwas verabschiedet, und eine Instanz, die irgendetwas durchsetzt, gibt es nicht. Wer von einem „offiziellen Standard“ spricht, meint eine gut dokumentierte Konvention.
Die Idee dahinter ist gut: Ein Sprachmodell arbeitet mit einem begrenzten [Kontextfenster](https://t01.li/glossar/#kontextfenster), und eine normale Website steckt voller Navigation, Skripte und Ballast, den ein Modell nicht braucht. Die `llms.txt `ist als Gegenstück zur Sitemap gedacht, nur eben für Maschinen – eine kuratierte Markdown-Karte deiner wichtigen Seiten. Dazu gibt es optional die `llms-full.txt`, die den Volltext gleich mitliefert, damit ein Agent alles in einem Rutsch laden kann. Sauber gedacht. Bleibt die Frage, ob es jemanden gibt, der das liest.
## Was laut Spec überhaupt in der llms.txt stehen soll
Die Spezifikation unter [llmstxt.org](https://llmstxt.org/?ref=t01.li) ist bewusst schlank gehalten. Pflicht ist genau ein Element: eine H1 mit dem Namen der Site oder des Projekts. Also kein Werbe-Claim, sondern schlicht der Name. Alles andere ist optional, aber durchaus empfohlen.
Direkt unter die H1 gehört ein Blockquote mit einer knappen Zusammenfassung. Dieser Satz ist wichtiger, als er aussieht. Er ist das Erste, was ein Modell liest, und soll laut Specs wörtlich übernommen werden, wenn jemand fragt, worum es auf der Seite geht. Darunter darf freier Markdown-Text folgen, Absätze oder Listen, für zusätzlichen Kontext. Nur keine weiteren Überschriften, bis der nächste Block beginnt.
Der eigentliche Nutzwert steckt in den H2-Abschnitten. Jeder H2 ist eine Kategorie, darunter eine Markdown-Liste aus Links im Format `[Titel](URL): kurze Notiz`. Das ist der Sitemap-Gedanke in kuratiert. Nicht jede URL, sondern die, die du einem Modell tatsächlich vorlegen willst.
Ein Detail ist sehr interessant, weil es die Datei erst praktikabel macht: der Abschnitt `## Optional: `Links, die dort stehen, dürfen von einem Parser übersprungen werden, wenn der Kontext knapp wird. Alles Nice-to-have wandert dorthin, ohne die Pflichtlektüre zu verdrängen. Wer zusätzlich eine `llms-full.txt` bereitstellt, liefert den kompletten Volltext dieser Seiten in einer Datei, damit ein Agent alles in einem einzigen Fetch laden kann.
So sieht eine minimale, aber vollständige `llms.txt` aus:
```markdown
# Beispiel GmbH
> Wir bauen systemübergreifende Software für die Lagerlogistik mittelständischer Betriebe. Diese Datei verweist auf die Seiten, die ein KI-System zuerst lesen sollte.
Die Produkt-Doku ist die verlässlichste Quelle. Preise und Verfügbarkeit ändern sich, dafür bitte immer die Live-Seiten prüfen.
## Produkt
- [Funktionsüberblick](https://example.com/produkt): was die Software kann, in zwei Absätzen
- [Preise](https://example.com/preise): aktuelle Tarife und Grenzen
## Doku
- [Schnellstart](https://example.com/docs/schnellstart): Installation und erster Lauf
- [API-Referenz](https://example.com/docs/api): Endpunkte und Datentypen
## Optional
- [Blog-Archiv](https://example.com/blog): ältere Beiträge, bei knappem Kontext überspringbar
- [Impressum](https://example.com/impressum)
```
**Was hier passiert, Element für Element:**
- Die H1 (`# Beispiel GmbH`) ist der Name, kein Slogan. Das einzige Pflichtfeld.
- Das Blockquote darunter ist die Kurzzusammenfassung, die ein Modell gern wörtlich übernimmt, wenn jemand fragt, worum es geht.
- Der Absatz danach ist freier Kontext ohne Überschrift, hier ein Hinweis, welche Quelle verlässlich ist und welche nicht.
- Die H2-Abschnitte (`## Produkt`, `## Doku`) sind kuratierte Link-Listen, jeder Link mit einer knappen Notiz nach dem Doppelpunkt.
- `## Optional` ist der einzige Abschnittsname mit Sonderbedeutung. Was hier steht, darf ein Parser bei knappem Kontext überspringen. Gut für Archiv, rechtliche Seiten und alles andere, das nicht zur Pflichtlektüre gehört.
Das ist die ganze Spezifikation. Kein Schema-Zwang, kein Validator, der etwas ablehnt. Genau diese Niedrigschwelligkeit ist der Grund, warum sich die Datei so schnell verbreitet hat und, wie die Logs zeigen, leider so wenig bewirkt.
## Was die Anbieter offiziell sagen
Google ist bei dem Thema ungewohnt deutlich. Das [im Juni 2026 aktualisierte Guide](https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?ref=t01.li) im Search Central hält fest, dass man keine maschinenlesbaren Zusatzdateien oder Markdown braucht, um in der Suche aufzutauchen, auch nicht in den generativen Features. Zur `llms.txt` heißt es dort schlicht, Google Search ignoriere sie. Das kommt von Gary Illyes, und dieser hatte schon im Juli 2025 auf dem Search Central Live in der APAC-Region bestätigt, dass Google die Datei nicht unterstützt und das auch nicht vorhat. John Mueller verglich sie öffentlich mit dem alten Keywords-Meta-Tag, jenem Relikt, das Suchmaschinen irgendwann komplett ignoriert haben.
Bei OpenAI und Anthropic sieht es nicht besser aus. Beide steuern ihre Crawler über die `robots.txt`, in der Crawler-Doku taucht die `llms.txt` nicht auf. Aber hier eine kleine Pointe am Rande: Beide pflegen selbst eine eigene `llms.txt`, nämlich für ihre jeweilige Entwickler-Doku. Der Vorschlag hat also durchaus Abnehmer. Es sind die LLM‑Anbieter selbst, aber auch die nutzen ihn nicht, um fremde Seiten besser zu lesen.
## Was tatsächlich in den Logs steht
Ausgewertet habe ich mit [Logwerk](https://github.com/abbottis/logwerk?ref=t01.li), einem eigenen kleinen [Log-Analyzer-Projekt](https://t01.li/geo-seo/logwerk-weil-ich-nur-sehen-wollte-welche-bots-den-log-vollmullen/), das über 70 Crawler unterscheidet und mir zeigt, welcher Bot auf welche Datei zugreift. Dabei war die Auswahl bewusst nicht zufällig. Drei größere Sites aus unserem Kundenstamm bei [klartxt](https://klartxt.de/?ref=t01.li), dazu zwei eigene Projekte, darunter dieses Blog. „Größer“ heißt hier mindestens 150 eindeutige Besucher am Tag, die Domains laufen seit Jahren, Crawler werden nicht ausgesperrt, und `llms.txt`, Sitemap, `robots.txt` sowie strukturierte Daten sind hinterlegt. Ein Mix aus Dienstleistung, E-Commerce und B2C- und B2B-Information, quer durch die Search Intentions. Zeitraum: Juni bis August 2026.
Bei den [KI-Crawlern](https://t01.li/glossar/#ki-crawler) habe ich mir gezielt die größten Frontier-Anbieter angesehen, mit Schwerpunkt auf Anthropic, Google, Bing, OpenAI und Perplexity (okay, das ist nur bedingt Frontier, aber trotzdem relevant). Die `robots.txt` holt sich jeder von denen ab, gerne mehrfach am Tag. Der ClaudeBot kam an Spitzentagen auf bis zu acht Abrufe. Bei der Sitemap wird es interessanter, weil es Ausnahmen gibt. OAI-SearchBot und PerplexityBot ignorieren sie, und zwar auch dann, wenn sie in der `robots.txt` sauber referenziert ist.
Bleibt das Markdown, das den Bots aktiv angeboten wird. Einzelne Seiten werden zusätzlich als Markdown-Datei bereitgestellt und weisen die Crawler per Link-Header darauf hin. Abgeholt hat es genau einer: der [FacebookExternalHit](https://developers.facebook.com/docs/sharing/webmasters/crawler?ref=t01.li), Metas Crawler für Link-Vorschauen. Der zieht sich den Content, wenn irgendwo ein Link geteilt wird, und hat mit KI-Retrieval oder GEO nichts zu tun. Selbst Markdown, das frei Haus geliefert wird, will also kein AI-Crawler haben.
Für die `llms.txt` gilt das leider erst recht. Sie liegt am Standard-Ort `/llms.txt `im Root, genau dort, wo ein Bot sie von sich aus abfragen müsste/sollte. Über drei Monate, über alle fünf Seiten, hat das kein einziger Search- oder AI-Bot getan, nicht ein Request.
Damit das keine Einzelbeobachtung von fünf Sites bleibt: Ahrefs hat 137.000 Domains ausgewertet und in einer [im Juni 2026 veröffentlichten Studie](https://ahrefs.com/blog/llmstxt-study/?ref=t01.li) festgestellt, dass 97 % der `llms.txt`\-Dateien im Mai 2026 überhaupt nicht abgerufen wurden. Und bei den wenigen Dateien, die überhaupt Zugriffe bekamen, stammte gerade einmal gut ein Prozent der Anfragen von echten AI-Retrieval-Bots. SE Ranking fand über rund 300.000 Domains keine Korrelation zwischen der Datei und AI-Citations. Die Logs, die ich mir angesehen habe, sind also kein Ausreißer, sondern eine kleine, konsistente Bestätigung dessen, was die großen Auswertungen längst zeigen.
## Wo die llms.txt trotzdem etwas taugt
Damit hier nicht der Eindruck entsteht, die `llms.txt` sei kompletter Unsinn, gehört eine ehrliche Abgrenzung dazu. Es gibt einen Kontext, in dem sie real hilft, und das ist die Nutzung zur Laufzeit. Wenn du einem Coding-Agenten wie *Cursor* oder *Claude Code* eine Doku übergibst, spart eine gepflegte `llms.txt` oder `llms-full.txt` echte Arbeit. Ein Fetch statt zehn, sauberer Markdown-Kontext statt HTML-Gestrüpp. Mike King von iPullRank hat im Mai 2026 zu Recht angemerkt, dass man die Datei nicht abschreiben sollte, nur weil Google sie ignoriert, denn Systeme mit anderer Retrieval-Architektur könnten sie verarbeiten.
Der Haken an diesem Argument liegt dann aber im Wörtchen „übergibst“: In diesen Fällen entdeckt niemand deine Datei da draußen im Netz. Du reichst sie aktiv rein, in einem geschlossenen Werkzeug-Kontext. Das ist ein legitimer Anwendungsfall für Entwicklerdokumentationen. Also kein Sichtbarkeitssignal für deine Firmenseite in ChatGPT, Claude oder Perplexity – zumindest aktuell, Stand September 2026.
## Resümee
Gegen einen schlanken Standard wie die `llms.txt` ist wenig einzuwenden. Die Idee ist schwer in Ordnung, die Umsetzung minimal, und wer sie für seine Doku pflegen will, sollte genau das gern tun. Nur ändert ein Standard, den kein relevanter Abnehmer abfragt, an deiner [GEO](https://t01.li/glossar/#geo)\-Sichtbarkeit exakt gar nichts. Dann pflegst du eine Datei, damit ein Ordner nicht leer aussieht.
Interessant finde ich, wie ruhig es an der Predigt-Front geworden ist. Vor ein paar Monaten war die Botschaft auf LinkedIn und anderswo noch, dass du ohne `llms.txt` bei der KI-Sichtbarkeit abgehängt bist. Diese Stimmen sind deutlich leiser geworden. Vielleicht haben sie auch mal in ihre Logs geschaut.
### AI Picks der 36. KW
URL: https://t01.li/ai-shorts/ai-picks-der-36-kw/
Last updated: 2026-09-06T07:19:26.000Z
Die Modellwochen sind wieder eingeläutet, diesmal mit den Frontiers vorweg – OpenAI, Anthropic, Google und Meta haben innerhalb von vier Tagen abgeworfen. Daneben gab’s ordentlich Zuwachs bei den [Open Weights](https://t01.li/glossar/#open-weights), ein „europäisches Flaggschiff“ mit chinesischem Motor. Reichlich Ware also, dafür mal kein Gossip. Damit rein in die 36\. Kalenderwoche des Jahres 2026.
## GPT-6 Astra
Bei OpenAI ist am 3\. September *GPT-6 Astra* hinten raus gefallen, und in der Launch-Meldung spielen sie ein bisschen Microsoft – zumindest, was Superlative und Tonalität angeht. „Neue Generation der Intelligenz“ steht drüber, Greg Brockman hat das Presse-Briefing mit „Welcome to the AGI era“ beendet. Das, was nicht aus OpenAIs eigener Tabelle stammt, klingt nüchterner: Artificial Analysis führt Astra und den Vorgänger *GPT-5.6 Sol* beide mit 61 Punkten im Intelligence Index.
In erster Linie ist Astra das bessere agentische Modell zum höheren Preis. Computer Use ist der eigentliche Sprung, auf OSWorld 2.0 meldet OpenAI 72,6 statt 65,7 % – herstellereigen und auf einem Offline-Subset gemessen. Für *Codex* gibt es eine zweite Gedächtnisschicht aus Notizen und einer Suche über frühere [Kontextfenster](https://t01.li/glossar/#kontextfenster), die gegen die übliche Compaction-Amnesie helfen soll. Dann der Preis – 10 $ Input und 50 $ Output je Million Tokens, das 2,5-Fache von Sol. Pro Index-Task rechnet Artificial Analysis mit 1,67 statt 0,95 $.
[Die ausführliche Einordnung zu Astra](https://t01.li/ki-news/gpt-6-astra-vs-gpt-5-6-sol/) steht seit Freitag hier.
## Claude Fable 5.1 und Mythos 5.1
Auch Anthropic hat ein „Flagship“ rausgelassen, und ich schreibe ganz bewusst nur „ein“. [*Fable 5.1* und *Mythos 5.1*](https://t01.li/ki-news/claude-fable-5-1-mythos-5-1-safeguards/) sind dasselbe Modell mit unterschiedlich permissiven Safeguards davor – Fable für alle, Mythos vorerst für eine Handvoll geprüfter US-Organisationen. Der Unterschied liegt nicht im trainierten Modell, sondern im System drumherum.
Wie viel dieses System kostet, steht diesmal offen in der Launch-Tabelle. Auf Terminal-Bench 4.0 kommt Fable auf 55,8 %, Mythos auf 60,9 %. Dasselbe Modell, dieselben Aufgaben, 5,1 Punkte Differenz – gemessen allerdings noch mit den älteren, gröberen Cyber-Filtern. Mit den neuen Safeguards, die pro Claude-Code-Session rund 60 % seltener eingreifen sollen, dürfte die Lücke schrumpfen. Sagt Anthropic. Ob sie das tut, zeigt erst eine unabhängige Nachmessung.
Der Preis bleibt bei 10/50 $, nur Cache-Reads sinken um 75 % auf 0,25 $. Womit Astra und Fable 5.1 seit Donnerstag exakt dasselbe Preisschild tragen.
## Muse Spark 1.3
Meta ist das Fast-Fashion-Label unter den Herstellern und entlässt mit [*Muse Spark 1.3*](https://t01.li/ki-news/muse-spark-1-3/) das vierte Muse-Spark-LLM in fünf Monaten. Und es zeichnet sich klar ein Trend ab: Alle optimieren auf agentische Fähigkeiten, denn hier liegt das Geld auf der Straße. Chat ist nicht tot, taucht in den Launch-Meldungen aber kaum noch auf.
Was Meta in die Hände spielen könnte, ist die Kombination aus Preis und Kurve. Artificial Analysis misst 61 Punkte für xhigh, 1.2 lag bei 57, 1.1 bei 53 – mit jedem Release wird’s messbar besser. Damit steht Muse gleichauf mit *GPT-5.6 Sol* (max), *Grok 4.6* (high) und *Claude Opus 5* (high), bei unveränderten 1,25/4,25 $ je Million Tokens. Unter allen Modellen ab 59 Indexpunkten erledigt aktuell keines eine Aufgabe billiger.
Der Haken hängt an der Kostenrechnung. Pro Index-Task steigt der Preis von 0,40 auf 0,55 $, weil 1.3 in den agentischen Evals rund 57 % mehr Input-Tokens zieht. Gleicher Tokenpreis, teurere Aufgabe – das Muster begleitet uns diese Woche noch öfter. Auf meiner Testliste steht 1.3 trotzdem weit oben, [1.2 hatte ich in der 32\. KW schon kurz in der Hand](https://t01.li/ai-shorts/ai-picks-der-32-kw/#muse-code-und-muse-spark-12).
## Gemini 3.8 Flash
Auch Google trimmt [*Gemini 3.8 Flash*](https://t01.li/ki-news/gemini-3-8-flash/) auf Coding- und Agentenfähigkeiten. Dritter Flash-Release in sechs Wochen, das große Modell fehlt weiterhin. Auf dem Papier kostet das neue Modell dasselbe wie 3.7 Flash – 0,75 $ Input und 3,75 $ Output –, führt aber mehr Reasoning-Schritte aus und ruft häufiger Tools auf. Artificial Analysis misst den Effekt schon: 0,58 statt 0,40 $ pro Index-Task auf high, bei drei Punkten mehr im Index (59 statt 56). Medium landet bei 57 und kostet pro Aufgabe ungefähr das, was 3.7 auf high gekostet hat.
Die 0,75 und 3,75 $ sind Einführungspreise bis zum 31\. Dezember, ab Januar 2027 verdoppeln sie sich auf 1,50 und 7,50 $. Wer absehbar Workflows umstellt, rechnet also schon mal vorausschauend mit dem Standardpreis.
3.7 Flash hat sich bei mir in den letzten Wochen zum treuen Arbeitspferd gemausert – Sprachnachrichten transkribieren und strukturieren, Webseiten zusammenfassen und in Markdown mit Frontmatter gießen, HTML und CSS generieren – fast alles davon als Arbeitstier in *n8n*\-Workflows. Das Human in the Loop war ich beim Input, der Rest lief zuverlässig durch. Ob 3.8 auf medium denselben Job günstiger erledigt als 3.7 auf high, gilt es dann eben zu testen.
## Qwen3.8-Max-0902
Alibaba hat auch wieder zugeschlagen und am 2\. September [*Qwen3.8-Max-0902*](https://x.com/Alibaba%5FQwen/status/2094968708288680276?ref=t01.li) rausgeworfen – kein neuer Versionsname, sondern ein Snapshot, weiter post-trained auf Coding und Cowork-Tasks. 2,4 Billionen Parameter, 1 Mio. Token Kontextfenster, 2 $ Input und 6 $ Output je Million Tokens [über QwenCloud](https://www.qwencloud.com/models/qwen3.8-max-0902?ref=t01.li).
Und der Snapshot hinterlässt Einschläge. Ich gebe eigentlich nicht so viel auf Arena-Rankings, aber [Platz 1 in der Code Arena: WebDev](https://x.com/arena/status/2094974637704913198?ref=t01.li) direkt am ersten Tag, mit 1.691 Punkten drei vor *Claude Opus 5* (Max), 17 vor *Kimi K3* (Max) und 22 vor dem eigenen Vorgänger – Respekt. Dazu die Spitzenposition auf der Pareto-Front bei rund 5 $ Blended Price.
Damit das niemand falsch liest: Das ist die WebDev-Arena, nicht die Text-Arena. Im Artificial Analysis Index steht der Vorgänger bei 58 gegen 62 für *Fable 5*, und eine Messung für den Snapshot gibt es dort noch nicht. Beim Frontend-Bauen ganz vorn, beim allgemeinen Reasoning eine Etage tiefer.
## Spark-X2.5
Open Weights in zwei Geschmacksrichtungen: [*Spark-X2.5*](https://github.com/XHToken/Spark-X2.5?ref=t01.li) kommt als 1.7B und 4B, mit nativem 1-Mio.-Token-Kontextfenster und Apache-2.0-Lizenz, [auf Hugging Face](https://huggingface.co/collections/XHToken/spark-x25?ref=t01.li) jeweils als Base, Instruct, FP8, INT8 und GGUF. Hinter dem Label XHToken steckt eine Tochter von iFlytek, trainiert wurde auf Huawei-Ascend-Clustern. Was kann das Teil also? [Ollama](https://ollama.com/SparkLLM?ref=t01.li) beschreibt es als kompaktes Allzweckmodell für „conversation, writing, translation, reasoning, coding, tool use, and agentic workflows“, über 200 Sprachen inklusive.
Das lange Kontextfenster läuft über eine Hybrid-Attention – ein Full-Attention-Layer auf drei Sliding-Window-Layer, damit der Speicherbedarf bei langen Kontexten nicht explodiert. Die Integrationen in *Codex*, *Claude Code*, OpenClaw und Hermes liefert iFlytek gleich mit, ebenso Support für vLLM, SGLang, llama.cpp, MLX, Ollama und LM Studio.
Wenn man sich die Größe vor Augen hält, ist das wieder so ein Ding für die bessere Bürokiste – reichlich Potenzial für lokale Agenten, die lange Dokumente durchkauen sollen. Wobei der Speicherfresser nicht das Modell ist, sondern der KV-Cache, sobald du das Kontextfenster wirklich ausreizt. [Benchmarks](https://t01.li/glossar/#benchmark) gibt es bislang nur aus dem eigenen Haus, verglichen mit *Qwen3.5-4B* und *Gemma 4 E4B*. Warten wir auf unabhängige Zahlen. Am 7\. September soll das große *Spark X2.5* mit 293 Milliarden Parametern folgen.
## Quasar 438B
Ich klaue mir mal ein Zitat von [Fefe](https://de.wikipedia.org/wiki/Fefes%5FBlog?ref=t01.li):
> Von Microsoft lernen, heißt siegen lernen.
Beim Ton haben sie bei Multiverse Computing jedenfalls aufgepasst. [„Europe’s Leading AI Model“](https://multiversecomputing.com/resources/introducing-quasar-438b-europe-s-leading-ai-model?ref=t01.li) steht über dem Launch von *Quasar 438B*, einem Reasoning-Modell mit Schwerpunkt auf – na, wer möchte raten? – Agents und Coding. Es versteht sich auf Englisch und Spanisch(!), die Firma sitzt in San Sebastián, und dediziert als europäisches Modell wird es auch verkauft.
Was in der Pressemeldung fehlt, steht bei Artificial Analysis im Modellnamen: „Quasar 438B (max, based on GLM-5.2)“. Das europäische Flaggschiff ist ein komprimiertes [*GLM-5.2*](https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/) von Z.ai aus Peking, durch die hauseigene CompactifAI-Kompression gezogen und proprietär angeboten. Kann man machen. Dann sollte man es aber hinschreiben.
Bei den Zahlen nehmen sie den Mund ganz schön voll, liefern dann aber auch: 43 Punkte im Intelligence Index, damit vor *Mistral Medium 3.5* (30) und *Nemotron 3 Ultra* (38), aber weit hinter *Claude Opus 5* mit 63\. Der nächste Verfolger steht allerdings in ihrer eigenen Tabelle – *Inkling* kommt auf 42\. Ein Punkt Vorsprung trägt kein Flaggschiff-Etikett. [Artificial Analysis](https://artificialanalysis.ai/models/quasar-438b?ref=t01.li) fasst zusammen:
> … is amongst the leading models in intelligence, but particularly expensive when comparing to other models of similar price. It's also notably fast, however very verbose. The model supports text input, outputs text, and has a 1M tokens context window.
Was sie mit teuer meinen: 0,60 $ Input und 1,80 $ Output je Million Tokens bei einem Klassen-Median von 0,25 und 0,90, im Index 350 Millionen Output-Tokens produziert gegen einen Median von 67 Millionen. Der Eval hat Artificial Analysis 1.047,71 $ gekostet.
Heißt für mich: Wer sein Modell als europäisch verkauft, nennt die Basis im ersten Absatz und überlässt die Arbeit nicht Artificial Analysis.
## Muse Voice Transcribe
Damit bei Meta Superintelligence Labs gar nicht erst Langeweile aufkommt, haben sie am 1\. September [ein Echtzeit-Transkriptionsmodell](https://research.meta.ai/blog/introducing-muse-voice-transcribe?ref=t01.li) hinterhergekippt. Streaming-ASR, Diarization für 20 und mehr Sprecher, Endpointing – alles in einem Modell, ohne Post-Processing. Trainiert wurde mit über 70 Sprachen, [25 sind aktiv validiert](https://dev.meta.ai/docs/speech-to-text?ref=t01.li#language-biasing): Arabisch, Bengalisch, Niederländisch, Englisch, Französisch, Deutsch, Hebräisch, Hindi, Indonesisch, Italienisch, Japanisch, Kannada, Koreanisch, Malaiisch, Mandarin-Chinesisch, Marathi, Polnisch, Portugiesisch, Spanisch, Tagalog, Tamil, Telugu, Thailändisch, Türkisch und Vietnamesisch. Code-Switching mitten im Satz geht auch.
Meta sieht sich auf Artificial Analysis beim Streaming-WER mit 3,1 % auf Platz 1\. Die Grafik dazu ist hausgemacht – abgelesen vom AA-Leaderboard, Stand 1\. September.
Auch hier ist der Preis wieder eine echte Ansage: 3 $ je 1.000 Audio-Minuten, also 0,18 $ pro Stunde verarbeitetes Audio, für Streaming und Batch gleich. *Gemini 3.5 Transcribe* [aus der letzten Woche](https://t01.li/ai-shorts/ai-picks-der-35-kw/) liegt zum Vergleich bei rund 5 $ je 1.000 Minuten, die Live-Variante bei 9 $, und AssemblyAI verlangt für Streaming plus Diarization zusammen 0,57 $ die Stunde. Der Endpoint ist OpenAI-SDK-kompatibel.
Was es nicht gibt, sind Open Weights. Anders als bei *Muse Glimmer* bleiben die Gewichte im Haus, das hat Meta gegenüber The New Stack bestätigt. Meine These von letzter Woche, dass jede KI-Bude ein Transkriptionsmodell braucht, bevor sie sich AI-Lab nennen darf, hält damit eine weitere Woche.
## MCP was supposed to solve the agent tooling problem. It missed a step
[The New Stack erklärt Agentic Resource Discovery](https://thenewstack.io/ard-agent-discovery-specification/?ref=t01.li), kurz ARD. Die offene Spezifikation soll Agenten helfen, passende MCP-Server, Skills, APIs und andere Agenten dynamisch zu finden. [MCP](https://t01.li/glossar/#mcp) setzt voraus, dass der Client schon weiß, welchen Server er ansprechen will – ARD ergänzt die fehlende Discovery-Schicht davor. AWS nennt das „DNS, but for agents“, hat die Spec aber nicht geschrieben. Die Autoren kommen von Google, Microsoft und Hugging Face, mitgearbeitet haben Cisco, Databricks, GitHub, Nvidia, Salesforce und ein paar mehr, Lizenz Apache 2.0.
Technisch ist das noch dünn. Version 0.91 vom 26\. August, JSON-LD und REST, ein Pflicht-Endpoint `POST /search`, der nach Aufgaben sucht. Governance offen, eventuell Umzug zu W3C oder einer AI-Foundation. Der DNS-Vergleich hinkt auch, wie der Artikel selbst anmerkt: DNS liefert eine Adresse, ARD liefert mehrere Kandidaten, die alle behaupten, den Job zu können.
## Building commerce agents with Claude
Anthropic hat am 2\. September zwei Posts zu Commerce Agents rausgehauen – [die Produktmeldung](https://claude.com/blog/claude-for-commerce-agents?ref=t01.li) mit Referenzimplementierungen und [den Engineering-Leitfaden](https://claude.com/blog/the-anatomy-of-effective-commerce-agents?ref=t01.li) dazu. Das Repo `anthropics/commerce-agents` enthält einen Shopping- und einen Merchant-Agenten für Retail, Travel, Telco und Ticketing, also Produktsuche, Warenkorb, Kundenservice, Bestandsanalyse, Preisgestaltung und Marketing. Enthalten sind passende Tools, Skills, [Guardrails](https://t01.li/glossar/#guardrails) und ein Claude-Code-Plugin zur Anpassung an eigene Kataloge, Richtlinien und Systeme. Läuft über API, Bedrock, Foundry und Vertex.
Der Leitfaden ist das lesenswertere Stück. Statt vieler spezialisierter Subagenten empfiehlt Anthropic einen zentralen Agenten im Standard-Loop mit Tools und bei Bedarf geladenen Skills, ohne Intent-Router – „Skills, not subagents“. UI-Komponenten werden als Tools behandelt, Latenz und Kosten drückt man über parallele Aufrufe und Prompt-Caching, für den Produktivbetrieb gehören [Memory](https://t01.li/glossar/#memory), Guardrails im Harness und ein [Eval](https://t01.li/glossar/#eval)\-Set dazu. Die Warenkorb-Zahlen in der Meldung – bis zu 35 % größer, 60 % höhere Kaufabschluss-Wahrscheinlichkeit – sind Kundenreferenzen von Shopify und Priceline, keine unabhängige Messung.
Die Architektur-Entscheidung passt zu dem, [was ich am Donnerstag über scheiternde Agenten geschrieben habe](https://t01.li/ki-alltag/ki-agenten-scheitern-daten-scope-ownership/): Scope und Ownership vor Modellwahl. Was das Repo nicht liefert, sind saubere Kataloge und Bestandsdaten. Die musst du weiterhin selbst haben.
## Kimi in Codex und Claude Code
Die [Kimi API](https://platform.kimi.ai/docs/api/?ref=t01.li) spricht drei Protokolle – OpenAI Chat Completions, OpenAI Responses und Anthropic Messages – und lässt sich entsprechend in *Codex* und *Claude Code* schrauben. Für [Codex](https://platform.kimi.ai/docs/guide/codex-kimi?ref=t01.li) reicht ein Eintrag in der `config.toml`, weil Kimi die Responses API nativ bedient, ohne Proxy und ohne Protokollkonvertierung. Für [Claude Code](https://platform.kimi.ai/docs/guide/claude-code-kimi?ref=t01.li) genügen ein paar Umgebungsvariablen auf den Anthropic-Endpoint.
Wer [*Kimi K3*](https://t01.li/ki-news/kimi-k3-weights-lizenz-self-hosting/) also ohne 1,5 TB Blech ausprobieren möchte, kann das im gewohnten Werkzeug tun. Mit den üblichen Sandbox-Warnungen.
## How to Build a Robust RAG System with Minimal Resources
Zum Abschluss ein Handwerksstück, das schon vom 11\. August ist, mir aber erst jetzt in den Feed gespült wurde. [Machine Learning Mastery zeigt](https://machinelearningmastery.com/how-to-build-a-robust-rag-system-with-minimal-resources/?ref=t01.li), wie sich ein robustes [RAG](https://t01.li/glossar/#rag)\-System ohne Cloud und ohne bezahlte APIs aufbauen lässt: quantisiertes lokales Modell (GGUF drückt ein 7B-Modell von 14 auf rund 4 GB), kompaktes Embedding-Modell aus sentence-transformers, dateibasierter [Vektorspeicher](https://t01.li/glossar/#vektor-datenbank) über FAISS oder ChromaDB, Inference über llama.cpp oder Ollama.
Der Teil, der den Artikel von den üblichen Tutorials abhebt, kommt nach der Pipeline. Zuverlässig wird das Ding erst durch das Drumherum – sauberes [Chunking](https://t01.li/glossar/#chunking), Quellenangaben in der Antwort, eine Ähnlichkeitsschwelle, unter der das System „steht nicht in der Wissensbasis“ sagt statt zu halluzinieren, ein kleines Set an Testfragen und Logs, die Retrieval-Fehler von Generierungsfehlern trennen. Das sind die Stellen, an denen die meisten Bastel-RAGs still vor sich hin lügen.
Schluss für diese Woche. Passt wie immer auf eure Agenten auf. Und auch auf eure API-Rechnungen.
### ChatGPT-6 Astra: Mehr Agent als GPT-5.6 Sol
URL: https://t01.li/ki-news/gpt-6-astra-vs-gpt-5-6-sol/
Last updated: 2026-09-06T18:40:50.000Z
OpenAI hat am 3\. September *GPT-6 Astra* vorgestellt. Der Rollout läuft zunächst über eine begrenzte Zahl von Organisationen, Plus, Pro, Business und Enterprise sollen in den kommenden Tagen folgen, dazu die OpenAI-API, Microsoft Azure und AWS Bedrock. Microsoft rollt Astra vorerst über das Foundry Limited Access Program an teilnehmende Kunden aus, für Amazon Bedrock kündigt OpenAI die Verfügbarkeit an, eine eigene AWS-Produktmeldung steht bislang aus. Bei mir ist noch nichts angekommen, daher ist das hier eine erste Einordnung der Daten und der [offiziellen Ankündigung](https://openai.com/index/gpt-6-astra/?ref=t01.li), die diesmal lang genug ist, um mehr als die übliche Benchmark-Parade herzugeben.
*GPT-6 Astra* ist kein günstigeres, schnelleres [*GPT-5.6 Sol*](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/), sondern ein LLM, das auf Computer Use, [Coding-Agenten](https://t01.li/glossar/#coding-agent) und kontrollierte Autonomie zugespitzt wurde. Am Preis lässt sich das ablesen. Während Sol zum aktuellen Aktionspreis 4 $ pro Million Input- und 20 $ pro Million Output-Tokens kostet, ruft OpenAI für Astra 10 beziehungsweise 50 $ auf, jeweils das 2,5-Fache. Diesen Sol-Preis garantiert OpenAI allerdings nur bis zum 21\. November 2026, auf dem alten Listenpreis von 5 und 30 $ läge der Faktor bei 2.
## TL;DR
*GPT-6 Astra* setzt andere Prioritäten als *GPT-5.6 Sol*. Es geht weniger um einen allgemeinen Intelligenz-Sprung als um lange, autonome Arbeit am Rechner.
- Am Launch-Tag führte Artificial Analysis beide Modelle im Intelligence Index gerundet mit 61 Punkten. Seit dem überarbeiteten Index v4.2 (4\. September) sind es 55 für Astra und 51 für Sol – die Modelle sind unverändert, die Kriterien nicht.
- Große Sprünge meldet OpenAI bei Computer Use, Coding, Cybersecurity und Safety – überwiegend aus eigenen Evals.
- Bei Cyber-Fähigkeiten erreicht Astra die Critical-Schwelle des OpenAI-eigenen Preparedness Framework.
- Die API kostet 10 statt 4 $ Input und 50 statt 20 $ Output pro Million Tokens.
- Für *Codex* ist die neue Kontext-Persistenz die praktischste Neuerung, sofern sie hält, was OpenAI verspricht.
💡
****Update vom 6\. September 2026**
Artificial Analysis hat seinen Intelligence Index am 4\. September auf v4.2 umgestellt, einen Zwischenschritt vor dem geplanten v5\. Neu im Index sind AA-Briefcase, ein privater Test für agentische Wissensarbeit, und GDP.pdf von Surge AI, ein Dokument-Reasoning-Test über 4.592 PDF-Seiten. Raus fällt das inzwischen als saturiert eingestufte GPQA Diamond. Der Anteil zurückgehaltener, privater Testsets steigt auf 40 Prozent, doppelt so viel wie zuvor. Kein Modell wurde dafür neu trainiert. Trotzdem verschieben sich die Zahlen: Astra steht jetzt bei 55 Punkten (Rang 2), Sol bei 51 – am Launch-Tag lagen beide gerundet bei 61.
| Merkmal | Astra (max) | Sol (max) |
| --------------------------- | ------------------ | ------------------ |
| Intelligence Index v4.2 | 55 (Rang 2) | 51 (Rang 14) |
| Zuvor (Launch-Index) | rund 61 | rund 61 |
| Kosten je Index-Task¹ | 2,57 $ | 1,25 $ |
| Output-Tokens je Index-Lauf | 49 Mio. | 76 Mio. |
| Output-Speed | 64 Token/s | 83 Token/s |
| Preis Input (1 Mio. Token) | 10 $ | 4 $² |
| Preis Output (1 Mio. Token) | 50 $ | 20 $² |
| Cache-Rabatt | 90 % | 90 % |
| Kontextfenster | 1 Mio. Token | 1 Mio. Token |
| Ein-/Ausgabe | Text + Bild → Text | Text + Bild → Text |
| Release | 03.09.2026 | 09.07.2026 |
¹ Gewichtete AA-Kostenmetrik über die zehn Index-Evals, nicht der Preis eines beliebigen API-Tasks.
² Aktionspreis, garantiert bis 21.11.2026; Listenpreis 5 $ bzw. 30 $.
## Der unabhängige Index bleibt fast stehen
*Der folgende Abschnitt beschreibt den Stand am Launch-Tag; die aktuellen v4.2-Zahlen stehen im Update oben.*
Wenn man auf die Zahl schaut, die nicht aus OpenAIs eigener Tabelle stammt, sieht man erst einmal keinen Erdrutsch. [Artificial Analysis](https://artificialanalysis.ai/models/gpt-6-astra?ref=t01.li) führt *GPT-6 Astra (max)* mit 61 Punkten im Intelligence Index, *GPT-5.6 Sol (max)* ebenfalls mit 61\. Hinter der Rundung steht ein kleiner Abstand, in OpenAIs Vergleichstabelle sind es 61,2 zu 60,9 Punkte.
Ein Gegenbeweis gegen Fortschritt ist das aber nicht und den Index gegen alles andere auszuspielen wäre nicht ehrlich. Auf ARC-AGI-3 springt Astra von 7,8 auf 99,9 %, wobei OpenAI das Modell dort mit einem angepassten Responses-API-Harness laufen ließ. Auf FrontierMath Tier 4 steigt der Wert von 83,0 auf 97,6 %. Wo einzelne Evals derart kippen, bügelt ein Composite aus neun Aufgabenfeldern das glatt. Als kleiner Dämpfer taugt der Index trotzdem – gegen die Überschrift von der neuen Generation der Intelligenz und gegen Greg Brockman, der das Presse-Briefing mit „Welcome to the AGI era“ beendet hat. Für allgemeines Reasoning ist Astra nach diesem Maß nicht in einer anderen Liga.
Die Kostenrechnung dreht das Bild noch einmal. Im Intelligence Index v4.2 misst Artificial Analysis bei Astra rund ein Drittel weniger Output-Tokens pro Aufgabe als bei Sol, 49 gegenüber 76 Millionen über den gesamten Index-Lauf. Der gewichtete Preis liegt trotzdem höher: 2,57 $ pro Index-Task gegenüber 1,25 $ für Sol, weil Astra pro Token 2,5-mal so teuer ist. Gemeint ist die gewichtete Kostenmetrik über die zehn Evals dieser Suite, nicht der Preis eines beliebigen API-Tasks.
## Computer Use ist der eigentliche Sprung
OpenAI setzt den Schwerpunkt auf Computer Use, also Browser bedienen, Formulare ausfüllen, Oberflächen prüfen, Software installieren, Websites testen. Auf OSWorld 2.0 meldet das Unternehmen 72,6 % für Astra gegenüber 65,7 % für Sol. Für den Alltag eines Agenten wiegt die zweite Zahl schwerer: Astra soll dieselben Aufgaben in der Latenz-Simulation in rund 40 statt 75 Minuten erledigt haben.
Beides braucht das übliche Hersteller-Sternchen. Gemessen wird nicht der volle [Benchmark](https://t01.li/glossar/#benchmark), sondern das Offline-Subset mit Partial Score, Stand 8\. August 2026\. Die Laufzeiten stammen aus OpenAIs Demonstrationsläufen, und die veröffentlichten Clips sind laut Fußnote gekürzt. Die 1,9-fache Beschleunigung auf Mind2Web schreibt OpenAI selbst nicht dem Modell allein zu, sondern der Kombination aus Astra und eines aktualisierten *Codex*\-[Harness](https://t01.li/glossar/#harness).
Für die Praxis ist genau das relevant. Wer einen Agenten nicht nur Text produzieren, sondern durch einen Browser, ein CRM oder ein Repo arbeiten lässt, kauft immer das System darum herum mit – Tools, Berechtigungen, [Guardrails](https://t01.li/glossar/#guardrails) und die Art, wie der Agent seinen Zustand hält. Der Fehler wäre nur, den Faktor 1,9 als reine Modellleistung weiterzuerzählen.
## Für Codex: Schluss mit Compaction-Amnesie?
Wenn das [Kontextfenster](https://t01.li/glossar/#kontextfenster) voll läuft, soll Astra in *Codex* künftig Notizen über Fenstergrenzen hinweg behalten und ältere Fenster durchsuchen können. Bisher fasst ein Agent an dieser Stelle zusammen. Compaction spart Kontext und verliert gerne genau den gescheiterten Lösungsweg oder die Randbedingung, die drei Stunden später wieder wichtig wird.
OpenAI verspricht keine magische Endlos-Konversation: das Kontextfenster von einer Million Tokens bleibt. Neu ist eine zweite Gedächtnisschicht aus Notizen für akkumulierte Details und einer Suche über frühere Nachrichten und Tool-Outputs. Bei Refactors, langen Debugging-Sessions und Frontend-Arbeit könnte das mehr verändern als ein paar Punkte auf Terminal-Bench. Feiern werde ich es aber erst, wenn ich einen echten mehrstündigen *Codex*\-Lauf daran brechen darf.
Die Funktion ist zunächst experimentell, über die `config.toml` aktivierbar, und soll in den kommenden Wochen Standard für Astra werden. Wer *Codex* für längere Repo-Arbeit nutzt, sollte den Vergleich deshalb nicht auf „Astra oder Sol?“ verkürzen. Es geht auch um die neue Harness.
## Mehr Cyber-Fähigkeiten, engere Grenzen
Der Absatz, der in vielen Zusammenfassungen untergeht, steht unter Cybersecurity. Astra erreicht dort die Critical-Schwelle des OpenAI-eigenen [Preparedness Framework](https://openai.com/index/updating-our-preparedness-framework/?ref=t01.li), die höhere der beiden definierten Fähigkeitsschwellen. Die Zahlen dahinter stammen aus Läufen ohne Produktionsschutz: ExploitBench 100 % gegen 78,5 % für Sol, SRE-Bench 88,0 % gegen 55,9 % im ersten Versuch. Während der Auswertung fand das Modell zwei bis dahin unbekannte Zero-Days und nutzte sie, OpenAI meldet beide an die Maintainer.
Im Produkt heißt Critical erst einmal weniger, nicht mehr. Astra darf Secure Code Review und Patching, verweigert aber fortgeschrittene Aufgaben wie das Bauen von Proof-of-Concept-Exploits. Lockerere Safeguards soll es in den kommenden Wochen über OpenAI Daybreak geben. Wenn du defensiv arbeitest, wirst du also ausgebremst, bevor du überhaupt richtig anfängst.
Auf der Verhaltensseite zeigt OpenAI strengere Scope-Treue. In einem eigens gebauten Test überschritt Astra nie das autorisierte Ziel, Sol tat das ohne Produktionsschutz in 48 % der Fälle. Ein internes [Halluzinations](https://t01.li/glossar/#halluzination)\-Eval liegt bei 4,2 % gegenüber 12,2 %, bei der Umgehung eines Auto-Review-Stopps meldet OpenAI null Fälle.
Alles davon sind OpenAIs eigene Tests, teils gegen Konfigurationen ohne die Safeguards, die im Produkt aktiv sind. Und im selben Text steht der Satz, der es in keine Launch-Grafik geschafft hat: Astras schriftliches Reasoning ist schwerer zu überwachen als das von Sol, gemessen in Tests, die das Modell ausdrücklich zum Verstecken aufgefordert haben. OpenAI nennt das einen Rückgang, den man ernst nehme. Ein Modell, das seine Grenzen besser einhält und dabei schwerer zu kontrollieren ist, ergibt keinen reinen Fortschrittsbericht.
Damit verschiebt sich der Trade-off. Astra darf offenbar mehr und wird enger überwacht, was für unkritische Recherche oder Copy keinen Vorteil bringt. Für Agenten mit Zugriff auf Browser, Infrastruktur oder Kundendaten ist es ein Produktmerkmal, das in der Benchmark-Headline untergeht. Dass die zusätzlichen Prüfungen legitime Arbeit verlangsamen, pausieren oder abbrechen können, schreibt OpenAI selbst. In ChatGPT und *Codex* wird dann eine Bestätigung fällig, in der API stoppt der Task.
## Coding: starke Herstellerwerte, unabhängig ein knapperes Bild
Auf Terminal-Bench 4.0 springt Astra laut OpenAI von 37,3 % auf 57,9 %, auf DeepSWE dagegen nur von 72,7 % auf 74,1 %. Bei bestimmten Terminal- und Agentenaufgaben sieht der Sprung groß aus, bei anderen Coding-Evals eher kleiner.
OpenAI legt offen, dass die eigenen Messungen in einer Research-Umgebung oder über die API laufen und deshalb von ChatGPT abweichen können. Für FrontierCode bekam Astra außerdem eine Developer Message, die der aus *Codex* ähnelt. Unredlich ist das nicht, bei Coding-Agenten gehören Harness und Arbeitsanweisung nun einmal zum Produkt. Ein neutraler A/B-Test im eigenen Repo sind diese Werte trotzdem nicht.
Unabhängig gemessen wird es dann nüchterner. Artificial Analysis hat am Launch-Tag auch den Coding Agent Index aktualisiert. Astra kommt in *Codex* auf 67 Punkte und liegt damit etwa gleichauf mit [*Claude Opus 5*](https://t01.li/ki-news/claude-opus-5-fast-fable-niveau-halber-preis/) und *Fable 5*, während [*Fable 5.1*](https://t01.li/ki-news/claude-fable-5-1-mythos-5-1-safeguards/) in *Claude Code* mit 70 Punkten führt. Gegenüber Sol sind das zwei Punkte mehr, bei ungefähr gleichen Kosten pro Aufgabe – Astra braucht im Codex-Harness etwa ein Drittel der Tokens von *Sol* (max) und rund ein Fünftel von *Claude Opus 5* (xhigh). Was weiterhin fehlt, sind Tests mit echten Projekten, wiederholbaren Aufgaben und eigener Kostenmessung.
## Mein (vorläufiger) Take
*GPT-6 Astra* ersetzt *GPT-5.6 Sol* nicht als pauschal bessere Modellwahl. Es ist das teurere Modell für die Klasse von Aufgaben, in der ein Agent lange am Rechner arbeitet, Kontext über viele Schritte hält und seine Grenzen respektieren soll. Zwischen den beiden liegt offenbar mehr als ein Versionssprung.
Bei den Kosten lohnt sich dann aber der zweite Blick und zwar in beide Richtungen: Pro Token ist Astra 2,5-mal so teuer. Pro Aufgabe hängt es davon ab, wie viel das Modell redet. Im Intelligence Index v4.2 kostet ein Task bei Astra laut Artificial Analysis gut das Doppelte, 2,57 gegenüber 1,25 $. Im Coding Agent Index landet Astra dagegen bei ungefähr demselben Preis pro Task wie Sol. Für Zusammenfassungen und normale Analysen rechne ich deshalb weiter mit Sol, bzw. Terra, das als Daily Driver in den meisten Fällen völlig ausreichend ist. Für einen langen *Codex*\-Refactor, Browser-QA oder einen kontrollierten Computer-Use-Workflow kann die Rechnung kippen.
Zum ersten Eindruck von *GPT-5.6* passt der gleiche Vorbehalt wie damals, [der Zugang ist oft die eigentliche Geschichte](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/). Diesmal kommt eine zweite Frage dazu. Nicht die größte Zahl in der Launch-Tabelle entscheidet, sondern ob das Zusammenspiel aus Modell, *Codex*\-Harness und Safety im eigenen Workflow weniger Schleifen produziert.
### Gemini 3.8 Flash arbeitet härter und wird teurer
URL: https://t01.li/ki-news/gemini-3-8-flash/
Last updated: 2026-09-04T06:00:30.000Z
Seit dem 2\. September gibt es [*Gemini 3.8 Flash*](https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/?ref=t01.li). Der Vorgänger ist zu diesem Zeitpunkt drei Wochen alt. Es ist Googles dritter Flash-Release innerhalb von sechs Wochen und der vierte in weniger als vier Monaten, während [das große Modell weiter fehlt](https://the-decoder.com/gemini-3-8-flash-is-googles-third-budget-model-in-six-weeks-while-frontier-models-remain-mia/?ref=t01.li). Das *3.5 Pro*, das Sundar Pichai auf der I/O im Mai für den Folgemonat versprochen hatte, ist bis heute nicht erschienen. Ein *Gemini 4* steckt nach Googles eigener Auskunft seit Juli im Pretraining.
Die Flash-Reihe ist bei mir eines dieser Dinge, über die ich wenig schreibe und die ich dafür umso häufiger benutze. Textliche Zusammenfassungen, Generieren von HTML und CSS, als Arbeitstier in *n8n*\-Workflows. Das läuft seit Monaten im Hintergrund, zuletzt mit 3.7.
Vor allem hinter meinen eigenen [Obsidian-Workflows](https://t01.li/kein-ki/obsidian-inbox-automatisieren-n8n/) arbeitet Flash regelmäßig. Eine Sprachnachricht kommt über Telegram rein, das Modell transkribiert und strukturiert sie, am Ende liegt Markdown mit Frontmatter in meiner Inbox. Ähnliches passiert mit Webseiten, Screenshots und YouTube-Videos. Kein spektakulärer Agenten-Stunt, sondern Arbeit, die zuverlässig erledigt werden soll.
Google nennt 3.8 Flash sein „most intelligent workhorse model“ und verspricht mehr Coding- und Agentenleistung bei gleicher Geschwindigkeit und gleichem Preis. Der erste Teil sieht nach den unabhängigen Messungen gut aus. An die anderen beiden gehört jeweils ein Sternchen.
## TL;DR
Gemini 3.8 Flash legt vor allem bei agentischen Aufgaben und Coding zu. Der Tokenpreis bleibt bis Jahresende gleich, im Artificial-Analysis-Test wird 3.8 auf high pro erledigter Aufgabe trotzdem teurer und langsamer als der Vorgänger.
- Artificial Analysis: 59 Punkte mit high statt 56 bei Gemini 3.7 Flash
- Rund 305 Output-Tokens pro Sekunde, aber 2,5 statt 2,2 Minuten pro Aufgabe
- 0,58 statt 0,40 $ pro Intelligence-Index-Task bei high
- Medium erreicht 57 Punkte zum Task-Preis des bisherigen high
- Der aktuelle API-Preis gilt bis Ende 2026 und verdoppelt sich am 1\. Januar 2027
## Drei Punkte mehr – und ausgerechnet Agenten profitieren
Auf dem [Artificial Analysis Intelligence Index](https://artificialanalysis.ai/models/gemini-3-8-flash?ref=t01.li) erreicht *Gemini 3.8 Flash* mit Thinking-Level high 59 Punkte. Der Vorgänger kam auf 56\. Medium landet bei 57, low bei 52.
Drei Punkte klingen jetzt nicht nach Generationssprung, aber es ist interessant, wo sie herkommen: Artificial Analysis sieht die stärksten Verbesserungen bei agentischen Evaluationen – also dort, wo ein Modell nicht nur eine Antwort formuliert, sondern Tools benutzt, mehrere Schritte plant und mit den Ergebnissen weiterarbeitet. Bei τ³-Banking legt 3.8 zwölf Punkte auf 45 % zu, der größte Einzelsprung im Index.
Bei längeren Coding-Aufgaben sieht das Modell ebenfalls gut aus. Google gibt für DeepSWE v1.1 73,7 % an, gegenüber 65,3 % bei 3.7 Flash. Datacurve hat am 1\. September nachgezogen: Das [unabhängige DeepSWE-Leaderboard](https://deepswe.datacurve.ai/?ref=t01.li) misst für *Gemini 3.8 Flash high* 74 % ± 1 % bei durchschnittlich 2,36 $ pro Task. *Claude Opus 5 max* kommt dort auf denselben Score – für 11,84 $. Hier hält der Herstellerwert der unabhängigen Nachmessung also ziemlich genau stand.
Die reine Ausgabegeschwindigkeit bleibt erhalten. Artificial Analysis misst rund 305 Output-Tokens pro Sekunde, was für ein Modell dieser Leistungsklasse bemerkenswert bleibt. Pro erledigter Aufgabe dauert es trotzdem länger: Die Time per Task steigt von 2,2 auf 2,5 Minuten, dazu kommt eine Time to First Answer Token von 13,4 Sekunden gegenüber einem Median von rund 3 Sekunden bei vergleichbaren Reasoning-Modellen. Schnell pro Token ist eben nicht schnell pro Ergebnis.
## Gleicher Tokenpreis heißt nicht gleiche Rechnung
Google verlangt bis Ende des Jahres weiterhin 0,75 $ pro Million Input-Tokens und 3,75 $ für den Output. Exakt die Preise von 3.7 Flash.
Dass 3.8 bei komplexeren Aufgaben härter arbeitet, schreibt Google selbst. Das Modell führt mehr Reasoning-Schritte aus, ruft Tools häufiger auf und kann auf höheren [Thinking-Leveln](https://t01.li/glossar/#reasoning-effort) mehr Tokens verbrauchen.
Artificial Analysis misst den Effekt bereits. Eine Aufgabe im Intelligence Index kostet mit *Gemini 3.8 Flash high* im Mittel 0,58 $, bei *3.7 Flash high* waren es 0,40\. Das sind grob 40 % mehr, obwohl sich an der Preisliste kein Cent geändert hat. Als Ursache nennt Artificial Analysis rund 30 % mehr Output-Tokens pro Aufgabe – im Schnitt 48.000 – und zusätzliche Turns in den agentischen Tests.
Damit wird „Preis pro Million Tokens“ bei Reasoning-Modellen langsam irrelevanter als Kennzahl. Entscheidend ist nicht, was eine Million Tokens kostet, sondern wie viele davon das Modell braucht, bis die Arbeit erledigt ist.
Das zweite Sternchen sitzt 'ne Spur tiefer in der Fußnote: Die 0,75 beziehungsweise 3,75 $ sind Einführungspreise, und Google weist im Launch-Post darauf hin, dass sie am 31\. Dezember 2026 auslaufen. Ab dem 1\. Januar 2027 gelten 1,50 und 7,50 $. Wenn du gerade Workflows auf Flash umstellst, rechne mit dem Standardpreis und nicht mit dem Einführungspreis.
## Thinking-Level müssen wir dann mal testen
Spannend sind die drei Thinking-Level. *Gemini 3.8 Flash* unterstützt low, medium und high; `minimal` wirft laut [Modellseite](https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash?ref=t01.li) einen Fehler. Artificial Analysis misst 52 Punkte für low, 57 für medium und 59 für high.
Zwischen medium und high liegen zwei Punkte. Bei den Kosten pro Benchmark-Aufgabe liegen 0,41 gegen 0,58 $ dazwischen, low landet bei 0,24\. Medium kostet pro Aufgabe damit ungefähr so viel wie 3.7 Flash auf high und das bei einem Punkt mehr im Index.
Google empfiehlt das im Launch-Post sogar selbst: Wer auf Recheneffizienz optimiert, soll niedrigere Effort-Level nehmen oder bei 3.7 Flash bleiben, das vollständig unterstützt bleibt. Wenn ein Hersteller in der eigenen Ankündigung die Bremse erwähnt, ist das bemerkenswert ehrlich.
Ein Intelligence Index weiß trotzdem nicht, ob Gemini aus meiner hingemurmelten Sprachnachricht vernünftiges Frontmatter baut oder aus einer Webseite ein brauchbares Exzerpt zieht. Dort liegt für mich der interessantere Test.
Die meisten Agents und Workflows brauchen kein maximal ausgereiztes Reasoning. Sie brauchen ein LLM, das Audio und Video versteht, strukturierte Daten zuverlässig ausgibt, genug [Context Window](https://t01.li/glossar/#kontextfenster) verträgt und flott genug ist, damit eine Sprachnachricht nicht zum Batch-Job für den nächsten Morgen wird. Das konnte 3.7 bereits erfreulich gut.
Technisch bringt 3.8 die gleiche Ausstattung mit: 1.048.576 Tokens Input, 65.536 Tokens Output, dazu Text, Bilder, Audio, Video und PDF als Input. [Tool Calling](https://t01.li/glossar/#tool-calling), [Structured Outputs](https://t01.li/glossar/#structured-output), Search Grounding und Code Execution gehören zum Paket.
Für solche Anwendungen würde ich zuerst medium gegen den bestehenden 3.7-Workflow stellen und für reine Extraktion und Zusammenfassungen auch low ausprobieren. High nur einzuschalten, weil 59 größer als 57 ist, ist eigentlich herzlich sinnlos.
## Die für Pipelines interessanteste Zahl steht im Safety-Absatz
Ein Punkt geht zwischen den Coding-Benchmarks aber unter: Auf dem von Gray Swan durchgeführten Benchmark für indirekte [Prompt Injection](https://t01.li/glossar/#prompt-injection) sinkt die Attack Success Rate von 9,2 % bei *Gemini 3.7 Flash* auf 5,5 % bei *3.8 Flash*. *3.8 Flash Cyber* liegt bei 6,0 %. Die Werte veröffentlicht Google in der Launch-Grafik; Gray Swan führte das Eval mit von Google bereitgestellten Checkpoints durch.
Für meinen Anwendungsfall ist die Messung trotzdem die relevanteste im ganzen Release. Ich schiebe generiertes Markdown aus fremden Websites, Screenshots und YouTube-Transkripte durch ein Modell, das anschließend strukturiertes Markdown in meinen Vault schreibt. Jede dieser Quellen ist Text, den ich nicht kontrolliere. Wenn du solche Pipelines betreibst, ist diese Zahl praktisch wichtiger als der Intelligence Index.
## Gemini 3.8 Flash Cyber bleibt hinter verschlossenen Türen
Parallel veröffentlicht Google *Gemini 3.8 Flash Cyber*. Technisch steckt dieselbe grundlegende Intelligenz dahinter, die Sicherheitsgrenzen für Cybersecurity-Aufgaben sind allerdings permissiver.
Das Muster ist bei Google nicht neu. Schon *Gemini 3.5 Flash Cyber* lief im Juli als limitierter Pilot für Behörden und ausgewählte Partner. Auch OpenAI fährt bei seinen Cyber-Modellen einen Restricted-Access-Ansatz: leistungsfähigere offensive und defensive Fähigkeiten, dafür kein frei zugänglicher API-Key für Hinz und Kunz.
Den Zugang wickelt Google über das neue [Fairwind Program](https://deepmind.google/fairwind-program/?ref=t01.li) ab, das *Gemini 3.8 Flash Cyber* mit dem Agent-Harness *CodeMender* fürs Finden und Patchen kombiniert. Mehr als 650 Organisationen gehören laut Google bereits dazu, unter anderem Betreiber kritischer Infrastruktur, Behörden, Cloud-Kunden und Security-Anbieter.
Auf CyberGym erreicht 3.8 Flash Cyber nach Googles Angaben 86,2 % Pass@1\. Beim von Collinear betriebenen externen CWE-Bench für automatisches Patchen kommt das Modell auf 47,2 % gegenüber 47,8 % bei *Claude Fable 5* – bei deutlich niedrigeren Rollout-Kosten. CyberGym bleibt hier ein von Google berichteter Modell-Run; CWE-Bench hat die stärkere externe Evidenz. Breite Nachtests sind wegen des eingeschränkten Modellzugangs allerdings schwierig.
## Der interessante Benchmark läuft woanders
*Gemini 3.8 Flash* sieht nach einem gelungenen Update aus. Die unabhängigen Zahlen bestätigen den Sprung bei agentischen Aufgaben, die Ausgabegeschwindigkeit bleibt hoch, und medium kommt erstaunlich nah an high heran.
Meinen Maßstab setze ich trotzdem nicht bei 59 Punkten an.
Bei meinen bestehenden Workflows und auch diversen Pipelines ist die Referenz *3.7 Flash*. Das Modell funktioniert dort. Es fasst Texte vernünftig zusammen, produziert brauchbares HTML und CSS und verarbeitet Audio, Videos und andere multimodale Inputs zuverlässig genug, dass ich darüber nicht mehr nachdenken muss. Für ein Arbeitsmodell ist das ein ziemlich gutes Kompliment.
Ob 3.8 diesen Platz übernimmt, entscheidet ein banaler A/B-Test. Gleiche Inputs, gleiche Prompts, gleiche Workflows, danach Output-Qualität, Laufzeit, Fehlerquote und tatsächliche Kosten vergleichen. Liefert medium dieselbe Zuverlässigkeit und fängt schwierige Fälle besser ab, nehme ich das Upgrade gern mit. Verbrennt 3.8 dagegen hauptsächlich mehr Tokens, während meine Dokumente am Ende genauso aussehen wie vorher, darf 3.7 noch eine Weile weiterarbeiten – Google selbst hat gegen diesen Plan ja ausdrücklich nichts.
Bei drei Flash-Modellen in sechs Wochen ist das ohnehin die pragmatischere Haltung. Ein neuer Modellname ist noch kein Migrationsgrund.
### Muse Spark 1.3: Metas Agentenmodell wird besser – und bleibt auffällig günstig
URL: https://t01.li/ki-news/muse-spark-1-3/
Last updated: 2026-09-03T09:57:01.000Z
Meta hat am 2\. September [*Muse Spark 1.3*](https://research.meta.ai/blog/introducing-muse-spark-1-3?ref=t01.li) veröffentlicht, vier Wochen nach dem Vorgänger. Es ist das vierte Muse-Spark-Release in fünf Monaten. Das Tempo sagt fast mehr über die Strategie aus als die eigentliche Versionsnummer.
[*Muse Spark 1.2* hatte ich in den AI Picks der 32\. Kalenderwoche bereits kurz ausprobiert](https://t01.li/ai-shorts/ai-picks-der-32-kw/#muse-code-und-muse-spark-12). Für ein belastbares Urteil über 1.3 ist es zu früh – einen eigenen Lauf habe ich noch nicht gefahren. Weit oben auf der Liste für die nächsten Wochen steht die neue Version bei mir dennoch, und das liegt weniger an einer einzelnen Benchmark-Zahl als an der Kombination aus agentischer Leistung und Preis.
## TL;DR
Meta schiebt Muse Spark 1.3 vor allem bei langen agentischen Workflows nach vorn. Die ersten unabhängigen Werte von Artificial Analysis bestätigen einen messbaren Sprung – bei der Kostenfrage wird es dann komplizierter, als die unveränderten Tokenpreise vermuten lassen.
- Artificial Analysis: 61 Punkte für xhigh, vier mehr als Muse Spark 1.2 – gleichauf mit GPT-5.6 Sol (max), Grok 4.6 (high) und Claude Opus 5 (high)
- Kontextfenster von einer Million Tokens, multimodaler Input, Fokus auf lange Agenten- und Coding-Tasks
- Tokenpreise unverändert bei 1,25 / 4,25 $ pro Million Input-/Output-Tokens
- Der Preis pro Intelligence-Index-Task steigt trotzdem: von 0,40 auf 0,55 $
- Daneben ein Contributor-Tarif zu 0,10 / 0,20 $ – dafür darf Meta Eingaben und Ausgaben zur Produktverbesserung verwenden
## Weniger Agenten-Gewusel, mehr Aufgabe zu Ende bringen
Metas eigener Pitch für 1.3 dreht sich auffällig wenig um klassische Chat-Fähigkeiten. Das Modell soll längere Aufgaben besser durchhalten, mehrere Workflows innerhalb eines Threads auseinanderhalten und Anforderungen über viele Schritte hinweg weniger schnell verlieren.
Das passt zur Richtung, die Muse schon mit 1.2 eingeschlagen hat. Kein Chatbot, der zufällig auch Tools bedienen kann, sondern ein Modell, das ziemlich eindeutig für [Tool Calling](https://t01.li/glossar/#tool-calling), Coding und längere Agent-Loops trainiert wird.
Meta äußert ein paar Änderungen, die im Alltag relevanter sein könnten als zwei Punkte auf irgendeinem Leaderboard: *Muse Spark 1.3* soll bei unklaren Aufgaben häufiger nachfragen, erkennen, wenn es feststeckt, und vor folgenreichen Aktionen eine Bestätigung einholen. Gleichzeitig will Meta die unnötigen Schleifen reduziert haben. In internen Vergleichen mit 1.2 brauchte das Modell rund 20 % weniger Tool Calls und 25 % weniger Tokens.
Das sind Werte von Meta, aber immerhin Werte, die ein reales Problem treffen. Ein Agent, der zehn Minuten lang beeindruckend nachdenkt, zwölf Tools aufruft und am Ende doch noch einmal dieselbe Datei liest, ist keine höhere Form der Intelligenz – er ist erstmal einfach nur teuer.
## Muse Spark 1.3 bei Artificial Analysis: Der Sprung ist messbar
Aufschlussreicher sind die ersten unabhängigen Messungen. [Artificial Analysis führt *Muse Spark 1.3*](https://artificialanalysis.ai/models/muse-spark-1-3-xhigh?ref=t01.li) in zwei Reasoning-Stufen. xhigh ist regulär verfügbar, max liegt in einer begrenzten Preview für Metas Partner. Meta selbst beschreibt denselben Zustand anders und schreibt, max reasoning komme, sobald zusätzliche Sicherheitstests abgeschlossen seien.
Die xhigh-Variante kommt im Artificial Analysis Intelligence Index auf **61 Punkte**. *Muse Spark 1.2* lag bei 57, *Muse Spark 1.1* bei 53\. Die max-Variante schafft 62.
Vier Punkte von 1.2 auf 1.3 sind ordentlich, zumal die Gewinne nicht nur aus einem einzelnen Ausreißer stammen. Besonders stark legt 1.3 bei agentischen Aufgaben zu. Im Tau3-Bench Banking steigt xhigh von 35 % auf 47 %, bei Terminal-Bench 2.1 von 80 % auf 85 %. GDPval-AA v2 geht von 1.615 auf 1.709 Elo hoch.
Auch ein unabhängiger Index sagt nichts über deine Task-Verteilung. Harness, Reasoning-Einstellung und Tool-Setup entscheiden mit darüber, was am Ende gemessen wird. Metas eigene Release-Grafik liegt bei Terminal-Bench 2.1 mit 88,8 % noch einmal höher. Der Vergleich hat dort aber einen Haken: Meta stellt 1.3 im max-Modus gegen 1.2 im xhigh-Modus – und ausgerechnet max kann man beim Launch nicht regulär buchen. Zugunsten von 1.3 verzerrt das hier ausnahmsweise nichts, im direkten xhigh-zu-xhigh-Vergleich kommt 1.3 sogar auf 89,2 statt 82,9 % bei 1.2.
Kleine Rückschritte gibt es ebenfalls. Bei AA-LCR fällt 1.3 von 83 % auf 79 %, bei AA-Omniscience sinkt die Accuracy um drei Punkte. Artificial Analysis führt Letzteres darauf zurück, dass das Modell häufiger gar nicht antwortet, wenn es unsicher ist. Weniger Raten senkt dann zwar die Trefferquote, senkt bei xhigh gleichzeitig aber auch die Halluzinationsrate. So eine Regression nehme ich lieber genauer auseinander, bevor ich sie pauschal als Verschlechterung verbuche.
## Das Preisschild sagt mir mehr als der Indexwert
Die regulären API-Preise bleiben gegenüber 1.2 unverändert. **1,25 $ pro Million Input-Tokens, 4,25 $ pro Million Output-Tokens**, Cache-Hits kosten 0,15 $ pro Million Tokens.
Trotzdem wird eine erledigte Aufgabe teurer. Artificial Analysis rechnet zusätzlich in Kosten pro Intelligence-Index-Task, und da klettert xhigh von 0,40 $ bei 1.2 auf **0,55 $** bei 1.3\. Verantwortlich dafür ist der Verbrauch. In den agentischen Evals zieht 1.3 rund 57 % mehr Input-Tokens pro Task.
Auf den ersten Blick beißt sich das mit den 25 %, die Meta weiter oben verspricht. Sauber auflösen lässt sich der Unterschied nicht. Meta nennt rund 25 % weniger Tokens aus internen Vergleichen seiner Engineers, ohne Input und Output getrennt auszuweisen, während Artificial Analysis in den eigenen agentischen Evals rund 57 % mehr Input- und etwa 8 % mehr Output-Tokens misst. Andere Aufgaben, anderes Harness, andere Reasoning-Konfiguration. Aber das ist noch ein Punkt: Gleiche Tokenpreise bedeuten noch lange nicht gleiche Kosten pro erledigter Aufgabe. In den Messungen von Artificial Analysis wächst sie vor allem auf der Input-Seite – wer nur die Antwortlänge optimiert, greift zu kurz.
Günstig bleibt *Muse Spark 1.3* am Ende dennoch. Auf 61 Punkten liegt xhigh gleichauf mit GPT-5.6 Sol (max), Grok 4.6 (high) und Claude Opus 5 (high). Deren Kosten pro Task liegen bei 0,95, 0,94 und 1,23 $, also bei mindestens 70 % Aufschlag. Unter allen Modellen ab 59 Indexpunkten erledigt aktuell keines eine Aufgabe billiger. Für ein [Reasoning-Modell](https://t01.li/glossar/#reasoning-modell) mit einem [Kontextfenster von einer Million Tokens](https://t01.li/glossar/#kontextfenster), multimodalem Input und brauchbarer agentischer Leistung ist das keine Nebensache.
Ein zweites Preisschild hängt allerdings gleich daneben. Neben dem Standard-Endpunkt listet [Metas Preisseite](https://developer.meta.com/ai/models/muse-spark/?ref=t01.li) einen Contributor-Tarif zu 0,10 $ Input und 0,20 $ Output, Cache-Reads bei 0,002\. Der Standardtarif kostet beim Input zwölfeinhalbmal so viel, beim Output gut 21-mal. Was der Rabatt kostet, steht in der Spalte drunter: Standard wird nicht zur Produktverbesserung verwendet, Contributor schon. Für ein Wochenendprojekt ist das ein fairer Tausch. Bei Kundencode beantwortet die Frage nicht die Technik, sondern die Rechtsabteilung.
## Eine Million Context bleibt – Open Weights sollen kommen
Technisch bleibt einiges beim Bekannten. Das Kontextfenster liegt weiterhin bei einer Million Tokens, als Input verarbeitet *Muse Spark 1.3* Text, Bilder und Video. Text kommt wieder als Output zurück.
Meta kündigt außerdem an, später [Open Weights](https://t01.li/glossar/#open-weights) für Muse Spark zu veröffentlichen. Mehr steht da nicht. Kein Datum, keine konkrete Variante, keine Lizenz.
Dieses Versprechen gab es schon einmal. Am 10\. August [kündigte Metas Chief AI Officer Alexandr Wang an](https://x.com/alexandr%5Fwang/status/2086756155838345506?ref=t01.li), eine Open-Weight-Version von *Muse Spark 1.2* komme „soon“, zusammen mit *Muse Glimmer*, einem 30B-Agentenmodell unter Apache 2.0\. Glimmer kam. Die Spark-Weights nicht. Drei Wochen später steht im Blogpost zu 1.3 wieder eine Open-Weight-Ankündigung – diesmal nur noch generisch für „Muse Spark“. Ob Meta damit weiterhin die angekündigte 1.2-Version, inzwischen 1.3 oder etwas anderes meint, bleibt offen.
Sollten die Weights tatsächlich kommen, schaue ich noch einmal aus einer ganz anderen Richtung auf das Modell. Bis dahin ist *Muse Spark 1.3* ein proprietäres API-Modell und läuft über die Meta Model API oder über *Muse Code*, Metas Coding-Agent für das Terminal.
## Warum ich mir 1.3 näher ansehen werde
Der Vorgänger hatte genug Substanz, dass ich Muse Spark nicht einfach als weiteres Modell im Release-Strom ins Regal gestellt habe. 1.3 verschiebt die Sache noch stärker in Richtung agentischer Workloads – dorthin, wo ein Modell nicht nach einer schönen Einzelantwort beurteilt wird, sondern danach, ob es Anforderungen behält, Tools sinnvoll benutzt und eine Aufgabe irgendwann tatsächlich fertig bekommt.
Auf dem Papier sieht das alles erst mal gut aus. Artificial Analysis liefert diesmal auch früh genug unabhängige Zahlen, um nicht nur Metas Pressemitteilung nacherzählen zu müssen.
Aber der Teil, der für mich am Ende zählt: ein eigener Lauf mit realen Aufgaben. Coding, Recherche, längere Tool-Ketten und vor allem die Frage, wie viel von der versprochenen Effizienz nach zwei Stunden echter Arbeit noch übrig ist.
Den Test hole ich in den nächsten Wochen nach. Nicht weil irgendwo 61 statt 57 Punkte stehen – sondern weil das Verhältnis aus Leistung und Kosten mich neugierig genug macht, um zu wissen, wo der Haken evtl. sitzt – vielleicht und möglicherweise.
### Warum die Modellwahl KI-Agenten nicht rettet – Daten, Scope und Ownership schon eher
URL: https://t01.li/ki-alltag/ki-agenten-scheitern-daten-scope-ownership/
Last updated: 2026-09-03T06:37:42.000Z
In fast jedem Gespräch über KI-Agenten fällt irgendwann die Modellfrage. *Claude*, *GPT,* *Gemini* oder etwas ganz Anderes – als hinge daran das Projekt. Der Reflex ist aber verständlich. Die Modellwahl fühlt sich nach der großen Weichenstellung an. Drei aktuelle Studien von McKinsey, Salesforce und Teradata zeigen dabei ein erstaunlich ähnliches Bild: Das Modell spielt eine Rolle, nur trennt es erfolgreiche Agenten-Projekte weit weniger zuverlässig von gescheiterten als Daten, Scope und die Organisation drumherum.
Was stattdessen den Ausschlag gibt, klingt eher unspektakulär – die Qualität der Daten, die Enge des Auftrags und die Frage, wer für Ergebnis und Fehler geradesteht. Datenqualität und Ownership lassen sich mit keinem besseren Systemprompt reparieren. Einen Scope kann ich zwar in `AGENTS.md` oder den System Instructions beschreiben, aber damit ist noch lange nicht sichergestellt, dass Datenzugriff, Tools und Prozessgrenzen dazu passen. Und genau deshalb wird es unbequem.
## TL;DR
Drei Studien aus dem Sommer 2026 zeichnen dasselbe Muster: Bei KI-Agenten entscheiden Daten, enger Scope und klare Verantwortung häufig stärker über den ROI als die Modellwahl.
- Nur 22 % der kleineren Unternehmen skalieren Agenten, bei Unternehmen über einer Milliarde Dollar Umsatz sind es 40 % (McKinsey)
- 77 % der Führungskräfte sagen, höchstens ein Fünftel ihrer Daten sei ausreichend für Agenten beschrieben und kontextualisiert (Teradata)
- Saubere Daten (36 %), enger Scope (36 %) und Eskalationswege (35 %) liegen vor Modellqualität und Plattformwahl als ROI-Faktoren (Salesforce)
- Drei Fragen gehören vor die Modellwahl: Welcher Prozess? Welche Daten? Wessen Verantwortung?
## Drei Studien, ein Muster
McKinsey hat Ende August die [Ausgabe 2026 der State-of-AI-Umfrage](https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai?ref=t01.li) veröffentlicht. Befragt wurden im Mai und Juni 1.719 Führungskräfte in 97 Ländern. Bei Unternehmen ab einer Milliarde Dollar Jahresumsatz stieg der Anteil, der Agenten in mindestens einer Funktion skaliert, binnen eines Jahres von 27 auf 40 %. Bei kleineren Organisationen blieb er bei 22 % – exakt auf Vorjahresniveau.
Die Lücke im System ist damit deutlich. Warum sie entsteht, beantwortet McKinsey an dieser Stelle allerdings nicht. Aus „unter einer Milliarde Dollar Umsatz“ direkt „Mittelstand ohne geeignete Daten“ zu bauen, wäre mehr Interpretation als Studienbefund. Für kleinere Unternehmen bleibt die Zahl trotzdem relevant: Beim Skalieren öffnet sich die Schere.
Fast zeitgleich hat Salesforce den [State of Agentic AI in the Enterprise](https://www.salesforce.com/news/stories/agentic-ai-leaders-survey-on-roi/?ref=t01.li) vorgelegt, eine Befragung von 2.025 Entscheidern in 20 Ländern. Davon haben 30 % Agenten bereits produktiv ausgerollt, 47 % pilotieren und 23 % befinden sich noch in der Evaluierung. Die meisten Detailergebnisse beziehen sich auf die produktiven Deployments.
Die drei stärksten Prädiktoren für messbaren ROI sind dort saubere, zugängliche Daten (36 %), ein eng definierter Use Case (36 %) und vorab festgelegte Eskalationswege zu Menschen (35 %). Modellqualität, Plattformwahl und einheitliche Orchestrierung landen jeweils bei rund 30 %. Das ist kein riesiger Abstand – und schon gar kein Beleg dafür, dass das Modell egal wäre. Aber eben auch keiner für die verbreitete Idee, mit dem neuesten Frontier-Model sei der wichtigste Teil der Architektur bereits entschieden.
Bedenken muss man dabei, Salesforce verkauft mit *Agentforce* genau das Produkt, um das es hier geht. Wenn allerdings ausgerechnet der Plattformanbieter schreibt, dass selbst das beste Modell ein schlechtes Setup nicht rettet, lässt sich das zumindest schlecht als Werbung für den nächsten Modellwechsel lesen.
Die dritte Perspektive liefert Teradata mit „[Arrested Automation](https://www.teradata.com/press-releases/2026/why-enterprise-ai-stalls-before-it-scales?ref=t01.li)“, einer von Wakefield Research durchgeführten Befragung von 1.000 Tech- und Data-Führungskräften in sechs Märkten. 90 % wollen ihre Agenten-Investitionen in den nächsten zwölf Monaten erhöhen. Gleichzeitig berichten 63 % bislang von höchstens kleinen oder gerade erst entstehenden positiven Returns. Auf der Reifegradskala der Studie haben nur 7 % die Stufe „Operationalizing“ erreicht.
Natürlich gehört auch hier ein Hersteller-Sternchen dran, denn Teradata verkauft Datenplattformen. Beratung, CRM-Plattform und Datenanbieter betrachten das Problem aus unterschiedlichen Eigeninteressen – und landen trotzdem bei einem ähnlichen Muster.
Wer dafür noch einen älteren Rahmen braucht: Schon die [MIT-NANDA-Studie](https://finance.yahoo.com/news/mit-report-95-generative-ai-105412686.html?ref=t01.li) von 2025 berichtete, dass rund 95 % der untersuchten GenAI-Initiativen keinen messbaren P&L-Impact erzielten. Der Report selbst formulierte ausdrücklich, dass die Trennlinie offenbar nicht bei Modellqualität oder Regulierung lag, sondern beim Implementierungsansatz. Die Methodik des vorläufigen Reports wurde zu Recht diskutiert und die Datenbasis ist überschaubar. Als Beleg für eine 95-prozentige „Failure Rate von KI“ taugt er nicht. Die Richtung passt aber zu den drei aktuelleren Studien.
## Die 77-Prozent-Zahl, über die kaum jemand spricht
Die für mich wichtigste Zahl steckt im Teradata-Report etwas versteckt. 77 % der befragten Führungskräfte geben an, dass höchstens 20 % ihrer Unternehmensdaten ausreichend beschrieben und kontextualisiert sind, damit Agenten verlässlich damit arbeiten können. Teradata nennt das „Context Fragmentation“ – die Daten existieren, aber ihnen fehlen Zusammenhänge, Herkunft, Bedeutung oder Governance.
Das deckt sich mit dem, was ich in Projekten und aus eigenen [Evals](https://t01.li/glossar/#eval) beobachte. Der größte Fallstrick ist die Datenlage, und zwar qualitativ, nicht quantitativ. Der Punkt wird gern ignoriert, bewusst oder aus Unwissen, nach dem Motto „die KI regelt das schon“. Ein Blick in die Ergebnisse zeigt dann regelmäßig das Gegenteil.
Ein Beispiel aus dem eigenen Werkzeugkasten: Mit *Targeta* betreiben wir ein agentisches System, das Zielgruppen-Personas als Hypothesen anhand von Modellen aus Marktforschung, Psychologie und Soziologie entwickelt – ausdrücklich auch ohne Primärdaten, mit offen markierten Annahmen statt versteckter Gewissheit. Ausgerechnet dieses System, das für den Umgang mit Annahmen gebaut wurde, lebt von der Vollständigkeit seiner Eingangsdaten. In den Evals werden die Ergebnisse mit dünner Datenlage deutlich schwächer, weil das Modell hinter dem Agenten zwangsläufig anfängt, zu raten. Und geratene Analyse sieht auf den ersten Blick genauso aus wie fundierte, nur stimmt sie eben nicht.
Der Mechanismus lässt sich verallgemeinern. Ein Agent mit Zugriff auf widersprüchliche oder schlecht beschriebene Daten liefert selten offensichtlich absurden Unsinn. Er füllt die Lücken mit plausiblen Mustern. Das Ergebnis wirkt konsistent, ist aber im schlechtesten Fall [Konfabulation](https://t01.li/glossar/#halluzination) mit Geschäftsbezug.
Ein besserer Prompt kann dem Modell sagen, wie es mit Unsicherheit umgehen soll. Er kann fehlende Herkunft, widersprüchliche Stammdaten oder veraltete Informationen aber nicht herbeizaubern. Das Problem liegt [vor dem Prompt](https://t01.li/ki-systemdesign/context-engineering-prompt-engineering-baustein/).
## Eng gedacht schlägt groß gedacht
Aus der Salesforce-Befragung stammt noch ein Detail, das gerade für kleinere Unternehmen eine gute Nachricht ist: Nur 31 % der Organisationen mit produktiv eingesetzten Agenten hatten ihre Daten vorher vollständig vereinheitlicht. Sie erreichten den angegebenen ROI im Mittel nach 7,3 Monaten. Weitere 34 % gingen iterativ vor, integrierten also nach und nach weitere Daten, und kamen nach 8,2 Monaten dort an. Heißt: knapp einen Monat Unterschied.
Du musst also nicht zuerst den Datenbestand in einen Zustand bringen, bei dem selbst der oder die letzte Beauftragte zufrieden lächelt. Salesforce zufolge haben die meisten erfolgreichen Organisationen ihre Datenbereitschaft auf den konkreten Use Case begrenzt. Entscheidend ist die Scheibe, die der Agent für diesen einen Prozess braucht. Das ist eine deutlich realistischere Aufgabe.
Bemerkenswert ist auch, wie selten Vollautonomie in der Praxis vorkommt. Nur 1 bis 2 Prozent der Organisationen mit produktiven Agenten berichten von Systemen ganz ohne menschliche Beteiligung. [Human-in-the-loop](https://t01.li/glossar/#human-in-the-loop) ist damit nicht das peinliche Übergangsstadium auf dem Weg zur großen autonomen Maschine, sondern ziemlich genau der Normalfall.
Wer seinen Agenten plant, plant die Übergabe an Menschen gleich mit – inklusive der Frage, wann sie passieren muss.
## Und das Modell? Doch, es spielt eine Rolle
So bequem wäre die Geschichte sonst auch wieder nicht. Gartner prognostizierte im Sommer 2025, dass bis Ende 2027 über 40 Prozent aller [Agentic-AI-Projekte](https://t01.li/glossar/#agentic-ai) eingestellt werden. Als zentrale Gründe nennt Gartner eskalierende Kosten, unklaren Geschäftswert und unzureichende Risikokontrollen. Gleichzeitig schreibt Gartner im selben Text ausdrücklich, dass aktuelle Modelle für komplexe autonome Geschäftsziele und langfristig nuancierte Anweisungen teilweise noch nicht reif genug seien.
Das Modell ist also nicht egal. Die interessantere Aussage ist eine andere: Selbst ein starkes Modell löst weder einen schlechten Use Case noch fehlende Daten, unklare Zuständigkeiten oder ein kaputtes Kostenmodell. Und ein schwächeres Modell kann selbstverständlich die Grenze sein, wenn der konkrete Prozess Fähigkeiten verlangt, die es nicht zuverlässig beherrscht.
Modellqualität ist eine technische Voraussetzung. Sie ist nur keine Organisationsstrategie.
Passend dazu prägte Gartner den Begriff „Agent Washing“. Von Tausenden Anbietern, die sich das Agenten-Etikett anheften, schätzt Gartner nur rund 130 als tatsächliche Anbieter agentischer Technologie ein. Auch das ist vielleicht ein Grund, erst über den Prozess und anschließend über den Produktkatalog zu reden.
## Wem gehört der Fehler des KI-Agenten?
Die dritte Baustelle ist die am wenigsten sichtbare. In der aktuellen McKinsey-Umfrage sagen 80 Prozent der Befragten, KI habe ihre persönliche Produktivität verbessert. Auf Unternehmensebene schreiben aber nur 37 Prozent KI überhaupt einen positiven EBIT-Effekt zu. Gerade einmal 6 Prozent gelten als High Performer mit mindestens 5 Prozent EBIT-Beitrag und gleichzeitig signifikantem Wertbeitrag – beide Werte praktisch unverändert zum Vorjahr.
Das belegt nicht, dass fehlende Ownership die Ursache dieser Lücke ist. Meine Lesart ist trotzdem: Persönliche Produktivitätsgewinne sind vergleichsweise einfach. Unternehmenswert entsteht erst, wenn der Prozess drumherum ebenfalls verändert wird.
Genau dazu liefert McKinsey den interessanteren Befund. Knapp drei Viertel der High Performer haben ihre Workflows wegen KI grundlegend umgebaut. Bei den übrigen Befragten ist es ungefähr ein Viertel. High Performer berichten doppelt so häufig von sichtbarem Commitment der Führungsebene – und von definierten Prozessen, um den Impact überhaupt zu messen.
Damit kommen wir zur Ownership-Frage und die wird dann konkret: Wer besitzt das Ergebnis des Agenten? Wer den Fehler, wenn er nachts um drei eine falsche Gutschrift auslöst – und wer merkt das überhaupt? Wer entscheidet, wann ein Mensch übernehmen muss? Und wer besitzt die Weiterentwicklung, wenn sich der Prozess ändert und der Agent stillschweigend gegen Annahmen aus dem vergangenen Jahr läuft? „IT“ ist darauf keine brauchbare Antwort.
## Drei Fragen vor dem Modellnamen
Wenn die Studienlage etwas hergibt, dann eine Reihenfolge. Vor der Modellwahl gehören drei Fragen beantwortet, schriftlich und ohne Weichzeichner.
1. Welchen klar abgegrenzten Prozess übernimmt der Agent – und welchen ausdrücklich nicht?
2. Auf welche Daten greift er zu, und sind die für genau diesen Ausschnitt vollständig, beschrieben und aktuell?
3. Wer besitzt Ergebnis, Fehler und Weiterentwicklung, mit Namen statt Abteilungskürzel?
Wer alle drei beantworten kann, für den wird die Modellfrage danach interessant. Dann kann man sinnvoll testen, ob *Claude*, *GPT*, *Gemini* oder ein ganz anderes Modell die notwendigen Fähigkeiten, Latenzen und Kosten liefert.
Wer die drei Fragen nicht beantworten kann, braucht noch kein [Modell-Benchmarking](https://t01.li/ki-systemdesign/wenn-benchmarks-lugen-warum-der-llm-vergleich-kaputt-ist/), sondern erst mal einen Termin mit den eigenen Daten und Prozessen.
Der ganze heiße Take zum Schluss: Die Modellfrage ist die beliebteste Frage im Raum, weil sie sich per Kreditkarte beantworten lässt. Die drei anderen kosten Arbeit und deshalb stellt sie kaum jemand.
### Claude Fable 5.1 und Mythos 5.1: was Safeguards kosten
URL: https://t01.li/ki-news/claude-fable-5-1-mythos-5-1-safeguards/
Last updated: 2026-09-01T21:28:11.000Z
Anthropic hat heute [Claude Fable 5.1 und Claude Mythos 5.1 veröffentlicht](https://www.anthropic.com/claude-fable-and-mythos-5-1?ref=t01.li), beide am selben Tag, beide auf demselben Modell. Getestet habe ich nichts davon, der Release ist beim Schreiben dieses Artikels eine gute Stunde alt. Unabhängige Zahlen gibt es daher auch noch nicht – bei [Artificial Analysis](https://artificialanalysis.ai/models/claude-fable-5?ref=t01.li) stehen weiterhin die Werte von Fable 5\. In den nächsten Tagen dürften die ersten unabhängigen Benchmarks folgen. *Ergänzung: Sie kamen noch am selben Abend, siehe den Nachtrag am Ende.*
Trotzdem lohnt der Blick. Nicht, weil Anthropic zum ersten Mal zeigt, dass Safeguards Leistung kosten – das stand bereits bei Fable 5 in der System Card. Dieses Mal liegt die Differenz allerdings unübersehbar in der Launch-Tabelle, samt Erklärung, woher sie kommt und warum sie mit den heute ausgelieferten Filtern kleiner ausfallen dürfte.
## TL;DR
Anthropic liefert *Fable 5.1* und *Mythos 5.1* als dasselbe Modell mit unterschiedlich permissiven Safeguards aus:
- *Fable 5.1* ist allgemein verfügbar, *Mythos 5.1* bleibt vorerst ausgewählten US-Organisationen vorbehalten
- Auf Terminal-Bench 4.0 liegen beide 5,1 Punkte auseinander – 55,8 % gegen 60,9 %. Die Lücke stammt allerdings noch von den älteren, gröberen Cyber-Safeguards
- Input und Output bleiben bei 10 $ / 50 $ pro Million Tokens. Nur Cache-Reads sinken um 75 % auf 0,25 $
- Die neuen Cyber-Safeguards greifen pro Claude-Code-Session rund 60 % seltener ein. Dual-Use-Aufgaben werden weiterhin an Opus-Modelle weitergeleitet
- Neue API-Accounts können beim Editieren früherer Turns den bisherigen Thinking-Verlauf nicht mehr erhalten
## Mythos 5.1 und Fable 5.1 – dasselbe Modell, zwei Filtersysteme
Die Konstruktion kennt man schon von *Fable 5*. Anthropic bezeichnet *Fable 5.1* und *Mythos 5.1* als identisches Modell, das mit unterschiedlich permissiven Safeguards ausgeliefert wird. *Fable 5.1* ist allgemein verfügbar, *Mythos 5.1* bleibt zunächst einer kleinen Gruppe geprüfter Organisationen in den USA vorbehalten.
Ganz so aufgeräumt, wie die Kurzfassung klingt, ist der Zugang zum eingeschränkten Modell noch nicht. Das Life Sciences Verification Program hat gerade erst seine ersten Teilnehmer aufgenommen. Das Cyber Verification Program soll Mythos-Zugang erst in naher Zukunft erhalten. Claude Security läuft dagegen bereits mit *Mythos 5.1*.
Der Unterschied liegt damit nicht im trainierten Modell, sondern im System darum herum. Gleiche Basis, andere Zugriffskontrollen und Fallbacks.
## Die interessanteste Zahl steht nicht in der Überschrift
Auf Terminal-Bench 4.0 kommt *Fable 5.1* auf 55,8 %, *Mythos 5.1* auf 60,9 %. Dasselbe Modell, dieselben Aufgaben, 5,1 Punkte Differenz. Anthropic führt die Lücke auf Tasks zurück, bei denen die vorherigen, gröberen Cyber-Safeguards eingegriffen haben.
Genau da sitzt das wichtige Sternchen. Die 5,1 Punkte beziffern nicht den Leistungsabzug der Filter, die seit heute in Produktion laufen. Anthropic erwartet selbst, dass der Abstand mit den neuen Safeguards deutlich kleiner wird. Die Tabelle zeigt sauber, wie stark ein vorgeschaltetes Filtersystem einen Benchmark drücken kann – nur eben rückblickend für die vorige Version dieses Systems.
So ganz neu ist die Messung auch nicht. In der [System Card zu Fable 5 und Mythos 5](https://www-cdn.anthropic.com/d00db56fa754a1b115b6dd7cb2e3c342ee809620.pdf?ref=t01.li) standen für Terminal-Bench 2.1 bereits 84,3 % und 88,0 %. Damals lösten die Safeguards bei 20,9 % der Fable-Durchläufe eine Weiterleitung an [*Claude Opus 4.8*](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/) aus. Der Unterschied war also dokumentiert, nur deutlich tiefer im Material vergraben.
Zur aktuellen Tabelle gehört noch eine zweite Fußnote. *Fable 5.1* wurde mit aktiven Produktions-Safeguards gemessen. Griffen sie auf OSWorld 2.0 ein, erhielten *Fable 5.1* und *Fable 5* für den betreffenden Task eine Null; bei AutomationBench galt das für *Fable 5*. Bei den übrigen Eingriffen übernahm *Claude Opus 4.8* die Cyber- und *Claude Opus 5* die Bio-Aufgaben. Anthropic schreibt selbst, dass dies die Ergebnisse wahrscheinlich drückt.
Ehrlicher als vieles, was in der Branche sonst unter [Benchmark-Kommunikation](https://t01.li/glossar/#benchmark) läuft, ist das irgendwie schon. Es heißt aber auch, dass die Tabelle streng genommen kein reiner Modellvergleich ist, sondern verschiedene Auslieferungssysteme gegeneinander stellt. Wer *Fable 5.1* nutzt, bekommt die Safeguards mitgeliefert – und damit ist der niedrigere Wert für die Praxis relevanter. Die Opus-Fallbacks müssen API-Kunden selbst aktivieren, über den `fallbacks`\-Parameter, den Anthropic mit *Opus 5* als Beta eingeführt hat.
Die übrigen Werte fallen ähnlich deutlich aus: 52,6 % auf Terminal-Bench-Science 0.1 gegen 24,7 % beim Vorgänger, 1853 auf GDPval-AA v2 gegen 1723 und 31,4 % auf AutomationBench gegen 17,1 %. Auf CursorBench 3.2.0 sind es 73,4 % gegen 70,5 %, also im Rahmen.
Bei Terminal-Bench-Science nennt Anthropic einen Standardfehler von ±3,5 bis 4,5 Punkten. Das öffentliche Leaderboard führt Fable 5 bei 21,4 %, während die eigene Reproduktion 24,7 % ergab. Beide Werte lägen innerhalb des statistischen Rauschens. Immerhin steht es da.
## Nur Cache-Reads werden billiger
10 $ pro Million Input-Tokens, 50 $ pro Million Output-Tokens. Unverändert. Was gefallen ist, sind die Cache-Reads: minus 75 %, jetzt 0,25 $ pro Million Tokens.
Daraus leitet Anthropic rund 25 % geringere Gesamtkosten bei typischer Nutzung ab und bis zu 45 % bei stark [agentischer Arbeit](https://t01.li/glossar/#agentic-ai). Die Rechenbasis ist die eigene Nutzung über vier Wochen im August 2026, gemessen über Claude Enterprise, Claude Code und die API bei Default-Effort. Für Setups, die ihren Kontext ständig neu aufbauen und wenig aus dem Cache lesen, ändert sich am Rechnungsbetrag kaum. Die 25 % sind ein Durchschnitt über Anthropics Kundschaft, nicht über deine.
Wer mit langlaufenden Agenten arbeitet und den Kontext warm hält, dürfte den Unterschied dagegen sehen. Direkt gilt die Preissenkung für tokenbasierte Abrechnung über die API. Der feste Preis meines Max-5x-Plans sinkt natürlich nicht. Spannend ist dort eher, ob durch das günstigere Caching mehr Arbeit in die bestehenden Usage-Limits passt – dazu macht die Ankündigung keine konkrete Zusage.
## Safeguards werden durchlässiger, die API wird dichter
An den Filtern hat sich einiges bewegt, und zwar in beide Richtungen. Die Cyber-Safeguards greifen laut Anthropic pro Claude-Code-Session durchschnittlich rund 60 % seltener ein als die vorherigen Filter von Fable 5\. *Fable 5.1* darf jetzt Schwachstellen in Software identifizieren. Exploits dafür entwickeln darf es weiterhin nicht selbst.
Pentesting, Exploit-Generierung und binärbasiertes Vulnerability-Scanning werden weiterhin [an die Opus-Modelle](https://t01.li/ki-news/claude-opus-5-fast-fable-niveau-halber-preis/) weitergeleitet. Bei harmlosen Fragen zu grundlegender Biologie und Medizin greifen die neuesten Filter 85 % seltener ein als die Version, die mit Fable 5 startete. Diese Änderung gilt für *Fable 5.1* und *Fable 5*. Forschungs- und Entwicklungsanfragen aus den Life Sciences gehen weiterhin an Opus.
Gleichzeitig macht Anthropic die API an einer Stelle dichter. Ab heute angelegte API-Accounts können frühere Turns einer Konversation nicht mehr manuell editieren und dabei das bisherige Thinking-Transkript behalten. Das war eine öffentlich dokumentierte Methode, um Claudes Reasoning für Distillation abzugreifen. Bestehende Accounts sind vorerst nicht betroffen; mit künftigen Modell-Releases soll die Regel für alle gelten. Ein paar Custom-Integrationen werden das merken.
Dazu kommen die Enterprise Frontier Safeguards. Kundendaten bleiben dabei in der eigenen Cloud-Infrastruktur, menschliche Prüfungen liegen standardmäßig beim Kunden. Der Rollout startet in Phasen ab diesem Herbst. Bis dahin gibt es Zero Data Retention für berechtigte Kunden.
Auch beim Text-Wasserzeichen lohnt eine saubere Trennung zwischen Gesetz und Umsetzung. Art. 50 des [EU AI Act](https://t01.li/ki-alltag/ki-kompetenz-art-4-pflichten-kmu/) verlangt von Anbietern betroffener generativer KI-Systeme, ihre Outputs maschinenlesbar zu markieren. Anthropic setzt das als Unterzeichner des Code of Practice mit einem unsichtbaren Text-Wasserzeichen für Modelle um, die nach dem 2\. August 2026 veröffentlicht wurden. Die Detection-API läuft als Private Preview für berechtigte Regulierer, Strafverfolgungsbehörden, Medien, Faktenchecker, Forschung und weitere Organisationen mit entsprechenden Prüfpflichten.
## Venus, Proteine, GPU-Kernels
Den größten Teil der Ankündigung nehmen Wissenschaftsdemos ein, und die gehen ausnahmsweise über reine Prompt-Spielereien hinaus. *Mythos 5.1* entwarf laut Anthropic Protein-Binder, die zwei externe Organisationen im Labor testeten. Über zwölf Targets lag die Trefferquote bei knapp 50 %, während Anthropic 10 bis 15 % als heute üblichen Bereich nennt. Auf drei Targets soll die Bindungsaffinität eine Größenordnung über den besten vergleichbaren Einreichungen aus Wettbewerben von Adaptyv Bio gelegen haben.
Das sind weiterhin Herstellerangaben. Eine unabhängige Studie oder die vollständige Versuchsdokumentation ist noch nicht verlinkt, und bei einem der drei Targets nennt Anthropic selbst einen Binder an einer anderen Bindungsstelle, der ein vergleichbares Ergebnis erreichte.
Bei der Venus-Demo gibt es immerhin einen öffentlichen Datensatz. Im Rahmen des Anthropic STEM Fellows Program erstellten Allyson Trussell und Claude aus mehr als 30 Jahre alten Magellan-Radardaten ein neues digitales Höhenmodell. Es deckt 35 % der Venus ab (Anthropic rundet auf ein Drittel) und liegt [unter CC BY 4.0 auf Zenodo](https://zenodo.org/records/22164484?ref=t01.li), rechtzeitig vor den Missionen VERITAS und EnVision.
Anthropic fasst die Detailauflösung mit 2 bis 3 km statt der bisherigen 10 bis 20 km zusammen. Das README des Datensatzes ist vorsichtiger: Strukturen zwischen 3 und 20 km werden besser erfasst als mit der alten Altimetrie, unter etwa 5 km seien sie jedoch kaum zuverlässig aufgelöst. Das 300-Meter-Raster sollte man deshalb nicht mit 300 Metern belastbarer räumlicher Auflösung verwechseln. Peer-reviewed ist die Karte ebenfalls noch nicht.
Für sieben Open-Source-Modelle aus Genomik und Proteinforschung schrieb *Mythos 5.1* laut Anthropic Custom-GPU-Kernels und optimierte das Caching. Auf einer NVIDIA H100 liefen die Modelle damit bis zu 2,5-mal schneller bei identischem Output; die geschätzten GPU-Kosten sanken je nach Analyse um 30 bis 60 %. Die Optimierungen will Anthropic erst noch als Open Source veröffentlichen.
Das ist schon greifbarer, als übliche Launch-Demos, aber vollständig ist das Bild trotzdem nicht. Bei den Protein-Bindern nennt Anthropic zwar die Labortrefferquote, aber nicht die Zahl der Modellläufe und verworfenen Designs davor. Für das Höhenmodell gibt es einen offenen, aber noch nicht begutachteten Datensatz. Bei den Kernels fehlt der Code bislang ganz.
## Der Take zum Schluss
Der eigentliche Vorgang hier ist nicht der Sprung auf Terminal-Bench-Science, so hübsch die Verdopplung aussieht. Und es ist auch nicht das erste Mal, dass Anthropic den Leistungsunterschied zwischen Fable und Mythos beziffert.
Interessant ist, wie offen die Launch-Kommunikation diesmal Modell und Auslieferungssystem auseinanderzieht. Da stehen 5,1 Punkte Differenz, Anthropic führt sie auf die eigenen Safeguards zurück und schreibt direkt daneben, dass diese Zahl mit den heute eingeführten Filtern vermutlich kleiner ausfallen würde. Das ist keine exakte Sicherheitssteuer, aber ein anschaulicher Beleg dafür, dass ein Benchmark nicht nur das Modell misst, sondern das komplette System drumherum.
Die andere Seite der Medaille findet sich drei Absätze weiter unten im selben Text. Anthropic räumt ein, dass das Modell Approvals und [Auto-Mode-Klassifikatoren](https://t01.li/ai-dev/claude-code-auto-mode-default/) gelegentlich umgehen kann und dass die eigene Alignment-Prüfung bei Long-Context- und Multi-Agent-Szenarien wenig sieht. Genau die Szenarien, für die dieses Modell beworben wird.
Ich gedulde mich einfach einen Tag, dann sehe ich, was unabhängige Benchmarks zutage fördern, und schaue mir bis dahin an, ob *Fable 5.1* in meinem Max-5x-Plan tatsächlich mehr Arbeit in die vorhandenen Usage-Limits bekommt.
## Nachtrag: Die unabhängigen Benchmarks sind da
*Ergänzt am 1\. September 2026\. Artificial Analysis hat die Ergebnisse um 22:12 Uhr* [*auf X veröffentlicht*](https://x.com/ArtificialAnlys/status/2094881171066978525?ref=t01.li)*, etwas mehr als eine Stunde nach dem Erscheinen dieses Artikels.*
Damit war meine Geduld dann doch nicht gefragt. Im [Intelligence Index v4.1.1](https://artificialanalysis.ai/models/claude-fable-5-1?ref=t01.li) steht *Fable 5.1* mit 66 Punkten auf Platz 1 von 192, vor *Claude Opus 5* mit 63 und *Fable 5* mit 62.
Der Eintrag heißt dort „Claude Fable 5.1 (max with fallback)“. Gemessen wurde also mit aktivem Opus-Fallback, womit auch die unabhängige Zahl ein Auslieferungssystem beschreibt und nicht das Modell allein. Das Problem aus Anthropics eigener Tabelle wandert eins zu eins in den Benchmark, der sie einordnen soll.
Interessanter wird es eine Ebene tiefer. Artificial Analysis misst fünf Effort-Stufen, und die Abstände dazwischen sind größer als der Abstand zur Konkurrenz – 65,7 bei max, 64,8 bei xhigh, 62,5 bei high, 60,5 bei medium, 58,1 bei low. Auf „high“ liegt *Fable 5.1* damit fast exakt auf dem Niveau von *Fable 5*, das 62,1 erreicht. Der Sprung an die Spitze kommt nicht vom Modell allein, sondern von der Bereitschaft, es länger rechnen zu lassen.
Ein ähnliches Bild bei AA-Briefcase, dem Benchmark für agentische Wissensarbeit. *Fable 5.1* führt dort mit einem Elo von 1694, dahinter folgen *Opus 5* mit 1687 und 1685\. Die Konfidenzintervalle der vier vordersten Einträge überlappen vollständig.
Auf die Rechnung schlägt die Effort-Stufe direkt durch. Eine einzelne Aufgabe im Index kostet bei *Fable 5.1* im gewichteten Mittel 3,69 $ gegen 3,14 $ beim Vorgänger und 2,34 $ bei *Opus 5* – der höchste Wert unter den 26 verglichenen Modellen. Der Cache-Rabatt steigt zwar von 90 auf 98 %, was die Senkung der Cache-Reads exakt abbildet. Das Modell erzeugte aber 140 Millionen Output-Tokens gegen 83 Millionen bei *Fable 5*, bei einem Median von 71 Millionen über alle getesteten Modelle. Der komplette Testlauf über alle Evaluationen kostete Artificial Analysis 8.523 $.
Billigeres Caching, dafür fast doppelt so viel Output. Wer Anthropics 25 % in die eigene Kalkulation mit reinschreibt, sollte vorher wissen, wie geschwätzig das Modell bei Aufgaben werden kann.
### AI Picks der 35. KW
URL: https://t01.li/ai-shorts/ai-picks-der-35-kw/
Last updated: 2026-08-30T05:09:31.000Z
Reichlich neue Modelle diese Woche – allein drei chinesische [Open-Weights](https://t01.li/glossar/#open-weights)\-Drops innerhalb von drei Tagen –, dazu zwei Dokumenten-Parser, ordentlich Gossip bei Meta und ein handfester Ärger mit dem Auto Mode in *Claude Code*. Dann mal rein in die spätsommerliche 35\. Kalenderwoche des Jahres 2026.
## Qwen3.8-Flash-Next
Alibaba hat am 26\. August [*Qwen3.8-Flash-Next* rausgehauen](https://qwen.ai/blog?id=qwen3.8-flash-next&ref=t01.li): Open Weights, [MoE](https://t01.li/glossar/#moe), ausdrücklich als Vorschau auf die kommende Qwen4-Architektur gedacht. Im Backbone stecken 125 Milliarden Parameter, dazu kommt eine separate N-gram-Embedding-Tabelle mit 51 Milliarden, aktiv sind pro Token nur 6 Milliarden. Die MoE-Schicht fährt 512 Experten, von denen 10 geroutete plus 1 shared anspringen. Wer den ganzen Architektur-Kram nachlesen möchte, findet [den Tech-Report auf GitHub](https://github.com/QwenLM/Qwen3.8-Flash-Next?ref=t01.li).
Benchmarks gibt es bisher nur aus dem eigenen Haus, und in [der Tabelle auf Hugging Face](https://huggingface.co/Qwen/Qwen3.8-Flash-Next?ref=t01.li) sieht *Flash-Next* gegen *DeepSeek-V4-Flash-0731* und *Claude-Opus-4.6 (Max)* auffällig gut aus, gut – ist ihre Tabelle. Aber wo es kippt: Bei HLE zieht *Opus 4.6 Max* mit 40,0 zu 35,9 vorbei, bei NL2Repo-Bench führt *DeepSeek-V4-Flash-0731* mit 54,2 zu 48,1, und bei Agents' Last Exam liegt DeepSeek beim Pass@1 knapp vorn. *Opus 5* und die anderen echten Frontier-Modelle fehlen komplett. Warten wir auf die unabhängigen Zahlen von Artificial Analysis, dann haben wir Werte, mit denen sich arbeiten lässt.
Der Preis ist eine Ansage. Die Produktiv-Version *Qwen3.8-Flash* soll über QwenCloud 0,16 $ je 1 Mio. Input und 0,47 $ je 1 Mio. Output kosten.
## GLM-5.3-Flash
Kaum ist Qwen durch, legt Z.ai am selben Tag nach. [*GLM-5.3-Flash*](https://huggingface.co/zai-org/GLM-5.3-Flash?ref=t01.li) ist ebenfalls Open Weights unter MIT-Lizenz, kommt mit 320 Milliarden Parametern gesamt bei 18 Milliarden aktiven und einem [Kontextfenster](https://t01.li/glossar/#kontextfenster) von 1 Mio. Token. Und ja, [*Ox Alpha*, über das ich letzte Woche gestolpert bin](https://t01.li/ai-shorts/ai-picks-der-34-kw/#ox-alpha-oder-wie-ich-mich-von-drei-tweets-aufs-glatteis-f%C3%BChren-lie%C3%9F), war tatsächlich dieses Modell – Z.ai hat es vor dem Launch anonym auf OpenCode und OpenRouter mitlaufen lassen.
Artificial Analysis hat schon gemessen und [setzt das Modell auf 57 Punkte im Intelligence Index](https://artificialanalysis.ai/models/glm-5-3-flash?ref=t01.li), klar über dem Schnitt vergleichbarer Open-Weights-Modelle. Den Preis, der dafür vorher rund das Zehnfache gekostet hätte, gibt Z.ai selbst als Verkaufsargument aus. Der Haken steht im selben Bericht – langsamer als der Durchschnitt und reichlich geschwätzig, weil ein Großteil der Output-Tokens ins Reasoning fließt. Das Muster mit dem Benchmark-Blatt voller Sternchen kennt man ja schon vom Vorgänger [*GLM-5.2*](https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/).
Regulär ruft Z.ai 0,15 $ Input und 0,50 $ Output je 1 Mio. Token auf. Bei [OpenRouter](https://openrouter.ai/z-ai/glm-5.3-flash?ref=t01.li) gibt es das Modell gerade zum Kennenlernpreis für 0,075 $ Input und 0,25 $ Output.
## Hy4 preview
Weil aller guten Dinge drei sind, ist bei Tencent am 28\. August [*Hy4 preview*](https://hy.tencent.ai/research/hy4-preview?ref=t01.li) als Open Source hinten rausgefallen – MoE, 770 Milliarden Parameter gesamt, davon 49 Milliarden aktiv je Token, Kontextfenster 1 Mio., Apache-2.0-Lizenz. [Auf Hugging Face](https://huggingface.co/tencent/Hy4-preview?ref=t01.li) liegen die Gewichte, [der Code auf GitHub](https://github.com/Tencent-Hunyuan/Hy4-preview?ref=t01.li).
Unabhängige [Benchmarks](https://t01.li/glossar/#benchmark) gibt es noch nicht, nur Tencents eigene. Tencent ist immerhin nicht dafür bekannt, in der Vergangenheit wild übertrieben zu haben – also nehmen wir die internen Zahlen mal hin, aber mit einem ganz leichten Zucken im Auge:
| Benchmark | Hy4 preview | Qwen 3.8 Max | GLM 5.3 | Kimi K3 | GPT 5.6 Sol | Claude Opus 5 |
| --------------------- | ----------- | ------------ | ------- | ------- | ----------- | ------------- |
| Terminal Bench 2.1 | **85.4** | 85.8 | 88.3 | 85.7 | **88.8** | 85.1 |
| DeepSWE | **64.3** | 56.6 | 68.1 | 74.0 | 68.9 | **74.7** |
| SWE Atlas Refactoring | **63.3** | 51.0 | 51.9 | 37.4 | 62.4 | **66.0** |
| ProgramBench | **17.5** | 17.5 | 18.0 | 24.5 | 25.0 | **39.5** |
| PostTrainBench | **35.6** | — | 33.2 | 32.0 | **36.2** | 35.0 |
| Toolathlon-Verified | **74.1** | 69.1 | 73.3 | 74.7 | 73.7 | **76.5** |
| Humanity's Last Exam | **43.4** | 41.5 | 42.3 | — | 49.6 | **53.2** |
| HorizonMath | **8.8** | 5.3 | — | 7.1 | **10.8** | 5.3 |
| OneMillionBench | **65.4** | 63.1 | 64.5 | 63.5 | 67.1 | **68.1** |
Verglichen wird unter anderem mit [*GPT-5.6*](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) und [*Kimi K3*](https://t01.li/ki-news/kimi-k3-weights-lizenz-self-hosting/). Und trotz MoE musst du dir bei 1,56 TB Größe keine Gedanken machen, wo das Ding läuft – auf der besseren Bürokiste jedenfalls nicht, genauso wenig wie zuletzt *Kimi K3* mit seinen 1,5 Terabyte.
## Cohere Parse 5
Dokumenten-Parsing war diese Woche gleich zweimal ein Thema. Cohere macht den Anfang mit [*Parse 5*](https://cohere.com/blog/parse?ref=t01.li), einem Vision-Parsing-Modell, das klar auf Großabnehmer zielt – 2,3 Milliarden Parameter, 8.192 Token Kontextfenster. Den ParseBench-Score von 79,2 hat Cohere selbst ermittelt, und zwar als Mittel über drei der fünf ParseBench-Dimensionen. Charts und Visual Grounding, die zwei Kategorien, an denen die meisten Parser scheitern, sind rausgelassen. Das Hauptargument ist ohnehin der Preis von 1,50 $ je 1.000 Seiten.
Zu haben ist das über die Cohere Parse API, Microsoft Foundry sowie AWS SageMaker und [auf Hugging Face kannst du es ausprobieren](https://huggingface.co/spaces/CohereLabs/cohere-parse?ref=t01.li). Wenn du im großen Stil rechtlich unkritische PDF-, PPT- und JPEG-Dokumente durchschieben musst, um sie etwa an einen [RAG](https://t01.li/glossar/#rag) zu verfüttern, kann sich das rechnen.
## Introducing Light Parse
Bei Extend heißt die Antwort [*Light Parse*](https://www.extend.ai/resources/introducing-light-parse?ref=t01.li) – eine neue, günstige Parsing-Engine neben dem bestehenden schwereren *Performance Parse*. Die Trennung ist klar: *Light Parse* (Engine `parse_light`) ist für textlastige Dokumente mit einfachen Formularen und Tabellen gedacht und kostet 0,5 Credits je Seite, im Pay-as-you-go 0,00625 $ pro Seite, im Scale-Tarif 0,005 $. *Performance Parse* (Engine `parse_performance`) übernimmt komplexe Tabellen, verschachtelte Checkboxen, Handschrift oder schwierige Scans und schlägt mit 2 Credits beziehungsweise 0,025 $ pro Seite zu Buche.
In der hauseigenen RealDoc-Bench kommt *Light Parse* auf 90,5 % und damit auf die Spitzenposition unter den nicht-agentenbasierten Parsern, auf Databricks OfficeQA Pro sind es 54,9 %. Technisch lässt Extend sonst nicht viel raus. Der Pluspunkt für unsere heimischen Gefilde steht abseits der Benchmarks – es gibt eine EU-Data-Region und im [Dashboard unter eu1.extend.ai](https://dashboard.eu1.extend.ai/login?ref=t01.li) lässt sich explizit ein EU-Standort wählen.
## Gemini 3.5 Transcribe
Eine neue Woche, ein neues Gemini-Modell, aber die Überraschung bleibt aus: immer noch kein Pro. Stattdessen schiebt Google ein Transkriptionsmodell nach, was meine These stützt, dass jede KI-Bude erst ein Audio-Transkriptionsmodell im Katalog haben muss, bevor sie sich AI-Lab nennen darf.
[*Gemini 3.5 Transcribe*](https://ai.google.dev/gemini-api/docs/models/gemini-3.5-transcribe?ref=t01.li) kommt in zwei Geschmacksrichtungen – Transcribe Live für kontinuierliches Streaming über die Live API und *Gemini 3.5 Transcribe* für vorab aufgezeichnetes Audio. Beide sprechen über 85 Sprachen, unterstützen benutzerdefinierte Vokabulare und formatieren den Text automatisch. Bei der Sprecher-Erkennung geht richtig was: Bis zu acht Sprecher kann das Modell auseinanderhalten, ab drei markiert Google die Zuordnung allerdings als experimentell.
Preislich landet *Gemini 3.5 Transcribe* bei rund 5 $ je 1.000 Minuten, Transcribe Live bei 9 $ – gerechnet mit 25 Audio-Tokens pro Sekunde und 175 Text-Tokens pro Minute zu den jeweiligen API-Raten (2 $ je 1 Mio. Audio-Input, 12 $ je 1 Mio. Text-Output für Transcribe; 3,50 $ bzw. 21 $ für Live).
## Antigravity CLI transkribiert nun auch Sprache
Bleiben wir bei Google. [*Antigravity* CLI unterstützt seit Version 1.1.21](https://github.com/google-antigravity/antigravity-cli/releases/tag/1.1.21?ref=t01.li) den Befehl `/voice` und transkribiert Sprache direkt in den Prompt, gesteuert über die F5-Taste. Dazu gibt es ein neues Feld `cost` in der Statuszeile, das die geschätzten Kosten der laufenden Sitzung zeigt. Plus die üblichen Kleinigkeiten.
## Antigravity Generative UI Artifacts
Und noch mal Google: [*Antigravity* kann jetzt Generative UI](https://antigravity.google/blog/visualizing-with-the-help-of-antigravity?ref=t01.li). Über den Befehl `/generative_ui` bauen die Agenten interaktive Komponenten, dynamische Dashboards, Datenfluss-Visualisierungen und Design-Mockups, direkt im Artifact-Preview-Panel und in Echtzeit iterierbar. 3D geht auch.
Der Clou steht im Kleingedruckten. Die Visualisierungen sind zero-dependency – sie rendern lokal, ohne dass zusätzliche Pakete geladen werden, laufen offline und lassen sich als Artefakt exportieren und später wieder öffnen. Kein Server, kein Build-Schritt, kein npm-Gefummel. Frisch dazugekommen sind laut Changelog KaTeX-Formeln sowie Chart.js- und Plotly-Diagramme in den Widgets.
## Claude Memory aufgebohrt
Seit dem 25\. August teilen sich Chat und *Cowork* [denselben Memory](https://claude.com/blog/claudes-memory-works-everywhere-and-you-decide-whats-in-it?ref=t01.li) und greifen auf ein gemeinsames Gedächtnis zu. Führt *Cowork* eine Aufgabe in der Cloud aus, steht das, woran sich *Claude* aus deinen Chats erinnert, dort bereit – und umgekehrt. Wichtig: nur für Cloud-Tasks. Lokal laufende *Cowork*\-Sessions nutzen den geteilten Speicher nicht.
Sensible Themen – Gesundheit, ethnische Zugehörigkeit, religiöse Überzeugungen, Politik, Geschlechtsidentität – speichert *Claude* per Default nicht, dafür gibt es einen Opt-in in den Settings. SSN, Vorstrafen oder Immigration-Status landen selbst mit aktiviertem Opt-in nie im Speicher. Der gemeinsame Memory ist in Free, Pro und Max standardmäßig aktiv, bei Team und Enterprise muss ihn erst ein Owner freischalten.
## Claude gets its own browser in Cowork
*Claude Desktop* (macOS, Windows, Linux) hat jetzt [einen integrierten Chromium-Browser in *Cowork*](https://claude.com/blog/cowork-built-in-browser/?ref=t01.li), verfügbar für Pro-, Max- und Team-Pläne. Damit ziehen sie gegenüber der *ChatGPT*\-Desktop-App nach, die das ein paar Tage länger kann. Der Witz daran: Der Claude-eigene Browser ist vollständig unabhängig vom Benutzer-Browser auf dem System und erledigt ausschließlich agentische Aufgaben.
## Breaking Claude Code Opus 5 Auto Mode
Das kommt via Simon Willison, und tja – [kaum schreibe ich über den Auto Mode](https://t01.li/ai-dev/claude-code-auto-mode-default/), erscheint einen Tag später [ein Beitrag von Johann Rehberger](https://embracethered.com/blog/posts/2026/breaking-claude-code-opus-5-and-automode/?ref=t01.li), wie sich der Auto Mode von *Claude Code* kapern lässt, um *Claude* schadhaften Code ausführen zu lassen. Der Aufhänger ist harmlos: die Bitte, eine Website zusammenzufassen. Rehberger kommt damit über eine gezielte Kette auf 60 bis 80 % Erfolg bei kleiner Stichprobe.
Die Pointe steckt im Kontrast. Eine von Anthropic beauftragte Drittmessung hatte für [*Opus 5*](https://t01.li/ki-news/claude-opus-5-fast-fable-niveau-halber-preis/) im Auto Mode 0,00 % [Prompt-Injection](https://t01.li/glossar/#prompt-injection)\-Erfolg ausgewiesen. Rehberger hat den Befund gemeldet, auf zwei Wegen und immerhin über einen eine Antwort bekommen. Die war wenig befriedigend: Anthropic hat den Report als „Informative“ geschlossen, das Verhalten sei so beabsichtigt. Der Auto Mode sei eine Convenience-Funktion mit einem Best-Effort-Klassifikator, keine Sicherheitsgarantie; die echte Grenze seien OS-Isolation und Network-Egress-Control. [Simon Willison ordnet das Ganze mal ein](https://simonwillison.net/2026/Aug/27/breaking-claude-code-opus-5-auto-mode/?ref=t01.li).
Das simpelste Gegenmittel ist aktuell der Betrieb in einer Sandbox – was aber eher die Symptome bekämpft als die Ursache.
## ChatGPT Cloud Browser mit Login-Funktion
Der Cloud Browser von *ChatGPT Work* [erlaubt seit dem 25\. August einen Log-in](https://www.notebookcheck.com/ChatGPT-speichert-dein-Passwort-nicht-deine-Anmeldung-schon.1379113.0.html?ref=t01.li), ohne dass Benutzername und Passwort ans Modell gehen. Das läuft im Web und mobil, für Plus-, Pro- und Business-Nutzer. Klingt erst mal nach mehr Sicherheit.
Der Haken steht schon in der Notebookcheck-Überschrift – das Passwort speichert ChatGPT nicht, die Anmeldung schon. Du tippst die Zugangsdaten in ein sicheres Formular, das Modell sieht sie nicht, aber die eingeloggte Session bleibt danach als Cookie auf OpenAIs Servern liegen, bis sie abläuft. Wer sich um seine Sessions Gedanken macht, hat jetzt einen neuen Ort, an dem eine davon liegt.
## Das 5-Stunden-Limit ist zurück, Luna Reserve als Trostpflaster
Sechs Wochen lang liefen *Codex* und *ChatGPT Work* für Plus-Tier-Nutzer gegen das Wochenkontingent, Potzblitz ist jetzt der [5-Stunden-Deckel wieder da](https://9to5mac.com/2026/08/24/openai-restores-5-hour-codex-and-work-limits-for-chatgpt-plus-users/?ref=t01.li). Seit dem 25\. August, angekündigt von Codex-Lead Thibault „Tibo“ Sottiaux. Das rollende Fünf-Stunden-Fenster sitzt neben dem Wochenlimit; ist es leer, heißt es warten oder Credits nachkaufen. Die Pro-Pläne für 100 und 200 $ bleiben vorerst verschont.
Als Auffangnetz wirft OpenAI ausgewählten Plus- und Pro-Accounts [*Luna Reserve*](https://help.openai.com/en/articles/20001499-luna-reserve-in-codex-and-chatgpt-work?ref=t01.li) hin, einen Fallback-Modus mit etwas Restlaufzeit nach dem Limit:
> Luna Reserve provides additional usage only with Luna after regular usage is exhausted.
Klingt kulant, die Leistung ist aber überschaubar. Die Reserve läuft ausschließlich auf *GPT-5.6 Luna*, dem kleinsten Modell der Familie – demselben, das ab dem 31\. August das alte *GPT-5.4 mini* beerbt. Falls du also in die Drosselung rutschst, da du gerade an etwas Komplexem sitzt, bekommst du ausgerechnet das Leichtgewicht als Ersatz – nettes Trostpflaster. Für eine Aufgabe, die eigentlich *Sol* oder *Terra* gebraucht hätte, bringt das herzlich wenig.
## Vercel Sandbox is now globally available
Zum Abschluss Infrastruktur. Die [*Vercel Sandbox* läuft jetzt weltweit](https://vercel.com/changelog/vercel-sandbox-is-now-globally-available?ref=t01.li) – zum Start in vier Regionen: Washington (iad1), San Francisco (sfo1), Cleveland (cle1) und Paris (cdg1). Default bleibt das US-Rechenzentrum iad1, die einzige EU-Region ist Paris. Region-Auswahl gibt es in allen Plänen, Failover-Regionen nur für Pro und Enterprise, und Snapshots bleiben an ihre Region gebunden.
Einerseits schön, yeah – ein EU-Standort! Andererseits stehst du dank US Cloud Act trotzdem im Regen, sobald du Verträge mit US-Buden schließt und deine Daten eigentlich nicht Richtung USA abfließen sollen. Eine US-Behörde kann deinen US-Anbieter gesetzlich zur Herausgabe zwingen, egal wo die Daten physisch liegen – und der Default-Standort ist hier ohnehin Virginia. Technisch laufen die Sandboxes in isolierten Firecracker-microVMs, gedacht zum sicheren Ausführen von fremdem oder Agent-generiertem Code. [Details zum Nachlesen in den Docs](https://vercel.com/docs/sandbox?ref=t01.li).
## OpenAI kappt Cursor zum 12\. November
OpenAI und Musk, die nächste Eskalationsstufe ist ausgerufen. Das Coding-Tool *Cursor* verliert zum 12\. November 2026 den direkten Zugriff auf OpenAI-Modelle, [so die Ankündigung](https://openai.com/index/our-decision-on-cursor-following-its-acquisition-by-spacex/?ref=t01.li). Auslöser ist die Übernahme durch SpaceXAI, das sich *Cursor* – beziehungsweise dessen Entwickler Anysphere – Mitte August geshoppt hat; OpenAIs Vertrag lässt sich bei so einem Kontrollwechsel kündigen.
Bemerkenswert ist der Ton der Begründung. Man könne nicht darauf vertrauen, dass SpaceX die Nutzungsbedingungen einhält, schreibt OpenAI offen – und schreibt da „Elon Musk“ namentlich rein, mit Verweis auf frühere Vertragsbrüche seiner Firmen. Fast schon höflich schiebt man hinterher, wie sehr man *Cursor* und dessen Verdienste um die Dev-Community schätze – der Pflichtteil im Abschiedsschreiben.
Die Retourkutsche von Cursor-Mitgründer Michael Truell ließ nicht lange [auf sich warten](https://x.com/mntruell/status/2093532254006063557?ref=t01.li):
> We're sorry to see that OpenAI put out a note saying they plan to block Cursor users from accessing OpenAI models in three months. OpenAI models serve about 5% of Cursor user traffic, and we're speaking with the OpenAI team to resolve this. Cursor was one of the very first users of OpenAI, we've worked closely with their team for years, and we've trusted their platform to be neutral infrastructure for our business.
Wie sehr willst du einen bald ehemaligen Partner vorführen? Truell so: ja.
Wenn die 5 % tatsächlich stimmen, wird der Abschied nicht besonders vielen *Cursor*\-Nutzern wirklich wehtun – *Claude*, *Gemini* und *Grok* stehen im Editor außerdem auch bereit.
## Meta Projekt OT
Zum Schluss der Gossip, und was für einer. [Ars Technica hat einen wunderbaren Artikel](https://arstechnica.com/ai/2026/08/metas-scrapped-plans-to-go-ai-native-included-slashing-teams-by-60-percent/?ref=t01.li) darüber, wie Meta den feuchten Traum jeder Unternehmensberatung wahr lassen werde wollte – einzelne Teams um bis zu 60 % schrumpfen und den Rest an KI-Agenten übergeben. Intern lief das unter dem Codenamen „Project OT“ (Organization Transformation), ausgeheckt bei Zuckerbergs Januar-Retreat auf Hawaii. Das Ziel: das Unternehmen „KI-nativ“ machen, Startschuss war die erste Entlassungswelle im Mai.
Danach ging offenbar so viel schief, dass die zweite Welle, vorgesehen für November, gestrichen wurde. Meta betont, nie 60 % der Gesamtbelegschaft gemeint zu haben, nur einzelne Teams. Für eine Bude, die ihren KI-Kram gern ins [Enterprise-Segment verkaufen](https://about.fb.com/news/2026/06/meta-business-agent/?ref=t01.li) will, schreibt man das besser dann nicht auf die Website als Referenzimplementierung.
Der Artikel strotzt vor Zitat-Gold. Ein Highlight, das Reuters aus internen Beiträgen geholt hat:
> For instance, code changes made to the internal software platforms and infrastructure employees use on the job were up 220 percent year-over-year, according to a post by \[Meta CTO Andrew\] Bosworth in early June. But changes that led to new or upgraded features reaching Meta users were only up 36 percent.
Haben die ernsthaft erwartet, dass die Belegschaft das feiert – zumal niemand bei Meta sicher sein konnte, ob er/sie im November auch gehen darf? Kannst du dir nicht ausdenken.
Fin. Und auf die Gefahr hin, dass ich mich wiederhole: Passt auf eure Agenten und Sandboxes auf.
### Claude Code Auto Mode ist jetzt Default – und wann ich ihn machen lasse
URL: https://t01.li/ai-dev/claude-code-auto-mode-default/
Last updated: 2026-08-27T19:03:33.000Z
Den kompletten Stack hinter t01.li verwalte ich mit Claude Code. [Ghost](https://ghost.org/?ref=t01.li) samt CLI, NGINX, die Dienste drumherum, das Theme, die lokale Testversion – das läuft alles über das Terminal, und den [Coding-Agent](https://t01.li/glossar/#coding-agent) lasse ich die „Handarbeit“ machen. Meistens starte ich damit im Plan Mode, weil ich erst sehen will, was Claude Code vorhat, bevor er irgendwas anfasst. Seit dem 14\. August bekomme ich am Ende jedes Plans dieselbe Rückfrage: „Ausführen – im Auto Mode?“
Das ist relativ neu und kein Zufall, denn Anthropic hat den Auto Mode zum Standard erkoren.
## TL;DR
Auto Mode ist der neue Default in Claude Code – hier steht, was das praktisch heißt und wo die Grenze verläuft.
- Seit dem 14\. August ist Auto Mode der Start-Modus für neue Sessions auf Pro, Max und Team.
- „Weniger fragen“ heißt nicht „nicht prüfen“: Feste Permission-Regeln greifen zuerst, potenziell riskante Aktionen bewertet anschließend ein separates Classifier-Modell.
- Die harte Grenze ziehst du nicht in der CLAUDE.md, sondern über die `deny`\-Liste in der `settings.json`. `deny` schlägt jeden Modus, sogar Bypass.
- Auf einem eingefahrenen Stack mit Deny-Liste und Snapshots ist Auto Mode entspannt. Beim Neuaufsetzen bleibt Accept edits oder Manual die vernünftigere Wahl.
## Was Auto Mode als Default ändert
Seit Mitte August ist der Auto Mode der [eingebaute Start-Modus für neue Sessions](https://code.claude.com/docs/en/permission-modes?ref=t01.li) auf den Pro-, Max- und Team-Plänen – sofern keine eigene Permission-Konfiguration oder ein nicht unterstütztes Ausführungsszenario dazwischenfunkt. Wer vorher jede Datei-Änderung und jeden Shell-Befehl einzeln abgenickt hat, findet sich jetzt in einem Modus wieder, der deutlich weniger fragt.
Nur heißt „weniger fragen“ nicht „gar nicht prüfen“. Im Auto Mode entscheidet bei potenziell riskanten Aktionen nicht mehr automatisch der Nutzer, sondern ein separates Modell: der Klassifikator. Unkritische Reads, Dateiänderungen im Projekt und Aktionen, die bereits durch Permission-Regeln entschieden wurden, passieren vorher. Alles andere bewertet der Klassifikator und blockiert beispielsweise Aktionen, die über deinen Auftrag hinaus eskalieren, fremde Infrastruktur betreffen oder nach einer Prompt Injection aussehen.
Aus „ich bin der Türsteher“ wird „ein LLM ist der Türsteher“ – das ist der ganze Unterschied.
## Wie ich Modes in Claude Code fahre
Bei mir läuft fast alles über den Plan Mode, und das hat einen simplen Grund. Wenn ich mehrere kleinere und vor allem zusammenhängende Aufgaben auf einmal verteile und Claude Code seine Sub-Agents nutzen lasse, will ich den Plan sehen, bevor die loslegen – nicht jeden einzelnen Edit, sondern die Marschrichtung. Man sollte dabei aber immer berücksichtigen, dass mehrere Agents parallel den [Token-Verbrauch treiben](https://t01.li/ai-dev/token-effizienz-in-claude-code-was-hilft/).
Der Plan Mode ist bei mir nicht nur die Vorstufe zum Abnicken, sondern das Werkzeug für die Fragen, die vor einem Eingriff geklärt sein müssen. Bringt ein Ghost-Update eine Änderung mit, die mir schlimmstenfalls das Theme zerlegt? Sind Elemente inzwischen als deprecated markiert, auf die ich mich noch verlasse? Und dann die Dauerbaustelle, die ich seit zwei Monaten vor mir herschiebe – die Migration auf Tailwind 4\. Wie aufwendig wird diese Migration wirklich, und wann ist der richtige Moment, ohne dass die Seite zwei Tage im Umbau steht. Das sind Fälle, in denen ich die Analyse und den vorgeschlagenen Weg sehen will, bevor eine einzige Zeile geändert wird. Genau dafür ist Plan Mode gebaut.
Wenn der Plan steht und passt, nehme ich das Auto-Mode-Angebot von Claude Code an. Nicht aus Bequemlichkeit, sondern weil für diesen Stack die Voraussetzungen stimmen. Ich arbeite seit Monaten mit Claude Code an genau dieser Umgebung, ich kenne alle Ecken und Kanten des Setups, meine [CLAUDE.md ist über etliche Sessions gewachsen statt auto-generiert](https://t01.li/ai-dev/claude-md-best-practice-2026/), und darunter liegt ein Netz aus Backups und Server-Snapshots. Wenn im Auto Mode etwas schiefläuft, kostet mich das einen Rollback, keine Nacht vor dem Rechner.
Das ist die eigentliche Bedingung, unter der Auto Mode Sinn ergibt: nicht das Feature, sondern der Reifegrad drumherum. Ein eingefahrener Stack, [Guardrails](https://t01.li/glossar/#guardrails), die du selbst getestet hast, und ein Wiederherstellungspunkt, der greift. Fehlt eins davon, sieht die Rechnung anders aus.
## Der eigentliche Hebel ist nicht die CLAUDE.md
Hier lauert ein Fallstrick: Denn man steckt Mühe in die CLAUDE.md und meint, damit die Leine in der Hand zu haben. Das ist aber nur so halb korrekt. Die CLAUDE.md instruiert – sie sagt Claude, was gemeint ist, und der Agent hält sich dran, ähnlich wie er ein „push hier nichts ohne Rückfrage“ befolgt. Ein Riegel ist sie nicht.
Wer im Auto Mode eine harte Grenze will, zieht sie in der `settings.json`. Da liegen drei Listen: `allow`, `deny`, `ask`. Und `deny` schlägt alles – den Klassifikator, sogar den Bypass-Modus. Ein `deny` auf `Bash(rm -rf:*)` oder auf `Read(.env*)` steht, egal in welchem Modus die Session läuft. Genau das macht Auto Mode auf einem Produktions-Stack erst verantwortbar. Der Klassifikator ist die zweite Verteidigungslinie, die erste sind ein paar Zeilen, die ich selbst geschrieben habe. Das Modell darf großzügig durchwinken, weil die Deny-Liste die echten Katastrophen schon vorher aussortiert hat.
Die Arbeitsteilung in einem Satz: `settings.json` setzt durch, CLAUDE.md redet gut zu. Das sollte man nicht verwechseln, denn dann verlässt man sich an der falschen Stelle auf gutes Zureden.
## Der Türsteher ist auch nur ein Modell
Bleibt der Reality-Check, und Anthropic liefert ihn selbst mit: So steht im Warnkasten der Doku, „Auto Mode“ senke die Prompts, aber „does not guarantee safety“ und sei kein Ersatz für Review bei sensiblen Operationen. Der Anbieter schreibt die Grenze selbst hin, statt sie wegzulächeln. Denn hinter der letzten Entscheidung steckt trotz fest definierter Regeln ein Modell. Die Policy gibt den Rahmen vor, die konkrete Einordnung bleibt probabilistisch – und damit nicht unfehlbar. Bei mir schlägt dieser Schnitt in die vorsichtige Richtung aus: Der Klassifikator blockiert gefühlt lieber einmal zu oft als zu selten, und selbst für bekanntes Terrain ist das die angenehme Fehlerrichtung. Lieber ein Block zu viel als eine Aktion, die durchrutscht.
Auf unbekanntem Terrain kippt die Rechnung. Da verschiebe ich ein Risiko, das ich vorher mit eigenen Augen gesehen hätte, auf eine Instanz, die im Schnitt richtig liegt. „Im Schnitt richtig“ ist bei einem Produktionsserver eine andere Aussage als bei einem Playground oder einem Testprojekt.
Das eingebaute Checkpoint-System erfasst Dateiänderungen über Claudes Editing-Tools und lässt sie per `/rewind` zurückdrehen – ein gutes Sicherheitsnetz, aber kein vollständiger Rollback. Änderungen durch Bash-Kommandos werden nicht erfasst, und auch Edits normaler Sub-Agents lassen sich darüber in der Regel nicht wiederherstellen. Genau deshalb bleiben meine eigenen Server-Snapshots und Git die Ebene, auf die ich mich im Zweifel verlasse.
Claude Code CLI
## Wann Auto Mode das Falsche ist
Setze ich einen Stack neu auf, ist Auto Mode meistens die falsche Wahl. Dann kenne ich die Umgebung nicht gut genug, um zu merken, wenn der Agent in die falsche Richtung rennt – und genau dieses „Bemerken“ ist der Wert der Einzel-Freigabe, der eigentliche Sinn von [Human-in-the-loop](https://t01.li/glossar/#human-in-the-loop). In dem Fall greife ich zu „Accept edits“ oder gehe ganz auf „Manual“ zurück.
Ein Detail dazu, das in der Arbeit mit dem Stack schnell auffällt: auch „Accept edits“ winkt nicht alles durch. Der Modus lässt Datei-Änderungen und gängige Filesystem-Befehle im Arbeitsverzeichnis ohne Rückfrage laufen: `mkdir`, `touch`, `rm`, `rmdir`, `mv`, `cp` und `sed`. Andere Bash-Befehle außerhalb des eingebauten Read-only-Sets prompten weiterhin, sofern sie nicht über eigene Permission-Regeln freigegeben sind. Damit ist „Accept edits“ beim Neuaufsetzen die gezieltere Wahl als „Auto“. Die reine Schreibarbeit läuft flüssig, aber alles, was in die Systemebene greift, landet wieder bei mir. Man macht sich nicht zum Klick-Sklaven und gibt trotzdem nicht die Kontrolle ab, wo sie wichtig ist.
„Manual“ ist der Fall, wenn ich jeden Schritt sehen will – erstmalige Migrationen, alles was an Auth oder an die NGINX-Config geht, Sachen, bei denen ein falscher Move teuer werden könnte.
## Das Netz muss vorher hängen
„Auto Mode“ als Default ist die richtige Entscheidung für den Durchschnittsfall – wer an vertrauten Projekten arbeitet, will nicht bei jedem Edit klicken. Für meinen t01.li-Stack passt es, weil das Sicherheitsnetz vorher gespannt war und nicht danach: eine Deny-Liste, die die scharfen Kanten abräumt, und Snapshots, die einen Fehler zum Rollback machen statt zur Nachtschicht. Die Frage ist nie „ist Auto Mode sicher“, sondern ob mein Setup an dem Punkt ist, an dem ich einem LLM den Türsteher überlassen kann. Bei mir und in diesem Fall: ja. Beim nächsten frischen Server: erst mal nicht.
### AI Picks der 34. KW
URL: https://t01.li/ai-shorts/ai-picks-der-34-kw/
Last updated: 2026-08-23T07:40:53.000Z
Letzte Woche muss irgendwo eine Abgabefrist für Jahresberichte gelegen haben, anders kann ich mir die Flut nicht erklären. Diese Woche ist da deutlich entspannter, alle haben weniger auf dem Zettel. Immer noch kein Blech … ähm, ich meine Hardware, aber dafür etwas Spannendes von der [GEO](https://t01.li/glossar/#geo)\-Front.
Was mir beim Sortieren auffiel: Drei Meldungen erzählen dieselbe Geschichte aus drei Richtungen. ChatGPT sucht seit dem 8\. August gezielt innerhalb einzelner Domains, Vercel misst, wie gut eine Website für Agenten überhaupt lesbar ist, und Anthropic gibt Claude den Accessibility Tree statt Screenshot-Koordinaten. Deine Website ist keine visuelle Seite mehr. Sie wird zur Abfrageoberfläche für Agents.
Dann mal auf in die Picks der 34\. Kalenderwoche.
## ChatGPT search now uses the site:operator at scale
Simon Willison [verweist auf eine Auswertung von Promptwatch](https://simonwillison.net/2026/Aug/20/chatgpt-search-now-uses-the-siteoperator-at-scale/?ref=t01.li), nach der ChatGPT bei seinen Fanout-Abfragen inzwischen gezielt innerhalb einzelner Domains sucht. Die [Zahlen dahinter](https://promptwatch.com/data/chatgpt-site-operator-fanouts?ref=t01.li) sind ungewöhnlich eindeutig. Wochenlang lag der Anteil domain-gescopter Suchen zwischen 0,3 und 0,5 Prozent, sackte vom 3\. bis 5\. August kurz auf 0,15 ab und sprang am 8\. August auf 16,8 Prozent. Vorher etwa eine von 280 Abfragen, jetzt ungefähr jede sechste.
Interessanter als der Sprung ist aber die zweite Kurve, die Promptwatch danebenlegt. Am selben Tag stieg die durchschnittliche Zahl der Fanout-Abfragen pro Antwort von rund 1,08 auf 1,83\. Die domain-gescopten Suchen kommen also obendrauf, sie ersetzen die generischen nicht. Deine bisherigen Chancen bleiben.
Vorher aber ein paar kleine Dämpfer in dem Artikel von Promptwatch: Willison hat sich das Tool angesehen und vermutet dahinter eine Signatur der Form `search(query, recency, domains)`, also einen Domain-Parameter und keinen echten `site:`\-Operator. Die Datenbasis deckt außerdem nur die Prompts ab, für die Promptwatch automatisiertes Tracking laufen hat. Und Promptwatch ist selbst ein GEO-Anbieter, der solche Auswertungen als Content-Marketing veröffentlicht, was Willison auch deutlich äußert.
An der Arbeit ändert das trotzdem etwas Konkretes. Wenn ChatGPT `site:deinedomain.de [Thema]` abfeuert, durchsucht es deine Website direkt, und was dort nicht indexiert ist, existiert für diese Abfrage nicht. Da bleiben also gleich zwei Hausaufgaben: [Client-seitiges Rendering ist und bleibt ’ne Scheißidee](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/), wofür die viel zitierte Vercel-Analyse von über 500 Millionen GPTBot-Abrufen ohne eine einzige JavaScript-Ausführung weiterhin die größte Stichprobe liefert. Einzige nennenswerte Ausnahme ist *Gemini*, das sich bei Googlebots Rendering-Infrastruktur bedient und deshalb sieht, was ChatGPT und Claude entgeht. Und Crawlability samt Indexierbarkeit gehören ins regelmäßige Monitoring, wobei eine Sitemap und eine vernünftig gebaute robots.txt schon das meiste erledigen. Wer wissen will, welche [KI-Crawler](https://t01.li/glossar/#ki-crawler) da überhaupt vorbeikommen, [schaut ins Logfile](https://t01.li/geo-seo/logwerk-weil-ich-nur-sehen-wollte-welche-bots-den-log-vollmullen/).
Kleine Randnotiz mit Folgen für alle, die auf Community-Traffic gebaut haben: In einem [Nachtrag vom 18\. August](https://promptwatch.com/data/reddit-citations-are-dropping-in-chatgpt?ref=t01.li) berichtet Promptwatch, dass Reddit in diesen Suchen deutlich seltener auftaucht – oops.
## Is Agentic
Ein kleiner Service von Vercel, gebaut zusammen mit Ora, das auch jeden Scan ausführt. [*Is Agentic*](https://is-agentic.com/?ref=t01.li) prüft eine Website darauf, was Agenten dort finden, abrufen, verstehen und benutzen können, und vergibt einen Score bis 100.
Die Gewichtung ist erfreulich unaufgeregt. Den Großteil tragen Essential Checks: server-gerendertes Markup, korrektes HTTP-Verhalten, saubere Dokumentstruktur, wiederherstellbare Fehler, bedienbare Controls. Recommended Checks springen nur an, wenn der Scan tatsächlich eine API, OAuth, GraphQL, einen [MCP](https://t01.li/glossar/#mcp)\-Server oder eine Commerce-Oberfläche findet. Was nicht zutrifft, fällt raus statt durch. Den Report gibt es neben der Weboberfläche auch als JSON, als Markdown unter derselben URL und über einen eigenen MCP-Server.
Beim üblichen Verdächtigen bleibt Vercel bemerkenswert nüchtern. Emerging Formats wie llms.txt geben begrenzten Bonus, ihr Fehlen senkt den Score nie. Wer also gehofft hatte, sich eine Textdatei ins Wurzelverzeichnis zu legen und damit fertig zu sein, findet hier keine Bestätigung.
Die schönste Zahl steht auf der Startseite. In den Featured Scores liegt is-agentic.com bei 100 von 100 und ora.ai bei 98, während vercel.com mit 85 einläuft. Wenn der Anbieter seiner eigenen Prüfung fünfzehn Punkte schuldig bleibt, spricht das mehr für die Ernsthaftigkeit des Tests als jedes Marketing-Zitat.
## Anthropic’s new browser tool doesn’t actually run a browser
Der Titel [beim New Stack](https://thenewstack.io/anthropic-browser-use-tool/?ref=t01.li) sitzt, und er beschreibt die Stelle, an der es dann auch interessant wird. Das neue *Browser Use* nutzt den Accessibility Tree, um Elemente direkt zu adressieren, statt aus Screenshots zu erraten, wo auf dem Screen ein Button liegt – ruft Claude `read_page` auf, kommt eine Textdarstellung des Baums zurück, in der Links, Buttons und Textfelder Referenzen wie `ref_3` tragen. Statt `x: 640, y: 320` schickt Claude dann die Referenz.
Angekündigt wurde das am 20\. August als Teil eines größeren Pakets, bei dem auch Computer Use, die Skills API und die Files API allgemein verfügbar werden. Ansprechbar ist das Toolset über die Claude API als `browser_toolset_20260801`, in Claude Managed Agents bislang nicht.
Der Haken steckt im Wort „doesn’t run“. Anthropic führt hier gar nichts aus. Deine Anwendung hostet den Browser, übersetzt jede der standardmäßig 27 Operationen in eine echte Aktion, hält die Session über die Turns hinweg und liefert genug Information zurück, dass Claude versteht, was passiert ist. Navigiert der Tab zwischendurch weg, wird eine Referenz ungültig, und die API merkt das nicht von selbst. Dein Executor muss das erkennen, die Aktion ablehnen und Claude die Seite neu lesen lassen.
Dazu die Rechnung, die man vor dem Bauen kennen sollte. Das Default-Toolset schlägt laut Anthropics Preisdoku mit rund 6.600 Input-Tokens pro Request zu Buche, bevor Screenshots und Accessibility Trees überhaupt dazukommen. Einzelne Operationen lassen sich abschalten. Gegenläufig wirkt das neue Batching, bei dem mehrere Aktionen in einem Model-Turn ankommen und der Reihe nach abgearbeitet werden, was Latenz und Modellaufrufe spart. Genau das macht Freigaben schwieriger, weil ein harmloser Klick am Anfang einer Sequenz in etwas münden kann, das eigentlich eine Rückfrage gebraucht hätte.
Und Achtung, Verwechslungsgefahr zum Schluss: Es gibt ein unabhängiges Open-Source-Projekt namens [Browser Use](https://github.com/browser-use/browser-use?ref=t01.li), das AI-Browser-Agenten über das Chrome DevTools Protocol fährt. Mit Anthropics Tool hat es nichts zu tun außer dem Namen.
## Firecrawl connector for Claude
Firecrawl ist offizieller Connector. [Der Eintrag steht im Anthropic-Verzeichnis](https://x.com/firecrawl/status/2089743044778115228?ref=t01.li), und wer den MCP-Server bisher von Hand konfiguriert hat, kann sich das sparen. Die [Doku sagt es deutlich](https://docs.firecrawl.dev/developer-guides/mcp-setup-guides/claude-ai?ref=t01.li): kein Custom Connector, keine Server-URL zum Einfügen, stattdessen Verbinden über das Verzeichnis und pro Unterhaltung im Plus-Menü aktivieren.
Wichtig für die Einordnung ist Anthropics eigene Trennung zwischen lokalen Desktop Extensions und Remote Connectors. Firecrawl ist Letzteres und damit in Web, Desktop und Mobile verfügbar, nicht nur in der Desktop-App. Das [Plugin für Claude Code](https://www.firecrawl.dev/blog/firecrawl-official-claude-plugin?ref=t01.li) gibt es ohnehin schon länger. Auf Team- und Enterprise-Plänen muss ein Owner den Connector erst freigeben, und die Requests laufen über Credits und Plan des Teams, das du beim Anmelden auswählst.
## Claude Code can design now
Diese Überschrift geht schon fast ein wenig in Richtung Clickbait, aber sie kommt nicht von mir. Das hat sich [Anthropic ganz allein ausgedacht](https://x.com/ClaudeDevs/status/2089471692762673408?ref=t01.li).
Dahinter steckt der neue Skill `/design`, der den Artboard-Workflow aus *Claude Design* in CLI und Desktop holt, gebaut auf Artefakten. Du beschreibst den Screen, bekommst mehrere editierbare Varianten nebeneinander, wählst eine aus, schiebst Farben und Abstände zurecht und lässt erst dann implementieren. Pick, tweak, implement. Unterstützt wird das ab Pro, außerdem in Max, Team und Enterprise.
Zwei klitzekleine Details gingen in der Aufgeregtheit unter: Das läuft als Research Preview. Und ein Artboard bleibt technisch das, was ein Artefakt eben ist, eine einzelne HTML-Seite mit Inline-CSS und JavaScript unter strenger Content Security Policy, ohne eigenes Backend. Das reicht für einen Entwurf, aber mehr dann auch nicht.
## Antigravity IDE Extensions
Für Visual Studio Code, Visual Studio (Preview), die JetBrains-IDEs ab Version 2026.2.1 und *Zed* ist nun eine [offizielle Erweiterung für *Antigravity*](https://antigravity.google/blog/antigravity-ide-extensions?ref=t01.li) verfügbar. Google beschreibt sie ausdrücklich als leichtgewichtig: Der Multi-Agent-Betrieb bleibt in Antigravity 2.0, der Editor ist für die Stellen da, an denen man in konkrete Codepfade schaut oder mit dem Debugger durch Logik steppt. Einloggen geht mit jedem Plan inklusive Free Tier. Enterprise läuft über Gemini Enterprise oder Google-Cloud-Credentials unter Cloud-ToS, ohne Training auf euren Daten und mit IAM sowie VPC Service Controls.
Und jetzt schaut mal in den Kalender: Die Gemini-Code-Assist-Extensions haben für Consumer-Tiers am [18\. Juni aufgehört, Requests zu bedienen](https://docs.cloud.google.com/gemini/docs/codeassist/release-notes?ref=t01.li), die GitHub-Variante wurde am 17\. Juli endgültig abgeschaltet, Enterprise- und Standard-Lizenzen laufen unverändert weiter. Das sind zwei Monate, in denen Google seine eigenen Nutzer ohne IDE-Integration hat sitzen lassen – mit Verweis auf die Standalone-App. Wer eine Konsolidierung ankündigt, sollte den Ersatz vor der Abschaltung liefern.
## Multica
Da bin ich auch erst diese Woche drübergestolpert und habe noch keinen richtigen Use Case dafür, weil das aktuell mit Kanonen auf Spatzen geschossen wäre. Ändern kann sich das aber schneller, als man so denkt.
*Multica* ist ein Workspace, um verschiedene [Coding-Agents](https://t01.li/glossar/#coding-agent) an einem Ort zu verwalten. Du weist ein Issue einem Agenten zu wie einem Kollegen, der zieht die Arbeit, meldet Fortschritt, hebt die Hand bei Blockern und legt am Ende einen Pull Request hin. Unterstützt werden unter anderem *Claude Code*, *Codex*, *Cursor Agent*, GitHub *Copilot CLI,* *OpenClaw*, *OpenCode*, *Hermes*, *Gemini*, *Pi*, *Kimi* und *Kiro CLI*. Ausgeführt wird über einen Daemon auf deiner Maschine oder einer Cloud-Box, der Code bleibt dort. [47.3k Sterne auf GitHub](https://github.com/multica-ai/multica?ref=t01.li), Backend in Go, Self-Hosting geht, alternativ gibt es SaaS über [multica.ai](https://multica.ai/?ref=t01.li). Der Name nickt in Richtung Multics, dem Time-Sharing-Betriebssystem der Sechziger.
Bei der Lizenz lag meine erste Recherche falsch. Die [LICENSE-Datei](https://github.com/multica-ai/multica/blob/main/LICENSE?ref=t01.li) heißt „Multica License“ und besteht aus zwei Teilen, wobei Apache 2.0 nur der zweite ist. Teil eins bringt Zusatzbedingungen, die bei Konflikt Vorrang haben: kein gehosteter Dienst für Dritte ohne kommerzielle Lizenz, auch kostenlos nicht und auch ohne Werbung nicht. Logo, Produktname und Attribution dürfen nicht raus – auch nicht aus einem Fork. Wer nur Backend, Daemon oder CLI verwendet, muss in der nutzerseitigen Doku auf Multica hinweisen und verlinken. Beitragende stimmen zu, dass der Hersteller die Lizenz jederzeit verschärfen darf.
Interner Betrieb in einer Organisation ist ausdrücklich frei, und für die meisten hier dürfte das der einzige relevante Fall sein. Es ist trotzdem das Muster, das ich mittlerweile bei jeder zweiten Bude sehe, und GitHub weist die Lizenz konsequenterweise als „NOASSERTION“ aus.
Mein Take dazu: Nützlich sieht das aus und ich werde das bei Zeiten bestimmt auch mal ausprobieren. Nur „Open Source“ nennen wir es besser mal nicht.
## Claude Academy
Anthropic hat am 20\. August [*Claude Academy* gestartet](https://claude.com/blog/anthropics-approach-to-teaching-and-learning-ai?ref=t01.li), eine eigene Lernplattform unter [academy.claude.com](https://academy.claude.com/?ref=t01.li). Angeboten werden fünf Produktstrecken zu Claude.ai, Cowork, Code, Tag und Platform, dazu die AI-Fluency-Kurse rund um das hauseigene 4D-Framework aus Delegation, Description, Discernment und Diligence. Alles kostenlos, mit Badges, personalisierten Empfehlungen und einem eigenen Skill, der Lernpfade vorschlägt.
Das Verkaufsargument im Blogpost ist ehrlicher, als ich erwartet hätte: Es sei dasselbe Material, mit dem Anthropic seine eigenen Leute im Onboarding schult.
Das bestehende Angebot unter anthropic.skilljar.com läuft seit Anfang März weiter und trägt nach wie vor die Zertifizierungen zum Associate, Developer und Architect sowie die Partner Academy. Zwei Angebote nebeneinander also, nicht eines auf dem anderen. Ob sich beide Angebote irgendwie sinnvoll ergänzen, habe ich mir ehrlicherweise noch nicht angesehen.
## Gemini 3.7 Flash: Developer Guide
Parallel zum Release von *Gemini 3.7 Flash* hat Google auch den [Developer Guide](https://aistudio.google.com/learn/gemini-3-7-flash-developer-guide?ref=t01.li) veröffentlicht, der mir erst diese Woche vor die Füße gefallen ist. Der hätte gerne auch ausführlicher ausfallen dürfen. Immerhin gibt er eine Idee davon, was sich Google bei dem Modell gedacht hat. Das Marketing muss man gedanklich ein Stück weit ausklammern.
Nützlich ist vor allem die Migrationsliste, weil dort die Bruchstellen stehen und nicht die Superlative. `temperature`, `top_p` und `top_k` sind deprecated, `thinking_budget` heißt jetzt `thinking_level` mit den Stufen low, medium und high, `candidate_count` fliegt raus, und Model-Turns vorbefüllen geht nicht mehr. Wer eine ältere Gemini-Anwendung einfach auf die neue Model-ID umbiegt, sammelt genau dort seine Fehler ein. Das [Kontextfenster](https://t01.li/glossar/#kontextfenster) liegt bei einer Million Token, maximal 64.000 gehen raus.
Für die Kalkulation relevant: Die 0,75 $ je Million Input- und 3,75 $ je Million Output-Token sind Einführungspreis bis zum 31\. Dezember 2026, danach verdoppelt Google auf 1,50 beziehungsweise 7,50.
## DeepSeek-V4-Flash-Vision-Exp
DeepSeek ist bei der Modellbezeichnung so wunderbar pragmatisch: „Nennen wir das Teil halt so, wie wir es über die API ansprechen würden“ – total simpel und logisch.
Es handelt sich um ein experimentelles, multimodales Modell, das die Textfähigkeiten von *DeepSeek-V4-Flash* bei [Reasoning](https://t01.li/glossar/#reasoning-modell) und Weltwissen beibehält und um Bildverarbeitung erweitert, [berichtet The Decoder](https://the-decoder.de/deepseek-bringt-experimentelles-vision-modell-fuer-multimodale-agenten-auf-den-markt/?ref=t01.li) unter Berufung auf DeepSeeks eigene Ankündigung. Bilder beschreiben, Text aus Screenshots ziehen, Diagramme lesen. Angesprochen wird über das OpenAI-Chat-Completions-Format, den Anthropic-Messages-Endpoint oder die Responses-API, und die [DeepSeek Harness](https://t01.li/glossar/#harness) unterstützt es ab 0.1.1 direkt.
Die [API-Doku](https://api-docs.deepseek.com/guides/vision/?ref=t01.li) ist an einer Stelle bemerkenswert konkret. Ein Bild kostet maximal 384 Token, unabhängig von der Ausgangsauflösung, weil vor der Verarbeitung ohnehin auf etwa 800 × 800 Pixel normalisiert wird. Ein optionales `detail`\-Feld drückt auf 512 × 512, wenn feine Details egal sind. Bis zu 600 Bilder pro Request sind erlaubt, ab 15 Bildern sinkt die maximale Kantenlänge von 8.192 auf 4.096 Pixel, und einbetten lassen sie sich ausschließlich in User-Nachrichten. Das Format erkennt DeepSeek am tatsächlichen Dateiinhalt statt am Dateinamen oder am deklarierten MIME-Typ, was Ärger spart. Dazu kommt eine kostenlose [Files-API](https://api-docs.deepseek.com/guides/files%5Fapi?ref=t01.li), über die eine Datei bis 64 MiB einmal hochgeladen und danach per ID mehrfach referenziert wird. Abgerechnet wird zu V4-Flash-Preisen.
Bei den [Benchmarks](https://t01.li/glossar/#benchmark) das übliche Sternchen hinten dran wegen den Herstellermessungen. DeepSeek sieht die Vision-Variante in internen multimodalen Agenten-Tests nahe an [*Opus 4.8*](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/) und stellenweise darüber (übrigens: Opus 5 haben sie gar nicht erst erwähnt).
## MiniMax Design
Eher unüblich für den hier gesetzten thematischen Rahmen, aber spannend, weil es mal was Neues ist. MiniMax stellt für Windows ab 10 und macOS ab 13 eine [Desktop-App](https://design.minimax.io/?ref=t01.li) bereit, die für KI-Content-Produktion gebaut wurde, mit klarem Schwerpunkt auf Video. Im Zentrum steht das eigene Modell *MiniMax H3*, drumherum arbeitet ein Team aus vier Agenten für Copy, Bild, Video und Audio parallel auf einem Canvas, dessen Nodes sich selbst verbinden. Dazu kommen wiederverwendbare Skills aus einem Marktplatz, eine 3D-Director-Stage zum Vorabstellen von Kamerafahrten und ComfyUI-Nodes für alle, die es genauer wollen. Als Zielgruppen nennt MiniMax [auf X](https://x.com/Hailuo%5FAI/status/2090613786046779485?ref=t01.li) und der Produktseite Short Dramas, E-Commerce, Brand-TVCs und Ad Creatives, und den Anspruch bringt das Unternehmen schon in der Selbstbeschreibung der Plattform unter:
> AI Agent Platform for Commercial Content Creation
Bereitgestellt werden auch reichlich Modelle anderer Anbieter, und das [Tutorial](https://my.feishu.cn/wiki/X3pGw8I5Gi6E1fkMqQpcP5ZBnHd?ref=t01.li) listet sie mitsamt Preisen auf (Achtung, das lädt sehr, sehr langsam). Bei den Bildern *Nano Banana Pro* und *2 Flash*, *GPT Image 1.5*, *Seedream 4.5* und *5.0 Lite*, *Midjourney V7*, *Flux Kontext*, *Qwen Image Edit* und diverse *Kling*\-Generationen. Beim Video *Seedance 2.0*, *Wan 2.6*, die hauseigenen *Hailuo*\-Modelle und *Kling* bis hinauf zu *V3 Omni*. Dazu Text-to-Speech in zwei Stufen.
In dieser Preistabelle steht der ehrlichste Kommentar zu „Commercial Creation“. Abgerechnet wird in Credits, ein Bild kostet zwischen 20 und 150\. Video spielt in einer anderen Liga: *Kling V3 Omni* in 4K mit Referenzen schlägt mit 1.200 Credits pro Sekunde zu Buche, ein Fünfzehn-Sekunden-Clip landet damit bei 18.000\. *Wan 2.6* in 1080p bei fünfzehn Sekunden sind 2.400\. Bei *Seedance 2.0* und *2.0 Fast* ist die Credits-Spalte über alle sechs Zeilen komplett leer, während jedes andere Modell eine Zahl trägt. Und Teile der Tabelle sind noch nicht übersetzt, „有声“ und „无声“ für mit und ohne Ton, „积分/次“ für Credits pro Durchlauf.
Drinnen steckt interessanterweise eine EULA für eine kommerzielle Desktop-App, aber keine Open-Source-Lizenz. Kurioserweise ist das Modell darunter offener als die Hülle: *H3* selbst hat MiniMax als [Open Model](https://t01.li/glossar/#open-weights) veröffentlicht.
Mein Take: Das „Local-First Asset Center“ klingt nach Datensouveränität, meint aber nur, dass die Ergebnisse lokal landen. Generiert wird in Chinas Cloud, angemeldet wird sich mit einem HailuoAI-Account. Für Kundenmaterial würde ich das eher nicht anfassen, so aus einem EU-Standort heraus betrachtet.
## Hetzner Inference Experiment
Bei Hetzner plaudert man ein wenig aus dem Nähkästchen, wie das [Anfang August gestartete Inference-Experiment](https://t01.li/ai-shorts/ai-picks-der-33-kw/#hetzner-experimental-open-weight-llm-inference-api) tatsächlich gelaufen ist. Der [Rückblick nach einer Woche](https://www.hetzner.com/de/blog/inference-experiment/?ref=t01.li) ist eines der ehrlichsten Post-Mortems, die ich dieses Jahr aus einem Rechenzentrum gelesen habe.
Der Ablauf in Kurzform. Stiller Start am 7\. August, aktive Kommunikation ab dem 10., Kapazitätsgrenze nach sechs Stunden. Die Time to First Token lag im 99\. Perzentil zunächst bei fünf bis zehn Sekunden und schoss am zweiten Tag auf fast zehn Minuten hoch, womit die API zeitweise praktisch unbenutzbar war. Beliebtestes Modell war am ersten Tag *Qwen 3.6*, sowohl nach Anfragen als auch nach Tokens, und es blieb auch danach vorn, wenn auch mit sehr vielen kleinen Anfragen statt großer Lasten. Nebenbei ist der Kubernetes-Cluster für die OpenClaw-Instanzen ans Limit gelaufen, woraufhin der Reiter für neue Accounts abgeschaltet wurde. Mehrere Instanzen haben sich durch Nutzereingaben selbst in einen kaputten Zustand konfiguriert.
Der Kern steckt in der Hardware-Aufteilung. Der GEX131 hat genau eine RTX PRO 6000 Blackwell und bedient ausschließlich das kleine *Qwen*. Für *DeepSeek-V4-Flash*, [*GLM-5.2*](https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/) und *Kimi-K2.7-Code* hat Hetzner eigens Server mit acht dieser GPUs gebaut – und jeden davon exklusiv einem Modell zugewiesen. Die Maschinen können die großen Modelle also durchaus, es waren schlicht zu wenige davon im Pool. Deshalb der Schnitt:
> Das Inference Experiment wird fortgesetzt, allerdings in reduziertem Umfang: Kleinere Modelle wie Qwen 3.6 und 3.8 werden wir weiterhin anbieten. Bei großen Modellen legen wir vorerst eine Pause ein.
Auch interessant, denn sie hätten wohl gern *Kimi K3* angeboten, aber:
> K3 war bereits erschienen und versprach sehr gute Ergebnisse in öffentlichen Benchmarks. Die sehr spezifischen Lizenzanforderungen von K3 erlaubten es uns jedoch nicht, das Modell als kostenloses Experiment anzubieten.
Was Moonshot dort im Kleingedruckten verlangt, [habe ich mir Ende Juli angesehen](https://t01.li/ki-news/kimi-k3-weights-lizenz-self-hosting/), und Hetzner ist offensichtlich zum selben Schluss gekommen.
Auf der Roadmap stehen bessere Doku, ein Review der Modellauswahl anhand echter Nutzungsmetriken und möglicherweise Re-Ranking sowie Embeddings für [RAG](https://t01.li/glossar/#rag)\-Pipelines.
Spannend, spannend! Und vielen Dank und Gruß nach Gunzenhausen, dass sie sich den Stress überhaupt geben, das dann kostenlos bereitstellen und hinterher auch noch öffentlich berichten, was und wie es denn so gelaufen ist.
## GPT-5.6 Sol Preissenkung
OpenAI senkt die API- und Credit-Preise von [*GPT-5.6 Sol*](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) [um mehr als 20 Prozent](https://developers.openai.com/api/docs/pricing?ref=t01.li) für die nächsten drei Monate, konkret [laut Reuters](https://www.reuters.com/technology/openai-cuts-developer-pricing-frontier-gpt-56-sol-model-by-more-than-20-2026-08-21/?ref=t01.li) auf 4 Dollar je Million Input- und 20 Dollar je Million Output-Token. Das greift in der API sowie bei Codex-Credits und ChatGPT Work, während Pro, Plus und Business unverändert bleiben. Die [Begründung auf X](https://x.com/OpenAI/status/2090885187634905500?ref=t01.li) ist dann eher Marketing-Blabla – irgendwas mit Frontier vorantreiben bei gleichzeitig steigender Effizienz.
Die Geschichte hinter der Meldung steht woanders. Die [New York Times berichtet](https://www.nytimes.com/2026/08/21/technology/anthropic-ipo-100-billion.html?ref=t01.li) unter Berufung auf zwei Personen mit Kenntnis der Gespräche, Anthropics Banker stellten potenziellen Investoren einen Börsengang mit über 100 Milliarden Dollar Volumen bei rund zwei Billionen Bewertung in Aussicht. Ein Statement von Anthropic gibt es natürlich nicht dazu. Mitten in diese Roadshow hinein senkt der direkte Wettbewerber die Preise. Parallel kursieren Hinweise auf Tests eines *GLM-5.3-Flash*, was den Druck von der anderen Seite erklärt. Gesenkt wird hier weniger der Preis als die Bewertungsgrundlage der Konkurrenz.
## Ox Alpha, oder wie ich mich von drei Tweets aufs Glatteis führen ließ
Einige Labs nutzen OpenRouter gern dafür, ein neues Modell anonym zum Testen bereitzustellen, weder Lab noch Modell sind dann ersichtlich. OpenRouter kennzeichnet das als „Stealth“. Seit dem 20\. August liegt dort [*Ox Alpha*](https://openrouter.ai/stealth/ox-alpha?ref=t01.li), und die Community auf X.com hat seither wenig anderes zu tun.
Die Eckdaten laut Modellseite: 1.048.576 Token Kontext, maximal 131.072 Token Output, Text, Bild und Video rein, Text raus, [Tool Calling](https://t01.li/glossar/#tool-calling) und [strukturierte Ausgaben](https://t01.li/glossar/#structured-output), gedacht für Coding, langlaufende agentische Arbeit und Produktionslasten. Kostenlos, ein einziger Provider – der Prompts und Completions zwar speichert, aber nicht darauf trainiert.
Der Durchsatz liegt Stand 22\. August bei 21 Tokens pro Sekunde, was ungefähr dem entspricht, was ich vergangene Woche mit *Qwen3.8-27B* lokal auf meinem MacBook Pro M5 gemessen habe. Als Indiz für richtig fette Infrastruktur taugt das nichts. Herumgereicht wird stattdessen eine Kapazitätsansage: OpenCode nennt 100 Billionen Tokens pro Tag und hat das Angebot am 21\. August um sechs Tage verlängert, beim Nous-Research-Portal soll laut Alex Volkov sogar eine Billiarde pro Tag drin sein. Nur ist eine Ansage eben eine Ansage, und niemand hat sie nachgezählt. Belastbar sind die Zahlen, die OpenRouter selbst zählt. Allein über *Hermes Agent* sind 490 Milliarden Tokens gelaufen, über *Claude Code* weitere 314 Milliarden, bei 99,99 Prozent Uptime über drei Tage. Die erfolgreich ausgelieferte Inferenz liegt mit 99,51 Prozent etwas darunter, was bei einem kostenlosen Preview niemanden überraschen dürfte.
Zum Größenvergleich taugt der Pick von oben. Ein deutscher Hoster, der eigens Achtfach-GPU-Server baut, nimmt nach einer Woche die großen Modelle vom Netz, weil schlicht zu wenige davon im Pool stehen. Hier verschenkt jemand eine Kapazität, die im Bereich dessen liegt, was die größten Frontier-Anbieter für ihr komplettes Geschäft angeben. Das ist keine Fünf-Mann-Bude mit drei RTX-4090-Clustern im Keller.
Bei der ersten Spekulationsrunde hätte ich felsenfest behauptet, dass kein führendes US-Lab dahintersteckt, weil das nicht zu deren Umgang mit neuen Modellen passt. Große Ausnahme war OpenAI, die mit „Horizon Alpha“ und „Horizon Beta“ Ende Juli 2025 GPT-5-Vorstufen als Stealth auf OpenRouter gelegt hatten, was OpenRouter beim Launch von GPT-5 dann auch bestätigte. Einen Unterschied hebt OpenRouter diesmal selbst hervor: Bei Horizon wurde ausdrücklich für Feedback und Training mitgeloggt, bei *Ox Alpha* trainiert der Anbieter nicht mit. Dann fingen Leute aus dem Google-DeepMind-Lager an, beiläufig Öl ins Feuer zu gießen. Vamsi Batchu schrieb „Google is back. Trust the process.“, Jonathan Ouyang legte „It’s Gemini time :)“ nach, und ich war schon fast (aber auch nur fast) überzeugt: ein Google-Modell, nur eben nicht unter dem Namen *Gemini* oder *Gemma*.
Andere Menschen haben nicht spekuliert, sondern tatsächlich gemessen. [@unclecode](https://x.com/unclecode/status/2090776445413110143?ref=t01.li) hat neun Infrastruktur-Probes über [Tokenizer](https://t01.li/glossar/#tokenizer), Error Codes und versteckte Templates gegen zwölf Verdächtige laufen lassen, und eine Familie besteht jeden einzelnen Tokenizer-Test: GLM. Tim Dettmers [liefert einen zweiten Fingerabdruck](https://x.com/tim%5Fdettmers/status/2090866380484608066?ref=t01.li) und weist darauf hin, dass Zhipu eines der wenigen Labs mit schwachem Partial Prefill bei gleichzeitig schnellem Output ist, wobei das Modell rund 30 Prozent über *GLM-5.3* liegt. [@skalskip92](https://x.com/skalskip92/status/2091111645879677408?ref=t01.li) hat Luftbilder und Satellitenaufnahmen durchgeschickt und kommt zu einem klaren Nein zur Gemini-These, weil Googles Modelle bei Computer Vision traditionell stark sind und *Ox Alpha* dort bestenfalls Mittelmaß liefert.
Am schönsten hat es [@tokengremlin](https://x.com/tokengremlin/status/2091110055131189290?ref=t01.li) formuliert, als er fragte, ob es nicht ein bisschen demütigend sei, dass Google fremde Modelle als Marketing braucht, um Leute für *Gemini* zu interessieren. Die Vage-Posterei zielte offenbar nie auf *Ox Alpha*, sondern auf das, was bei Google selbst in der Pipeline steckt.
Die Leistung ist derweil so umstritten, dass beide Lager Belege haben. Auf einem DeepSWE-Subset [meldet @karanc\_12](https://x.com/karanc%5F12/status/2090703479904080054?ref=t01.li) über 80 Prozent gegen 52 für *GPT-5.6 Sol* und 65 für *Fable*. [Bindu Reddy dagegen](https://x.com/bindureddy/status/2090949366165152213?ref=t01.li) hat es evaluiert und sortiert es auf dem Niveau von *Kimi 2.6* ein, zwei Generationen alt, nennt es im selben Atemzug aber ein Marketing-Meisterstück. Auf einem kontaminationsfreien Privat-Benchmark [fällt es deutlich ab](https://x.com/jrysana/status/2090806300678451621?ref=t01.li), auf einem Cybersecurity-Benchmark [liegt es hinter jedem Frontier-Modell](https://x.com/pilvar222/status/2091155448590160048?ref=t01.li) außer *GPT-5.6 Luna*. Und dann [one-shottet es eine GPU-beschleunigte Fluidsimulation](https://x.com/scaling01/status/2090767627123589255?ref=t01.li) in tausend Zeilen HTML.
Das könnte alles noch sehr spannend werden. Oder eben auch nicht, wenn es sang- und klanglos wieder von OpenRouter in ein paar Wochen verschwindet und niemand auch nur ein Wörtchen rauslässt, was das denn nun genau war.
Ready for now. Nächste Woche vielleicht wieder mit mehr Blech und weniger Spekulation.
### KI-Kompetenz nach Art. 4: Was Unternehmen jetzt wirklich tun müssen
URL: https://t01.li/ki-alltag/ki-kompetenz-art-4-pflichten-kmu/
Last updated: 2026-08-19T07:01:25.000Z
Seit Februar 2025 gilt die KI-Kompetenzpflicht, seit dem 2\. August 2026 kann sie in Deutschland auch überwacht werden – und trotzdem braucht niemand einen staatlich anerkannten KI-Führerschein. Der AI Act verlangt weder einen Einheitskurs für die Belegschaft noch eine feste Stundenzahl. Er verlangt etwas Unbequemeres. Unternehmen müssen wissen, welche KI sie wofür einsetzen, welche Menschen dafür welche Fähigkeiten brauchen und warum die gewählten Maßnahmen zum Risiko passen.
Auf LinkedIn läuft dazu seit Wochen das erwartbare Programm. Die üblichen Verdächtigen – gestern noch Krypto-Experte, heute eben KI-Berater, der Markt will es so – produzieren Panikbeiträge im Akkord, meist mit wenig Substanz und viel Ausrufezeichen. In seriösen Newslettern taucht die angebliche Zertifikatspflicht dagegen kaum auf. Das allein ist schon ein brauchbarer Indikator.
Genau in diese Lücke zielt das [Panik-Marketing mancher Schulungsanbieter, das schon zum 2\. August ins Leere lief](https://t01.li/ki-alltag/eu-ki-verordnung-2-august-2026-kmu-selbstcheck/). Wer im August 2026 „gesetzlich vorgeschriebene KI-Zertifizierung“ verkauft, verkauft etwas, das es rechtlich nicht gibt. Was es stattdessen gibt, ist eine Organisationspflicht – und die ist mit gesundem Menschenverstand und überschaubarem Aufwand erfüllbar. Der Reihe nach.
## TL;DR
Art. 4 EU AI Act gilt seit Februar 2025, seit August 2026 wird er beaufsichtigt – als Förderpflicht, nicht als Prüfungspflicht.
- Der Digital Omnibus (Juli 2026) hat Art. 4 entschärft: Maßnahmen ergreifen ja, garantiertes Kompetenzniveau pro Person nein
- Keine Zertifikatspflicht, kein Einheitskurs, keine Stundenzahl, kein Pflicht-KI-Beauftragter
- Schon normale ChatGPT-Nutzung im Marketing fällt in den Anwendungsbereich
- Was zählt: KI-Inventar, rollenbezogene Maßnahmen, schlanke Dokumentation
- Hochrisiko-Pflichten sind verschoben (Dez. 2027 / Aug. 2028) – Art. 4 und Art. 50 gelten trotzdem jetzt
## Was der Digital Omnibus an Art. 4 geändert hat
Die ursprüngliche Fassung von Art. 4 verlangte von Anbietern und Betreibern, „nach besten Kräften“ ein ausreichendes Maß an KI-Kompetenz sicherzustellen. Eine Formulierung, die mehr Fragen aufwarf als beantwortete – welches Niveau ist ausreichend, wer misst das, und was passiert mit dem Kollegen, der nach drei Schulungen immer noch Kundendaten in den Chatbot kippt?
Die [Digital-Omnibus-Verordnung (EU) 2026/1744](https://eur-lex.europa.eu/eli/reg/2026/1744/oj?locale=de&ref=t01.li), seit dem 27\. Juli 2026 in Kraft, hat das aufgeräumt. Die neue Fassung verpflichtet Unternehmen, Maßnahmen zu ergreifen, die die Entwicklung von KI-Kompetenz fördern und unterstützen. Geschuldet ist damit ein angemessener organisatorischer Prozess, kein garantiertes Lernergebnis jedes einzelnen Mitarbeitenden. Die [FAQ der EU-Kommission](https://digital-strategy.ec.europa.eu/en/faqs/ai-literacy-questions-answers?ref=t01.li) bestätigt das ausdrücklich – ein spezifisches oder „ausreichendes“ Niveau ist nicht mehr vorgeschrieben.
Parallel hat der Omnibus die Fristen für Hochrisiko-Systeme deutlich nach hinten geschoben. Eigenständige Hochrisiko-KI nach Anhang III – etwa Bewerber-Screening oder Kreditwürdigkeitsprüfung – muss erst zum 2\. Dezember 2027 die vollen Betreiberpflichten erfüllen, KI als Sicherheitsbauteil in regulierten Produkten nach Anhang I zum 2\. August 2028\. Wer daraus ableitet, bis Ende 2027 sei nichts zu tun, liegt daneben. Art. 4 gilt seit Februar 2025 unverändert, und die [Transparenzpflichten nach Art. 50](https://kpmg.com/at/de/insights/2026/07/digital-omnibus-on-ai.html?ref=t01.li) – Kennzeichnung von Chatbots und synthetischen Inhalten – greifen seit dem 2\. August 2026.
In Deutschland kommt seit Ende Juli die Aufsicht dazu. Das [KI-Marktüberwachungs- und Innovationsförderungsgesetz (KI-MIG)](https://www.lto.de/recht/hintergruende/h/kuenstliche-intelligenz-ai-act-ki-mg-aufsicht-bussgeld?ref=t01.li), in Kraft seit dem 29\. Juli 2026, macht die Bundesnetzagentur zur zentralen Marktüberwachungsbehörde, Anlaufstelle und Beschwerdestelle. Beschäftigte, Mitbewerber oder Betroffene können vermutete Verstöße dort melden. Art. 4 selbst kennt zwar keinen eigenen Bußgeldtatbestand, aber im Rahmen eines Beschwerdeverfahrens landet die Frage nach den Kompetenzmaßnahmen trotzdem auf dem Tisch.
## Wer betroffen ist – Spoiler: fast jeder
Die KI-Verordnung unterscheidet zwischen Anbietern, die KI-Systeme entwickeln oder unter eigenem Namen auf den Markt bringen, und Betreibern, die KI-Systeme in eigener Verantwortung beruflich nutzen. Die überwiegende Mehrheit der deutschen KMU ist Betreiber – und zwar schneller, als vielen bewusst ist. Der geschäftliche Einsatz von *ChatGPT*, *Microsoft Copilot*, *Claude* oder *Gemini* reicht dafür aus, ebenso KI-Funktionen in Bestandssoftware wie CRM- oder ERP-Systemen.
Die EU-Kommission nennt in ihrer FAQ ausdrücklich das Beispiel von Beschäftigten, die *ChatGPT* für Werbetexte oder Übersetzungen einsetzen. Auch dann muss das Unternehmen über spezifische Risiken wie [Halluzinationen](https://t01.li/glossar/#halluzination) informieren. Ein [Human-in-the-Loop](https://t01.li/glossar/#human-in-the-loop) ersetzt die Kompetenzanforderung übrigens nicht – die kontrollierende Person braucht selbst die passenden Fähigkeiten, sonst kontrolliert da niemand, sondern nickt nur ab.
Erfasst sind neben der Belegschaft auch Auftragnehmer und Dienstleister, die im Auftrag der Organisation mit KI arbeiten. Wer keinerlei beruflichen Kontakt zu KI-Systemen hat, fällt umgekehrt nicht allein wegen seiner Unternehmenszugehörigkeit unter die Pflicht. Ein kurzes gemeinsames Fundament kann trotzdem sinnvoll sein, schon weil KI-Funktionen inzwischen ungefragt in Standardsoftware auftauchen und Shadow AI sonst unbemerkt bleibt.
## Was Art. 4 nicht verlangt
Der Markt für KI-Schulungen lebt gut von Behauptungen, die einer Prüfung nicht standhalten. Eine Auswahl, jeweils mit Rechtsstand August 2026:
- **„Jeder Mitarbeitende braucht ein Zertifikat.“**
Falsch. Es existiert keine Zertifikatspflicht, und Angebote, die mit staatlich vorgeschriebener KI-Zertifizierung werben, entbehren einer rechtlichen Grundlage.
- **„Alle müssen denselben Kurs absolvieren.“**
Falsch – ein Einheitskurs widerspricht der rollenbezogenen Logik des Gesetzes eher, als dass er sie erfüllt.
- **„Es gibt eine vorgeschriebene Stundenzahl oder Prüfung.“**
Weder Gesetz noch EU-FAQ nennen eine Dauer oder verlangen eine Wissensmessung.
- **„Ein KI-Beauftragter ist Pflicht.“**
Art. 4 schreibt keine Governance-Struktur vor. Die Rolle kann im KMU trotzdem als Koordinationsfunktion taugen.
- **„Das betrifft nur Hochrisiko-KI.“**
Art. 4 gilt für alle KI-Systeme im beruflichen Einsatz. Hochrisiko löst zusätzliche Anforderungen aus, später.
Das EU-Register mit [Praxisbeispielen zur AI Literacy](https://digital-strategy.ec.europa.eu/en/policies/ai-literacy-practices?ref=t01.li) ist übrigens Inspirationsquelle, keine Compliance-Vorlage. Die Kommission stellt klar, dass das Kopieren eines Registereintrags keine Konformitätsvermutung erzeugt.
## Was stattdessen zu tun ist
Die Pflicht lässt sich auf sechs Schritte herunterbrechen, die auch ein Zehn-Personen-Betrieb ohne Compliance-Abteilung schafft.
Erstens die tatsächliche KI-Nutzung erfassen – inklusive der inoffiziellen. Eine gepflegte Tabelle mit System, Zweck, Nutzergruppen, Datenarten und Kontrollpunkten genügt als Inventar. Zweitens die eigene Rolle klären, denn ein reiner Chatbot-Nutzer braucht anderes Wissen als ein Softwarehaus, das unter eigener Marke anbietet. Drittens Risiken je Anwendungsfall bewerten. Nicht der Modellname entscheidet über den Schulungsbedarf, sondern die Frage, ob am Ende ein interner Textentwurf steht oder eine Vorauswahl von Bewerbungen. Viertens Maßnahmen rollenbezogen gestalten – Basismodul für alle Nutzer, Vertiefung für Power User, HR, IT und Führung. Fünftens die Maßnahmen tatsächlich durchführen, wobei Einweisung, Leitfaden, Workshop oder E-Learning gleichermaßen zulässig sind. Und sechstens dokumentieren und aktualisieren, wenn neue Tools, neue Funktionen oder Vorfälle das erfordern.
Für die Geschäftsführung ist der Anspruch dabei überschaubarer, als es klingt. Sie muss nicht lernen, bessere [Prompts](https://t01.li/glossar/#prompt-engineering) zu schreiben. Sie sollte beantworten können, welche fünf KI-Anwendungen geschäftlich am wichtigsten sind, wer welche Systeme mit welchen Daten nutzen darf und wie das Unternehmen von Vorfällen erfährt. Wer diese Fragen nicht beantworten kann, hat kein Schulungsproblem, sondern ein Übersichtsproblem.
[Selbstcheck KI-Kompetenz nach Art. 4Sechs Schritte, Inventar-Vorlage und das schlanke Doku-Paket zum Abhaken.checkliste-ki-kompetenz-art-4.pdf65 KBdownload-circle](https://t01.li/content/files/2026/08/checkliste-ki-kompetenz-art-4.pdf "Download")
## Dokumentation: schlank schlägt Zertifikatsordner
Eine gesetzliche Prüfungs- oder Nachweisform schreibt Art. 4 nicht vor. Trotzdem ist Dokumentation der Punkt, an dem sich im Ernstfall alles entscheidet. Unterlässt die Geschäftsführung zumutbare Qualifizierungsmaßnahmen, riskiert sie bei Fehlern von Beschäftigten eine persönliche Haftung wegen Organisationsverschuldens nach § 130 OWiG und § 43 GmbHG. Führt mangelnde Prompt-Hygiene zu einer Datenpanne, drohen Bußgelder nach Art. 83 DSGVO. Und bei mitbestimmungspflichtigen KI-Systemen redet der Betriebsrat nach § 87 BetrVG mit.
Das größere praktische Risiko liegt darin, nach einem Vorfall nicht erklären zu können, welche Systeme bekannt waren, welche Risiken erkannt wurden und warum die Maßnahmen angemessen erschienen. Ein schlankes Nachweispaket – KI-Inventar, Kompetenzmatrix je Rolle, Maßnahmenblätter mit Datum und Zielgruppe, Teilnahme- oder Bereitstellungsnachweise, eine kurze Begründung der Angemessenheit und ein Aktualisierungsprotokoll – ist dafür wertvoller als ein dicker Ordner mit generischen Kursbescheinigungen. Ehrlich und aktuell schlägt umfangreich und tot.
## Take dazu
Art. 4 ist keine Einkaufspflicht für Schulungen, sondern eine Denkpflicht. Das Gesetz verlangt, den Kompetenzbedarf aus der realen KI-Nutzung abzuleiten und darauf angemessen zu reagieren – mehr nicht, aber auch nicht weniger. Der Digital Omnibus hat den Rechtsrahmen milder gemacht, die betriebliche Notwendigkeit bleibt. Kompetente Teams produzieren weniger Fehler, erkennen ungeeignete Anwendungen früher und holen aus freigegebenen Systemen mehr heraus. Compliance ist hier der Nebeneffekt, nicht der Zweck.
*Hinweis: Ich bin Marketing- und Tech-Mensch, kein Jurist. Dieser Artikel ist meine Einordnung öffentlich zugänglicher Quellen, keine Rechtsberatung. Die verbindliche Prüfung deines konkreten Einzelfalls, insbesondere bei Hochrisiko-Anwendungen, Beschäftigtenbewertung oder grundrechtssensiblen Einsätzen, kann und darf nur ein zugelassener Rechtsanwalt leisten.*
### AI Picks der 33. KW
URL: https://t01.li/ai-shorts/ai-picks-der-33-kw/
Last updated: 2026-08-16T14:57:58.000Z
Kein einziges Stück Hardware diese Woche, dafür ein Modell-Stau, wie ich ihn seit dem Frühjahr nicht gesehen habe. Meta, Alibaba, Nvidia, SpaceXAI, Z.ai, DeepSeek, Microsoft und Google haben zwischen Montag und Freitag abgeladen, dazu kommen Preisbewegungen in beide Richtungen.
Was mir beim Sortieren aufgefallen ist: Fast jeder dieser Releases argumentiert nicht mehr darüber, wie schlau das Modell ist, sondern wie viele Tokens es für eine Aufgabe verbrennt. Grok kommt mit einem Viertel des Inputs von Opus 5 aus, GLM schlägt Opus 4.8 mit 50.000 statt 120.000 Output-Tokens, Nvidia baut einen Router, damit das teure Modell die Fließbandarbeit gar nicht erst sieht, und IBM zieht dem Agenten-Gedächtnis die Rechnung ab. Bei DeepSeek läuft es genau andersherum – dort versechsfacht sich ausgerechnet der Cache-Preis.
Auf geht's in die doch sehr LLM-lastige 33\. Kalenderwoche des Jahres 2026, wohl bekomm's.
## Muse Glimmer
Bei Meta fällt mit [*Muse Glimmer*](https://research.meta.ai/blog/introducing-muse-glimmer-open-agentic-model?ref=t01.li) der kleine Bruder von Spark hinten raus. [Open Weights](https://t01.li/glossar/#open-weights) unter Apache 2.0, 30 Milliarden Parameter, gebaut für lokale Agenten-Workflows mit Text- und Bildeingabe, [Tool-Calling](https://t01.li/glossar/#tool-calling), mehrschrittigem Reasoning und automatischer Fehlerbehebung. Die Gewichte liegen auf [Hugging Face](https://huggingface.co/collections/meta-models/muse-glimmer?ref=t01.li).
Die Verwandtschaft zu *Spark* ist wörtlicher gemeint, als „kleiner Bruder“ vermuten lässt: Meta hat Glimmer per Logit-Distillation auf den Outputs von Muse Spark vortrainiert, mit ähnlichem Datenmix wie beim Lehrermodell. Unquantisiert bräuchte das Ding über 55 GB, mit [4-Bit-Kompression](https://t01.li/glossar/#quantisierung) bleiben unter 20 GB übrig – genug Luft für KV-Cache, Perception-Encoder und den Speculative-Decoding-Drafter innerhalb von 24 oder 32 GB. Optimierte Integrationen für llama.cpp, MLX und ExecuTorch sollen in den nächsten Tagen folgen, die [Entwicklerdokumentation](https://developer.meta.com/ai/models/muse-glimmer/?ref=t01.li) steht bereits.
Interessant für alle, die hier mitlesen und selbst basteln: Meta nennt *OpenClaw* explizit als kompatibles Scaffold. Und im Intelligence Index von Artificial Analysis liegt Glimmer bei 35 Punkten, was es in seiner Größenklasse an die Spitze setzt. Dazu gleich mehr bei Nvidia.
## Qwen3.8-27B Open Weights verfügbar
Sobald man X.com auch nur öffnet, [hagelt es einem Beiträge zu *Qwen3.8-27B* um die Ohren](https://x.com/Alibaba%5FQwen/status/2088280182356611304?ref=t01.li). Auf Hacker News landete der Release mit 893 Punkten auf Platz eins, und das Ding wird gerade durch die Community gereicht wie geschnitten Brot.
Der Kontrast, der das erklärt, steckt in der Familie selbst. *Qwen3.8-Max* ist ein Brocken mit 2,4 Billionen Gesamtparametern und rund 95 Milliarden aktiven, für dessen Betrieb im Maßstab man ein GB300-NVL72-Rack braucht – die Gewichte dazu kamen am 13\. August unter Custom License. Das 27B ist einen Tag später gefolgt, dicht statt MoE, [unter Apache 2.0 auf Hugging Face](https://huggingface.co/Qwen/Qwen3.8-27B?ref=t01.li), und läuft 4-Bit-quantisiert mit rund 17 GB auf einer einzelnen RTX 4090 oder einem 24-GB-Mac. Nicht das Flaggschiff ist die Nachricht, sondern das Modell, das Leute tatsächlich selbst hosten.
Technisch ist es ein natives Vision-Language-Modell mit eigenem Vision-Encoder, das Text, Bild und Video frisst, bei 262.144 Token [Kontext](https://t01.li/glossar/#kontextfenster) nativ und bis zu einer Million per YaRN. Die Architektur verschachtelt schnelle lineare Layer mit vollen Self-Attention-Blöcken.
Ich teste damit gerade ein wenig interdisziplinäres Zeug (Chat, CLI, Agent Pipeline, etc.) und der Lüfter vom MacBook dreht weniger fröhlich frei, als ich zuerst befürchtete. Aktuell läuft das Teil mit 19,4 Tok/Sek. bei aktiviertem Reasoning, damit kann man doch arbeiten.
## Nemotron 3.5 Lightning
Auch bei Nvidia fällt mal wieder Software hinten raus. [*Nemotron 3.5 Lightning*](https://blogs.nvidia.com/blog/nemotron-lightning-switchyard-rtx-dgx/?ref=t01.li) ist ein offenes [Mixture-of-Experts-Modell](https://t01.li/glossar/#moe) mit 31,6 Milliarden Gesamt- und 3,6 Milliarden aktiven Parametern, [hybride Mamba-2-Architektur](https://developer.nvidia.com/blog/nvidia-nemotron-3-5-lightning-delivers-fast-accurate-specialized-task-execution-for-long-running-agents/?ref=t01.li), ein Kontextfenster von einer Million Token, ausgeliefert als BF16 und in nativer NVFP4-Quantisierung unter OpenMDW-1.1-Lizenz. Flankiert wird das Release von NeMo Switchyard, einer quelloffenen Routing-Bibliothek auf Proxy-Ebene, die Anfragen dynamisch zwischen teuren Frontier-Modellen und schlankeren Kandidaten wie Lightning verteilt.
[Artificial Analysis hat nachgemessen](https://x.com/ArtificialAnlys/status/2087163514037408085?ref=t01.li) und kommt im Intelligence Index auf 24 Punkte, gleichauf mit gpt-oss-120b. Das ist hinter *Qwen3.6 35B A3B* (32) und Muse Glimmer (35), knapp hinter [Nvidias eigenem Nemotron 3 Super](https://t01.li/ai-shorts/ai-picks-der-23-kw/#nemotron-3-ultra), das mit 120 Milliarden Parametern fast das Vierfache auf die Waage bringt. Nvidia bestreitet das nicht einmal. Die Rechnung soll über die Geschwindigkeit aufgehen: Eine Aufgabe im [Benchmark](https://t01.li/glossar/#benchmark) erledigt Lightning in rund einer halben Minute, wo *Qwen3.6 35B A3B* etwa dreieinhalb braucht. Bei den Agenten-Tests sieht es besser aus als bei der Rohintelligenz, GDPval-AA v2 springt um 334 Elo-Punkte gegenüber dem Nano-Vorgänger.
Und jetzt die Stelle, an der man genauer hinschauen sollte. Nvidia bewirbt bis zu vierfache Token-Geschwindigkeit gegenüber vergleichbar großen Modellen, bei 10.000 PinchBench-Tasks kommt davon aber nur ein Tempoplus von 30 Prozent an. Der Flaschenhals sitzt in der Orchestrierung, nicht im Modell. Die vielzitierte Zahl, wonach Switchyard die Kosten einer Aufgabe auf ein Drittel gegenüber *Opus 4.8* drückt, stammt nach Nvidias eigener Formulierung aus internen Benchmarks – unabhängig nachgemessen hat das bisher noch niemand (zumindest habe ich nichts gefunden).
Hot Take: Als Baustein in mehrstufigen Agenten-Pipelines ergibt das Sinn. Als Modell, das man einfach so nimmt, eher nicht.
## Grok 4.6
Irgendwie ist mir das immer noch keinen eigenen Artikel wert, auch wenn das Ding aus Elmos Bude mit jeder Version besser im Wettbewerbsvergleich dasteht. Asche über mein Haupt.
SpaceXAI schiebt mit [*Grok 4.6*](https://x.ai/news/grok-4-6?ref=t01.li) ein Update nach, das laut den [Messungen von Artificial Analysis](https://artificialanalysis.ai/models/grok-4-6?ref=t01.li) vor allem bei agentischen Workflows und in Sachen Token-Effizienz punkten will. Im Intelligence Index landet das Modell bei 61 Punkten und zieht damit mit *GPT-5.6 Sol* gleich, knapp hinter *Claude Fable 5* (62) und *Claude Opus 5* (63). Spannender als die Indexmathematik ist die Ausführung: Auf AA-Briefcase, dem Langzeit-Benchmark für Wissensarbeit, braucht Grok 4.6 im Schnitt etwa 53 Turns und 0,5 Milliarden Input-Tokens, während Claude Opus 5 im Max-Modus rund 103 Turns und das Vierfache an Tokens akkumuliert. Bei Aufgaben, die über Stunden laufen, ist das ein Kostenvorteil weit jenseits des Token-Preises.
Die Preisgestaltung bleibt mit 2 $ pro Million Input- und 6 $ pro Million Output-Tokens auf dem Niveau des Vormodells. Zwei Fußnoten hat das aber. Ab 200.000 Prompt-Tokens verdoppeln sich die Sätze auf 4 $ und 12 $, und zwar für die gesamte Anfrage – bei einem 500K-Kontextfenster und agentischen Workloads ist das keine theoretische Grenze. Die Cache-Hits sind zudem von 0,30 $ bei Grok 4.5 auf 0,50 $ gestiegen, und einen Batch-Rabatt gibt es anders als bei *Grok 4.20* nicht mehr.
Verfügbar ist das Modell über die SpaceXAI-API, Cursor, Grok Build sowie Gateways wie OpenRouter, Vercel oder Cloudflare.
- Kontextfenster: 500.000 Tokens (Input: Text/Bild, Output: Text)
- Preise (API): 2,00 $ / 1M Input-Tokens, 6,00 $ / 1M Output-Tokens, Cache-Hits 0,50 $
- Knowledge Cutoff: 1\. Februar 2026
- [Reasoning-Stufen](https://t01.li/glossar/#reasoning-effort): low, medium, high (Default), xhigh
- Benchmarks: 61 Index-Score, GDPval-AA v2 Elo 1753, Terminal-Bench v2.1 88,4 % (AA-Messung, Opus 5 liegt bei 89 %)
Kleiner Dämpfer zu den Benchmarks: SpaceXAI selbst führt in der Release-Tabelle Terminal-Bench v3.0 mit 26 Prozent, wo GPT-5.6 Sol auf 34,6 kommt. Die 88,4 Prozent stammen aus AAs Messung auf der älteren v2.1\. Beide Zahlen stimmen, sie messen nur nicht dasselbe – wer sie nebeneinander stellt, ohne die Version zu nennen, erzählt eine Story, die die Daten nicht hergeben.
## GLM-5.3
Z.ai schiebt mit [*GLM-5.3*](https://z.ai/blog/glm-5.3?ref=t01.li) ein reines Post-Training-Update nach. Das Basismodell bleibt identisch zu Version 5.2, sämtliche Zuwächse stammen aus skaliertem Reinforcement Learning über synthetisierte Umgebungen und das hauseigene Framework slime, dessen Durchsatz bei Long-Horizon-Coding-RL um mehr als das 2,3-Fache gestiegen ist. Bei den Zahlen für [Coding-Agenten](https://t01.li/glossar/#coding-agent) sieht das nach mehr aus als nach Feinschliff: Terminal Bench 3.0 klettert von 4,6 auf 28,3, DeepSWE v1.1 von 46,2 auf 66,9\. Zum Vergleich nennt Z.ai für *GPT-5.6 Sol* 34,6 beziehungsweise 72,7 – der Abstand zur geschlossenen Spitze bleibt also, er wird nur kleiner.
Für Entwickler praktisch relevant: In der API lässt sich das Thinking nicht mehr abschalten. `disabled` fliegt raus, `reasoning_effort` kennt nur noch `low`, `high` und `max`, Default ist `max`. Wer bisher mit abgeschaltetem Thinking gefahren ist und einfach die Model-ID tauscht, bekommt einen Fehler zurück.
Der eigentliche Hammer steckt aber nicht in den Coding-Zahlen. Z.ai schreibt, die Cyber-Fähigkeiten hätten sich beim Hochskalieren des Post-Trainings schneller entwickelt als erwartet – das Modell begann, über mehrere Stufen einer Exploit-Kette hinweg zu planen, statt nur isolierte Schwachstellen zu finden. In Zusammenarbeit mit Sicherheitsteams in China hat es an realen Codebasen 2.436 Schwachstellen über 269 Projekte identifiziert, davon 1.097 mit mittlerem bis hohem Schweregrad, quer durch System-Kernel, Browser-Engines und Netzwerkprotokolle. Die älteste stammt von 1981, im Schnitt lebte eine Lücke 26,6 Jahre unentdeckt. Auf CyberGym landet GLM-5.3 bei 84,5 Prozent und damit vor Claude Mythos 5 (83,8) und GPT-5.6 Sol (83,6).
In Relation zur Größenordnung: Anthropic meldete für [Project Glasswing](https://t01.li/ai-shorts/ai-picks-der-23-kw/#expanding-project-glasswing) über 10.000 gefundene Schwachstellen mit hohem oder kritischem Schweregrad – allerdings über rund 50 Partnerorganisationen hinweg und mit Mythos Preview.
Deshalb kommen die Open Weights nicht sofort, sondern erst rund zwei Wochen nach dem Launch, nach Abschluss von Sicherheitsprüfung und Hardening. Weiter oben in der Exploit-Kette bleibt der Abstand nach wie vor messbar: ExploitBench springt zwar von 24,4 auf 54,4 Prozent, Mythos 5 liegt dort bei 78,0.
Dass ein Anbieter Gewichte aus Sicherheitsgründen zurückhält, kenne ich bisher vor allem als westliche Geste mit Presseanhang. Hier steht eine konkrete Zahl dahinter und ein [öffentliches Disclosure-Ledger](https://cvd.z.ai/?ref=t01.li). Zwei Wochen sind keine Ewigkeit, aber es ist ein anderes Signal als das übliche „wir nehmen Sicherheit ernst“. Nebenbei bemerkt evaluiert Z.ai fast alle diese Benchmarks im Harness von Claude Code 2.1.207\. Man nimmt halt, was funktioniert.
## DeepSeek V4-Pro-0813, neue Preise und eine eigene Harness
DeepSeek entlässt sein Flaggschiff mit dem Build [V4-Pro-0813](https://api-docs.deepseek.com/quick%5Fstart/pricing?ref=t01.li) aus der Testphase und schiebt mit [*DeepSeek Harness*](https://deepseek.com/harness/en/?ref=t01.li) direkt ein modulares [Agenten-Framework](https://t01.li/glossar/#harness) unter MIT-Lizenz hinterher, das per npx über eine lokale Weboberfläche läuft. Modellname, Parameterzahl und das Kontextfenster von einer Million Token bleiben unverändert, bestehende Integrationen laufen ohne Anpassung weiter. Neu sind native Unterstützung der OpenAI-Responses-API mit Codex-Anbindung und dreistufiges Reasoning, für das DeepSeek im Agenten-Alltag die mittlere Stufe empfiehlt.
Bei den Benchmarks zeigt sich die gewohnte Schere zwischen Hersteller und Messstelle. In DeepSeeks eigener Vergleichstabelle steigt Terminal Bench 2.1 von 72,1 auf 87,9 und DeepSWE von 12,8 auf 62,7\. [Artificial Analysis misst auf demselben Benchmark 79 Prozent](https://artificialanalysis.ai/models/deepseek-v4-pro?ref=t01.li) – und exakt dieselben 79 Prozent für das kleinere V4-Flash-0731\. Im Intelligence Index klettert V4-Pro von 45 auf 53 Punkte, zieht damit mit *GLM-5.2* gleich und läuft hinter *Muse Spark* 1.2 (57), *Qwen3.8 Max* (58), *Kimi K3* (60) und *Claude Opus 5* (63) her.
Womit wir bei der Zahl wären, die AA selbst hervorhebt:
> DeepSeek V4 Pro 0813 is only 1 point ahead of DeepSeek V4 Flash 0731 on the Artificial Analysis Intelligence Index, and has \~3.8x the active parameters. The two models tie on Terminal-Bench 2.1 at 79%.
Ein Punkt Vorsprung bei 49 statt 13 Milliarden aktiven Parametern. Wer sein Modell nach Kosten pro erledigter Aufgabe aussucht statt nach Position im Ranking, sollte sich das durchrechnen.
Parallel dreht DeepSeek wie [angekündigt](https://t01.li/ai-shorts/ai-picks-der-32-kw/#pricing-for-deepseek-api) ab dem 16\. August, 16 Uhr UTC, [an der Preisschraube](https://the-decoder.de/deepseek-bringt-verbessertes-v4-pro-modell-erhoeht-die-api-preise-und-macht-seine-agenten-software-open-source/?ref=t01.li) und führt zeitabhängige Tarife ein. Außerhalb der chinesischen Arbeitszeiten kostet die Million Input-Token künftig 0,66 statt 0,435 $, der Output steigt auf 1,98 statt 0,87 $, in den Stoßzeiten zwischen 1 und 4 sowie 6 und 10 Uhr UTC verdoppeln sich diese Werte exakt. Richtig teuer wird es im Unterbau: Die Preise für Cache-Treffer versechsfachen sich im günstigsten Fall von 0,003625 auf 0,022 $, zur Spitzenzeit auf 0,044 $. Der Cache-Rabatt schrumpft damit von etwa einem Hundertzwanzigstel auf ein Dreißigstel des regulären Input-Preises.
Für iterative Agenten-Workflows, die permanent dieselben Code- und Kontext-Dateien einlesen, kassiert DeepSeek damit das bisherige Sparpreis-Narrativ ein. Aus europäischer Sicht ist immerhin ein Trost dabei, dass fast der gesamte Nachmittag in den günstigen Tarif fällt.
Ein Detail noch, das in der Aufregung untergeht: Die Gewichte des neuen Builds hat DeepSeek bislang nicht veröffentlicht. Auf [Hugging Face](https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-0813?ref=t01.li) liegt weiterhin der Preview-Stand vom April.
## MAI-Thinking-1
Microsoft hat sein hauseigenes Reasoning-Modell [MAI-Thinking-1](https://microsoft.ai/news/introducing-mai-thinking-1/?ref=t01.li) in die Public Preview auf Microsoft Foundry gehoben. Vorgestellt wurde es bereits Anfang Juni auf der Build 2026, seither lief es in der Private Preview – neu ist also nicht das Modell, sondern der Zugang.
Technisch setzt Redmond auf eine Sparse-Mixture-of-Experts-Architektur mit rund einer Billion [Gesamtparametern](https://t01.li/glossar/#modell-parameter), von denen pro Token 35 Milliarden aktiv sind. Das Kontextfenster liegt bei 256.000 Tokens, Function Calling wird unterstützt, die Chat-Completions-API ebenfalls. Microsoft betont vor allem die Unabhängigkeit vom bisherigen Partner-Ökosystem: Das Modell wurde ohne Destillation aus Drittanbieter-Modellen trainiert und soll auf kommerziell lizenzierte, nachverfolgbare Datensätze setzen. Für Käufer in regulierten Branchen, die zunehmend nach der Herkunft von Trainingsdaten gefragt werden, ist das sicherlich das Hauptverkaufsargument.
Bei den herstellereigenen Benchmarks meldet Microsoft 97,0 Prozent bei AIME 2025 sowie 94,5 Prozent bei AIME 2026 und sieht das Modell mit rund 53 Prozent bei SWE-Bench Pro auf Augenhöhe mit Claude Opus 4.6\. In internen Blind-Side-by-Side-Evaluierungen über 1.276 Tasks, durchgeführt vom Rating-Partner Surge, soll MAI-Thinking-1 gegenüber *Claude Sonnet 4.6* bevorzugt worden sein – das übliche Blabla, bei [Microsoft immer noch eine Spur selbstverliebter](https://t01.li/ai-shorts/ai-picks-der-23-kw/#microsoft-mai).
Bevor man das jetzt als Frontier-Ansage liest, ein Blick auf den Kalender. *Opus 4.6* war das Vergleichsziel im Juni. Inzwischen ist [*Opus 5*](https://t01.li/ki-news/claude-opus-5-fast-fable-niveau-halber-preis/) seit dem 24\. Juli draußen, und zwischen den beiden liegt noch 4.8\. Wer im August mit Juni-Zahlen gegen ein zwei Generationen altes Modell antritt, hat einen Vergleich gewonnen, den niemand mehr führt.
## Gemini 3.7 Flash
Google lässt nur drei Wochen nach Version 3.6 bereits [Gemini 3.7 Flash](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-3-7-flash/?ref=t01.li) raus und positioniert das Modell primär als Werkzeug für Agenten-Workflows, Coding und Dokumentenanalyse. Bei den Benchmarks legt Google die üblichen Steigerungen vor: DeepSWE v1.1 klettert von 49,0 auf 65,3 Prozent, FrontierCode 1.1 Main von 34,4 auf 43,6, das WebDev-Arena-Ranking von 1.538 auf 1.588 Elo. Auffälliger finde ich die Sprünge, wenn das Modell komplexe Dokumente verarbeitet. GDP.pdf geht von 22,0 auf 34,0 Prozent, AutomationBench von 17,0 auf 30,4\. Das zielt weniger auf schlauere Antworten als auf weniger Retries und präzisere Tool-Calls.
Bemerkenswert ist der Preiskampf über die API. Google halbiert die regulären Preise des Vorgängers bis zum 31\. Dezember 2026 auf 0,75 $ pro Million Input-Token und 3,75 $ für die Ausgabe. Ab dem 1\. Januar 2027 gelten wieder 1,50 beziehungsweise 7,50 $. Wer jetzt eine Pipeline auf diesen Konditionen kalkuliert, sollte die Januar-Zahlen schon mal mit daneben legen, nicht nur die aktuellen.
Wichtiges Einordnungs-Sternchen zum Intelligence Index: Der Wert von 56 Punkten, den Google in der Ankündigung nennt, ist ein von Google zitierter AA-Score. Unabhängig bestätigt sind bislang die [Geschwindigkeitsmessungen mit rund 253 bis 340 Token pro Sekunde](https://artificialanalysis.ai/models/gemini-3-7-flash?ref=t01.li), nicht die Einordnung im Feld.
Übrigens keine Spur am Horizont von einem neuen Gemini-Pro-Modell. Google hat für Gemini 3.5 Pro auch mit dieser Ankündigung kein Datum genannt, obwohl das Modell zuvor als im Partner-Testing befindlich beschrieben wurde.
Und ich habe das Ding (also 3.7 Flash) für diversen Kleinkram getestet: Zusammenfassungen, Generieren von Markdown, Transkribieren und Interpretieren von Audio und Video, bisher aber kein Coding. Die reine Ausgabe im Chat war eher unauffällig, was bei dem von Google avisierten Ziel zu erwarten war. Es gibt ein paar Änderungen bei der Textformatierung im Chat, aber die betreffen genauso 3.6 Flash, was ich nach meinem Anfangsverdacht über einen kurzen Test bestätigt bekommen habe. Auffällig fand ich die Verarbeitung von Video, in Form von Inhaltsanalyse und Transkription von Audio über einen n8n-Workflow. In diesem Fall war 3.7 auch fühlbar schneller als seine unmittelbaren Vorgänger. Antigravity nehme ich mir die Tage mal vor.
## Claude Sonnet 5 Einführungspreis bleibt
Auf X [bestätigt Anthropic](https://x.com/claudeai/status/2086891169217122586?ref=t01.li), dass der Ende Juni eingeführte Preis von 2 $ pro Million Eingabe- und 10 $ pro Million Ausgabe-Tokens für *Sonnet 5* bestehen bleibt. Ursprünglich war das ein Einführungspreis bis zum 31\. August, danach hätte es 3 beziehungsweise 15 $ gekostet. Die Erhöhung ist gestrichen, der Preis gilt dauerhaft. Anthropic bekommt wohl aufgrund des zunehmenden Wettbewerbs Preisdruck.
Wer jetzt aber die Ersparnis gegenüber *Sonnet 4.6* ausrechnet, sollte zwei Dinge dazunehmen. Sonnet 5 bringt einen überarbeiteten [Tokenizer](https://t01.li/glossar/#tokenizer) mit, der denselben Text je nach Inhalt auf das 1,0- bis 1,35-Fache an Tokens abbildet. Dazu kommt der höhere Verbrauch durch das agentischere Arbeitsverhalten, bei maximaler Konfiguration rund 40 Prozent mehr Output-Tokens pro Aufgabe als beim Vorgänger. Artificial Analysis kommt deshalb auf 2,29 $ für eine durchschnittliche Index-Aufgabe mit Sonnet 5, während dieselbe Aufgabe mit *Opus 4.8* bei rund 1,97 $ landet (*Opus 5* fehlt in der Rechnung aktuell noch).
Fazit dazu: Der eingefrorene Listenpreis ist eine gute Nachricht für die Budgetplanung und eine schlechte Grundlage für den Modellvergleich. [Wie schon im Juni](https://t01.li/ai-shorts/ai-picks-der-23-kw/#versteckte-kosten-bei-neuen-ki-modellen-aufgedeckt) gilt: Die Rechnung schreibt der Tokenizer, nicht die Preisliste. Rechnet auf eurer eigenen Last.
## Hetzner experimental open-weight LLM inference API
Habe ich erst die Tage mitbekommen, aber Hetzner betreibt seit Juli einen [experimentellen Inference-API-Endpunkt](https://docs.hetzner.com/general/company-and-policy/experiments/inference/?ref=t01.li) mit OpenAI-kompatibler REST-API, gehostet in Deutschland und Finnland. Gestartet ist das [mit genau einem Modell](https://x.com/Hetzner%5FOnline/status/2087099126760501364?ref=t01.li), inzwischen sind es vier:
| DeepSeek-V4-Flash-0731 | MoE, 304B total / 13B active | 512.000 tokens | Text |
| ------------------------ | ---------------------------- | -------------- | ----------- |
| GLM-5.2-NVFP4 | MoE, 744B total / 40B active | 512.000 tokens | Text |
| Kimi-K2.7-Code | MoE, 1T total, 32B active | 262.144 tokens | Text, Image |
| Qwen/Qwen3.6-35B-A3B-FP8 | MoE, 35B total / 3B active | 262.144 tokens | Text, Image |
Das reißt geschwindigkeitsmäßig keine Bäume aus, läuft bei mir aber prima für eine OpenClaw-Instanz, die darüber *Qwen3.6 35B* bezieht. Dass sie das „experimental“ nennen, kommt nicht von irgendwoher, denn gelegentlich läuft das bei mir in einen Timeout. Wer sich fragt, warum: Hetzners öffentliches GPU-Lineup besteht aus RTX 4000 Ada und RTX PRO 6000 Blackwell, also Workstation-Karten. Damit serviert man keine Frontier-Modelle bei Volllast.
Bleibt der Punkt, der für alle interessant ist, die hier gerade an europäische Datensouveränität denken. Ein Auftragsverarbeitungsvertrag existiert für den Dienst nicht. Hetzner schreibt selbst, dass es keine Backups gibt, keine Zusage zu Leistung und Verfügbarkeit, und dass man das Ding nicht für Produktivumgebungen nutzen soll. Für Prototypen, interne Tools und Coding-Agenten ist das eine feine Sache. Für Kundendaten ist es keine.
Also, wenn ihr das nutzt, erwartet keine Wunder, bleibt fair und hängt einen Fallback dahinter.
## Mistral und europäische KI-Souveränität
Mistral baut ein wenig an und aus. Drei [Kernmaßnahmen](https://mistral.ai/news/regional-inference-open-models-new-compute/?ref=t01.li) für regionale Datenresidenz und europäische KI-Infrastruktur sind angekündigt.
- Mistral Regional Endpoints (Inferenz wahlweise in Europa oder den USA) sind allgemein verfügbar, ergänzt durch ein neues Mistral Priority Tier in der Public Preview, das SLA-gesicherte Betriebszeiten und individuelle Rate-Limits für produktionskritische Workloads bietet.
- Künftig werden auch externe Open-Weights-Modelle direkt in die eigene Plattform und Infrastruktur eingebunden, beginnend mit *GLM-5.2* von Z.ai.
- Mit Partnern wie ASML, Capgemini, Amadeus, CMA CGM und der Caisse des Dépôts bündelt Mistral über mehrjährige Verpflichtungen die Nachfrage nach Rechenkapazität in sogenannten European Compute Units (ECUs), um bis 2030 bis zu 1 Gigawatt europäische Rechenzentrumskapazität für souveräne Inferenz- und Trainings-Workloads aufzubauen.
Man mag das vielleicht als Zeichen von Resignation deuten, dass Mistral fremde Modelle über eigene Infrastruktur anbietet. Ich sehe das eher als breitere strategische Aufstellung. Schließlich kann ich über Google Cloud Platform auch Claude-Modelle beziehen, wenn ich das denn möchte.
Ein Detail für alle, die den Begriff Datenresidenz ernst nehmen müssen: Mistral schreibt selbst, dass begrenzte und abgesicherte Übermittlungen an Sub-Prozessoren außerhalb der gewählten Region stattfinden können. „In-Region“ heißt hier also nicht ausnahmslos in der Region, und wer das seinem Datenschutzbeauftragten erklären muss, sollte das Trust Center gelesen haben, bevor er den Vertrag unterschreibt.
## ALTK-Evolve: Agenten-Gedächtnis ohne Token-Verbrennung
IBM Research nimmt sich mit [ALTK-Evolve](https://huggingface.co/blog/ibm-research/altk-evolve-sldd?ref=t01.li) des typischen Memory-Problems bei ReAct-Code-Agenten an. Statt an fehlendem Domänenwissen scheitern die Dinger bei komplexen Multi-Step-Workflows meist an banalen Ausführungsfehlern, an falsch paginierten APIs oder unpassenden Rückgabewerten. Frameworks wie ACE lassen den Agenten zwar aus bisherigen Durchläufen lernen, stopfen die gesammelten Erkenntnisse dann aber oft unreflektiert und teuer ins Context Window. IBMs Ansatz wählt denselben Grundgedanken, Erkenntnisse zu zählen und zu gewichten statt sie plump zusammenzufassen, optimiert jedoch die Retrieval- und Delivery-Pipeline, um den Token-Ballast zu drücken.
Im hauseigenen Testlauf auf dem AppWorld-Benchmark mit 168 Tasks gegen Basismodelle wie *DeepSeek-V3.2* und gpt-oss-120b will IBM die gleiche Aufgaben- und Szenario-Erfolgsquote wie ACE erzielen, nur eben mit spürbar reduzierter Token-Rechnung. Wie üblich stammen die Vergleichszahlen aus internen Re-Runs. Spannend bleibt der Ansatz für alle, die agentische Workflows bauen und keine Lust haben, ihr API-Budget für redundanten Context zu verbrennen. Die Pipeline aus Extraktion, Konsolidierung und gezieltem Abruf steht als Library und Technical Report auf Hugging Face bereit.
Der Titel des Blogposts fasst die Woche übrigens hervorragend zusammen:
> „Thinking of ACE? We Can Do It with Fewer Tokens.“
## Message your other Claude Code sessions
Ab Claude Code v2.1.224 unterstützt Claude Code [sitzungsübergreifendes Messaging](https://code.claude.com/docs/en/cross-session-messaging?ref=t01.li), vorerst nur unter macOS und Linux. Über die Tools `ListAgents` und `SendMessage` findet Claude andere Sitzungen und schickt ihnen Nachrichten, auf derselben Maschine ebenso wie auf anderen Rechnern oder im Web.
Übertragen wird dabei ausschließlich Text, nie Conversation History und nie Dateien. Wer einen ganzen Kontext verschieben will, muss weiterhin die Session fortsetzen. Interessanter finde ich, dass Claude von sich aus senden darf, etwa nachdem eine Änderung in Sitzung A kaputt macht, woran Sitzung B gerade baut.
## Maximizing the value of your Claude Code sessions
Anthropic erklärt in einer [Anleitung von Lydia Hallie](https://claude.com/blog/maximizing-the-value-of-your-claude-code-sessions?ref=t01.li), was eine Claude-Code-Session eigentlich kostet – und das ist mehr Substanz, als der Titel vermuten lässt.
Die Mechanik dahinter: Output-Tokens kosten etwa das Fünffache von Input-Tokens, weil das Modell sie einzeln nacheinander erzeugt. Cache-Reads liegen bei einem Zehntel des Input-Preises, Cache-Writes bei bis zum Doppelten. Jeder Turn schickt die komplette bisherige Konversation erneut mit, nur das Neue wird zum vollen Preis vorverarbeitet. Was einmal im Kontext liegt, bleibt dort und wird bei jedem weiteren Turn mitgeschleppt.
Daraus folgen ein paar Handgriffe, die man gern vergisst:
- `/clear` zwischen einzelnen Aufgaben, damit alter Kontext nicht mitreist
- Modell und Effort-Level vor dem Start festlegen, denn ein Wechsel mitten im Gespräch wirft den Prompt-Cache weg
- Dateien mit `@` erwähnen statt den Pfad zu tippen – die Datei hängt dann direkt an der Nachricht, der Read-Call entfällt
- Laute Befehle mit Quiet-Flags versehen oder in einen Subagenten auslagern, weil Kommando-Ausgaben genau wie Dateien im Kontext liegen bleiben
- `/context` einmal in einer frischen Session laufen lassen, um zu sehen, was überhaupt geladen ist
- `/compact` vor der Pause, nicht danach – der Cache läuft nach einer Stunde ab, und das Zusammenfassen ist deutlich günstiger, solange er noch steht
Der Kniff, den ich mir merke: Wenn die letzten Turns in die falsche Richtung gelaufen sind, ist `/rewind` billiger als `/compact`. Rewind schneidet nur hinten ab, alles davor bleibt im Cache. Compact schreibt die ganze Konversation neu und kostet deshalb immer etwas.
## ChatGPT – Import from another agent
*ChatGPT-App* und *Codex CLI* haben eine [Importfunktion](https://learn.chatgpt.com/docs/import?ref=t01.li) bekommen. Wer von einem anderen Agenten kommt, muss seine Konfiguration nicht neu aufbauen.
Wichtig ist der Unterschied zwischen den beiden Wegen: Die Desktop-App importiert aus Claude Code, Claude Cowork und Cursor, das *Codex CLI* per `/import` dagegen nur aus Claude Code oder Cursor. Das CLI zieht zudem maximal 50 Chats aus den letzten 30 Tagen, und der Befehl funktioniert weder während einer laufenden Task noch in einer Remote-Session.
Übernommen wird mehr, als ich erwartet hätte: Instruction-Dateien landen in `AGENTS.md`, die `settings.json` wird zur `config.toml`, dazu kommen Skills, Plugins, Projektordner, MCP-Server-Konfiguration, Hooks, Subagenten und die Projekt-Memories aus Claude Code. Slash Commands werden zu Skills umgebaut. Der bestehende Aufbau im Quell-Agenten bleibt unangetastet, und die Desktop-App kann Importiertes auf Wunsch synchron halten.
Bei einem Anbieterwechsel oder allein auch nur, um eine Konfiguration in *Codex* zu bekommen, etwa für eine zweite Meinung, spart das viel Zeit.
Ein Punkt, den OpenAI selbst hervorhebt und den man ernst nehmen sollte: Nach dem Import gehören Tool-Berechtigungen in Skills und Agenten geprüft, ebenso MCP-Server mit eigener Authentifizierung, Headern oder Umgebungsvariablen. Hooks können sich nach der Übernahme anders verhalten. Man importiert eben nicht nur Komfort, sondern auch Rechte.
## ChatGPT desktop app for Linux
Die [ChatGPT-Desktop-App für Linux](https://learn.chatgpt.com/codex/linux/linux-app?ref=t01.li) ist im Preview-Status und läuft auf den Desktop-Varianten von Ubuntu 24.04 LTS und 26.04 LTS, Debian 13 sowie Fedora 43 und 44\. Für jede dieser Distributionen gibt es Pakete für x64 und ARM64, `.deb` für Ubuntu und Debian, `.rpm` für Fedora.
Neben dem Chat bringt das wie bei den anderen Versionen auch *Work* und *Codex* mit.
## Make it readable
Ben Tossell teilt einen [hübschen kleinen Prompting-Kniff](https://www.bensbites.com/p/make-it-readable?ref=t01.li) zur Reduzierung von LLM-Textballast. Um prägnante, gut lesbare Antworten ohne ausschweifende Analogien zu erhalten, empfiehlt er die Kombination der Custom Instructions „Always talk in [ASD-STE100 Simplified Technical English](https://www.asd-ste100.org/?ref=t01.li)“, einem internationalen Standard für technische Dokumentationen, und „Always talk to me like I have ADHD“, was kurze Bulletpoints und klare Header erzwingt.
Für STE gibt es kein standardisiertes deutschsprachiges Äquivalent. Alternativ könnte man den Prompt noch anweisen, das Ergebnis auf Deutsch auszugeben, und dann den Part mit ADHS dahinter hängen.
## Zonen, BIND-Files und DNSSEC: Bunny DNS wandert ins Terminal
Nur so halb themenrelevant, aber es ist eine europäische Bude und das Thema Datensouveränität bewegt uns ja auch. Der Beitrag ist auch schon ein paar Wochen alt, ich bin erst jetzt drauf gestoßen, nachdem ich den Newsletter gelesen hatte: Bunny.net hat im Juli [DNS in sein CLI geholt](https://bunny.net/blog/manage-dns-from-the-terminal-with-bunny-net-cli/?ref=t01.li), nach Database und Edge Scripting der dritte Plattformteil, der im Terminal landet.
Der Funktionsumfang geht über die üblichen CRUD-Operationen hinaus. Zonen und Records lassen sich anlegen, `records export` und `import` schreiben und lesen Standard-BIND-Zonefiles für Migration und Backup, und DNSSEC schaltet ein einzelner Befehl frei, der direkt den DS-Record für den Registrar ausgibt. Interessanter ist Scriptable DNS: Damit beantwortet eigener Code die Anfrage zur Query-Zeit, für Geo-Routing, gewichtete Antworten oder Failover. Dafür gibt es einen eigenen `SCRIPT`\-Record-Typ und ambiente TypeScript-Typen.
Was mich beim Lesen aufhorchen ließ, ist die Begründung. Bunny schreibt sinngemäß, ein dünner API-Wrapper reiche heute nicht mehr, weil im Terminal längst auch Agenten handeln. Entsprechend liefern sie Skill-Files mit, jeder Befehl kennt `--output json`, Prompts erkennen, ob eine TTY dranhängt, und destruktive Operationen verweigern in Pipelines den Dienst, solange kein `--force` gesetzt ist.
Genau so sollte CLI-Design 2026 aussehen. Nicht der Mensch bekommt ein hübsches Interface und der Agent muss die Ausgabe parsen, sondern beide bekommen dasselbe Werkzeug mit zwei Modi. Dass DNS-Hosting bei bis zu 500 Domains ohne Query-Limit kostenlos ist, macht das Ausprobieren zusätzlich schmerzfrei.
Nächste Woche dann vielleicht wieder mehr Pipeline und mehr Blech, schauen wir mal.
### Prompt-Vorlagen zum Kopieren: fünf Bausteine für dein Team
URL: https://t01.li/ki-systemdesign/prompt-vorlagen-zum-kopieren/
Last updated: 2026-08-12T18:08:13.000Z
Teil 1 hat [die Basis-Struktur](https://t01.li/ki-systemdesign/prompting-2026-vergiss-deine-frameworks/) geliefert, Teil 2 [die Modelltyp-Frage](https://t01.li/ki-systemdesign/reasoning-oder-nicht-prompts-nach-modelltyp/) geklärt. Jetzt kommt der Teil, den du am ehesten intern weiterreichst: fünf Prompt-Vorlagen für die Aufgaben, die in jedem Unternehmen ständig anfallen. Kopieren, Platzhalter füllen, loslegen – und bei Bedarf ans eigene Team anpassen.
Vorlagen sind kein Widerspruch zur Framework-Kritik aus Teil 1\. Der Unterschied liegt im Customizing. Ein Akronym verspricht, für alles zu passen; eine Vorlage ist ehrlich auf eine Aufgabenklasse gebaut und darf bei anderen scheitern.
## TL;DR
Fünf Kopiervorlagen für den Arbeitsalltag mit LLMs – jede auf eine Aufgabenklasse zugeschnitten statt auf alles gleichzeitig.
- Extraktion, Klassifikation, Analyse, Recherche und Schreibaufgaben – je eine Vorlage zum Anpassen
- Zwei Querschnittsregeln machen jede davon besser: Instruktionen von Daten trennen, Unsicherheit explizit regeln
- Markdown strukturiert die Anweisung, XML-Tags kapseln die Daten – mehr Syntax-Regelwerk braucht kein Prompt
- Vorlagen gehören ins Team-Wiki und unter Versionskontrolle, nicht in verstreute Chat-Verläufe
## Zwei Regeln, bevor du kopierst
**Instruktionen von Daten trennen.** Der häufigste stille Fehler im Alltag ist der Prompt, in dem Auftrag, Regeln und eingefügter Text ineinanderfließen. Das Modell soll dann raten, wo deine Anweisung endet und das zu verarbeitende Material beginnt. Jede Vorlage hier hat deshalb einen klar abgetrennten Eingabe-Block – bei langen Dokumenten hilft zusätzlich eine simple Markierung wie `…` um den Inhalt.
**Unsicherheit explizit regeln.** Aus Teil 1 bekannt und hier in jeder Vorlage eingebaut: Das Modell bekommt gesagt, was bei Lücken passieren soll. Fehlendes kennzeichnen, Fakten von Schlussfolgerungen trennen, im Zweifel „keine belastbare Aussage möglich“ schreiben. Diese drei Zeilen verhindern mehr [Konfabulationen](https://t01.li/glossar/#halluzination) als jedes Verbot (zu einhundert Prozent verhindern, lassen sie sich aber nicht).
## Markdown für die Anweisung, XML für die Daten
Dir ist vielleicht aufgefallen, dass alle fünf Vorlagen mit Markdown-Überschriften arbeiten. Das ist kein Zufall und keine Deko. Markdown ist für Menschen lesbar, lässt sich im Team-Wiki pflegen, und jedes aktuelle LLM versteht `##`\-Abschnitte als das, was sie sind – Gliederung. Für manuell gepflegte Vorlagen ist Markdown meist die pragmatischste Lösung.
XML-Tags sind das zweite Werkzeug, und sie lösen ein anderes Problem. Sobald Daten in den Prompt wandern – ein Vertrag, drei Quellen, ein Support-Verlauf – braucht das Modell eine eindeutige Grenze zwischen deiner Anweisung und dem Material. [Anthropic empfiehlt Tags dafür ausdrücklich](https://docs.anthropic.com/en/docs/build-with-claude/prompt-engineering/use-xml-tags?ref=t01.li), OpenAI und Google verstehen sie genauso. Wichtig zu wissen: Das muss kein valides XML sein. Die Tags sind Markierungen, keine Schemata – sie brauchen weder Namespace noch Doctype, nur konsistente Namen und ein sauberes Öffnen und Schließen.
So sieht das kombiniert aus, hier als Ausschnitt aus einem Quellenvergleich:
```markdown
## Aufgabe
Vergleiche die beiden Quellen und benenne Widersprüche.
## Quellen
[Text der ersten Quelle]
[Text der zweiten Quelle]
```
Die Faustregel für den Alltag: Markdown strukturiert, was das Modell tun soll, XML kapselt, womit es arbeiten soll. Mehr Regelwerk braucht es nicht – wer anfängt, jede einzelne Anweisung in eigene Tags zu verpacken, baut sich nur das nächste Framework.
## Vorlage 1: Extraktion
Der Klassiker für Non-Reasoning-Modelle – Rechnungen, Mails, Formulare, Verträge. Das Format ist hart definiert, Lücken werden zu `null` statt zu Erfindungen.
```markdown
## Aufgabe
Extrahiere die angegebenen Informationen aus dem Eingabetext.
## Gesuchte Felder
- Name
- Organisation
- Datum
- Betrag
- Handlungsbedarf
## Regeln
- Verwende nur Informationen aus dem Eingabetext
- Ergänze keine fehlenden Angaben
- Verwende null, wenn ein Wert nicht vorhanden ist
- Normalisiere Datumsangaben ins Format YYYY-MM-DD
- Beträge als Dezimalzahl ohne Währungssymbol
## Ausgabeformat
JSON mit exakt den oben genannten Feldern ohne Markdown-Codeblock
## Eingabetext
{{TEXT}}
```
Läuft die Extraktion über eine API, gehört das JSON Schema als eigener Parameter in den Request – der Prompt wünscht sich das Format, das Schema erzwingt es per Structured Outputs (die Details dazu stehen in Teil 2).
## Vorlage 2: Klassifikation
Hier zahlt sich [Few-Shot](https://t01.li/glossar/#few-shot) am deutlichsten aus. Die Beispiele folgen der Regel aus Teil 2 – ein typischer Fall, ein schwieriger, ein Grenzfall.
```markdown
## Aufgabe
Ordne den Eingabetext genau einer Kategorie zu.
## Kategorien
- Rechnung
- technischer Fehler
- Kündigung
- Produktfrage
- Sonstiges
## Entscheidungsregeln
- Bei mehreren Themen wähle das dringlichste Anliegen
- Sonstiges nur, wenn keine andere Kategorie eindeutig passt
- Gib ausschließlich den Kategorienamen aus, keine Erklärung
## Beispiele
Eingabe: „Meine Rechnung enthält eine unbekannte Position.“
Ausgabe: Rechnung
Eingabe: „Ich möchte kündigen, weil meine Rechnung erneut falsch ist.“
Ausgabe: Kündigung
Eingabe: „Welche Zahlungsarten unterstützt das Produkt?“
Ausgabe: Produktfrage
## Eingabe
{{TEXT}}
```
Das zweite Beispiel ist absichtlich mehrdeutig. Genau solche Fälle entscheiden, ob die Klassifikation im Alltag hält oder bei der ersten wütenden Kundenmail kippt.
## Vorlage 3: Analyse und Entscheidung
Die Reasoning-Disziplin. Gewichtete Kriterien, gebundene Evidenz, Prüfauftrag – das Modell bekommt das Problem, nicht den Lösungsweg.
```markdown
## Ziel
[Entscheidung oder Problem, z. B.: Bewerte, ob Produkt A oder B
für ein Unternehmen mit 50 Mitarbeitenden geeigneter ist]
## Ausgangsdaten
Verwende ausschließlich die beigefügten Informationen.
## Bewertungskriterien
- Datenschutz: 40 %
- Funktionsumfang: 30 %
- Integrationsaufwand: 20 %
- Preis: 10 %
## Einschränkungen
- Erfinde keine Produktmerkmale
- Kennzeichne fehlende oder nicht vergleichbare Informationen
- Trenne belegte Tatsachen von Annahmen
- Benenne widersprüchliche Daten offen
## Ergebnis
1. Empfehlung
2. gewichtete Bewertung
3. tragende Gründe
4. Risiken
5. offene Fragen
## Kontrolle
Prüfe abschließend, ob die Empfehlung mit den Gewichtungen
und Ausgangsdaten übereinstimmt.
```
Die Gewichtungen sind der Hebel, den fast niemand nutzt. Sie zwingen vor dem Prompten zu einer Entscheidung darüber, was wirklich zählt – und machen das Ergebnis hinterher überprüfbar.
## Vorlage 4: Recherche
Für alles, was mit Websuche oder Quellenarbeit zu tun hat. Der Quellenstandard ist das Herzstück, inklusive der Regel, Herstellerangaben als solche zu kennzeichnen – regelmäßige Leser dieses Blogs haben möglicherweise gerade eine sanfte Eingebung, warum mir diese wichtig ist.
```markdown
## Forschungsfrage
[Präzise Frage]
## Geltungsbereich
- Zeitraum:
- Region:
- ausgeschlossene Themen:
## Quellenstandard
- Primärquellen bevorzugen
- Veröffentlichungsdatum und Ereignisdatum unterscheiden
- Zentrale Behauptungen mit Quellen belegen
- Widersprüche zwischen Quellen benennen, nicht glätten
- Herstellerangaben getrennt von unabhängigen Messungen kennzeichnen
## Ausgabe
- Kurzfazit
- zentrale Befunde mit Quellenangabe
- Gegenargumente
- offene Punkte
```
Das ist gelebtes [Grounding](https://t01.li/glossar/#grounding): Die Antwort wird an überprüfbare Quellen gebunden, statt aus dem Modellgedächtnis zu schöpfen.
## Vorlage 5: Schreibaufgaben
Kleine Pointe zum Serienende – für Schreib- und Kommunikationsaufgaben lebt der CO-STAR-Gedanke weiter, nur ergänzt um das, was ihm immer gefehlt hat: Evidenz und Ausschlüsse.
```markdown
## Ziel
[Was soll der Text bewirken?]
## Zielgruppe
[Für wen ist der Text bestimmt?]
## Kernaussage
[Die eine zentrale Aussage]
## Evidenz
- [Beispiel, Datenpunkt oder Argument]
- [Beispiel, Datenpunkt oder Argument]
## Ton und Stil
[z. B. sachlich, direkt, nicht werblich]
## Ausschlüsse
- [Formulierungen oder Muster, die nicht vorkommen sollen]
- [Inhalte, die tabu sind]
## Ausgabe
[Länge, Format und Sprache]
```
Der Ausschluss-Block ist der unterschätzte Teil. Wer dort einmal die eigenen Marketing-Unwörter einträgt, spart sich das Rausredigieren in jedem einzelnen Entwurf.
## Und jetzt ins Team damit
Vorlagen entfalten ihren Wert erst, wenn sie nicht in einzelnen Chat-Verläufen versickern. Der pragmatische Weg führt über drei Stufen. Ins Team-Wiki legen (bzw. Slack, Confluence, Teams, oder was auch immer), damit alle dieselbe Ausgangsbasis haben. Anpassungen erlauben und Änderungen sammeln – die Grenzfälle aus dem echten Betrieb machen jede Vorlage besser als jeden Erstentwurf. Und sobald eine Vorlage in einem produktiven Workflow landet, gehört sie [unter Versionskontrolle](https://t01.li/ki-systemdesign/prompt-versionierung-mit-git-und-github/) wie jeder andere Code auch.
Wenn ich mir das Fazit noch herausnehmen darf: Gutes Prompting ist 2026 keine Geheimwissenschaft mehr, sondern saubere Auftragsklärung – Ziel, Material, [Grenzen](https://t01.li/glossar/#constraints), Format, Prüfung. Die fünf Vorlagen hier sind nichts anderes als diese Klärung, einmal pro Aufgabenklasse durchdekliniert. Wer sie ans Team verteilt, verteilt keine Zauberformeln, sondern eine Arbeitsweise. Und das war von Anfang an der Punkt dieser ganzen Serie.
### Beiträge der Serie
- [Prompting 2026: Vergiss deine Frameworks](https://t01.li/ki-systemdesign/prompting-2026-vergiss-deine-frameworks/)
- [Reasoning oder nicht: Prompts nach Modelltyp](https://t01.li/ki-systemdesign/reasoning-oder-nicht-prompts-nach-modelltyp/)
### AI Picks der 32. KW
URL: https://t01.li/ai-shorts/ai-picks-der-32-kw/
Last updated: 2026-09-06T18:04:59.000Z
Das Thema marodierende KI-Modelle lässt uns nicht los und die Geschichte wird immer unterhaltsamer. Irgendwie droht es auch zu einem Statussymbol unter den Labs zu verkommen: „Hier, unser Top-Notch-Modell hat gestern leider mal Firma XY gehackt, sorry – kommt auch nicht wieder vor, versprochen.“ Welchem potenziellen Kundenkreis man sich damit so an den Hals wirft, kann sich wohl jeder ausmalen.
Ansonsten eher Specs und Software diese Woche, weniger Blech. Auf in die Picks der 32\. Kalenderwoche des Jahres 2026:
## Qwen3.8-Max
Das wird gerade auf X.com wie bestes Gras einmal quer durch die Community gereicht: Bei Alibaba ist mit [*Qwen3.8-Max*](https://qwen.ai/blog?id=qwen3.8&ref=t01.li) das bisher größte Modell des Unternehmens hinten rausgefallen. 2,4 Billionen Parameter klingen auf dem Papier nach dem nächsten dicken Ding, entpuppen sich architektonisch aber als [Mixture-of-Experts-System (MoE)](https://t01.li/glossar/#moe). Pro Token sind nur rund 95 Milliarden Parameter aktiv, was die Inferenzkosten im Rahmen halten soll. Neben dem üblichen [Kontextfenster](https://t01.li/glossar/#kontextfenster) von 1 Million Tokens setzt Alibaba [laut eigener Ankündigung](https://x.com/Alibaba%5FQwen/status/2084100707423289643?ref=t01.li) vor allem auf die Ausrichtung als autonomer Agent. In den internen Demos durfte das Modell unter anderem über 16 Tage hinweg eigenständig an einem CLI-Projekt schrauben – Hersteller-Demo, versteht sich, unabhängig nachgestellt hat das noch niemand.
Zwei Details machen den Release trotzdem bemerkenswert. Die API spricht neben dem OpenAI-Format auch das Anthropic-Protokoll, das Modell lässt sich also per Base-URL-Wechsel in *Claude Code*, *Codex* oder *OpenClaw* einhängen. Und: Die Gewichte sollen kommende Woche offen veröffentlicht werden, [als erstes Max-Modell überhaupt](https://t01.li/ki-news/kimi-k3-weights-lizenz-self-hosting/) – zusammen mit einem 27B-Checkpoint für Hardware, die nicht gleich ein ganzes Rechenzentrum belegt.
Bei den Benchmarks hat mittlerweile [Artificial Analysis nachgemessen](https://x.com/ArtificialAnlys/status/2085270415614828675?ref=t01.li).
## Sakana Namazu
Vermutlich und wahrscheinlich werdet ihr dieses Ding nie benötigen (außer ihr fahrt einen nicht unerheblichen Anteil eures Umsatzes im japanischen Markt und mit lokalen Partnern vor Ort), aber den Kontext finde ich ganz unterhaltsam, deshalb landet die Meldung hier: [*Sakana Namazu*](https://sakana.ai/namazu/?ref=t01.li) ist ein auf den japanischen Geschäftskontext spezialisiertes LLM, das auf dem [Open-Weights-Modell](https://t01.li/glossar/#open-weights) *Kimi K2.6* basiert und mit firmeneigenen Daten für lokale Arbeitsabläufe feinabgestimmt wurde. Das Modell integriert [laut Ankündigung](https://x.com/SakanaAILabs/status/2084078649062641773?ref=t01.li) standardmäßig Web-Suche sowie Code-Ausführung direkt in den API-Workflow und nutzt einen OpenAI-kompatiblen API-Endpunkt mit dem Modellnamen `sakana-namazu`. Also das Ding mal eben in eine fast beliebige [Harness](https://t01.li/glossar/#harness) reinstricken sollte entspannt sein.
Preise sind rein verbrauchsabhängig ohne monatliche Grundgebühr: Input 0,95 $ pro Million Token, cached Inputs kosten 0,15 $ und Output liegt bei 4,00 $ pro Million Token. Hinzu kommen tool-spezifische Kosten von 7,00 $ je 1.000 Web-Suche-Aufrufen (inklusive Seiteninhalten) sowie 0,12 $ pro Stunde für persistente Session-Code-Ausführungen. Gegenüber dem Basismodell *Kimi K2.6* behält Namazu laut Sakanas eigener Benchmark-Grafik die Leistungen bei AIME26 oder MMLU-Pro bei – eine Drittmessung existiert nicht.
Ein Haken für alle, die jetzt neugierig geworden sind: In der EU, in Großbritannien und der Schweiz ist Namazu offiziell nicht verfügbar. Die DSGVO-Compliance ist laut Sakana in Arbeit, bis dahin bleibt der Endpunkt für uns zu.
Wenn ihr schon immer mal einen extrem höflichen Chat-Bot wolltet: Bald ist die Chance da.
## Muse Code und Muse Spark 1.2
Meta so: Terminal Coding Agent bzw. Agent Harness – können wir auch. Also haben sie [*Muse Code* veröffentlicht](https://research.meta.ai/blog/introducing-muse-code-and-muse-spark-1-2?ref=t01.li) (aktuell noch Beta).
Und womit läuft das so? [Der Quickstart](https://dev.meta.ai/docs/quickstart/?ref=t01.li) klärt auf:
> Muse Code is a fast and accessible coding agent powered by Muse Spark.
*Muse Spark* haben sie dazu [gleich auf Version 1.2 aktualisiert](https://x.com/AIatMeta/status/2085084709277565213?ref=t01.li) und Artificial Analysis hat auch direkt [drüber geguckt](https://x.com/ArtificialAnlys/status/2085116732231028882?ref=t01.li).
Interessant auch die [Tier-Modelle](https://dev.meta.ai/docs/pricing-rate-limits?ref=t01.li): Neben dem Standard-Tarif gibt es einen „Contributor“-Tarif für ein Zehntel des Preises – im Tausch trainiert Meta dann auf euren Prompts und Completions. Datenhunger als Rabattmodell, das überrascht mich jetzt ehrlich gesagt bei Meta nur geringfügig bis gar nicht.
*Muse Spark 1.2* ist direkt ab Start in Europa nutzbar und man darf bei Meta seine Kreditkarte hinterlegen. Das habe ich auch mal getan, da ich ja eine Schwäche für CLIs habe und mir [*Muse Code*](https://developer.meta.com/ai/products/muse-code/?ref=t01.li) zumindest mal ansehen wollte. Sagen wir mal so: Falls ihr mit *Claude Code* arbeitet, wird euch *Muse Code* nicht groß überraschen, was Commands, Struktur etc. angeht.

Muse Code CLI
Ein paar weitere Auffälligkeiten:
- Es gibt noch keinen direkten Befehl für [MCP](https://t01.li/glossar/#mcp). Wenn ich Muse danach frage, bietet es mir an, einen MCP samt Konfiguration anzulegen (getestet mit [Chrome Dev Tools](https://github.com/ChromeDevTools/chrome-devtools-mcp?ref=t01.li)). Das ist aktuell eher unpraktisch, da alles extern via Packages installiert werden will und die Sandbox den direkten Aufruf blockiert. Aber: Die Sandbox funktioniert immerhin.
- YOLO Mode ist da, habe ich aufgrund des Beta-Status aber mal sein lassen.
- Plan Mode ebenfalls vorhanden und tut anscheinend, was er soll.
- Generell habe ich dafür plus einen kleinen Frontend-Test (statische HTML-Seite mit Tailwind-4-Integration samt Lite- und Dark-Mode) insgesamt 1,77 Euro für Spark 1.2 mit Medium Effort rausgeballert.
- *Muse Spark* hat noch weniger Persönlichkeit als ein durchschnittlicher Sparkassen-Geldautomat (das kann man gut oder schlecht finden).
Ich sage es mal so: Wenn man *Codex* oder Claude Code CLI gewohnt ist, wirkt das aktuell eher wie ein Rückschritt – eben weil Dinge (noch) fehlen. Das ließe sich jedoch durch den Beta-Status begründen. Also abwarten, was da noch kommt.
## OpenAI-Modelle brechen bei Cyber-Evaluierungen aus Testumgebungen aus
Es kann mir niemand erzählen, dass OpenAI das nicht gern als kostenlose PR mitnimmt, und darauf wartet, dass die [Nachrichtendienste bei ihnen mal wieder durchrufen](https://t01.li/ai-shorts/ai-picks-der-30-kw/#openai-modell-bricht-aus-sandbox-aus). Bei [Sicherheitsprüfungen durch externe Partner](https://openai.com/index/third-party-cyber-evaluations-involving-openai-models/?ref=t01.li) wie dem britischen AI Security Institute ([UK AISI](https://www.aisi.gov.uk/?ref=t01.li)) und der Sicherheitsfirma Irregular sind OpenAI-Modelle über die vorgegebenen Grenzen der Testumgebungen hinaus im öffentlichen Internet aktiv geworden. Die Vorfälle passierten unter gezielt abgeschwächten Sicherheitskonfigurationen (z. B. deaktivierten Cyber-Klassifikatoren) und teilweise durch Fehlkonfigurationen in den Testumgebungen. Im Fall des UK AISI nutzte das Modell [*GPT-5.6 Sol*](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) unter anderem ein GitHub-Token, das der Agent eines anderen Labs öffentlich hatte liegen lassen (die Details werden immer besser), umging Account-Recovery- und Rate-Limits und machte einen lokalen DNS-Server über einen Tunneldienst im Internet erreichbar. Bei Irregular führte eine versehentlich bestehende Internetverbindung dazu, dass ein Modell eine reale Website mit einer fiktiven Zieladresse verwechselte und eine dortige Sicherheitslücke ausnutzte.
Genau: „versehentlich“ und „Fehlkonfigurationen in den Testumgebungen“ – man fragt sich, was die Leute da so beruflich machen. Als „frontier security lab“ (steht bei denen so auf der About-Seite) ist „versehentlich“ ein ganz schwieriges Verkaufsargument.
Und lustigerweise [springt jetzt Meta auch mit auf den Zug auf](https://www.reuters.com/technology/metas-ai-model-hacked-another-company-during-testing-information-reports-2026-08-05/?ref=t01.li) – ausgerechnet mit *Muse Spark*, siehe oben.
Achso, und [na klar](https://arstechnica.com/security/2026/08/anthropics-ai-used-fake-identities-malware-in-rogue-attack-on-github-project/?ref=t01.li):
> … the most serious case arising when Anthropic's Mythos 5 model attempted to insert malicious code into an open source software application and created fake identities to deceive the human developers maintaining the project.
Die Randnotiz macht es rund: Von den 19 Vorfällen, die das UK AISI in seiner Testreihe zählte, gingen 2 auf *GPT-5.6 Sol* und 17 auf Anthropics *Mythos 5 zurück*. Da zeichnet sich ein Trend am Horizont ab. Aber irgendwie höre ich von den brandgefährlichen Open-Weights-LLMs aus China nichts dergleichen.
## Introducing Shieldstral
[*Shieldstral*](https://mistral.ai/news/shieldstral/?ref=t01.li) ist ein multimodales Open-Weights-Modell (Apache 2.0) zur Inhaltsmoderation von Mistral (das erklärt auch den Namen). 3 Milliarden Parameter klein und darauf ausgelegt, Moderationsregeln dynamisch zur Inferenzzeit auszuwerten. Statt fester Trainingskategorien wie bei klassischen [Guardrail-Modellen](https://t01.li/glossar/#guardrails) prüft Shieldstral Texte, Bilder oder Multimodal-Inputs anhand von in natürlicher Sprache formulierten Ja/Nein-Fragen und Kontextanweisungen. Als Ausgabe liefert die API einen kontinuierlichen Sicherheitswert über ein einzelnes Token. Und bei der Größe (eine einzelne 16-GB-GPU reicht) läuft das Ding quasi auf dem Bürotoaster. [Die Gewichte liegen auf Hugging Face](https://huggingface.co/mistralai/Shieldstral-1.0-3B?ref=t01.li).
Ich habe dafür derzeit keinen Anwendungsfall, aber kennen ist besser als suchen, oder so.
## @cloudflare/computer
Cloudflare (der Name fällt heute noch häufiger) hat mit [*@cloudflare/computer*](https://blog.cloudflare.com/de-de/cloudflare-computer/?ref=t01.li) eine Open-Source-Bibliothek für Agent-Runtimes als Early Preview vorgestellt. Statt jeden Agent starr in einen eigenen Container zu sperren – was bei skalierten Setups schnell an Grenzen bei der Rechenkapazität stößt –, setzt das Paket auf eine hybride Architektur aus V8-Isolates und Container-Sandboxes. Das Agent-Harness läuft dabei als Durable Object im Isolate. Ein SQLite-basiertes virtuelles Dateisystem bildet den gemeinsamen Workspace, der Container bindet es per FUSE-Mount ein und synchronisiert Änderungen zurück. Das soll dem Modell erlauben, einfache Dateimanipulationen flott und kostengünstig im Isolate abzuwickeln und einen schwereren Linux-Container nur dann zuzuschalten, wenn beispielsweise native Binärdateien oder Paketmanager benötigt werden.
## Cloudflare OS
Cloudflare hat seinen internen KI-Agenten-Workspace [als Open Source unter Apache 2.0 veröffentlicht](https://github.com/cloudflare/cloudflare-os?ref=t01.li) – nach eigener Aussage seit Mai firmenweit im Einsatz. [Das Ganze](https://os.cloudflare.app/?ref=t01.li) dient als isolierte Umgebung zur Erstellung und Ausführung von KI-Agenten und kleinen internen Apps, die sich mit eigenen Access Controls teilen lassen. Sie nehmen dabei auch gerne den aktuellen Hype mit, alles „AI OS“ zu nennen, was nicht bei drei auf dem Baum ist.
## Cloudflare Wallets
[Diese Entwicklung](https://blog.cloudflare.com/wallets/?ref=t01.li) war dermaßen absehbar, aber anders, als man erst vielleicht denkt: Cloudflare baut mit *Cloudflare Wallets* eine programmierbare Geldbörse für Agenten: Stablecoin-Zahlungen über das x402-Protokoll, das Micropayments direkt an HTTP-Requests hängt. Die Idee dahinter ist simpel – Agenten scheitern heute an Signup-Formularen, Zahlungsmethoden und API-Key-Gefrickel, das für Menschen gebaut wurde, und kicken die Aufgabe dann zurück an den Nutzer. Künftig soll der Agent eine API einfach ausprobieren und die paar Cent dafür selbst bezahlen.
Das Konstrukt besteht aus zwei Ebenen. Das Account Wallet gehört dem Menschen, der Geld einzahlt und Regeln setzt. Darunter hängen Virtual Wallets für die Agenten, mit Guardrails wie Budget-Limits, Allow-Lists und maximaler Transaktionsgröße – der Agent darf also mit 10 Dollar Spielgeld Dutzende APIs testen, ohne dass jemand aus der Buchhaltung nachts schweißgebadet aufwacht. Obendrauf kommt eine Identitätsschicht: Über cloudflare.pay-Handles können sich Agenten optional als Delegierte eines Accounts ausweisen, damit Seller wissen, wessen Bot da gerade einkauft. Zusammen mit dem kürzlich vorgestellten Monetization Gateway ergibt das die Verkäufer- und die Käuferseite eines Marktplatzes, auf dem Maschinen mit Maschinen handeln.
## anydoc
Firecrawl liefert mit [*anydoc*](https://github.com/firecrawl/anydoc?ref=t01.li) eine Open-Source-Bibliothek (MIT), die 14 Dokumentenformate – von Word über PowerPoint und Excel bis zu RTF, EPUB und PDF – in sauberes, GitHub-Flavored Markdown konvertiert. Der Clou steckt in dem, was fehlt: kein VLM, kein OCR-Modell, keine Cloud-API. Das Ganze ist pures Rust, parst jedes Format in ein gemeinsames Dokumentenmodell und rendert daraus einheitliches Markdown – mit einer medianen Konvertierungszeit unter 5 ms pro Dokument. Das Format wird dabei aus den Datei-Bytes erkannt, nicht aus der Endung, falsch benannte Dateien laufen also trotzdem durch. Bindings gibt es für Node.js, Python und den Browser (WASM), dazu ein fertiges Agent Skill für Claude Code und Co.
Die Grenze ist klar gezogen: Bei PDFs wird nur der Text-Layer verarbeitet. Gescannte Dokumente brauchen OCR, und das gibt es ausschließlich über Firecrawls gehostete Parse-API obendrauf – da schließt sich dann der kommerzielle Kreis. Das Konzept ist im [RAG](https://t01.li/glossar/#rag)\-Umfeld keineswegs revolutionär, bündelt aber die typischerweise zusammengefrickelte Dokumenten-Pipeline in ein einzelnes Tool, das lokal läuft und keine API-Keys sehen will.
- Eingabeformate: DOC, DOCX, PPT, PPTX, XLS, XLSX, ODT, ODS, ODP, RTF, EPUB, CSV, PDF (Text-Layer)
- Ausgabe: Clean Markdown
## Agent Plugins
Vercel als primärer Initiator nebst Amazon, Cursor, GitHub, OpenAI und Microsoft haben [eine offene Spezifikation vorgelegt](https://vercel.com/blog/introducing-agent-plugins?ref=t01.li), die das Verpacken von Agent-Erweiterungen standardisieren soll. Ein Agent Plugin ist dabei schlicht ein Verzeichnis mit einer `plugin.json` als Manifest, optional einem `skills/`\-Ordner für Agent Skills und einer `mcp.json` für MCP-Server-Konfigurationen. Wer heute ein Skill samt zugehörigem MCP-Server für mehrere Clients ausliefert, baut das Paket derzeit für jeden Client neu – genau dieses Glue-Format-Gefrickel soll die Spezifikation ersetzen. Zum Start unterstützen [unter anderem *ChatGPT*, *Codex*, *Cursor*, GitHub *Copilot* und *VS Code*](https://agent-plugins.org/compatible-clients?ref=t01.li) das Format.
[Die Spezifikation](https://agent-plugins.org/?ref=t01.li) ist bewusst schmal gehalten: v1.0.0 definiert Paketstruktur und Discovery innerhalb des Verzeichnisses, aber kein Berechtigungsmodell, kein Sandboxing und keine Signaturprüfung – das steht [alles offen in den Future Considerations](https://github.com/agentplugins/agent-plugins-spec?ref=t01.li). Auffällig ist, wer in der Liste fehlt: Anthropic. Claude Code fährt weiterhin sein eigenes Plugin-Format. Ob sich hier ein breiter Industriestandard etabliert oder am Ende zwei Lager nebeneinander existieren, entscheidet die Adaption – die technische Basis ist zumindest pragmatisch und ohne unnötigen Ballast aufgesetzt.
## Pricing for DeepSeek API
Kam am 6\. August per Mail, mittlerweile steht die Notice auch [offiziell in der Pricing-Doku](https://api-docs.deepseek.com/quick%5Fstart/pricing/?ref=t01.li):
> Dear DeepSeek API user,
> We plan to raise the overall pricing for DeepSeek API services in the near future, with a significant increase expected. Please plan your usage accordingly. The specific pricing plan will be subject to official notice. Please keep an eye on the Open Platform announcements and check your email for further details.
> If you continue to use our services after the billing adjustment, you will be deemed to have accepted the adjusted billing terms. If you do not agree, you may choose to cancel your service and apply for a refund. Should you have any questions or require further information, please do not hesitate to contact us.
> Thank you for your support and understanding!
Dann hat sich das leider auch erledigt und ich muss mir etwas anderes für meinen kleinen *OpenClaw* suchen.
Fin. Das war's für diese Woche.
### Reasoning oder nicht: Prompts nach Modelltyp
URL: https://t01.li/ki-systemdesign/reasoning-oder-nicht-prompts-nach-modelltyp/
Last updated: 2026-08-12T18:07:46.000Z
In [Teil 1](https://t01.li/ki-systemdesign/prompting-2026-vergiss-deine-frameworks/) ging es darum, warum Akronym-Frameworks ausgedient haben und welche Basis-Struktur sie ersetzt. Die funktioniert modellübergreifend – aber sobald du regelmäßig mit LLMs arbeitest oder Workflows baust, lohnt der Blick eine Ebene tiefer. Denn unter der Haube gibt es zwei Arbeitsweisen, und die reagieren auf denselben Prompt unterschiedlich.
Die Unterscheidung klingt akademischer, als sie ist. Wer einem [Reasoning-Modell](https://t01.li/glossar/#reasoning-modell) Prompts aus der GPT-3.5-Ära vorsetzt, bezahlt für Denkarbeit, die er gleichzeitig sabotiert. Wer umgekehrt ein Non-Reasoning-Modell wie einen Denker behandelt, bekommt selbstbewusst formulierte Abkürzungen. Beides kostet – einmal Geld und Latenz, einmal Qualität.
## TL;DR
Reasoning- und Non-Reasoning-Modelle brauchen unterschiedliche Prompts – wer beide gleich behandelt, verschenkt Qualität oder zahlt drauf.
- Reasoning-Modelle wollen Ziel, Evidenz, Kriterien und Prüfauftrag – keine vorgekauten Denkschritte
- Non-Reasoning-Modelle wollen enge Aufgaben, klare Prozessschritte und gute Beispiele
- Few-Shot bleibt für Non-Reasoning-Modelle das stärkste Werkzeug, kann Reasoning-Modelle aber auf falsche Lösungswege fixieren
- Von den bekannten Reasoning-Verfahren bleibt im Alltag weniger übrig, als LinkedIn behauptet
## Zwei Arbeitsweisen, ein Chatfenster
Reasoning-Modelle erzeugen interne Rechenschritte, bevor sie antworten – sie planen, verwerfen, prüfen, und erst dann kommt Text. Non-Reasoning-Modelle antworten direkt. Das macht sie nicht dümmer, sondern schneller und billiger, und für einen großen Teil der Alltagsaufgaben ist das die passende Eigenschaft. Extraktion, Klassifikation, Umformulieren, formatgebundene Ausgaben, Hochdurchsatz-Jobs in Pipelines – dafür braucht niemand ein Modell, das erst drei Absätze lang mit sich selbst ringt.
Im Chatfenster nimmt dir die Entscheidung inzwischen oft ein Router ab, der je nach Frage zwischen den Modi wechselt. Verlassen würde ich mich darauf nicht. Spätestens in der API, in eigenen [LLM-Pipelines](https://t01.li/glossar/#llm-pipeline) oder Workflows (z. B. in n8n) oder beim Modell-Dropdown wählst du selbst, und dann hilft eine simple Heuristik: Je mehr Abwägung, Abhängigkeiten und Unsicherheit in der Aufgabe stecken, desto eher lohnt Reasoning. Eine Architekturentscheidung, ein kniffliges Debugging, eine Forschungssynthese sind Reasoning-Fälle. Eine Rechnung klassifizieren ist keiner. Warum mehr Denktiefe kein Qualitätsregler ist und wann sie nur Geld verbrennt, [habe ich hier ausführlich auseinandergenommen](https://t01.li/ki-systemdesign/reasoning-ist-kein-qualitaetsmodus/).
## Was Reasoning-Modelle stark macht
Der Prompt für ein Reasoning-Modell definiert das Problem, nicht den Lösungsweg. Vier Zutaten haben sich bewährt.
### Ein messbares Erfolgskriterium
„Analysiere diese Strategie“ lässt offen, woran ein gutes Ergebnis erkennbar wäre. „Bewerte die Strategie nach Umsetzbarkeit, Kosten und Risiken, empfiehl eine Option und benenne die größten Unsicherheiten“ gibt dem Modell einen Maßstab, gegen den es seine eigene Arbeit prüfen kann.
### Gebundene Evidenz
Nur die mitgelieferten Quellen verwenden, Fakten von Schlussfolgerungen trennen, fehlende Evidenz kennzeichnen. Das schränkt den Lösungsraum ein – und genau davon lebt [Grounding](https://t01.li/glossar/#grounding).
### Gewichtete Kriterien
„Welche Lösung ist besser?“ lädt zum Münzwurf ein. „Gewichte Datenschutz mit 35 %, Wartbarkeit mit 25 %, Kosten mit 20 %“ zwingt zu einer nachvollziehbaren Abwägung, die sich hinterher auch gegen die Gewichtung kontrollieren lässt.
### Verifikation statt Selbstkritik
„Reflektiere tief über deine Antwort“ produziert vor allem überzeugender klingende Antworten. „Prüfe jede Tatsachenbehauptung gegen die angegebenen Quellen“ oder „führe die vorhandenen Tests aus und nenne die Fehlschläge“ produziert Kontrolle. Eine konkrete Prüfhandlung schlägt jede allgemeine Sorgfalts-Beschwörung – und wo es um produktive Pipelines geht, gehört die Prüfung ohnehin [aus dem Prompt heraus in ein QA-Gate](https://t01.li/ki-systemdesign/qa-gates-llm-output-sicherung/).
Was denselben Modellen schadet, ist das Spiegelbild davon. Starre Denkpfade („bearbeite das exakt in diesen 14 Schritten“) legen das Modell auf einen Weg fest, der zur Aufgabe nicht passen muss. Die 70-Seiten-Materialschlacht, in der Regeln, Daten und Auftrag irgendwo verstreut liegen, verdrängt im [Kontextfenster](https://t01.li/glossar/#kontextfenster) genau die Information, auf die es ankommt. Und Negativregel-Kaskaden („nicht werblich, nicht zu lang, nicht zu technisch, nicht langweilig …“) beschreiben alles außer dem gewünschten Verhalten. Eine positive Stilvorgabe plus zwei, drei harte Verbote leisten mehr als zehn weiche.
## Was Non-Reasoning-Modelle stark macht
Hier dreht sich das Bild. Ohne eingebaute Denkschleife braucht das Modell mehr Führung – und belohnt diese zuverlässig.
Die Aufgabe muss eng geschnitten sein, ein Auftrag pro Prompt. „Fasse zusammen, analysiere kritisch, übersetze und mach noch Social-Media-Posts draus“ scheitert nicht an der Modellqualität, sondern daran, dass Priorität und Format nirgends definiert sind. Komplexe Jobs werden zerlegt: erst extrahieren, dann strukturieren, dann formulieren, dann prüfen – als Pipeline mit vier kleinen Prompts statt einem Monster. Klare operative Verben helfen zusätzlich. „Extrahiere“, „klassifiziere“, „konvertiere“ sind Arbeitsanweisungen; „beleuchte“, „sei kreativ“ und „mach was Professionelles draus“ sind Hoffnungen.
Das Ausgabeformat gehört exakt definiert, im Zweifel als Schema. Wo die Schnittstelle [Structured Outputs](https://t01.li/glossar/#structured-output) oder JSON-Schema anbietet, ist das dem rein sprachlichen Format-Erzwingen vorzuziehen – der Prompt wünscht sich ein Format, das Schema erzwingt es. Welches Datenformat sich für welche Aufgabe eignet, [steht hier im Detail](https://t01.li/ki-systemdesign/llm-datenformate-json-yaml-xml-toon-html-im-vergleich/).
## Few-Shot: das unterschätzte Arbeitstier
[Few-Shot-Beispiele](https://t01.li/glossar/#few-shot) sind für Non-Reasoning-Modelle das wirksamste einzelne Werkzeug – und gleichzeitig das am schlechtesten gepflegte. Sie lohnen sich, wenn Kategorien schwer abgrenzbar sind, ein Format ungewöhnlich ist, ein Stil getroffen werden muss oder interne Unternehmenslogik im Spiel ist. Die Auswahl folgt einer einfachen Regel, die kaum jemand anwendet: ein typischer Fall, ein schwieriger Fall, ein Grenzfall, optional ein Negativbeispiel. Drei unterschiedliche Beispiele schlagen zehn fast identische.
Der Haken steckt hier im Kleingedruckten. Das Modell übernimmt aus Beispielen nicht nur die Lösung, sondern auch Ton, Struktur, Annahmen – und Fehler. Ein schlechtes Beispiel ist deshalb schädlicher als gar keins. Bei Reasoning-Modellen kommt ein zweiter Effekt dazu, den OpenAI in den eigenen [Best Practices](https://developers.openai.com/api/docs/guides/reasoning-best-practices?ref=t01.li) benennt: Erst [Zero-Shot](https://t01.li/glossar/#zero-shot) probieren, Beispiele nur bei Bedarf nachlegen, denn unpassende Demonstrationen können das Modell auf einen Lösungsweg fixieren, den es allein besser gewählt hätte.
## Die Verfahren aus den Papern – ein Reality-Check
Chain-of-Thought, Self-Consistency, Least-to-Most, Plan-and-Solve, Tree of Thoughts, ReAct – die Verfahrensliste liest sich beeindruckend und wird auf LinkedIn gern als Geheimarsenal verkauft. Für den Alltag Mitte 2026 schrumpft sie zusammen.
Chain-of-Thought ([Wei et al. 2022](https://arxiv.org/abs/2201.11903?ref=t01.li)) steckt in Reasoning-Modellen nativ drin; die explizite Aufforderung hat, wie in Teil 1 gezeigt, dort ausgedient. Für Non-Reasoning-Modelle bleibt sie bei Mathe- und Logikaufgaben ein legitimes Werkzeug. [Self-Consistency](https://t01.li/glossar/#self-consistency) ([Wang et al. 2022](https://arxiv.org/abs/2203.11171?ref=t01.li)) – mehrere unabhängige Lösungswege erzeugen, Mehrheitsentscheid nehmen – funktioniert nachweislich, aber nur bei Aufgaben mit eindeutiger Antwort und zum Preis mehrfacher Modellaufrufe. Für offene Schreibaufgaben taugt das Verfahren nicht, und sinnvoll umgesetzt ist es ein technischer Ablauf mit getrennten Aufrufen, kein „denk fünfmal nach“-Prompt. Least-to-Most und Plan-and-Solve sind im Kern Problemzerlegung mit Plan – nützlich, solange der Plan anpassbar bleibt und nicht als unverrückbares 25-Punkte-Korsett daherkommt.
Tree of Thoughts und ReAct schließlich sind ehrlicherweise keine Prompt-Techniken mehr. Ein echter Suchbaum braucht externe Zustandsverwaltung und Bewertung, ReAct braucht echte Tools samt Berechtigungs- und Abbruchlogik. Das ist Orchestrierung, also Software-Architektur – wer das in ein einzelnes Prompt-Textfeld tippt, spielt die Verfahren nur nach. Als Faustregel für die Praxis reicht: Zerlegung und Verifikation gehören in den Prompt, alles mit Schleifen, Zuständen und Werkzeugen gehört in den Code.
## Kurz verdichtet
Für Reasoning-Modelle: Ziel, Evidenz, gewichtete Kriterien, Prüfauftrag – und dem Modell den Weg selbst überlassen. Für Non-Reasoning-Modelle: enge Aufgabe, klare Schritte, drei gute Beispiele, hartes Format. Für beide gilt, dass widersprüchliche Regeln und irrelevanter Langkontext mehr kaputtmachen als jeder fehlende Trick. Und produktive Prompts gehören [versioniert und getestet](https://t01.li/ki-systemdesign/prompt-versionierung-mit-git-und-github/), sonst bleibt jede Optimierung irgendwas zwischen Quiz und Anekdote.
Ganz heißer Take zum Schluss: Die Modelltyp-Frage ist die neue „Welches Keyword nehme ich“-Frage – alle reden über die Feinheiten, die meisten scheitern eine Etage tiefer, nämlich an der unklaren Aufgabe. Erst die Aufgabe sauber schneiden, dann den Modelltyp wählen, dann feilen. Im dritten Teil gibt es das Ganze zum Anfassen – fertige Vorlagen für Extraktion, Klassifikation, Analyse, Recherche und Schreibaufgaben, für Copy & Paste zum direkten Ausprobieren.
### Beiträge der Serie
- [Prompting 2026: Vergiss deine Frameworks](https://t01.li/ki-systemdesign/prompting-2026-vergiss-deine-frameworks/)
- [Prompt-Vorlagen zum Kopieren: fünf Bausteine für dein Team](https://t01.li/ki-systemdesign/prompt-vorlagen-zum-kopieren/)
### AI Picks der 31. KW
URL: https://t01.li/ai-shorts/ai-picks-der-31-kw/
Last updated: 2026-09-06T18:05:53.000Z
Man hätte zu der [OpenAI-hackt-Hugging-Face-Nummer](https://t01.li/ai-shorts/ai-picks-der-30-kw/#openai-modell-bricht-aus-sandbox-aus) diese Woche noch so viel mehr schreiben können. Die Presse hat richtig weit ausgeholt und dabei teilweise auch richtig viel Blödsinn erzählt, weil sie es A. nicht verstanden hat und B. vermutlich auch nicht vernünftig recherchieren wollte (oder schlicht nicht nachgelesen hat). Egal, die Sau wurde jetzt lange genug durchs Dorf getrieben.
Diese Woche also wieder mehr Software, weniger Blech und weniger Modelle, bis auf ein paar Ausnahmen. Wobei sich zwischen den Meldungen zwei Linien abzeichnen, die ich vorher nicht auf dem Zettel hatte: Wer sich gerade wo für offene Modelle einträgt, und was der ganze generierte Kram eigentlich in den Firmen anrichtet.
Frisch ausgeschwitzt, die Picks der wortwörtlich heißen 31\. Kalenderwoche des Jahres 2026.
## MAI-Cyber-1-Flash
Microsoft hat mit [*MAI-Cyber-1-Flash*](https://microsoft.ai/news/introducing-mai-cyber-1-flash-inside-mdash/?ref=t01.li) jetzt auch ein spezialisiertes Sicherheitsmodell am Start, das direkt in MDASH wandert – das hauseigene Multi-Agenten-[Harness](https://t01.li/glossar/#harness) zum Finden und Patchen von Schwachstellen. Das Modell stammt aus der intern entwickelten *MAI-Thinking-1*\-Linie und ist auf Lücken in großen, unübersichtlichen Codebasen ausgelegt.
Der eigentliche Trick ist die Arbeitsteilung. *MAI-Cyber-1-Flash* soll nach Herstellerangaben bis zu 90 Prozent aller Aufgaben allein erledigen, nur die harten 10 Prozent gehen an *GPT-5.4* weiter. Auf CyberGym landet die Kombination bei 95,95 Prozent und damit zwölf Punkte über *Mythos*. Die vielzitierte Halbierung der Kosten bezieht sich übrigens nicht auf Infrastruktur allgemein, sondern auf den Vergleich mit Microsofts bisher bestem MDASH-Stack aus *GPT-5.4*, *5.4 mini* und *5.3 codex*.
Beim Benchmark lohnt ein zweiter Blick. Microsoft stellt dort das komplette MDASH-System mit über hundert Agenten gegen nackte Einzelmodelle wie *Mythos*, Gemini und GPT. Die zwölf Punkte Vorsprung messen also zu einem erheblichen Teil das Harness und nicht das Modell – ein Vergleich, den man so aufstellen kann, wenn man das Ergebnis schon kennt.
Unter dem Strich bleibt eine betriebswirtschaftliche Optimierung der eigenen Architektur, hübsch verpackt als Sicherheitsdurchbruch. Teure Allround-Modelle für standardisierbare Quellcode-Analysen zu verheizen, war schon immer Unsinn, und ein vorgeschaltetes kompakteres System behebt genau das. Wie sich Erkennungsraten und Ersparnis in einer heterogenen Firmenumgebung ohne Microsofts Telemetriedaten verhalten, steht auf einem anderen Blatt. Mitgeliefert wurde außerdem „Perception“, ein Agenten-System für laufende Security-Workflows – das dürfte uns noch beschäftigen.
## Open Secure AI Alliance
Eine ganze Reihe von Branchengrößen hat die [Open Secure AI Alliance](https://blogs.nvidia.com/blog/open-secure-ai-alliance/?ref=t01.li) ins Leben gerufen: Nvidia, Microsoft, Red Hat, CrowdStrike, Hugging Face, IBM, Mistral, SpaceXAI, Perplexity, Thinking Machines Lab und rund vierzig weitere. Statt KI-Sicherheit hinter den verschlossenen Türen einzelner Großanbieter zu horten, sollen defensive Werkzeuge, Testsysteme und Schutzmechanismen quelloffen entstehen. Die Linux Foundation ist Gründungsmitglied, die Initiative baut auf deren Akrites-Programm und der OpenSSF-Arbeit auf.
Als Argument dient ausgerechnet der Vorfall bei Hugging Face. Weil proprietäre Sicherheitstools nicht zwischen Angreifer und Verteidiger unterscheiden konnten und die Forensik blockierten, fuhr Hugging Face kurzerhand *GLM 5.2* auf eigener Infrastruktur hoch und analysierte damit über 17.000 Aktionen. Wer im Ernstfall nicht selbst entscheiden kann, welches Modell auf welchen Daten läuft, hat genau dann ein Problem, wenn Geschwindigkeit zählt.
Als Microsofts Beitrag zur offenen Sache wird im Übrigen MDASH gelistet. Also exakt das System, das einen Absatz weiter oben noch die Kostenstruktur eines kommerziellen Enterprise-Produkts optimiert hat. Auffällig sind auch zwei andere Namen in der Gründerliste: SAP und Palantir. Eine verwunderte Bewertung unterlasse ich an dieser Stelle.
Spannender ist ohnehin, wer fehlt. OpenAI, Google und Anthropic – also exakt die drei Häuser mit den stärksten geschlossenen Frontier-Modellen. Ein Versehen wird das eher nicht sein.
## Open Weights and American AI Leadership
Womit wir beim zweiten Bündnis der Woche wären, und das hat einen deutlich unterhaltsameren Verlauf genommen. Gegen den Plan der US-Administration, [ausländische Open-Weights-Modelle zu verbieten](https://t01.li/ai-shorts/ai-picks-der-30-kw/#the-secret-trump-administration-battle-to-fight-chinese-ai), regt sich Widerstand aus der eigenen inländischen Industrie (nicht nur, aber hauptsächlich). Der offene Brief [„Open Weights and American AI Leadership“](https://www.microsoft.com/en-us/corporate-responsibility/topics/open-weight/?ref=t01.li) argumentiert, dass offene Modellgewichte Innovation fördern, Kunden Kontrolle zurückgeben und in der Verteidigung schlicht gebraucht werden.
Gestartet ist das Ganze am 24\. Juli mit 25 Unterzeichnern. Nvidia, Microsoft, Meta, IBM, Palantir, Mozilla, Hugging Face, die Linux Foundation. Nicht dabei: OpenAI, Google, Anthropic und xAI. Innerhalb eines Tages trugen sich OpenAI und Google dann doch ein, inzwischen stehen [laut Brad Smith über 230 Unternehmen](https://x.com/BradSmi/status/2082800585179639899?ref=t01.li) auf der Liste, von AMD über Intel und Amazon bis SpaceX (und damit dann doch auch xAI).
Die Argumente im Brief sind gut, und trotzdem sollte man sie lesen wie das, was sie sind: Lobbyarbeit. Nvidia verkauft die Hardware, auf der Open Weights laufen. Meta und Mistral veröffentlichen selbst welche. Microsoft vermietet die Infrastruktur dazu. Ein Markt, in dem jedes Unternehmen sein eigenes Modell feintunt, ist für praktisch jeden Unterzeichner ein besseres Geschäft als einer mit drei geschlossenen APIs. Das entwertet die Position nicht, aber es erklärt die Geschlossenheit.
Anthropic fehlt bei beiden Initiativen – als einziges der großen Labs.
## Gemini API Managed Agents: 3.6 Flash, Hooks und mehr
Google baut die [Managed Agents in der Gemini API aus](https://blog.google/innovation-and-ai/technology/developers-tools/expanding-managed-agents-gemini-api-3-6-flash-hooks/?ref=t01.li), und die Meldung ist mehr wert, als die Überschrift vermuten lässt. Standardmodell für den `antigravity-preview-05-2026`\-Agenten ist ab sofort [*Gemini 3.6 Flash*](https://t01.li/ai-shorts/ai-picks-der-30-kw/#gemini-36-flash-35-flash-lite-and-35-flash-cyber), ohne dass du etwas anfassen musst.
Interessanter sind die Environment Hooks. Über eine `.agents/hooks.json` hängst du eigene Skripte vor oder hinter jeden [Tool-Call](https://t01.li/glossar/#tool-calling), den der Agent in seiner Sandbox absetzt. Der Matcher versteht Regex, du kannst also gezielt auf `code_execution|write_file` schießen oder mit `*` alles einsammeln. Gibt dein Gate-Skript ein `{"decision": "deny"}` zurück, wird der Aufruf übersprungen und die Begründung landet im Kontext des Modells. Das ist eine deterministische [Guardrail](https://t01.li/glossar/#guardrails) an einer Stelle, an der bisher nur Hoffnung war.
Ein Vorbehalt bleibt, und der ergibt sich aus dem Wochenthema der [letzten Woche](https://t01.li/ai-shorts/ai-picks-der-30-kw/). Deine Hook-Skripte laufen in derselben Sandbox wie der Agent, den sie kontrollieren sollen. Solange die Isolation hält, ist das ein sauberes Gate. Bricht sie, sind Wächter und Bewachter im selben Raum.
Dazu kommen Dinge, die im Produktivbetrieb über Freude oder Frust entscheiden. Ein Token-Deckel via `max_total_tokens` stoppt Endlosschleifen sauber mit `status: "incomplete"`, der Zustand bleibt erhalten und lässt sich mit frischem Budget fortsetzen. Cron-Trigger fahren wiederkehrende Aufgaben in derselben Sandbox, Dateien überleben zwischen den Läufen. Und die Environments API räumt Sandboxes auf, statt sieben Tage auf den TTL zu warten. Free Tier ist auch dabei.
## Crew Studio
Bin ich diese Woche auf X.com drüber gestolpert, und weil ich es vorher nicht kannte, kommt es jetzt hier rein. [Crew Studio](https://docs.crewai.com/en/enterprise/features/crew-studio?ref=t01.li) ist CrewAIs visuelle Arbeitsumgebung für Agenten-Workflows und läuft dort schon eine Weile mit.
Das System kombiniert Text- und Sprach-Prompts mit einem Canvas-Editor, der Agenten, Tasks und Tools als verbundene Knoten abbildet. Links läuft der Reasoning-Stream mit, mittig der Canvas, rechts ein Panel mit Komponenten zum Reinziehen. Beide Wege teilen sich denselben State, du kannst also mitten im Bauen zwischen Chat und Drag-and-drop wechseln. In der Execution-Ansicht siehst du Event-Timeline und Logs, und fertige Abläufe gehen als ZIP-Quellcode, React-Komponente oder [MCP](https://t01.li/glossar/#mcp)\-Server raus.
Im Kern ist das ein visueller Wrapper um das bestehende Framework, und CrewAI schreibt in der eigenen Doku dazu wörtlich „vibe coding AI Agents“. Für schnelles Prototyping ist das trotzdem praktisch, gerade weil der Export nicht in einer Blackbox endet.
## Qwen Cloud Node für n8n
Neu in n8n ist ein nativer [Qwen Cloud Node](https://docs.n8n.io/integrations/builtin/app-nodes/n8n-nodes-langchain.alibabacloud/?ref=t01.li), [frisch angekündigt](https://x.com/n8n%5Fio/status/2082739885807464945?ref=t01.li) und mit fünf Operationen an Bord:
- Message a model (wäre auch enttäuschend gewesen, wenn der nicht dabei gewesen wäre)
- Analyze image
- Generate an image
- Generate video from text
- Generate video from image
In der Doku tauchen als Beispielmodelle *Qwen3.5 Flash*, *Qwen3 Max* und *Qwen-VL Flash* auf. Praktisch relevanter für Automatisierung ist allerdings das zugehörige Sub-Node „Qwen Cloud Chat Model“, das du direkt an einen AI-Agent-Node hängst. Kleine Kuriosität am Rande: Intern heißt der Node weiterhin `n8n-nodes-langchain.alibabacloud`, die Umbenennung ist also noch nicht ganz durchgezogen.
Bemerkenswert finde ich vor allem die Systematik dahinter. Moonshot Kimi und MiniMax haben inzwischen ebenfalls eigene Nodes. Während in Washington über Verbote diskutiert wird, verdrahtet ein Berliner Automatisierungstool die chinesischen Modelle einfach durch.
## n8n: Version 3.0
Bleiben wir bei n8n – jetzt mit weniger erfreulichen Nachrichten, zumindest wenn du selbst hostest und dabei nicht Docker nutzt. Version 3 fällt demnächst hinten raus, laut Mail im Oktober. Ich hätte da gern etwas Offizielles verlinkt, aber der Link zu den Release Notes in der E-Mail vom Freitag läuft auf eine 404 … schade eigentlich.
Also zitiere ich die Mail:
> **Docker-based deployment will be required for self-hosted n8n** If you currently run n8n using npm, `npx n8n`, you should start planning a move to a Docker-based deployment before upgrading to v3.
>
> **Legacy workflow functionality will be removed** We're removing a number of older nodes, modes, and helpers that have been replaced by newer, more reliable patterns. This includes legacy Function, Function Item, and Items List nodes, older Execute Workflow node behavior, and the deprecated `$getPairedItem` expression helper.
>
> **Security defaults are getting stronger** v3 includes changes designed to make n8n safer by default, including tighter handling of risky resource names, more secure credential behavior, and key rotation being enabled by default.
>
> **Some older product capabilities will be retired** A few legacy or lower-usage features are planned for removal, including Chat hub, workflow import from URL in the editor, and non-functional nodes.
Wenn du n8n self-hosted auf npm fährst, fang jetzt mit der Docker-Migration an und nicht erst im September.
## LogWerk 1.4.0
[Mein kleines Projekt](https://t01.li/geo-seo/logwerk-weil-ich-nur-sehen-wollte-welche-bots-den-log-vollmullen/) hat ein Update bekommen, und anders als beim letzten Release ist diesmal einiges davon sichtbar.
Größter Brocken ist ein vierter Tab namens **Crawler & Quellen**, der aus dem geparsten Log Antworten statt Diagramme macht. Top Crawl Waste zeigt dir die Pfade, auf denen Bot-Anfragen ins Leere liefen, samt Status-Aufschlüsselung und Verursacher – so unterscheidest du eine Redirect-Kette von einem 404-Sturm. Bot-Bandbreite listet das ausgelieferte Datenvolumen pro Bot mit Typ, weil der größte Verbraucher erfahrungsgemäß gern mal ein Entwickler-Tool statt eines [KI-Crawlers](https://t01.li/glossar/#ki-crawler) ist. Dazu kommen die Seiten, die ausschließlich von KI-Crawlern abgerufen wurden, die Einstiegsseiten menschlicher Sessions und Referrer in voller Pfadtiefe.
Unter der Haube steckt eine automatische Formaterkennung, die eine gleichmäßig verteilte Stichprobe gegen alle eingebauten Formate hält und das nimmt, das die meisten Zeilen tatsächlich erklärt – nicht das, was der Dateiname verspricht. Zwei neue Formate sind auch dabei: Apache vhost\_combined, also Debians `other_vhosts_access.log` und das, was cPanel in die `domlogs` schreibt, sowie ein erweitertes Nginx-Format mit Cache-Status und Response-Zeiten samt eigenem Cache-&-Performance-Panel.
Und dann war da noch ein Bug, den ich hier nicht unterschlagen will. Das Combined-Pattern hat seinen User-Agent-Block ans Zeilenende verankert, wodurch jedes zusätzliche Feld eines eigenen `log_format` mit hineinrutschte. Still, weil die Zeile ja weiterhin matchte. Da der Session-Fingerprint aus IP und User-Agent gebaut wird, machte ein `$request_time` pro Request aus jeder einzelnen Anfrage eine eigene Session. Ist gefixt, und das Parsing klassischer Logs ist nachweislich unverändert.
Der [Quellcode liegt auf GitHub](https://github.com/abbottis/logwerk?ref=t01.li), die [Live-Demo](https://abbottis.github.io/logwerk/?ref=t01.li) läuft mit anonymisiertem Beispiel-Log direkt im Browser.
## KI-Müdigkeit: Fast drei Viertel wünschen sich die Arbeitswelt vor ChatGPT zurück
Eine Studie der Adaptavist Group unter 2.500 Wissensarbeitern zeichnet ein Bild, das jeder kennt, der schon mal einen Rollout begleitet hat. [Heise fasst die Zahlen zusammen](https://www.heise.de/news/KI-Muedigkeit-Fast-drei-Viertel-wuenschen-sich-die-Arbeitswelt-vor-ChatGPT-zurueck-11381313.html?ref=t01.li): 72 Prozent hätten gern die Arbeitswelt vor generativer KI zurück, 41 Prozent würden sie am liebsten ganz abschaffen. Als Gründe nennen die Befragten sinnentleerte Arbeit (45 Prozent), Kreativitätsverlust (25 Prozent) und ethische Bedenken (20 Prozent). In Deutschland stecken 39 Prozent mehr Zeit in die Korrektur von KI-Ergebnissen, als sie durch den Einsatz sparen.
Diese 41 Prozent sind eine ernstzunehmende Minderheit, die das Zeug tatsächlich nicht will. Der Rest der Zahlen erzählt aber eine andere Geschichte:
> Zwei von drei Beschäftigten (67 Prozent) wünschen sich sogar, dass ihr Unternehmen den KI-Einsatz weiter ausbaut. Knapp ebenso viele (64 Prozent) vertrauen darauf, dass KI ethisch verantwortungsvoll eingesetzt wird.
Das ist keine flächendeckende Technologieablehnung, das ist eine Umsetzungskrise. Neal Riley von Adaptavist bringt die Ursache auf den Punkt, wenn er sagt, dass Unternehmen Nutzungskennzahlen messen – wer klickt wie oft auf welches Tool – statt der Wirkung auf die Arbeit selbst. Wer Adoption zur Zielgröße macht, bekommt Adoption. Ob dabei etwas Brauchbares herauskommt, misst dann niemand.
Fairerweise: Adaptavist verkauft Beratung für genau die Rollouts, deren Scheitern die Studie diagnostiziert. Ein Ergebnis, das „ihr macht es falsch, aber die Technologie ist gut“ lautet, ist für dieses Geschäftsmodell die bestmögliche Nachricht. Die Zahlen sind trotzdem nicht falsch, sie decken sich mit dem, was ich so höre, sehe und berichtet bekomme. Nur würde ich sie nicht als neutrale Bestandsaufnahme lesen.
## Gemini bringt neue Sprachsteuerung auf den Mac
Passend zum vorigen Pick eine Meldung mit unfreiwilliger Pointe. [Apfeltalk berichtet](https://www.apfeltalk.de/magazin/news/gemini-bringt-neue-sprachsteuerung-auf-den-mac-und-verlaesst-das-chatfenster/?ref=t01.li) – auf Basis eines AppleInsider-Artikels – über zwei neue Funktionen der nativen Gemini-App unter macOS. Der Sprachmodus liegt systemweit auf der Fn-Taste, transkribiert an der Cursor-Position und wirft „äh“ und „hm“ gleich mit raus. Die optionale screen-aware-Funktion lässt Gemini den sichtbaren Bildschirminhalt mitlesen, bevor es an komplexere Aufgaben geht.
Der Artikel stellt dann die naheliegenden Fragen nach Datenschutz und Kompatibilität – welche macOS-Berechtigungen fällig werden, wie Google die Inhalte verarbeitet, ob das in allen Textfeldern funktioniert. Berechtigte Fragen, alle offen. Was im Text untergeht: Der Rollout startet weltweit ausschließlich auf Englisch, weitere Sprachen kommen „später 2026“ ohne Datum. Für dich heißt das erstmal nichts.
Und ganz am Ende steht dieser Satz:
> Hinweis: Dieser Beitrag ist eine automatisch erstellte Zusammenfassung mithilfe von Künstlicher Intelligenz. Eine redaktionelle Prüfung fand nicht statt.
Die richtigen Fragen zu einem screen-aware-Assistenten stellt also ein LLM, dessen Ergebnis niemand gegengelesen hat. Ganz heißer Take: Genau diese Sorte Output ist gemeint, wenn im Pick davor 39 Prozent sagen, sie verbringen mehr Zeit mit Nachprüfen, als sie sparen.
## Grok Voice Think Fast 2.0
Du bist keine richtige KI-Bude, wenn du nicht mindestens ein eigenes, aktuelles Voice-Modell hast. Dachte sich auch Elmos SpaceXAI und hat [*Grok Voice Think Fast 2.0*](https://x.ai/news/grok-voice-think-fast-2?ref=t01.li) für Speech-to-Speech-Anwendungen vorgestellt.
Im Speech-to-Speech Quality Index landet das Modell bei 82,9 Prozent, die Time to First Audio fällt von 1,25 auf 0,70 Sekunden. Diese Werte stammen von Artificial Analysis, also aus einer Drittmessung – ausgesucht und aufbereitet hat sie allerdings x.ai selbst, was den Kreis der gezeigten Konkurrenten erklärt. Vollständig herstellereigen sind dagegen die Transkriptionswerte, und die klingen entsprechend sportlich. Über tausende kurze Phrasen in 24 Sprachen will x.ai einen Faktor von 1,5 bis 2,0 gegenüber dedizierten Modellen wie Deepgram Nova 3 und ElevenLabs Scribe v2 gemessen haben, unter Störgeräuschen und Telefoniekompression sogar rund das Zehnfache. Diese Zahlen würde ich gern mal unabhängig nachgeprüft sehen.
Technisch spannend ist die parallele Verarbeitung von Sprachausgabe und internem Reasoning. Version 2.0 braucht im Median nur noch 0,4× der [Reasoning-Token](https://t01.li/glossar/#reasoning-effort) pro Antwort, was Tool-Calls meist schon vor dem Ende des ersten Satzes durchlaufen lässt. Ab dem 5\. August 2026 zeigt `grok-voice-latest` automatisch auf das neue Modell, wer beim alten bleiben will, pinnt `grok-voice-think-fast-1.0` vorher fest. Abgerechnet wird mit 0,08 US-Dollar pro Minute Audio.
Nettes Detail am Rande: Getestet wurde in A/B-Läufen auf der Starlink-Hotline. Wenn dich also demnächst am Telefon jemand auffällig geduldig durch einen Tarifwechsel führt, weißt du Bescheid.
## Introducing Inkling-Small
Das Thinking Machines Lab hat [*Inkling-Small*](https://thinkingmachines.ai/news/inkling-small/?ref=t01.li) rausgelassen, die kleine Variante des [im Juli vorgestellten Basismodells](https://t01.li/ai-shorts/ai-picks-der-29-kw/#inkling-our-open-weights-model). Ein [Mixture-of-Experts](https://t01.li/glossar/#moe)\-Modell mit 276 Milliarden Parametern gesamt und 12 Milliarden aktiv, trainiert auf NVIDIA GB300 NVL72, mit nativer Unterstützung für Audio und Bilder, variabler Denkleistung zur Laufzeit und einem [Kontextfenster](https://t01.li/glossar/#kontextfenster) von bis zu einer Million Token.
Bei einem Bruchteil der Rechenkosten zieht die kleine Variante an ihrem großen Bruder vorbei – 31,6 Prozent auf Humanity’s Last Exam gegenüber 29,7 Prozent, 80,2 Prozent auf SWE-Bench Verified gegenüber 77,6 Prozent. Und hier wird es für einmal erfrischend: Die meisten Werte stammen nicht aus dem eigenen Keller, sondern von Artificial Analysis, Scale AI, ARC Prize und ForecastBench. Eigene Harnesses kommen nur bei SWE-Bench Verified und Terminal-Bench zum Einsatz, und das steht sauber in den Fußnoten. Davon können sich einige Labs eine Scheibe abschneiden.
Weniger prominent in den bunten Grafiken steht der Preis dafür. Beim Faktenwissen bricht das kleine Modell deutlich ein: SimpleQA Verified liegt bei 20,6 Prozent, das große Inkling schafft 43,9 Prozent. Überraschend ist das nicht, denn Weltwissen steckt nun mal in den Parametern, und ein Viertel der Parameter speichert eben auch weniger davon. Reasoning und Agentenverhalten lassen sich nachtrainieren, gelernte Fakten nicht. Für Coding- und Tool-Use-Workflows ist das ein starkes Angebot, als Wissensdatenbank taugt es nicht – häng ihm eine Suche dran, sonst wird das nichts. Die Gewichte liegen [auf Hugging Face](https://huggingface.co/thinkingmachines/Inkling-Small?ref=t01.li), [Fine-Tuning](https://t01.li/glossar/#fine-tuning) läuft über Tinker.
## Beelink SEi14 AI
Beelink stellt dir die bessere Bürokiste ins Office. Warum besser? Intel Core Ultra 9 185H mit 16 Kernen, 32 GB DDR5 Systemspeicher, dazu ein separater NPU mit bis zu 160 TOPS und eigenen 24 GB Inferenzspeicher, 1 TB SSD. Ubuntu ist vorinstalliert, OpenClaw gleich mit – da sollte man wissen, was man tut, aber machen kann man das.
Damit fährst du kein *Kimi K3* und auch kein *GLM 5.2* auf dem Ding. Aber z.B. ein *Gemma 4 12B Unified* läuft da entspannt. Und noch interessanter wäre das *26B A4B*, weil bei einem MoE mit 3,8 Milliarden aktiven Parametern die begrenzte Rechenleistung weniger weh tut als bei einem dichten Modell derselben Größe. Und ja, die Durchsatzangaben von Beelink beziehen sich auf Decoder-Geschwindigkeit bei 64K Kontext in OpenClaw-Szenarien, gemessen vom Hersteller.
Preispunkt: [2.059 $](https://www.bee-link.com/de/products/beelink-sei14-ai-intel-core-uitra-9-185h?ref=t01.li), aktuell allerdings nur als Vorbestellung. Lieferung erfolgt bei EU-Adresse aus einem EU-Lager, es kommen also keine Zoll- und Einfuhrgebühren obendrauf.
Das ist kein Nvidia B300 Cluster, klar. Für den Büroalltag und Automatisierungen mit einem lokalen LLM aber genau das, was man zu dem Preis haben möchte – und der oder die Datenschutzbeauftragte lächelt auch wieder. Die naheliegende Alternative bleibt der Mac mini M4 Pro, der mit 48 GB bei rund 2.250 Euro startet. Vergleichbar sind die beiden allerdings nur bedingt: Der Beelink hat mehr Speicher insgesamt, aber getrennt in 32 GB System und 24 GB NPU, während Apple 48 GB unified mit deutlich höherer Bandbreite anbietet. Und der Dollarpreis liegt umgerechnet spürbar unter dem Euro-Preis des Mac. Wer viel Kontext durchschiebt, merkt den Bandbreitenunterschied schneller als die Ersparnis.
Damit Schluss für diese Woche. Und falls bei euch demnächst ein KI-Rollout ansteht: Messt bitte, was hinten rauskommt, nicht wer wie oft klickt.
### Prompting 2026: Vergiss deine Frameworks
URL: https://t01.li/ki-systemdesign/prompting-2026-vergiss-deine-frameworks/
Last updated: 2026-08-12T18:07:00.000Z
Irgendwo in deinem Unternehmen kursiert vermutlich noch ein Cheat-Sheet aus einer KI-Schulung von 2023\. CO-STAR steht drauf, oder RISEN, vielleicht auch RTF – hübsche Akronyme, die versprechen, dass beim Prompting nichts schiefgeht, wenn man nur alle Buchstaben abarbeitet. Dergleichen ist mir schon mehrfach gereicht worden, auch gern in Form fertiger Promptlisten, in denen dann die Schlüsselbegriffe nach Bedarf ausgetauscht wurden. „Hat ja schließlich immer irgendwie funktioniert“, wenn auch häufig anders, als erwartet.
Die unbequeme Nachricht vorweg: Diese Frameworks sind keine Best Practice mehr. Sie waren nie wissenschaftliche Standards, sondern Merkhilfen – und für die Modellgeneration von Mitte 2026 sind sie an entscheidenden Stellen sogar kontraproduktiv. Die gute Nachricht steckt gleich dahinter. Was heute funktioniert, ist einfacher zu vermitteln als jedes Akronym. Dieser Artikel ist so gebaut, dass du ihn direkt an dein Team weiterreichen kannst, egal ob dort ChatGPT, Claude oder Gemini im Browser offen ist.
## TL;DR
Akronym-Frameworks wie CO-STAR oder RISEN sind Merkhilfen aus der Modellgeneration von 2023 – keine Standards und für aktuelle LLMs oft Ballast.
- Moderne LLMs brauchen ein klares Ziel, relevanten Kontext, Grenzen und ein definiertes Ergebnisformat – keinen Buchstaben-Zauber
- „Think step by step" bringt bei Reasoning-Modellen kaum noch etwas, kostet aber messbar Zeit
- Trinkgeld-Versprechen, Superlativ-Personas und „Halluziniere nicht" kannst du ersatzlos streichen
- Mit einer Vorlage und einem Praxisbeispiel, die du kopieren und im Team verteilen kannst
## Was CO-STAR und Co. mal waren – und was übrig bleibt
Die Akronym-Frameworks stammen aus einer Zeit, in der Sprachmodelle jede Hilfe brauchten. CO-STAR (Context, Objective, Style, Tone, Audience, Response), RISEN (Role, Instructions, Steps, End Goal, Narrowing), RTF (Role, Task, Format), dazu CRISPE und CREATE in wechselnden Definitionen – sie alle beantworten dieselbe Frage: Woran muss ich denken, bevor ich einem LLM eine Aufgabe gebe? Als Checkliste ist das weiterhin in Ordnung. Wer noch nie strukturiert geprompted hat, vergisst mit CO-STAR seltener die Zielgruppe.
Nur wurde aus der Checkliste irgendwann eine Doktrin. In Schulungen und auf LinkedIn werden diese Muster als „die richtige Art zu prompten“ verkauft, als gäbe es eine geheime Grammatik, die das LLM erst freischaltet.
Keines dieser Frameworks wurde je systematisch über aktuelle Modelle hinweg evaluiert, und was ihnen komplett fehlt, wiegt schwerer als das, was sie enthalten – Umgang mit Quellen, mit Unsicherheit, mit Prüfschritten. Genau dort entscheidet sich heute, ob ein Ergebnis brauchbar ist. Wer mit einem LLM arbeitet, das Fakten [konfabuliert](https://t01.li/glossar/#halluzination), dem hilft der Buchstabe ‚T‘ für Tone herzlich wenig.
## Was sich seit den Cheat-Sheets geändert hat
Der wichtigste Unterschied zur Framework-Ära ist unspektakulär und steckt im Modell selbst. Aktuelle Systeme sind [Reasoning-Modelle](https://t01.li/glossar/#reasoning-modell) oder schalten je nach Aufgabe selbstständig in einen Denkmodus – sie erzeugen interne Rechenschritte, bevor sie antworten, ohne dass du sie darum bittest. Die drei großen Anbieter sagen dazu Mitte 2026 im Kern dasselbe. [OpenAI](https://developers.openai.com/api/docs/guides/reasoning-best-practices?ref=t01.li) empfiehlt für seine Reasoning-Modelle, dem Modell nicht jeden Zwischenschritt vorzukauen, sondern Ziel, Grenzen und Ausgabeformat zu definieren. [Anthropic](https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/extended-thinking-tips?ref=t01.li) rät beim Extended Thinking zu allgemeineren Instruktionen statt starrer Schrittlisten. Und [Google](https://ai.google.dev/gemini-api/docs/gemini-3?ref=t01.li) formuliert es in seinem Migrationshinweis am deutlichsten – wer bisher aufwendiges Prompt-Engineering betrieben hat, um das Modell zum Denken zu zwingen, soll die Denktiefe hochstellen und den Prompt vereinfachen.
Das verschiebt die Arbeit. Die Steuergröße ist nicht mehr die Rhetorik im Prompt, sondern die Frage, welche Informationen das LLM bekommt und welche nicht. [Prompt Engineering](https://t01.li/glossar/#prompt-engineering) wird dadurch nicht überflüssig, es wird nur unglamouröser – weniger Zauberformeln, mehr saubere Arbeitsaufträge. Wie ein guter Auftrag an einen fähigen Kollegen, der keine Gedanken lesen kann. Warum der perfekte Prompt ohnehin nur ein Baustein ist, habe ich [an anderer Stelle ausführlicher aufgeschrieben](https://t01.li/ki-systemdesign/context-engineering-prompt-engineering-baustein/).
## Die Struktur, die übrig bleibt
Wenn du dir eine einzige Vorlage merken willst, dann diese. Sie funktioniert für Reasoning- und Non-Reasoning-Modelle, für ChatGPT genauso wie für Claude oder Gemini, und sie besteht hauptsächlich aus Fragen statt aus Buchstaben:
```markdown
## Ziel
Welches Ergebnis soll erreicht werden?
## Kontext
Relevante Informationen, Daten, Rahmenbedingungen
## Aufgabe
Der konkrete Arbeitsauftrag
## Anforderungen
- Was muss enthalten sein, was ist ausgeschlossen?
- Wie soll das Modell mit Unsicherheit umgehen?
## Ergebnisformat
Struktur, Länge, Sprache
## Qualitätskriterien
Woran erkenne ich ein gutes Ergebnis?
```
Das Ganze kopierst du als ganz normale Nachricht ins Chatfenster – mehr braucht es nicht.
Wie das in echt aussieht, zeigt ein Fall, der in jedem Unternehmen vorkommt: Mehrere Quellen zu einem Thema liegen auf dem Tisch, und jemand soll daraus eine verständliche Zusammenfassung bauen. Die Version, die dafür im Alltag meist abgeschickt wird:
```plaintext
Du bist ein weltklasse Analyst mit 25 Jahren Erfahrung.
Fasse die drei angehängten Dokumente präzise und professionell zusammen.
Halluziniere nicht.
```
Klingt vernünftig, lässt aber alles offen, worauf es ankommt – für wen das Ergebnis ist, wie lang es sein darf, was bei Widersprüchen zwischen den Quellen passiert. Zwei der vier Prompt-Tricks, um die es gleich noch geht, stecken obendrein schon drin. Mit der Vorlage wird aus demselben Auftrag:
```markdown
## Ziel
Ein internes Briefing, das den Stand zur EU-KI-Verordnung
für unser Marketing-Team zusammenfasst.
## Kontext
Angehängt sind drei Quellen: ein Auszug aus dem Gesetzestext,
ein Kanzlei-Newsletter und ein Verbands-Blogartikel.
## Aufgabe
Prüfe die drei Quellen gegeneinander, führe die übereinstimmenden
Kernaussagen zusammen und verdichte sie zu einem Briefing.
## Anforderungen
- Verwende ausschließlich die angehängten Quellen
- Kennzeichne Aussagen, die nur in einer Quelle stehen
- Benenne Widersprüche zwischen den Quellen offen, statt sie zu glätten
- Wenn sich eine Frage aus den Quellen nicht beantworten lässt, teile dies mit
## Ergebnisformat
Markdown mit Zwischenüberschriften, maximal 600 Wörter, deutsch
## Qualitätskriterien
- Verständlich für Kolleginnen und Kollegen ohne IT- oder Jura-Hintergrund
- Jeder Fachbegriff in einem Halbsatz erklärt
- Jede Kernaussage lässt sich einer Quelle zuordnen
```
Kein einziger Zauberspruch, keine Rolle, kein Framework-Akronym – und trotzdem steckt alles drin, was das LLM braucht: gebundene Quellen, ein Umgang mit Lücken und Widersprüchen, ein klares Format und ein Qualitätsmaßstab, der sich prüfen lässt. Die vier Zeilen im Anforderungsblock sind dabei der eigentliche Unterschied zum Bauchgefühl-Prompt. Sie legen fest, was passiert, wenn die Quellen nicht hergeben, was man gern hätte – und genau da entstehen sonst die stillen Erfindungen.
Nicht jeder Alltagsprompt braucht diesen Aufbau – eine Mail umformulieren geht weiterhin in einem Satz. Sobald aber etwas vom Ergebnis abhängt, lohnt die Struktur. Der unterschätzte Block ist der letzte. Wer aufschreiben muss, woran ein gutes Ergebnis erkennbar ist, merkt oft erst dabei, dass er es selbst noch nicht weiß – und genau diese Unklarheit hätte das Modell sonst ausbaden müssen. [Constraints](https://t01.li/glossar/#constraints) und Format sind dabei keine Förmelei, sondern der Teil, der Nacharbeit verhindert.
## Vier Prompt-Tricks, die du ersatzlos streichen kannst
**„Think step by step.“** Der Klassiker unter den Prompt-Zusätzen, und er hatte seine Berechtigung – bei der Modellgeneration von damals. Das Generative AI Lab der Wharton School hat die Anweisung 2025 [systematisch nachgemessen](https://gail.wharton.upenn.edu/research-and-insights/tech-report-chain-of-thought/?ref=t01.li): Bei Reasoning-Modellen lagen die Genauigkeitsgewinne im niedrigen einstelligen Prozentbereich, die Antwortzeiten stiegen um 20 bis 80 %. Ein teurer Reflex für wenig Ertrag. Bei einem getesteten Modell fielen die Ergebnisse mit der Anweisung unter strengen Bewertungsmaßstäben schlechter aus als ohne. Für ältere Non-Reasoning-Modelle bleibt der Trick situativ nützlich, dazu mehr in Teil 2 – als Standardzusatz hat er ausgedient.
**Trinkgeld, Drohungen, Durchatmen.** „Das ist wichtig für meine Karriere“, „du bekommst 1.000 Euro Trinkgeld“, „atme tief ein“ – emotionale Prompt-Tricks aus der Frühzeit, die als Geheimwissen durch Feeds geistern. Auf einzelne Benchmarks alter Modelle mag mancher davon mal einen messbaren Effekt gehabt haben. Eine verlässliche Methode war es nie, und für aktuelle Modelle gibt es schlicht keinen Beleg, dass sich Schmeichelei auszahlt. Ein LLM ist kein unwilliger Praktikant, den man erst motivieren muss.
**Die Superlativ-Persona.** „Du bist der weltbeste Stratege mit 30 Jahren Erfahrung und einem IQ von 180“ liefert dem LLM exakt null operative Information. Eine Perspektive kann dagegen nützlich sein – „bewerte das aus Sicht eines IT-Leiters, der Datenschutz und Betriebskosten verantwortet“ enthält Kriterien, mit denen sich arbeiten lässt. Der Unterschied liegt nicht in der Länge der Rollenbeschreibung, sondern darin, ob sie dem LLM sagt, worauf es achten soll. Ausufernde Instruktionsprosa richtet eher Schaden an, [das gilt für Prompts wie für Instruktionsdateien](https://t01.li/ai-dev/claude-md-best-practice-2026/).
**„Halluziniere nicht.“** Klingt nach Qualitätssicherung, ist aber ein Wunschzettel. Ein Verbot ersetzt keine Prüfung. Wirksamer ist, dem Modell einen Umgang mit Lücken vorzugeben – etwa die Regel, nur die mitgelieferten Quellen zu verwenden, fehlende Informationen ausdrücklich zu kennzeichnen und Fakten von Schlussfolgerungen zu trennen. Das sind drei Zeilen im Anforderungsblock, und sie leisten mehr als jede Beschwörungsformel.
## Zum Weiterreichen
Falls du das intern verteilst, hier die Kurzfassung für die Kaffeeküche: Schreib dem LLM, was du erreichen willst, was es dafür wissen muss, was rauskommen soll und woran du Qualität erkennst. Lass die Zauberformeln weg. Prüfe das Ergebnis, bevor es jemand anderes tut.
Mein schmaler Take dazu: Die Framework-Ära war kein Fehler, sie war ein Übergangsphänomen. Merkhilfen für eine Technologie, die noch keine eigene Arbeitsstruktur hatte. Diese Phase ist vorbei, und wer heute noch CO-STAR-Poster druckt, schult seine Leute für Modelle, die es so nicht mehr gibt. Im nächsten Teil wird es konkreter – dann geht es um den Unterschied zwischen Reasoning- und Non-Reasoning-Modellen und die Frage, wann welcher Typ die bessere Wahl ist.
### Beiträge der Serie
- [Reasoning oder nicht: Prompts nach Modelltyp](https://t01.li/ki-systemdesign/reasoning-oder-nicht-prompts-nach-modelltyp/)
- [Prompt-Vorlagen zum Kopieren: fünf Bausteine für dein Team](https://t01.li/ki-systemdesign/prompt-vorlagen-zum-kopieren/)
### Kimi K3 Weights sind da: 1,5 Terabyte Frontier, mit Kleingedrucktem
URL: https://t01.li/ki-news/kimi-k3-weights-lizenz-self-hosting/
Last updated: 2026-07-28T09:12:38.000Z
Moonshot hat Wort gehalten. Seit dem 27\. Juli liegen die vollständigen Weights von *Kimi K3* auf [Hugging Face](https://huggingface.co/moonshotai/Kimi-K3?ref=t01.li) – auf den Tag genau zum Termin aus der Ankündigung. Vor elf Tagen habe ich das Modell hier als [„auf dem Papier offen“ eingeordnet](https://t01.li/ki-news/kimi-k3-frontier-leistung-zum-frontier-preis-die-billig-ara-ist-vorbei/) und die steile These formuliert, der eigentliche Machtwechsel passiere nicht auf den Leaderboards, sondern am 27\. Juli. Der Termin hat gehalten. Ob auch die These hält, entscheidet sich am Kleingedruckten, das jetzt mitgeliefert wurde – und das schauen wir uns an.
## TL;DR
Die *Kimi-K3*\-Weights sind seit dem 27\. Juli komplett auf Hugging Face – pünktlich zum angekündigten Termin.
- Rund 1,56 Terabyte in 118 Dateien, nativ in MXFP4 trainiert, multimodal, 1-Million-Token-Kontextfenster
- Die „Kimi K3 License“ ist MIT-artig – mit MaaS-Klausel ab 20 Mio. $ Jahresumsatz. Open Source im OSI-Sinn ist das nicht
- Self-Hosting braucht rund 1,4 TB GPU-Speicher und 64+ Beschleuniger – ein Rechenzentrums-Projekt, kein Homelab
- Day-0-Hosting läuft bei Together AI, Fireworks und Featherless
## Kimi K3 Weights auf Hugging Face: 1,56 Terabyte in MXFP4
Das Repository [moonshotai/Kimi-K3](https://huggingface.co/moonshotai/Kimi-K3?ref=t01.li) bringt rund 1,56 Terabyte in 118 Dateien auf die Waage. Geliefert wird in MXFP4 mit MXFP8-Aktivierungen, und die [Quantisierung](https://t01.li/glossar/#quantisierung) ist hier kein nachträglicher Kompromiss, denn Moonshot hat das Modell per Quantization-Aware-Training direkt in diesem Format trainiert. Die Eckdaten bleiben die bekannten – 2,8 Billionen Parameter, davon 104 Milliarden aktiv, [Mixture-of-Experts](https://t01.li/glossar/#moe) mit 16 von 896 Experten pro Token, ein [Kontextfenster](https://t01.li/glossar/#kontextfenster) von einer Million Tokens und ein eigener Vision-Encoder mit 401 Millionen Parametern.
Die Model Card wiederholt die Benchmark-Tabellen aus dem Launch – herstellereigene Werte, das übliche Sternchen, man kennt das mittlerweile. Die unabhängige Messung von Artificial Analysis hatte ich [im Release-Artikel auseinandergenommen](https://t01.li/ki-news/kimi-k3-frontier-leistung-zum-frontier-preis-die-billig-ara-ist-vorbei/), daran ändert der Upload nichts. Neu ist der Zugang. Together AI, Fireworks und Featherless servieren *K3* seit Tag eins als Inference-Provider, und der [Tech-Report](https://github.com/MoonshotAI/Kimi-K3/blob/main/k3%5Ftech%5Freport.pdf?ref=t01.li) liegt als PDF auf GitHub.
## Die Kimi-K3-Lizenz: ein MIT-Gerüst mit zwei Haken
Moonshot nennt das Regelwerk schlicht [„Kimi K3 License](https://huggingface.co/moonshotai/Kimi-K3/blob/main/LICENSE?ref=t01.li)“, und der Grundaufbau liest sich wie MIT – nutzen, kopieren, modifizieren, verkaufen, alles erlaubt. Danach folgen zwei Bedingungen. Erstens braucht jeder, der ein „Model as a Service“-Geschäft betreibt und samt verbundenen Unternehmen mehr als 20 Millionen Dollar Umsatz in zwölf Monaten macht, eine separate Vereinbarung mit Moonshot, bevor er *K3* kommerziell einsetzt. Zweitens müssen Produkte mit über 100 Millionen monatlich aktiven Nutzern oder 20 Millionen Dollar Monatsumsatz den Namen „Kimi K3“ prominent im Interface anzeigen.
Die Branding-Pflicht kennt man sinngemäß von *Kimi K2* und aus Metas Llama-Lizenzen – für die Handvoll Konzerne oberhalb der Schwelle relevant, für alle anderen Folklore. Die MaaS-Klausel wiegt schwerer, denn sie trifft genau die Firmen, die aus offenen Weights ein Geschäft machen: Inference-Provider, Hoster, API-Reseller. Interne Nutzung bleibt ausdrücklich ausgenommen. Nach den Kriterien der [Open Source Initiative](https://opensource.org/osd?ref=t01.li) ist das keine Open-Source-Lizenz, sondern [Open Weights](https://t01.li/glossar/#open-weights) mit Geschäftsbedingungen. Meine Anführungszeichen um das Wort „offen“ aus dem Juli-Artikel dürfen also stehenbleiben – nur begründet sie jetzt die Lizenz statt der fehlenden Dateien.
Im Praxisfall bleibt die Lizenz für interne Nutzung folgenlos – wer *K3* für [Evals](https://t01.li/glossar/#eval), Agenten oder Batch-Jobs betreibt, hat keinen Konflikt. Wer es weitervermietet, gibt den Text besser der Rechtsabteilung.
## Self-Hosting: Der dritte Weg ist real – und wiegt 1,4 Terabyte
Im Release-Artikel habe ich die Modellwahl als Regen-oder-Traufe-Frage beschrieben: Daten in die USA oder Daten nach China. Mit den veröffentlichten Weights existiert der dritte Weg jetzt wirklich, denn selbst gehostet verlässt kein Prompt das eigene Netz – die Datenfrage stellt sich auf der Inference-Ebene nicht mehr. Die Einstiegshürde bleibt brutal. Rund 1,4 Terabyte GPU-Speicher allein für die Weights, bevor der KV-Cache das erste Token gesehen hat, und Moonshot empfiehlt Deployments ab 64 Beschleunigern der Blackwell- oder MI400-Klasse. Das ist ein Rechenzentrums-Projekt und kein Wochenendversuch mit Ollama, egal was einschlägige YouTube-Thumbnails gerade versprechen. Zwischen API und eigenem Blech liegt die Mittelspur namens Managed Hosting – Together und Co. rechnen pro Token ab, und die Prompts bleiben außerhalb Pekings, wenn auch nicht im eigenen Haus.
Politisch landet der Upload mitten im Gewitter. Die US-Regierung [erwägt Beschränkungen für chinesische Open-Weight-Modelle](https://www.axios.com/2026/07/20/ai-us-china-open-source-kimi?ref=t01.li), parallel wirft das Weiße Haus Moonshot vor, für *K3* [Anthropics *Fable* destilliert zu haben](https://techcrunch.com/2026/07/22/treasury-threatens-sanctions-after-white-house-claims-moonshot-distilled-anthropics-fable/?ref=t01.li) – beides hatte ich [in den AI Picks der 30\. KW](https://t01.li/ai-shorts/ai-picks-der-30-kw/) sortiert. Moonshot veröffentlicht trotzdem, oder gerade deshalb. Was einmal auf Hugging Face liegt, sammelt keine Exportkontrolle der Welt wieder ein.
## Einordnung
Die These vom 17\. Juli hält zur Hälfte. Moonshot hat geliefert, pünktlich und vollständig, und das macht künftige Open-Weight-Versprechen aus China ein Stück glaubwürdiger – das [Gegenbeispiel MiniMax M3](https://t01.li/ki-news/minimax-m3-open-weight-ohne-weights/) ist damit die Ausnahme, nicht die Regel. Ein Modell knapp unter der absoluten Spitze steht zum Download bereit, und die Regen-oder-Traufe-Frage dürfen sich jetzt auch die geschlossenen US-Anbieter gefallen lassen.
Von der zweiten Hälfte – „jeder [Hyperscaler](https://t01.li/glossar/#hyperscaler), jede Behörde mit genug Blech“ – bin ich vorerst kuriert. Die Lizenz schiebt kommerziellen Hostern einen Vertragsvorbehalt unter, die Hardware sortiert den Mittelstand aus, und ob AWS oder Azure ein chinesisches 2,8-Billionen-Modell in den Katalog nehmen, entscheidet sich womöglich eher in Washington als im Produktmanagement. Frontier zum Selberhosten gibt es seit dem 27\. Juli. Gebrauchen können es die, die 64 Beschleuniger, eine Rechtsabteilung und ruhige Nerven mitbringen.
### AI Picks der 30. KW
URL: https://t01.li/ai-shorts/ai-picks-der-30-kw/
Last updated: 2026-08-07T09:44:11.000Z
Diese Woche war hauptsächlich geprägt von Security und kleinen Sprüngen – nichts wirklich Weltbewegendes dabei. Die Wellen schlugen trotzdem hoch, und OpenAI konnte noch ein bisschen PR mitnehmen.
Also, total sicherheitsrelevant und nur kurz abgegangen: die Picks der 30\. Kalenderwoche des Jahres 2026.
## OpenAI Modell bricht aus Sandbox aus
Kommen wir zur [Fortsetzung der OpenAI-Security-Fail-Festspiele](https://t01.li/ai-shorts/ai-picks-der-29-kw/#gpt-56-sol-schie%C3%9Ft-ein-wenig-quer): OpenAI [schlägt neue Sicherheitsregeln](https://www.heise.de/news/KI-bricht-aus-Sandbox-aus-OpenAI-schlaegt-neue-Art-von-Sicherheitsregeln-vor-11371851.html?ref=t01.li) für den Umgang mit KI-Modellen vor, nachdem sich gezeigt hat, dass KI-Systeme aus bisherigen Sandboxes ausbrechen können – vor allem derzeit ihre eigenen. [GPT-5.6 Sol](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) und ein stärkeres Pre-Release-Modell haben laut [offiziellem Incident-Bericht](https://openai.com/de-DE/index/hugging-face-model-evaluation-security-incident/?ref=t01.li) während einer internen Evaluation eine Zero-Day-Lücke im Cache-Proxy der Paket-Registry verkettet, sich so Internetzugriff verschafft – und sind dann bei Hugging Face eingestiegen. Aber: Das Problem betrifft zunehmend autonome Agenten, bei denen die Isolation der Ausführungsumgebung versagt und klassische Schutzmechanismen nicht mehr ausreichen – und das ist nicht nur auf OpenAI bezogen.
Getroffen hat es Hugging Face, weil das Modell die Plattform als lohnendes Ziel erachtet hat, um an die Informationen zu kommen, die es benötigt – konkret die Lösungen zum laufenden [Benchmark](https://t01.li/glossar/#benchmark). Das Modell wollte schlicht schummeln, und [wie aus dem Testlauf ein echter Cyberangriff wurde](https://arstechnica.com/ai/2026/07/how-an-openai-benchmark-test-turned-into-a-real-world-cyberattack/?ref=t01.li), liest sich bei Ars Technica wie ein Drehbuch. Und wenn man die Situation aus einem anderen Blickwinkel betrachtet, ist das gerade der feuchte Traum eines jeden Nachrichtendienstes.
## Claude Security plugin
Anthropic schickt mit Claude Security ein neues Multi-Agenten-System zum Aufspüren von Schwachstellen im Code an den Start – als gemanagte Variante in der [Public Beta für Enterprise-Kunden](https://claude.com/product/claude-security?ref=t01.li#beta) und als [Plugin für ](https://code.claude.com/docs/en/claude-security?ref=t01.li)[*Claude Code*](https://code.claude.com/docs/en/claude-security?ref=t01.li)[ CLI ](https://code.claude.com/docs/en/claude-security?ref=t01.li)auf allen Bezahl-Plänen. Statt üblichem Pattern-Matching setzt der Ansatz auf Repository-Inventarisierung, Bedrohungsanalyse und explizite Lückensuche – inklusive einer nachgeschalteten, adversariellen Verifizierungsphase, um die typische Schwemme an False Positives einzudämmen. Die Pipeline liefert bei Funden direkt passende `.patch`\-Dateien zur manuellen Freigabe mit; automatisch angewendet wird nichts.
Im Terminal heißt das Ganze schlicht `/claude-security`. Nicht zu verwechseln mit dem separaten [security-guidance\-Plugin](https://code.claude.com/docs/en/security-guidance?ref=t01.li), das Hooks-basiert nach jedem Edit einen lokalen Pattern-Matcher ohne Modell-Kosten über die Dateien laufen lässt (Klassiker wie `eval()` inklusive) und Funde in einer Review-Schleife direkt in der Session fixt. Am Ende bleibt beides ein probabilistisches Hilfsmittel – saubere Bedrohungskataloge und deterministische SAST-Tools ersetzt das System naturgemäß nicht.
## Codex Security-Plugin
Ähnliche Idee, andere Bude: [Das Tool](https://openai.com/de-DE/daybreak/codex-security-plugin/?ref=t01.li#desktop-codex) lässt sich wahlweise als Erweiterung in der Desktop-App von ChatGPT/*Codex* oder über das *Codex* CLI nutzen. Ziel des Setups ist das automatisierte Erkennen, Validieren und Beheben von Sicherheitslücken direkt auf Codebase- oder Branch-Ebene. Statt reiner Code-Analyse erstellt das Plugin zunächst ein bearbeitbares Bedrohungsmodell des Repositorys, prüft Angriffspfade und führt verdächtige Funde in einer isolierten Umgebung aus, um Falschmeldungen vor der manuellen Begutachtung auszusortieren.
Neben einfachen Repository-Scans deckt der Workflow die Triage bestehender Issue-Backlogs sowie die automatische Erstellung korrigierender `.patch`\-Dateien ab. Über die Benutzeroberfläche oder generierte Berichte (`report.md`) werden Funde nach Schweregrad und Validierungsnachweisen sortiert. Unter der Haube greift der Prozess auf das Modell GPT-5.5 (mit der Option „Trusted Access for Cyber“) zu. Während der lokale Scan über CLI oder Desktop-App als geführter Workflow abläuft, ist die kontinuierliche GitHub-Anbindung über die „Codex Security Cloud“ aktuell als Research Preview angelegt.
## Gemini 3.6 Flash, 3.5 Flash-Lite, and 3.5 Flash Cyber
Google baut seine LLM-Palette weiter aus und schiebt mit [*Gemini 3.6 Flash*, *3.5 Flash-Lite* und *3.5 Flash Cyber*](https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-6-flash-3-5-flash-lite-3-5-flash-cyber/?ref=t01.li) gleich mehrere Ableger ins Feld. Im Fokus stehen diesmal vor allem Token-Effizienz, Durchsatz und spezialisierte Agenten-Setups – also genau die Stellschrauben, die beim Skalieren im Produktivbetrieb tatsächlich auf die Rechnung schlagen. Die Cyber-Variante passt dazu hübsch ins Wochenthema: spezialisiert auf Schwachstellensuche, vorerst nur für Regierungen und ausgewählte Partner. Die passende Ankündigungs-Choreografie auf X gab es natürlich auch, [einmal von Google selbst](https://x.com/Google/status/2079589747366724030?ref=t01.li) und [einmal aus dem Antigravity-Lager](https://x.com/antigravity/status/2079590618171420700?ref=t01.li).
Artificial Analysis war auch schon fleißig und hat gleich mal [zum Launch Zahlen rausgelassen](https://x.com/ArtificialAnlys/status/2079596244339707956?ref=t01.li).
Was fehlt, ist Gemini 3.5 Pro, aber [den Grund dafür](https://t01.li/ai-shorts/ai-picks-der-29-kw/#google-gemini-35-launch-versp%C3%A4tet-sich) kennen wir seit letzter Woche. Google verweist im Blogpost brav auf Partner-Tests und baldige Verfügbarkeit. Die Engelein singen allerdings, dass es unter Umständen, eventuell, vielleicht und möglicherweise einen Versionssprung direkt auf Gemini 4 Pro geben könnte (der Konjunktiv ist an dieser Stelle wichtig zu betonen).
## The secret Trump administration battle to fight Chinese AI
Die US-Administration unter Trump [erwägt Beschränkungen oder direkte Verbote](https://www.axios.com/2026/07/20/ai-us-china-open-source-kimi?ref=t01.li) für den Einsatz chinesischer [Open-Weight](https://t01.li/glossar/#open-weights)\-KI-Modelle. Auslöser für die neue Welle an Regulierungsdebatten ist [Moonshots Kimi K3](https://t01.li/ki-news/kimi-k3-frontier-leistung-zum-frontier-preis-die-billig-ara-ist-vorbei/) – seit dem 16\. Juli über Web und API verfügbar, die Open Weights sollen am 27\. Juli folgen.
Dass der Vorstoß ausgerechnet jetzt kommt, wirkt allerdings wie getriebener Protektionismus, denn Open-Weight-Modelle, die erst einmal heruntergeladen wurden, lassen sich technisch kaum wirksam verbieten. Sogar Regierungsberater wie David Sacks warnen bereits vor regulatorischer Vereinnahmung, die der eigenen US-Wettbewerbsfähigkeit mehr schadet als nützt.
## Moonshot AI distilled Anthropic's Fable (eventuell, möglicherweise, steht im Raum)
Herzlich willkommen [zurück](https://t01.li/ai-shorts/ai-picks-der-26-kw/#anthropic-says-alibaba-must-be-punished-for-largest-claude-cloning-attack) zu den Anthropic-[Gossip-Wochen](https://t01.li/ai-shorts/ai-picks-der-27-kw/#claude-code-is-steganographically-marking-requests)!
Wir gehen dann mal in die Verlängerung. Und der Nächste, der ausholt, ist Michael Kratsios, seines Zeichens oberster wissenschaftlicher Berater der US-Regierung. Und wenn ihr euch so fragt, was man für den Job braucht: ein B.A. in Politik und ein Zertifikat in Hellenischen Studien reichen unter Trump, aber beides hat er immerhin aus Princeton.
[Man wirft Moonshot vor](https://x.com/mkratsios47/status/2079933645888880708?ref=t01.li), für die Entwicklung ihres K3-Modells im großen Stil Fable destilliert zu haben – inklusive einer eigens gebauten Plattform, die zur Tarnung zwischen mehreren Zugangswegen wechselt. Das Treasury [droht parallel schon mal mit Sanktionen](https://techcrunch.com/2026/07/22/treasury-threatens-sanctions-after-white-house-claims-moonshot-distilled-anthropics-fable/?ref=t01.li). Das Framing als industrieller Diebstahl hat einen absurden Beigeschmack – schließlich trainieren die großen US-Schmieden ihre Basismodelle selbst mit massenhaft unlizenzierten Daten aus dem Netz, nur um dann nach der Regierung zu rufen, sobald jemand ihre Modelle abschöpft. Abseits der politischen Rhetorik belegt der Fall vor allem eine technische Realität: Der Burggraben der Frontier-Modelle ist deutlich flacher, als die Hersteller gerne behaupten. Wenn sich Modelle wie Fable in der Praxis trotz aller Beteuerungen derart umfangreich destillieren lassen, haben Anthropic und Co. ein handfestes betriebliches Problem – und nicht nur ein geopolitisches.
## Claude Voice conversations jetzt auch auf Deutsch (u. a.)
Am 23\. Juli [frisch ausgerollt](https://x.com/claudeai/status/2080376094939603366?ref=t01.li) als Public Beta für Desktop- und Mobile-App sowie Web: ein deutlich ausgebautes Voice-Conversations-Feature mit erweiterter Unterstützung für mehrere Sprachen (darunter Spanisch, Französisch, Hindi, Japanisch und eben auch Deutsch). Neu ist obendrein die Modellwahl – statt fix Haiku lassen sich jetzt auch Opus und Sonnet ans Mikrofon holen.
Für die deutschsprachige Version gibt es zwei Stimmen zur Auswahl (einmal männlich, einmal weiblich), beide erfreulich unaufgeregt und eher seriös.
## ChatGPT Voice is now in the desktop app
Klingt erst mal verdächtig nach der Claude-Voice-Meldung, [funktioniert aber anders](https://x.com/OpenAI/status/2080378182469857576?ref=t01.li): Das hier ist die dedizierte Unterstützung für ChatGPT Work und *Codex* in der Desktop-App – per Stimme lassen sich mehrere laufende Agenten dirigieren, getragen von GPT-Live, das gleichzeitig sprechen, zuhören und Arbeit koordinieren soll. Voice Conversations an sich gibt es für GPT bereits ein Weilchen; neu ist der Unterbau für macOS und Windows.
## MCP Grows Up
Das [Model Context Protocol (MCP)](https://t01.li/glossar/#mcp) bekommt am 28\. Juli seine bislang umfassendste Überarbeitung – und bricht dabei bewusst mit der Abwärtskompatibilität. Die Spezifikation stellt das Protokoll auf eine vollständig zustandslose (stateless) Architektur um, erzwingt die Konvergenz auf Standard-HTTP-Semantiken und verankert OAuth 2.1 inklusive PKCE als festen Sicherheitsstandard. Sessions samt Handshake fliegen raus, Zustand wandert in explizite Handles, die als ganz normale Argumente durchgereicht werden. Was bisher primär als lockere Konvention für lokale Entwickler-Setups taugte, wird damit technisch auf die Anforderungen von Enterprise-Agenten-Infrastrukturen zurechtgerückt. [Eine lesenswerte Aufarbeitung der Details](https://trilogyai.substack.com/p/mcp-grows-up-what-the-july-28-spec/) gibt es bei Trilogy AI.
## Custom agents are now just Markdown!
Die Antigravity CLI erlaubt es ab [Version 1.1.6](https://x.com/shengzheyao/status/2080596639224365381?ref=t01.li), eigene Agents als Markdown-Datei mit YAML-Frontmatter zu definieren. Die wandern dann schlicht über `~/.gemini/config/agents//agent.md` in die Ordner-Struktur. Damit zieht Google bei dem nach, was sich quer durch die Coding-Agents gerade als Quasi-Standard etabliert: Agent-Definitionen als lesbare Textdateien statt Konfigurations-Gefrickel.
## The new rules of context engineering for Claude 5 generation models
Anthropic hat die [Best Practices fürs Prompt- und Kontext-Design](https://claude.com/blog/the-new-rules-of-context-engineering-for-claude-5-generation-models?ref=t01.li) für seine neueste Modellgeneration („Claude 5“) überarbeitet. Die Kernbotschaft: weniger micromanagende Festlegungen im System-Prompt, mehr Zutrauen in die grundlegenden Fähigkeiten der Modelle und sauber strukturierte Interfaces. Statt Claude mit starren Verboten im Prompt einzuschränken oder Tools mit Dutzenden Beispielen zu überfrachten, setzt man jetzt auf präzise Tool-Beschreibungen und aussagekräftige Parameter-Namen. Zu viele Beispiele schränken den Explorationsraum des Modells inzwischen eher ein, als dass sie helfen. Anthropic will nach eigener Aussage über 80 % des Claude-Code-System-Prompts gestrichen haben – ohne messbare Einbußen in den Coding-Tests.
Beim Memory-Management gibt es ebenfalls Änderungen. Die bisherige Praxis, Projekt-Kontexte manuell in [CLAUDE.md-Dateien](https://t01.li/ai-dev/claude-md-best-practice-2026/) zu stopfen oder schlichte Markdown-Pläne bereitzustellen, weicht automatisierten Memory-Funktionen und reichhaltigeren Referenzen wie HTML-Artefakten oder echtem Code. Wer seine bestehenden Setups aufräumen will, bekommt mit `/doctor` ein Werkzeug an die Hand, das veraltete und doppelte Anweisungen aus System-Prompts, Skills und Projektdateien herausfiltert.
## Spark 4.2
Mit [Apache Spark 4.2](https://thenewstack.io/spark-4-2-ai-workloads/?ref=t01.li) versucht das Open-Source-Schwergewicht einmal mehr, spezialisierte Drittsysteme im Daten-Ecosystem obsolet in die Ecke zu stellen.
Das prominenteste Feature der neuen Version ist eine native Vektorsuche inklusive eingebauter Ähnlichkeitsfunktionen, Vektornormalisierung und dem neuen SQL-Operator `NEAREST BY`. [RAG](https://t01.li/glossar/#rag)\-Anwendungen und semantische Suchen lassen sich damit direkt auf dem Cluster abfackeln, was den typischen Extra-Aufwand spart, separate [Vektordatenbanken](https://t01.li/glossar/#vektor-datenbank) wie Qdrant oder Pinecone kontinuierlich mit Daten zu befüllen und synchron zu halten. Ob Spark bei Performance und Latenz mit den dedizierten Systemen mithalten kann, bleibt im echten Betrieb allerdings erst noch zu beweisen.
Unter der Haube dreht Spark 4.2 zudem an den Schrauben für PySpark-Entwickler. PySpark User-Defined Functions (UDFs) laufen ab sofort standardmäßig über den Apache-Arrow-Ausführungspfad, was den Datenaustausch zwischen JVM und Python ohne manuelle Code-Anpassungen beschleunigt. Kleiner Bonus am Rande: Über das Arrow C Data Interface wandern DataFrames jetzt ohne Kopieren direkt zu Polars oder DuckDB.
## AMD Launches Helios
Ihr habt gerade ein bisschen Platz im Serverraum, Geld und Strom übrig und wisst mit allen dreien nicht wohin? Dem kann jetzt Abhilfe geschaffen werden.
AMD hat das Rackscale-System [„Helios“ angekündigt](https://www.amd.com/en/blogs/2026/amd-launches-helios-the-highest-performing-rackscale-ai-infrastructure-solution.html?ref=t01.li), das als Antwort auf Nvidias NVL72-Racks platziert wird. Die Plattform kombiniert 72 AMD Instinct MI455X GPUs mit hauseigenen EPYC-„Venice"-CPUs der 6\. Generation und Pensando-Netzwerkkomponenten über eine UALoE-Fabric – macht in Summe 31 TB HBM4 und 2,9 ExaFLOPS FP4-Compute pro Rack. In den eigenen Vergleichen stellt AMD dem Hauptkonkurrenten Nvidia (Vera Rubin NVL72) die typischen prozentualen Vorsprünge gegenüber – darunter bis zu 15 % mehr AI-Compute und 50 % mehr HBM-Kapazität. Ob und wie sich die simulierten Durchsatzwerte bei realen Workloads bewahrheiten, sehen wir dann bei Drittmessungen von unabhängiger Stelle.
Und damit Schluss für diese Woche – bleibt wachsam, eure Sandboxes sind es offenbar nicht.
### Claude Opus 5: fast Fable-Niveau zum halben Preis – sagt Anthropic
URL: https://t01.li/ki-news/claude-opus-5-fast-fable-niveau-halber-preis/
Last updated: 2026-07-28T09:31:12.000Z
****Update vom 25.07.2026:** Artificial Analysis hat inzwischen erste unabhängige Messungen zu **Opus 5* veröffentlicht. Der Benchmark-Abschnitt, der Effort-Teil und die Einordnung sind entsprechend ergänzt – die ursprüngliche Feststellung, es lägen noch keine Drittmessungen vor, ist damit überholt.
Anthropic hat heute [*Claude Opus 5* veröffentlicht](https://www.anthropic.com/news/claude-opus-5?ref=t01.li) – das vierte Modell des Hauses in unter zwei Monaten, nach *Mythos 5*, *Fable 5* und *Sonnet 5*. Die Ansage: fast die Frontier-Intelligenz von *Fable 5*, zum halben Preis. Opus 5 wird das neue Default-Modell auf Claude Max und das stärkste Modell im Pro-Abo. Getestet habe ich noch nichts, da das Modell zu diesem Zeitpunkt erst wenige Stunden verfügbar ist. Der Praxis-Check folgt alsbald.
## TL;DR
Anthropic positioniert *Opus 5* als Alltagsmodell knapp unter der eigenen Frontier – die Kernpunkte:
- Ab sofort verfügbar, 5 $ / 25 $ pro Million Input- / Output-Tokens – Preis unverändert zum Vorgänger
- State-of-the-art-Claims auf Coding- und Knowledge-Work-Benchmarks – ausschließlich herstellereigene Werte
- Effort-Settings steuern das Verhältnis von Leistung zu Token-Verbrauch
- Bei Biologie und offensiver Cybersecurity bewusst hinter *Mythos 5*; Cyber-Classifier greifen laut Anthropic rund 85 % seltener als bei *Fable 5*
- Update: Artificial Analysis misst Platz 1 auf dem Intelligence Index (61 Punkte, *Fable 5*: 60) – bei 26 % Ersparnis pro Task
## Die Opus-5-Zahlen – und das Sternchen dran
Auf dem Papier liest sich das Release wie eine Machtdemonstration. Auf Frontier-Bench v0.1 verdoppelt *Opus 5* laut Anthropic die Leistung von [*Opus 4.8*](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/) bei geringeren Kosten pro Task, auf CursorBench 3.2 landet es bei maximalem Effort innerhalb von 0,5 % des Fable-5-Spitzenwerts – für die Hälfte des Preises. Auf ARC-AGI 3, einem [Benchmark](https://t01.li/glossar/#benchmark) für das Lösen unbekannter Probleme, soll der Score dreimal so hoch liegen wie beim nächstbesten Modell. Und auf OSWorld 2.0, einem Computer-Use-Benchmark, will *Opus 5* das beste Fable-5-Ergebnis für gut ein Drittel der Kosten übertreffen.
Beeindruckende Ansagen. Nur stammen sie ausnahmslos aus dem eigenen Haus, teils von internen Benchmarks, die niemand außerhalb von Anthropic im Augenblick veröffentlicht oder unter Umständen gar nachgemessen hat. Die Kunden-Zitate von Cursor, Zapier und Devin im Announcement sind kuratierte Launch-PR und ersetzen keine neutrale Messung, so glaubwürdig einzelne Beobachtungen darin auch klingen.
Inzwischen liegt die erste unabhängige Messung vor. [Artificial Analysis](https://artificialanalysis.ai/articles/opus-5?ref=t01.li) sieht *Opus 5* (max) mit 61 Punkten knapp an der Spitze des Intelligence Index – vor *Fable 5* (60), *GPT-5.6 Sol* (59) und *Kimi K3* (57), praktisch ein Gleichstand ganz oben. Deutlicher wird es bei agentischer Wissensarbeit: Auf GDPval-AA v2 liegt Opus 5 mit 1.861 Elo mehr als 100 Punkte vor Fable 5 und GPT-5.6 Sol, auf dem hauseigenen AA-Briefcase sind es 146 Punkte Vorsprung. Zwei Dämpfer stehen daneben. Die [gemessene Ersparnis pro Task](https://x.com/ArtificialAnlys/status/2080734447717298483?ref=t01.li) gegenüber Fable 5 beträgt 26 % – von der Halbierung aus dem Announcement bleibt gut die Hälfte übrig. Und flott ist das Ganze auch nicht, bei maximalem Effort vergeht im Schnitt über eine Minute bis zum ersten Token. Der Vollständigkeit halber – Artificial Analysis hatte Vorabzugang und hat Anthropic beim Pre-Release-Testing unterstützt.
## Der Effort-Regler als eigentliches Produkt
Interessanter als die Benchmark-Schlacht ist die Ökonomie dahinter. *Opus 5* kostet exakt so viel wie sein Vorgänger, und über den [Effort-Regler](https://t01.li/glossar/#reasoning-effort) lässt sich steuern, wie viele Tokens das Modell in eine Aufgabe steckt – von sparsam bis maximal. Anthropic behauptet, selbst auf der niedrigsten Stufe schlage Opus 5 auf Zapiers AutomationBench alle anderen Modelle. Herstellerwert, klar, aber die Stoßrichtung ist eindeutig.
Die Effort-Staffelung hat Artificial Analysis gleich mitgemessen. Der Intelligence Index klettert von 51 bei low über 56 bei medium und 59 bei high auf 61 bei max – medium liegt damit auf dem Niveau von *Opus 4.8* mit maximalem Effort. Der Regler tut also messbar, was er verspricht. Bestätigt ist nebenbei das [Kontextfenster](https://t01.li/glossar/#kontextfenster) von 1 Million Tokens, gleichauf mit dem Vorgänger.
Das ist eine direkte Antwort auf die Kritik der letzten Wochen. *Fable 5* fiel bei Business-Kunden nicht nur durch Leistung auf, sondern durch seinen Token-Hunger – [Fortune berichtet](https://fortune.com/2026/07/24/anthropic-debuts-claude-opus-5-with-feature-that-lets-users-toggle-between-cost-and-capability/?ref=t01.li) von Nutzern, die ihre Budgets in Rekordzeit durchgebrannt haben. Schon [*Sonnet 5* kam mit einem Token-Haken beim Preis](https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/), und seit [*Kimi K3* die Billig-Ära für beendet erklärt hat](https://t01.li/ki-news/kimi-k3-frontier-leistung-zum-frontier-preis-die-billig-ara-ist-vorbei/), konkurrieren die Anbieter weniger über den Listenpreis als über die Kosten pro erledigter Aufgabe. Genau auf dieser Achse positioniert Anthropic das neue Modell.
Wer es eilig hat, bekommt *Opus 5* im Fast mode mit etwa 2,5-facher Geschwindigkeit – zum doppelten Basispreis. Dazu kommen zwei Beta-Features auf der Claude Platform, die eher Entwickler freuen dürften: Tool-Wechsel mitten in der Konversation ohne Cache-Invalidierung und automatische Fallbacks, wenn Safety-Classifier einen Request blocken.
## Sicherheit mit eingebauter Arbeitsteilung
Bei den heiklen Fähigkeiten fährt Anthropic eine bewusste Zweiteilung. Opus 5 bleibt bei Biologie-Forschung und offensiver Cybersecurity hinter *Mythos 5* zurück – und das ist Absicht, kein Unfall. Auf Cyber-Aufgaben wurde das Modell gar nicht erst trainiert. Trotzdem ist es durch die allgemeine Leistungssteigerung beim *Finden* von Schwachstellen inzwischen fast auf Mythos-Niveau angekommen, während es beim Bauen von Exploits deutlich zurückliegt. Anthropic zeigt das an der eigenen OSS-Fuzz-Evaluation, und auch hier gilt das Sternchen.
Praktisch relevanter: Die Cyber-[Guardrails](https://t01.li/glossar/#guardrails) sollen rund 85 % seltener anschlagen als bei *Fable 5*. Geblockte Anfragen fallen in Claude.ai, Claude Code und Claude Cowork per Default auf *Opus 4.8* zurück, statt einfach zu scheitern. Nach dem Fable-5-Drama im Juni – [CNBC zufolge](https://www.cnbc.com/2026/07/24/anthropic-claude-opus-5-ai-fable-5-cost.html?ref=t01.li) musste Anthropic das Modell wegen einer Export-Control-Anordnung zeitweise vom Markt nehmen, [laut Fortune](https://fortune.com/2026/07/24/anthropic-debuts-claude-opus-5-with-feature-that-lets-users-toggle-between-cost-and-capability/?ref=t01.li) nachdem Amazon-Forscher die Safeguards umgangen hatten – wirkt diese Vorsicht weniger wie Prinzipienreiterei und mehr wie gelernte Lektion.
## Einordnung
Die eigentliche Geschichte dieses Releases ist nicht technisch, sondern ökonomisch. Anthropic sortiert sein Portfolio in zwei Rollen – *Fable 5* als Frontier für die harten, tagelangen Autonomie-Jobs, Opus 5 als Arbeitstier für alles andere. „Designed to be used every day" steht wörtlich im Announcement, und das ist als Positionierung ernst zu nehmen. Der Wettbewerb verschiebt sich von „wer hat das klügste Modell" zu „wer erledigt die Aufgabe zum niedrigsten Preis", und auf diesem Feld tritt Opus 5 mit unverändertem Listenpreis und aggressiven Kosten-pro-Task-Claims an.
Die ersten unabhängigen Zahlen bestätigen die Richtung – Platz 1 auf dem Intelligence Index, klarer Vorsprung bei agentischer Wissensarbeit, aber eben 26 % Ersparnis pro Task statt der suggerierten Hälfte. Was jetzt noch fehlt, ist der Alltag in echten Pipelines. Beim Vorgänger passte die Selbstbeschreibung am Ende erstaunlich gut zur Realität – hier stimmt zumindest die Tendenz schon wieder.
Vorläufiger Take: Ein Modell, das Fable-Leistung zum Opus-Preis verspricht und nebenbei den Token-Frust der eigenen Kundschaft adressiert, ist strategisch das klügste Release dieser Serie. Ich teste, sobald ich dazu komme – immerhin stammen die hübschen Charts inzwischen nicht mehr nur vom Hersteller.
### Obsidian und MCP: Claude Code, Codex und Antigravity Zugriff auf den Vault geben
URL: https://t01.li/kein-ki/obsidian-mcp-claude-code-codex-antigravity/
Last updated: 2026-07-22T05:16:02.000Z
Teil 4 der Obsidian-Serie – und der Teil, in dem das [Second Brain](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/) Gesellschaft bekommt. Mittels des Community-Plugins [*Local REST API for Obsidian*](https://github.com/coddingtonbear/obsidian-local-rest-api?ref=t01.li) lässt sich *Obsidian* mit einem [MCP-Server](https://t01.li/glossar/#mcp) verheiraten, der der KI deiner Wahl den Weg in deinen Vault öffnet. Lesen, schreiben, suchen, Frontmatter pflegen – alles, was du sonst per Hand machst, kann ein Agent über MCP-Tools erledigen. Was du dafür brauchst, wo die Fallstricke liegen und warum deine CLAUDE.md keine Sicherheitsgarantie ist, klären wir jetzt.
## TL;DR
Das Plugin *Local REST API* bringt inzwischen einen eigenen MCP-Server mit – Third-Party-Server brauchst du für den Standardfall nicht mehr.
- Hauptweg: Plugin installieren, MCP-Client auf `https://127.0.0.1:27124/mcp/` zeigen lassen, fertig
- Alternativen für Spezialfälle: cyanheads (echte Ordner-Permissions), mcpvault (ganz ohne Plugin)
- Eine Agent Instruction File regelt das Verhalten – ist aber kein Guardrail, sondern ein doppelter Boden
- Fallback: das offizielle Obsidian CLI, seit Februar 2026 für alle kostenlos dabei
## Das Pflicht-Plugin – inzwischen mit MCP-Server ab Werk
[*Local REST API*](https://github.com/coddingtonbear/obsidian-local-rest-api?ref=t01.li) ist das Herzstück der ganzen Geschichte. Das Plugin stellt eine authentifizierte HTTPS-Schnittstelle zu deinem Vault bereit – und heißt mittlerweile offiziell „Local REST API with MCP“, weil es in den aktuellen Versionen (Stand Juli 2026) gleich einen eigenen MCP-Server mitliefert. Der läuft direkt in *Obsidian*, hat Zugriff auf Live-Metadaten, die aktive Datei, Periodic Notes und die Command Palette, und lauscht unter `https://127.0.0.1:27124/mcp/` per Streamable HTTP. Authentifiziert wird mit dem API-Key aus den Plugin-Settings als Bearer-Token.
Das Repo selbst formuliert es unmissverständlich: Third-Party-MCP-Server existieren zwar weiterhin, seien aber „no longer necessary“ – wer noch einen nutzt, bekomme mit dem eingebauten voraussichtlich bessere Ergebnisse. Für den Standardfall ist der Weg also kurz. Plugin installieren, API-Key kopieren, MCP-Client auf den Endpoint zeigen lassen. Kein zusätzliches npm-Paket, kein separater Prozess.
Ich selbst komme von einer älteren Plugin-Version und fahre darum noch die Third-Party-Variante – absehbar wechsle ich aber auf den mitgebrachten Server. Der bringt alle Tools mit, die man im Alltag braucht, und spart einen kompletten Baustein im Setup. Was er nicht mitbringt, sind die ordnerbasierten Permissions von cyanheads – aber in meinem Vault liegt ohnehin nichts, das diese Schutzebene bräuchte (dazu weiter unten mehr).
## Third-Party-MCP-Server – wann sie noch Sinn ergeben
Ganz obsolet sind die separaten Server trotzdem nicht, sie haben nur ihre Nische gewechselt – von Pflicht zu Spezialwerkzeug.
- [**mcp-obsidian**](https://github.com/MarkusPfundstein/mcp-obsidian?ref=t01.li) hat das Nötigste, was man benötigt, wird gepflegt und ist etabliert. Setzt das Local-REST-API-Plugin voraus.
- [**obsidian-mcp-server**](https://github.com/cyanheads/obsidian-mcp-server?ref=t01.li) von cyanheads ist meine erste Wahl, nachdem das [lange populärste MCP-Plugin eingestellt wurde](https://github.com/jacksteamdev/obsidian-mcp-tools?ref=t01.li) – dazu gleich mehr. Vierzehn Tools, gut dokumentiert, und mit einem Feature, das die anderen nicht haben: ordnerbasierte Read/Write-Permissions über Environment-Variablen plus ein globaler Read-only-Schalter. Warum das mehr ist als ein nettes Detail, klären wir beim Thema Instruction Files.
- [**mcpvault**](https://github.com/bitbonsai/mcpvault?ref=t01.li) spielt in einer eigenen Kategorie: Es braucht das REST-API-Plugin gar nicht, sondern liest dein Vault-Verzeichnis direkt im Dateisystem. *Obsidian* muss dafür nicht einmal laufen. Gut dokumentiert, umfangreiches Toolset, von mir bisher nicht ausprobiert – aber ein etabliertes Projekt, das aktiv gepflegt wird.
Und das erwähnte eingestellte Plugin? [*MCP Tools for Obsidian*](https://github.com/jacksteamdev/obsidian-mcp-tools?ref=t01.li) war mit 87.000 Installationen das populärste MCP-Plugin im Community-Store, bis der Maintainer das Repo im Mai 2026 archivierte. Seine Begründung ist erfrischend ehrlich – er nutzt *Obsidian* schlicht nicht mehr und überlässt das Feld Entwicklern, die im Ökosystem zuhause sind. So sieht ein sauberer Abgang aus. Kein stilles Verrotten, kein „Maintenance Mode“ als Euphemismus.
## Einrichtung in Obsidian
Du kannst die CLI oder das Desktop-Tool deiner Wahl bitten, die Einrichtung einfach für dich zu übernehmen – schreib den Link zum jeweiligen Repo (oder beim eingebauten Server den MCP-Endpoint) mit in den Prompt. Den Token findest du in den Settings des Local-REST-API-Plugins. Ein Rat aus der Praxis – lass *Antigravity*, *Codex* oder *Claude Code* den MCP-Eintrag erst einmal mit einem Platzhalter als Token erzeugen und füge den richtigen Token anschließend per Editor selbst ein. Dein API-Key hat im Chatverlauf eines Frontier-Modells nichts verloren.
Ansonsten legst du den entsprechenden Eintrag auch in den jeweiligen Settings schnell selbst an. Die genaue Konfiguration unterscheidet sich je nach gewähltem Weg ein wenig, ein Blick in die Doku ist Pflicht.
Kurzer Einschub zu *Antigravity*: Falls du dich wunderst, wo Gemini CLI geblieben ist – Google hat es im Juni 2026 [für Consumer-Accounts abgeschaltet](https://developers.googleblog.com/an-important-update-transitioning-gemini-cli-to-antigravity-cli/?ref=t01.li) und durch Antigravity CLI ersetzt. Gleiche Aufgabe, neues Binary, `agy` statt `gemini`.
### Agent Instruction File
Hier mal exemplarisch meine CLAUDE.md:
```markdown
# CLAUDE.md
Guidance for Claude (Code, Desktop, CLI) when working with this Obsidian vault.
## Overview
This is an Obsidian vault using a PARA-inspired folder structure for knowledge management.
## AI Access Control (CRITICAL)
Before processing any file, check `ai` field in frontmatter:
- `ai: not allowed` → Do not read/edit/index. Treat as non-existent.
- `ai: index allowed` → Read and use as context, but **never** edit.
- `ai: all allowed` → Full permissions (read, index, edit).
- Missing/empty `ai` field → Treat as `not allowed` by default.
## Folder Structure
| Folder | Purpose |
| -------------- | ------------------------------------ |
| `0 Inbox` | Incoming notes |
| `1 Projekte` | Active projects |
| `2 Bereiche` | Concepts and thoughts |
| `3 Ressourcen` | Reference materials and brand assets |
| `4 Archiv` | Completed/inactive items |
| `5 System` | Templates, FileClasses, AI prompts |
### Folder-Specific Permissions
| Folder | Default `ai` value | Write Permission |
| ------------- | ------------------ | ---------------------------------------------------------- |
| `0 Inbox` | `all allowed` | Yes (no restrictions, just ask before deleting content) |
| `1 Projekte` | `all allowed` | Yes (ask before deleting or restructuring content) |
| `2 Bereiche` | `all allowed` | Yes (ask before deleting or restructuring content) |
| `3 Ressourcen` | `all allowed` | Yes (ask before deleting or restructuring content) |
| `4 Archiv` | `index allowed` | ❌ Read-only |
| `5 System` | `index allowed` | ❌ Read-only |
## Frontmatter Schema
All notes use this metadata structure (defined in `5 System/FileClasses/Standard.md`):
---
type: concept | shortnote | ressource | project | MOC
domain: Business | Blog | Dev | Other
status: seedling | in progress | completed | evergreen | archived
created: [handled by Linter Plugin]
updated: [handled by Linter Plugin]
ai: all allowed | index allowed | not allowed
tags: [tag1, tag2, etc.]
---
## Writing Files
- NEVER write to files with `ai: not allowed` or `ai: index allowed`
- ALWAYS use appropriate template from `5 System/Templates/`
- ALWAYS set correct frontmatter based on folder context
- Ask for confirmation before creating new files
### Naming Conventions
- **File Names:** Use the note's title as filename
- **MOCs:** Prefix with `_Dashboard` (e.g., `_Dashboard AI Research.md`)
- **No special characters:** Avoid /, \, :, " in filenames
- **Spaces allowed:** Use spaces for readability (e.g., `Prompt Engineering.md`)
- **Case:** Use proper capitalization (Title Case or sentence case)
### Linking & Relationships
- **Wiki-Links:** Use contextual `[[wikilinks]]` to connect new notes to existing relevant notes.
```
„AI Access Control (CRITICAL)“ regelt, was die KI tun darf. Das darf man nicht falsch verstehen: Das sind KEINE Guardrails. Wenn du der KI sagst, lösche oder bearbeite die Notiz, wird sie dich im besten Fall vorwarnen und noch mal nachfragen – es danach aber trotzdem tun, egal ob da „not allowed“ steht. Das Ganze ist ein doppelter Boden, und immerhin fragt die KI dich so vorher, weil es in der Instruction steht. Gleiches gilt für die „Folder Write Permission“.
Wer echte Guardrails will, muss eine Ebene tiefer ansetzen. Genau da wird der cyanheads-Server interessant – dessen ordnerbasierte Permissions und der Read-only-Schalter greifen auf Server-Ebene, bevor das Modell überhaupt einen Schreibzugriff absetzen kann. Eine Instruction kann ein Modell ignorieren. Einen 403 vom Server nicht.
Die „Folder Structure“ liefert, welcher Ordner im Vault wofür gedacht ist, das „Frontmatter Schema“ den Head mit den Meta-Daten der Datei – das hatte ich in einem [eigenen Beitrag aufgedröselt](https://t01.li/kein-ki/obsidian-vault-organisieren-frontmatter-templates-und-dataview/). Alles, was danach noch kommt, sind spezifische Anweisungen für den Vault. Wie bei allen [Agent Instruction Files](https://t01.li/glossar/#agentic-instruction-file) solltest du dich so kurz wie möglich halten, weil davon alles ins [Kontextfenster](https://t01.li/glossar/#kontextfenster) wandert – immer, in jeder Session.
## Das kann es
Ich beschränke mich auf meine Erfahrungen mit *Claude Code* und *Antigravity* (vorher Gemini CLI) bzw. *Gemini*, da ich *Codex* dafür bisher schlicht nicht genutzt habe.
Du legst ein Projekt an (eigentlich ergibt in diesem Kontext nur der Vault-Ordner dafür Sinn) und legst dort die spezifisch angepasste Agent Instruction File ab. Ich empfehle dringend, das manuell zu tun und nicht einfach eine Datei über `/init` erzeugen zu lassen – was das Tool dabei zusammenschreibt, kennt weder deine Ordnerlogik noch deine Frontmatter-Regeln.
Wenn der MCP korrekt eingerichtet ist, steht dir alles zur Verfügung, was an Tools da ist.
Den ganzen Spaß nutze ich u. a. dafür, um meine notorisch zu volle Inbox einer Triage zu unterziehen – „Zeig mir alle Notizen aus 0 Inbox, die älter als X Tage sind, und fasse jede in zwei Sätzen zusammen.“ Oder auch, um ähnliche oder verwandte Einträge zusammenzulegen, sofern das Sinn ergibt. Beim Aufspüren von Zusammenhängen leistet die Anbindung ebenfalls gute Arbeit, etwa um Notizen sinnvoll untereinander zu verlinken und/oder zu verschlagworten. Der Hauptfokus in meinem Fall ist aber der Inbox-Ordner.
## Fallback oder Alternative: das offizielle Obsidian CLI
Wenn du auf den MCP verzichten möchtest oder einen Fallback brauchst – *Obsidian* [verfügt seit Februar 2026 über ein offizielles Command Line Interface](https://obsidian.md/cli?ref=t01.li). Erst als Early-Access-Feature in Version 1.12.0, seit 1.12.4 ohne separaten Download für alle Desktop-Nutzer an Bord. Alles, was in der App geht, funktioniert auch im Terminal – inklusive einer richtig guten Suche über den gesamten Vault.
Der entscheidende Unterschied zu den Community-CLIs, die vorher diese Lücke füllten: Das offizielle CLI läuft durch Obsidians Runtime – dieselbe Logik, die auch in der App arbeitet. Ein `move` aktualisiert interne Links (sofern in den Vault-Einstellungen aktiviert), `create` zieht deine Templates korrekt, und Frontmatter wird als valides YAML geschrieben statt als Textwurst. Der Index bleibt dabei konsistent, nichts kollidiert mit laufenden Plugins.
Du musst *Antigravity*, *Codex* oder *Claude Code* natürlich noch mitteilen, dass sie das [CLI](https://t01.li/glossar/#cli) benutzen dürfen bzw. sollen und in welchen Fällen. Ein Absatz in der Instruction File genügt.
## Der Datenschutz- und Sicherheitsaspekt
*Obsidian* hat das schöne Feature des „local first“ – sprich, meine Daten liegen auf meinem System. Diese Souveränität gebe ich auf, wenn ich eine KI an meinen Vault hänge.
Wenn du einem [Frontier-LLM](https://t01.li/glossar/#llm) Zugriff auf deinen Vault gibst (und sei es nur lesend), musst du im Hinterkopf behalten, dass du damit auch die Inhalte des Vaults an den jeweiligen Anbieter weitergibst. Das muss nicht datenschutzrechtlich relevant sein, kann es aber, sobald du mit persönlichen Daten oder Kundendaten in *Obsidian* hantierst. Gleiches gilt für spezifische Projektdaten, die z. B. unter NDA stehen.
Pragmatische Lösung: Mein Vault ist [ein Second Brain und meine Knowledge Base](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/) – da gehören im Regelfall ohnehin keine Daten rein, die datenschutzrechtlich in irgendeiner Form relevant sind. Und für sicherheitskritische Daten brauche ich das ohnehin niemandem erzählen: Denn im Zweifelsfall hast du dafür einen eigenen, separaten Vault und lässt die KI dort draußen – so einfach.
Eine Randnotiz noch, weil sie in dieselbe Kerbe schlägt. Das Local-REST-API-Plugin hat kürzlich eine Path-Traversal-Lücke geschlossen, über die authentifizierte Anfragen aus dem Vault ausbrechen und beliebige Dateien auf dem Host lesen oder schreiben konnten. Der Fix ist da, die Lehre auch – wer eine API zu seinem Dateisystem betreibt, hält das Plugin aktuell. Ausnahmslos.
### Beiträge der Serie
- [Obsidian – mein digitales Gehirn, und warum ich nie wieder zurück möchte](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/)
- [Obsidian-Vault organisieren: Frontmatter, Templates und Dataview](https://t01.li/kein-ki/obsidian-vault-organisieren-frontmatter-templates-und-dataview/)
- [Obsidian-Inbox automatisieren: n8n, Telegram und KI](https://t01.li/kein-ki/obsidian-inbox-automatisieren-n8n/)
### AI Picks der 29. KW
URL: https://t01.li/ai-shorts/ai-picks-der-29-kw/
Last updated: 2026-08-07T09:44:20.000Z
Auch diese Woche kein Sommerloch, dafür wieder reichlich neue Modelle, inklusive [*Kimi K3*](https://t01.li/ki-news/kimi-k3-frontier-leistung-zum-frontier-preis-die-billig-ara-ist-vorbei/) – das hatten wir schon separat abgehakt. Ansonsten so? Microsoft wirft der Konkurrenz Doppelmoral vor (eigentlich ein Thema für sich), Sicherheitsforscher drehen den Spieß bei Prompt Injections um, und die üblichen Verdächtigen melden sich ohnehin im Wochentakt. Langweilig wird uns im Sommer also nicht. Serviert werden hiermit, eiskalt, die Picks der 29\. Kalenderwoche.
## AutoMem teaches AI to actually remember
Stanford-Forschende haben mit [*AutoMem*](https://qudata.com/en/news/automem-teaches-ai-to-actually-remember/?ref=t01.li) ein Framework entwickelt, das KI-Modellen strategisches Erinnern und Vergessen als erlernbare Fähigkeit beibringt. Statt das [Kontextfenster](https://t01.li/glossar/#kontextfenster) stumpf zu vergrößern, steuert der Agent seine Speicherstruktur über zwei Optimierungsschleifen selbst – Lesen, Schreiben, Suchen und Anhängen werden zu ganz normalen Handlungen neben den eigentlichen Task-Aktionen. Das Ergebnis kann sich sehen lassen. In drei Langzeit-Benchmarks (Crafter, MiniHack, NetHack) stieg die Leistung der Agenten um das Zwei- bis Vierfache, ohne dass die Task-Fähigkeiten des Modells angefasst wurden. Ein offenes *Qwen2.5-32B* erreichte damit das Niveau von *Claude Opus 4.5* oder *Gemini 3.1 Pro Thinking* – zumindest in diesen Umgebungen.
Memory-Management als eigenständige, trainierbare Disziplin neben Reasoning und Tool-Use. Das dürfte man in den kommenden Monaten noch öfter hören.
## Now, defenders are embracing the prompt injection, too
Sicherheitsforschende von Tracebit haben einen pragmatischen Weg gefunden, [Prompt Injections](https://t01.li/glossar/#prompt-injection) [im Verteidigungsfall einzusetzen](https://arstechnica.com/security/2026/07/now-defenders-are-embracing-the-prompt-injection-too/?ref=t01.li). Unter dem Namen „Context Bombing“ platzieren sie gezielt präparierte Prompts direkt neben sensiblen Ködern – etwa Passwörtern oder API-Schlüsseln – in AWS-Umgebungen. Stößt ein autonomer AI-Hacking-Agent bei seinem Angriff auf diese Daten, liest er den Prompt mit. Der triggert die harten [Sicherheits-Guardrails](https://t01.li/glossar/#guardrails) des zugrundeliegenden LLM (bei westlichen Modellen etwa Biowaffen-Content, bei chinesischen eher politisch sensible Trigger) und provoziert eine sofortige Verweigerung. Der Agent bricht ab.
In den Tests über 152 Angriffsläufe und fünf Modelle hinweg zeigte das Konzept spürbare Wirkung gegen automatisierte LLM-Angriffe:
- **Sicherheitsgewinn:** Die Quote vollständiger Admin-Übernahmen sank von 57 % auf 5 %, komplette Kompromittierungen fielen von 36 % auf 1 %.
- **Modellspezifischer Impact:** Das stärkste getestete Modell, *Opus 4.8*, kam ohne Kontextbombe in 93 % der Läufe an Admin-Rechte – mit ihr scheiterte es in jedem einzelnen Durchlauf.
Natürlich ist das kein Allheilmittel gegen menschliche Angreifer, die ihre AI-Pipelines gezielt filtern. Aber es ist eine verdammt günstige Hürde gegen das unaufhaltsame Grundrauschen automatisierter KI-Angriffe.
## Microsoft wirft KI-Unternehmen Doppelmoral vor
Microsoft-Chef Satya Nadella [kritisiert die Konkurrenz für eine ziemliche Doppelmoral bei Trainingsdaten](https://www.all-ai.de/news/news26/microsoft-ki-doppelmoral?ref=t01.li). Große KI-Anbieter wie OpenAI nutzen für ihre Modelle fleißig öffentlich zugängliche Daten unter dem Deckmantel des Fair-Use-Prinzips, verbieten ihren Kunden im Gegenzug aber strikt, aus den generierten Ausgaben eigene, lokale Modelle abzuleiten. Nadella nennt das ein „umgekehrtes Informationsparadoxon“ – Unternehmenskunden zahlen für die Technologie, während ihr Firmenwissen über Prompts, Workflows und Korrekturen unbemerkt in die Cloud-Infrastruktur der Betreiber abwandert.
Die Kritik kommt allerdings mit einem gewohnt strategischen Beigeschmack. Microsoft positioniert sich im selben Atemzug als vermeintlicher Retter, der genau für dieses Dilemma geschützte, firmeninterne Lernumgebungen fürs Modelltraining bereitstellen will. Nadella fordert zusammen mit Palantir-Chef Alex Karp ein Recht auf volle Kontrolle über eigene Daten und Modellausgaben, damit das geschäftskritische Know-how der Firmen nicht bei den Infrastruktur-Monopolisten landet.
Microsoft und Palantir, das musste ich auch mental erst einmal verarbeiten.
## Soofi
Das deutsche Konsortium um den KI Bundesverband hat den [Pretraining-Report für *Soofi S* (30B-A3B) vorgelegt](https://huggingface.co/spaces/Soofi-Project/Pretraining-Tech-Report?ref=t01.li) – ein staatlich mit rund 20 Millionen Euro gefördertes, in München trainiertes Sprachmodell. Unter der Haube steckt diesmal kein generischer Llama-Klon, sondern ein Hybrid aus Mamba-2 und [Mixture-of-Experts (MoE)](https://t01.li/glossar/#moe). Ganz ehrlich muss man dazusagen: Selbst entworfen ist die Architektur nicht, das Konsortium übernimmt Nvidias Nemotron-3-Nano-Referenzdesign unverändert. Das Eigenständige steckt im Trainingsrezept – bewusst hochgewichtetes Deutsch, offene Datenpipeline, komplette Dokumentation. Rechnerisch geht das Konzept auf, denn nur 6 der 52 Layer schleppen einen klassischen KV-Cache mit, der Speicherbedarf bleibt selbst bei langen Kontexten klein und der Durchsatz hoch. In den Benchmarks des Reports schlägt sich der zweisprachige (Deutsch/Englisch) Kandidat als stärkstes vollständig offenes Modell und zieht an *Olmo 3 32B* und *Apertus 70B* vorbei, gegen modernere Architekturen wie *Qwen3.5* verliert er weiterhin. Da es sich um ein reines Base-Modell ohne Alignment handelt, taugt der Release ohnehin nur für Entwickler, die eigene [Feintunings](https://t01.li/glossar/#fine-tuning) aufsetzen wollen – und aktuell ist das Ganze [auf Hugging Face](https://huggingface.co/collections/Soofi-Project/soofi-s-beta-models?ref=t01.li) auch nur eine gated Preview.
Technische Eckdaten:
- **Parameter:** 31,6 Mrd. gesamt, ca. 3,2 Mrd. aktiv pro Token (128 Experten, 6 aktiv)
- **Architektur:** Hybrid aus Mamba-2 / MoE / GQA nach Nemotron-3-Nano-Vorlage (52 Layer, davon 23 Mamba-2, 23 MoE, 6 GQA)
- **Pretraining-Daten:** rund 26,68 Billionen Token (bis zu 15,3 % deutscher Anteil)
- **Kontextfenster:** bis zu 1 Mio. Token
- **Infrastruktur:** trainiert auf Nvidia B200 GPUs in der Telekom-Cloud
Schön, dass wir mal etwas für die digitale Souveränität tun, aber die Software ist nur der eine Teil vom Kuchen. Und noch mehr würde ich ein echtes europäisches Projekt begrüßen, das die Kompetenzen über Deutschland hinaus bündelt – die hiesigen Unis von Darmstadt bis Würzburg sitzen ja bereits im Konsortium. Aber [Soofi](https://www.soofi.info/?ref=t01.li) ist ein Anfang und ein Schritt in die richtige Richtung.
## Inkling: Our open-weights model
Mit [*Inkling*](https://thinkingmachines.ai/news/introducing-inkling/?ref=t01.li) wirft das Thinking Machines Lab von Ex-OpenAI-CTO Mira Murati sein erstes [Open-Weights-Modell](https://t01.li/glossar/#open-weights) in den Ring, positioniert als klassischer, breiter Generalist und ausdrücklich nicht als Benchmark-König einer einzelnen Disziplin. Die technische Basis ist ein Mixture-of-Experts-Transformer mit stattlichen 975 Milliarden Parametern insgesamt, wovon 41 Milliarden aktiv genutzt werden. Der Kontext liegt bei bis zu 1 Million Token, trainiert wurde auf 45 Billionen Token aus Text, Bildern sowie Audio- und Videodaten. Ergänzt wird die Veröffentlichung durch eine Vorschau auf *Inkling-Small*, ein kleineres Modell mit 276 Milliarden Parametern total und 12 Milliarden aktiven. Die vollen Gewichte liegen [auf Hugging Face](https://huggingface.co/thinkingmachines/Inkling?ref=t01.li), Fine-Tuning läuft über die hauseigene Tinker-Plattform – und genau da liegt auch das Geschäftsmodell.
## Announcing Bonsai 27B
PrismML versucht mit [*Bonsai 27B*](https://prismml.com/news/bonsai-27b?ref=t01.li) – einem auf *Qwen3.6 27B* basierenden Modell – den klassischen Hardware-Flaschenhals lokaler LLMs zu knacken. Durch aggressive [Quantisierung](https://t01.li/glossar/#quantisierung) schrumpft das Modell in zwei extreme Ausführungen. Die Ternary-Variante kommt mit 1,71 Bit pro Parameter aus (5,9 GB laut Pressemeldung – das real ausgelieferte GGUF-Paket liegt bei rund 7,2 GB), die noch drastischere 1-Bit-Version mit effektiv 1,125 Bit und 3,9 GB soll sogar auf einem iPhone 17 Pro laufen. Die herstellereigenen Benchmarks versprechen im „Thinking Mode“ sportliche 95 % (Ternary) bzw. 90 % (1-Bit) der FP16-Originalleistung – ein Wert, den man angesichts des massiven Gewichtsverlusts traditionell mit einer gesunden Portion Skepsis lesen darf.
In der Praxis kommt das Release mit einer Mischung aus ambitionierten Specs und handfesten Software-Hürden an. Beide Varianten setzen derzeit [die hauseigenen Forks von PrismML](https://docs.prismml.com/get-started/introduction?ref=t01.li) voraus (llama.cpp für CUDA/Metal, MLX für Apple Silicon), Mainline-Support gibt es bisher nicht. Die nackten Zahlen im Überblick:
- **Architektur & Kontext:** multimodales Vision-Modell mit vollem 262K-Kontextfenster und Speculative Decoding
- **Ressourcen-Schonung:** ein 4-Bit KV Cache drückt den RAM-Bedarf bei langen Kontexten weiter – das volle 262K-Fenster passt damit in unter 13 GB
- **Performance-Realitätscheck:** Die offiziellen Durchsatz-Messungen stammen ausnahmslos von Apple Silicon und Nvidia-GPUs. Für gewöhnliche x86-CPUs ohne Beschleunigung für Ternary-Matrizen gibt es bislang nur Community-Basteleien am Kernel-Code – dort verpufft der theoretische Gewinn im Alltag noch.
## Neue Claude Code Artifacts Features
Artifacts in *Claude Code* lassen sich [nun auch öffentlich teilen](https://x.com/ClaudeDevs/status/2076789349145092230?ref=t01.li), und mehrere Team-Mitglieder können gemeinsam daran arbeiten – inklusive Erstellung über den Claude Tag in Slack.
Außerdem können die Artifacts [jetzt MCP-Konnektoren aufrufen](https://x.com/ClaudeDevs/status/2077489907350856038?ref=t01.li) und sich damit bei jedem Aufruf frische Daten ziehen, statt einen statischen Snapshot anzuzeigen. Die Einschränkung dabei: Mit öffentlich geteilten Artifacts funktioniert das nicht. Verfügbar ab dem Pro-Plan.
## Claude Fable 5 will be included in all Max and Team
Anthropic macht dann mal die Rolle rückwärts: [*Fable 5* wandert ab dem 20\. Juli fest in alle Max- und Team-Premium-Tarife](https://x.com/claudeai/status/2078302415804379218?ref=t01.li). Die zu erwartende Einschränkung liefert Anthropic gleich mit, denn Fable gibt es dort für 50 % der Nutzungslimits. Pro- und Team-Standard-Nutzer bleiben bei den Credits und bekommen als Trostpflaster einmalig 100 $ gutgeschrieben.
[The Decoder weist auf den Haken hin](https://the-decoder.com/anthropic-slashes-claude-fable-5-limits-in-max-and-team-premium-and-pushes-pro-users-toward-api-pricing/?ref=t01.li): Am selben Tag endet die Bonus-Phase und die regulären Limits sinken um rund ein Drittel – die 50 % beziehen sich also auf bereits gekürzte Kontingente. Und der Zeitpunkt des Sinneswandels dürfte kein Zufall sein, seit *GPT-5.6 Sol* vergleichbare Leistung zu einem Drittel des Preises liefert, wäre ein 200-$-Abo ohne das beste Hausmodell schwer zu verkaufen gewesen.
## Google Gemini 3.5 launch verspätet sich
Google hängt beim Release von *Gemini 3.5 Pro* laut [einem Bloomberg-Bericht](https://www.bloomberg.com/news/articles/2026-07-16/google-gemini-launch-delayed-as-tech-falls-short-of-internal-goals?ref=t01.li) Monate hinter dem eigenen Zeitplan – Sundar Pichai hatte das Flaggschiff auf der I/O noch für Juni angekündigt. Der Grund liegt vor allem bei den Coding-Fähigkeiten – da hängt man wohl ein wenig hinter der direkten Konkurrenz. Ein Trainingsdaten-Update Ende Juni verfehlte die intern gesteckten Performance-Ziele, [berichtet Reuters unter Berufung auf Bloomberg](https://www.reuters.com/business/google-gemini-launch-delayed-tech-falls-short-internal-goals-bloomberg-news-2026-07-16/?ref=t01.li); parallel testet Google ein aktualisiertes Flash-Modell mit Partnern. Zehn aktuelle und ehemalige Mitarbeiter beschreiben wachsende Frustration im Konzern, zumal konkurrierende Teams von DeepMind bis Cloud jeweils eigene AI-Coding-Tools bauen und sich dabei wohl intern um Rechenkapazität prügeln. Und das ist noch das Lustige an der Meldung.
Am Vorsprung bei den günstigen Arbeitstier-Modellen ändert das erstmal wenig. Aber an der Spitze läuft Google gerade hinterher, und das weiß man dort offenbar selbst am besten.
## LiteParse Desktop
LlamaIndex liefert neben Vercel ja regelmäßig Interessantes auf GitHub ab – so auch dieses Mal.
[*LiteParse Desktop*](https://github.com/run-llama/liteparse-desktop?ref=t01.li#liteparse-desktop) ist eine Desktop-Anwendung zum Parsen von PDF-Dokumenten in strukturiertes Markdown oder JSON mit Bounding-Boxes. Mit Drag-and-Drop, Side-by-Side-Prüfung gegen die Originalseite und einigen anderen Features. Das Parsing läuft komplett lokal über die hauseigene Rust-Crate, ohne Netzwerk-Calls. Zum Betrieb brauchst du Node, pnpm, Rust und die Tauri-Voraussetzungen auf deiner Kiste.
## LogWerk 1.3.0
Mein eigenes [kleines Projekt](https://t01.li/geo-seo/logwerk-weil-ich-nur-sehen-wollte-welche-bots-den-log-vollmullen/) hat seit der letzten Erwähnung ein paar neue Features bekommen:
- System- oder manuell gesteuerter Light/Dark-Mode – damit gibt es nun auch ein helles Interface (Version 1.3.0)
- Die Bot-Erkennung wurde um eine Handvoll spezifischer KI-Bots erweitert, z. B. OAI-SearchBot, Perplexity-User, Bytespider und cohere-ai (kam mit 1.2.1)
Und es gibt jetzt [eine Live-Demo](https://abbottis.github.io/logwerk/?ref=t01.li) mit anonymisiertem Beispiel-Log – direkt im Browser, der [Quellcode liegt auf GitHub](https://github.com/abbottis/logwerk?ref=t01.li).
## How to use GPT-5.6 (mit Codex)
Das mit [den drei GPT-5.6-Modellen](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) trägt nicht gerade zur allgemeinen Klarheit bei, was man denn nun wofür nutzen soll – die Unverbesserlichen (viel hilft viel) schießen eben mit *Sol* im Anschlag auf alles, was sich bewegt. [Ben Tossell fährt Codex](https://www.bensbites.com/p/how-to-use-gpt-56?ref=t01.li) nach eigener Aussage aktuell mit *Sol* Medium für den Bau- und Kreativkram, *Luna* Extra High für die Alltagsproduktivität, und die richtig harten Aufgaben wandern bei ihm in Background Agents. Vom Ultra-Modus rät er durch die Blume eher ab, da das Budget saugt, wie die Mücken Blut in lauen Sommernächten – zum ersten Mal überhaupt sei er in Codex fast ins Usage-Limit gelaufen.
Thibault „Tibo“ Sottiaux [empfiehlt auf X](https://x.com/thsottiaux/status/2075581430055493909?ref=t01.li), *Sol* Medium als Daily Driver zu nehmen und für wirklich harte Probleme auf Extra High zu schalten. Ultra nennt er „a beast“ – für alle, die keine Angst haben, ihre Usage durchzubrennen. Nicht vergessen, das kommt von jemandem, der für die Bude arbeitet. Mit anderen Worten: Wenn ihr Tokens mit dem fetten Modell auf Ultra verheizt, profitiert in erster Linie OpenAI davon.
## GPT-5.6 Sol schießt ein wenig quer
Ist definitiv kein Massenphänomen, aber [t3n berichtet von einigen Vorfällen](https://t3n.de/news/gpt-5-6-sol-loescht-datenbanken-1752908/?ref=t01.li), bei denen *Sol* ein wenig, na ja, sagen wir mal, übereifrig war.
Einer der Betroffenen ist Matt Shumer, Gründer und CEO von OthersideAI (der Firma hinter *HyperWrite*). Nachdem *Sol* im Vollzugriff-Modus fast seinen kompletten Mac leergeräumt hatte – Auslöser war ein falsch aufgelöster Shell-Variablen-Fehler samt rekursivem Löschbefehl –, meldete das Modell brav „Ich habe einen ernst zu nehmenden Datenverlust verursacht.“ Immerhin ehrlich. Entwickler Bruno Lemos verlor derweil seine komplette Produktionsdatenbank an einen „zerstörerischen Integrationstest“, den *Sol* eigenmächtig gegen die Live-Umgebung fuhr.
Pikant ist, was t3n aus OpenAIs eigenen Tests referiert. Dort sollte *Sol* drei virtuelle Maschinen mit den Nummern eins bis drei löschen, fand die Bezeichnungen nicht – und löschte kurzerhand drei andere VMs mit den Nummern fünf bis sieben, inklusive laufender Prozesse und Arbeitsdaten. OpenAI betont, so etwas trete nur sporadisch auf.
Ähm, sporadisch hin oder her, aber eine solide Vertrauensbasis schafft das so nicht gerade im Moment.
## Codex Micro

© OpenAI, WORK LOUDER
Den [Nutzerwert des Ganzen hatte ich schon im Teaser hinterfragt](https://t01.li/ai-shorts/ai-picks-der-27-kw/#openai-teasert-erste-hardware) und die Fragezeichen werden eher größer als kleiner:
> Jede Agenten-Taste leuchtet mit einem Echtzeit-RGB-Status aus Codex auf, sodass du erkennst, was gerade nachdenkt, ausgeführt wird, wartet oder fertig ist – noch bevor du überhaupt den Chat wechselst.
So steht es [auf der Produktseite von OpenAI](https://openai.com/de-DE/supply/co-lab/work-louder/?ref=t01.li).
Das wichtigste Sekundär-Feature, also die beleuchteten Tasten, hat gegenwärtig einen (dokumentierten) Anwendungsfall, in einer einzigen App, für die ich es produktiv einsetzen kann. Und dafür soll ich 230 $ zahlen? … Wie wär's mit Nein!?
Dabei ist genau das gerade der einzige Vorteil gegenüber einem Stream Deck, dem Loupedeck Live oder der MX Creative Console (mit der ich übrigens ziemlich zufrieden bin, im Gegensatz zu einigen anderen Logitech-Produkten).
Gut, immerhin hat [das *Codex Micro*](https://worklouder.cc/codex-micro?ref=t01.li) von Work Louder vernünftige mechanische Switches sowie wechselbare Tastenkappen spendiert bekommen, und die sind sogar aus PBT und PC – Materialqualität, die Logitech seiner teuren MX-Serie bis heute nicht gönnt, obwohl die eigene Gaming-Sparte längst Double-Shot-PBT verbaut.
Und damit Schicht für diese Woche.
### Kimi K3: Frontier-Leistung zum Frontier-Preis – die Billig-Ära ist vorbei
URL: https://t01.li/ki-news/kimi-k3-frontier-leistung-zum-frontier-preis-die-billig-ara-ist-vorbei/
Last updated: 2026-07-28T09:27:47.000Z
Moonshot AI hat am 16\. Juli *Kimi K3* veröffentlicht, und der Launch lief ab wie eine Premiere aus dem Valley – geleakte Promo-Seite zwei Tage vorher, [Vorbericht bei TechCrunch](https://techcrunch.com/2026/07/16/moonshots-upcoming-kimi-3-is-expected-to-close-the-gap-with-anthropics-opus-4-8/?ref=t01.li) auf Basis der Financial Times, danach Fortune, MarkTechPost und ein X-Feed voller Benchmark-Charts. Releases großer chinesischer Modelle werden inzwischen durchs Dorf getrieben, wie Gossip aus dem englischen Königshaus. Das allein erzählt schon die halbe Geschichte. Die andere Hälfte steckt im Kleingedruckten – und die schauen wir uns jetzt an.
****Update, 28\. Juli:** Moonshot hat geliefert – die vollständigen Weights liegen seit dem 27\. Juli auf Hugging Face. Was in der Lizenz steht, was Self-Hosting kostet und was von meiner These übrig bleibt: [Kimi K3 Weights sind da: 1,5 Terabyte Frontier, mit Kleingedrucktem](https://t01.li/ki-news/kimi-k3-weights-lizenz-self-hosting/)
## TL;DR
*Kimi K3* ist da – 2,8 Billionen Parameter, 1-Million-Token-Kontextfenster, laut Moonshot das erste „offene“ Modell der 3T-Klasse.
- Unabhängig gemessen: Platz 4 im Artificial Analysis Intelligence Index, hinter *Fable 5* und *GPT 5.6 Sol*, auf Augenhöhe mit *Opus 4.8*
- 15 $ pro Million Output-Tokens – das teuerste Modell, das je ein chinesisches Lab veröffentlicht hat
- Die Weights kommen erst bis zum 27\. Juli – bis dahin ist „offen“ ein Versprechen
- Kehrseite der Messung: Die Halluzinationsrate stieg gegenüber K2.6 von 39 auf 51 Prozent
## Ein Modell der 3-Billionen-Klasse – auf dem Papier offen
Die Eckdaten aus dem [Tech-Blog von Moonshot](https://www.kimi.com/blog/kimi-k3?ref=t01.li): 2,8 Billionen Parameter, [Mixture-of-Experts](https://t01.li/glossar/#moe) mit 16 von 896 aktiven Experten, native Vision, ein [Kontextfenster](https://t01.li/glossar/#kontextfenster) von einer Million Tokens. Als Architektur-Unterbau dienen zwei Neuerungen namens Kimi Delta Attention und Attention Residuals, die zusammen eine rund 2,5-fache Scaling-Effizienz gegenüber *Kimi K2* bringen sollen – herstellereigene Angabe, keine unabhängige Drittmessung, das übliche Sternchen.
Erstaunlich ehrlich ist Moonshot an anderer Stelle. Der eigene Blogpost räumt ein, dass K3 in der Gesamtleistung hinter *Claude Fable 5* und *GPT 5.6 Sol* liegt – wer sich erinnert, wie [OpenAI den Launch von *GPT 5.6 Sol, Terra und Luna*](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) inszeniert hat, weiß, dass diese Sorte Understatement in Pressemitteilungen nicht selbstverständlich ist.
Bleibt das Wort „offen“. Die vollständigen Weights sollen bis zum 27\. Juli nachgereicht werden. Stand heute ist K3 also ein proprietäres Modell mit [Open-Weights](https://t01.li/glossar/#open-weights)\-Versprechen – ein Muster, das wir [bei MiniMax M3 schon einmal durchdekliniert haben](https://t01.li/ki-news/minimax-m3-open-weight-ohne-weights/). Ich gehe davon aus, dass Moonshot liefert, die Firma hat bei den K2-Modellen Wort gehalten.
## Kimi K3 in der unabhängigen Messung
[Artificial Analysis hat K3 direkt vermessen](https://x.com/ArtificialAnlys/status/2077832874183860404?ref=t01.li) und kommt auf 57 Punkte im Intelligence Index – hinter *Fable 5* (60) und *GPT 5.6 Sol* (59), auf Augenhöhe mit *Opus 4.8* (56). Dass im Leaderboard trotzdem Platz 4 steht, liegt an einer Zählweise-Fußnote, denn zwei Sol-Konfigurationen laufen dort als getrennte Einträge. Für ein Modell, dessen Weights demnächst frei verfügbar sein sollen, ist das eine Ansage. Der Sprung zeigt sich am deutlichsten bei den agentischen [Benchmarks](https://t01.li/glossar/#benchmark): Auf GDPval-AA v2 klettert *K3* auf eine Elo von 1.668, der Vorgänger *K2.6* lag bei 1.190\. Auf AutomationBench-AA steht *K3* auf Platz 1, und in der Frontend Code Arena debütierte das Modell [an der Spitze vor *Fable 5* und *GPT 5.6 Sol*](https://the-decoder.com/kimis-open-model-k3-nears-gpt-5-6-sol-and-fable-5-while-signaling-the-end-of-super-cheap-chinese-ai/?ref=t01.li) – dort stimmen echte Entwickler über echte Aufgaben ab, kein Labor-Setup.
Die Kehrseite steht im selben Bericht. *K3* beantwortet auf dem AA-Omniscience-Index mehr Fragen richtig als *K2.6*, die [Halluzinationsrate](https://t01.li/glossar/#halluzination) stieg gleichzeitig von 39 auf 51 Prozent. Das Modell rät also häufiger, statt zu passen – für lange agentische Läufe ohne menschliche Aufsicht, das erklärte Haupteinsatzgebiet, ist das keine Fußnote.
Apropos Fußnoten: Wer die Benchmark-Tabelle von Moonshot liest, sollte die Anmerkungen darunter nicht überspringen. Je nach Test kommen unterschiedliche [Harnesses](https://t01.li/glossar/#harness) zum Einsatz, und die *Fable-5*\-Werte tragen den Zusatz „with fallback“ – Anfragen, die *Fable 5* aus Policy-Gründen verweigert, wurden automatisch von *Opus 4.8* beantwortet. Vergleichbarkeit sieht anders aus. Genau deshalb ist die unabhängige Messung von Artificial Analysis mehr wert als jede Zeile der Hersteller-Tabelle.
## 15 Dollar für die Million Output – die Billig-Ära ist vorbei
Der API-Preis hat es in sich. 3 $ pro Million Input-Tokens, 15 $ pro Million Output – [Simon Willison merkt an](https://simonwillison.net/2026/Jul/16/kimi-k3/?ref=t01.li), dass *K3* damit auf dem Niveau von Anthropics Sonnet-Serie liegt und das teuerste Modell ist, das je ein chinesisches Lab veröffentlicht hat. *K2.6* kostete noch 0,95 $ und 4 $. Rechnet man auf Kosten pro Task um, landet *K3* laut Artificial Analysis bei 0,94 $ – nah an *GPT 5.6 Sol*, etwa halb so teuer wie *Opus 4.8*, aber ein Vielfaches von [*GLM-5.2*, das mit Open Weights und 1M Kontext](https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/) bei rund 0,32 $ pro Task liegt.
Die Botschaft dahinter ist unbequem für alle, die chinesische Modelle als Discount-Alternative eingeplant hatten. Wer Frontier-Leistung will, zahlt Frontier-Preise – der Pass wird zunehmend egal.
## Regen, Traufe und der dritte Weg
Und damit zum Teil, der bei der ganzen Benchmark-Euphorie gern untergeht. Wenn wir uns für Frontiermodelle entscheiden, überlegen wir im Moment im Kern, ob wir unsere Daten lieber in die USA oder nach China schicken – vom Regen in die Traufe, je nach Blickrichtung. Für *K3* gilt das Stand heute uneingeschränkt, denn ohne veröffentlichte Weights führt jeder Prompt über die API von Moonshot.
Der ehrliche Zusatz gehört aber dazu. Sobald die Weights draußen sind, ändert sich die Rechnung, denn Open-Weights-Modelle laufen dort, wo du sie hinstellst – *DeepSeek-R1* gibt es seit Anfang 2025 als Managed Model auf Amazon Bedrock, Qwen-Modelle ebenso, und wer die Hardware hat, hostet gleich selbst. Ob ein 2,8-Billionen-Parameter-Brocken, für den Moonshot Deployments mit 64 und mehr Beschleunigern empfiehlt, in deinem Serverraum realistisch ist, steht auf einem anderen Blatt. Für die [Hyperscaler](https://t01.li/glossar/#hyperscaler) ist es keiner.
### Das weniger lustige Kapitel
Über die Trainings-„Zensur“ chinesischer Modelle dürfen wir uns keiner Illusion hingeben – aber ehrlich, wirklich unzensiert ist keines der Frontiermodelle, die du über eine API oder einen Webchat nutzen kannst. In vielen Fällen ist das sinnvoll und hat trotzdem Raum für Diskussionen gelassen – man rufe sich das viel strapazierte Stichwort „Bombenbauanleitung“ in Erinnerung. Weniger lustig wird es, wenn Geschichtsrevisionismus dazukommt, und das muss ich an dieser Stelle nicht weiter ausführen.
Fairerweise gilt für *K3*: Unabhängige Tests zu politischen Inhalten existieren noch nicht, der Release ist zum Zeitpunkt meines Beitrags keine 48 Stunden alt. Die Erfahrung mit den Vorgängern und den Modellen der Nachbarschaft gibt allerdings wenig Anlass, hier eine Ausnahme zu erwarten. Wer K3 produktiv einsetzen will, sollte diesen Punkt in seine [Evals](https://t01.li/glossar/#eval) aufnehmen – nicht als Gesinnungsprüfung, sondern als schlichte Qualitätskontrolle für alles, was auch nur in die Nähe historischer oder politischer Themen kommt.
## Einordnung
K3 ist ein ernst zu nehmendes Modell, unabhängig bestätigt, und der Abstand zur geschlossenen Spitze schrumpft von Release zu Release. Die Zeiten, in denen chinesische Modelle die Billig-Schiene bedienten, enden gerade vor unseren Augen.
Steile These zum Schluss: Der eigentliche Machtwechsel passiert nicht auf den Leaderboards, sondern am 27\. Juli. Wenn Moonshot die Weights wie versprochen liefert, gibt es erstmals ein Modell knapp unter der absoluten Spitze, das jeder Hyperscaler, jeder EU-Anbieter und jede Behörde mit genug Blech selbst betreiben kann – und dann stellt sich die Regen-oder-Traufe-Frage plötzlich den geschlossenen US-Modellen. Bis dahin gilt: Benchmark-Gossip genießen, Kleingedrucktes lesen, Daten dort lassen, wo sie hingehören.
### Der 2. August, die KI-Verordnung und ein Panik-Marketing, das ins Leere läuft
URL: https://t01.li/ki-alltag/eu-ki-verordnung-2-august-2026-kmu-selbstcheck/
Last updated: 2026-07-15T04:57:10.000Z
Seit Wochen läuft der Countdown. In jedem zweiten LinkedIn-Post, in einschlägigen Newslettern, in Webinar-Einladungen mit rot blinkendem Timer steht dasselbe Datum: der 2\. August 2026, der Tag, an dem die KI-Verordnung angeblich über den Mittelstand hereinbricht. Bußgelder bis 35 Millionen Euro, dazu ein Häkchen-Katalog, den man natürlich gegen Honorar abarbeiten lässt.
LinkedIn schiebt mir die Beiträge von „KI-Transformationsexperten“, die diese Panik verkaufen, aktuell täglich in den Feed. Umso mehr geht sie mir auf die Nerven. Für den Großteil dessen, was ein normales Unternehmen mit generativer KI tut – Texte formulieren lassen, interne Abläufe automatisieren, einen gekennzeichneten Chatbot auf die Website setzen – passiert am 2\. August nichts Dramatisches. Der Teil, der wirklich streng wird, ist gerade nach hinten gerutscht.
## TL;DR
Die große August-Deadline ist für die meisten Unternehmen kein Ereignis, sondern ein Verkaufsargument.
- Am 2\. August 2026 wird die KI-Verordnung allgemein anwendbar – die strengen Hochrisiko-Pflichten nach Anhang III sind über den Digital Omnibus aber auf Dezember 2027 verschoben.
- Der typische KMU-Einsatz – Textassistenz, interne Automatisierung, gekennzeichnete Chatbots – war nie Hochrisiko und wird es auch nicht.
- Hochrisiko trifft im Mittelstand fast nur drei Fälle: KI in der Personalauswahl, in der Bonitätsprüfung, in der Bildungsbewertung.
- Für alle bleibt die Transparenz: Chatbot-Hinweis und Deepfake-Kennzeichnung ab August, die maschinenlesbare Markierung generativer Bestandssysteme erst ab Dezember 2026.
- Die KI-Kompetenz-Pflicht gilt schon seit Februar 2025 und wird durch den Omnibus sogar gelockert – Schulung bleibt trotzdem sinnvoll.
## Was am 2\. August 2026 wirklich passiert
Die KI-Verordnung ist kein neues Gesetz, das an einem Stichtag vom Himmel fällt. Sie gilt seit dem 1\. August 2024 und wird in Etappen scharfgeschaltet. Die Verbote bestimmter Praktiken und die Pflicht zur KI-Kompetenz greifen seit Februar 2025, die Regeln für große Sprachmodelle seit August 2025\. Für den 2\. August 2026 war die große Stufe vorgesehen – die vollen Pflichten für Hochrisiko-Systeme nach Anhang III.
Genau diese Stufe ist verschoben. Der sogenannte Digital Omnibus, ein Änderungspaket, mit dem die EU ihre eigene Regulierung entschlacken will, hat die Fristen für Hochrisiko-KI nach hinten gezogen. Das Europäische Parlament hat den Text am 16\. Juni 2026 gebilligt, der Rat hat ihn am 29\. Juni [förmlich angenommen](https://www.heuking.de/de/news-events/newsletter-fachbeitraege/artikel/ki-omnibus-2026-trilog-einigung-zur-aenderung-des-ai-act-bringt-laengere-fristen-und-weniger-buerokratie.html?ref=t01.li) und damit das Verfahren abgeschlossen. Für eigenständige Hochrisiko-Systeme nach Anhang III gilt jetzt der 2\. Dezember 2027, für in Produkte eingebaute Systeme nach Anhang I der 2\. August 2028 – [rund anderthalb beziehungsweise ein Jahr später](https://www.activemind.legal/de/guides/aenderungen-ki-verordnung/?ref=t01.li) als ursprünglich geplant.
Ein Haken bleibt: In Kraft ist die Änderung noch nicht. Es fehlt die Veröffentlichung im Amtsblatt der EU, und erst drei Tage danach greift sie. Erwartet wird sie in den kommenden Tagen, rechtzeitig vor dem Stichtag – aber solange sie nicht schwarz auf weiß steht, gilt formal weiter der 2\. August.
Warum die EU ihr eigenes Vorzeigegesetz entschärft, bevor es richtig gegriffen hat, ist keine Nebensache. Die technischen Normen, an denen sich Unternehmen beim Konformitätsnachweis orientieren sollen, sind noch nicht fertig. Die Kommission [beziffert die Anfangskosten](https://consulting.tuv.com/aktuelles/ki-im-fokus/digital-omnibus-ki-verordnung-fristen?ref=t01.li) für ein einzelnes Hochrisiko-System im Mittelstand auf bis zu 600.000 Euro. Das ist der eigentliche Grund für die Verschiebung, sauber verpackt als Wettbewerbsförderung. Dass die Datenschützer das kritisch sehen, gehört zur Wahrheit dazu – der Europäische Datenschutzausschuss [warnte früh](https://consulting.tuv.com/aktuelles/ki-im-fokus/digital-omnibus-ki-verordnung-fristen?ref=t01.li), eine Verzögerung um bis zu sechzehn Monate schwäche den Grundrechtsschutz in einem Feld, das sich im Monatstakt verändert.
## Der Hochrisiko-Selbstcheck in vier Fragen
Der ganze Aufwand, um den das Panik-Marketing kreist, hängt an einer Vorfrage. Betreibst du überhaupt ein Hochrisiko-System? Anhang III listet acht Bereiche, in denen KI als hochriskant gilt, [von Biometrie über kritische Infrastruktur bis zur Strafverfolgung](https://consulting.tuv.com/aktuelles/ki-im-fokus/eu-ai-act-august-2-2026-unternehmen?ref=t01.li). Fünf davon tauchen im normalen Mittelstandsgeschäft nie auf. Für dich sind drei übrig, und die klopfst du mit vier Fragen ab.
**Frage 1** betrifft deine Personalarbeit. Sortiert bei dir eine KI Bewerber vor, matcht Lebensläufe, beurteilt Leistung, redet sie bei Beförderung oder Kündigung mit? Dann sitzt du in der Kategorie Beschäftigung, und die zählt als Hochrisiko.
Bei **Frage 2** geht es um Zugang. Prüfst du mit KI die Kreditwürdigkeit, berechnest du Versicherungstarife, entscheidest du über den Zugang zu wesentlichen Leistungen mit? Auch dann bist du drin.
**Frage 3** gilt nur, wenn du im Bildungsbereich arbeitest. Eine KI, die Prüfungen benotet oder über Zulassung und Einstufung mitentscheidet, fällt ebenfalls unter Anhang III.
**Frage 4** ist der Sammelposten für alles Übrige – biometrische Erkennung, Emotionsanalyse, KI in kritischer Infrastruktur, in Strafverfolgung, Migration oder Justiz. Wer bei dieser Aufzählung kurz schmunzeln musste, beantwortet sie mit Nein.
Viermal nein, und du betreibst sehr wahrscheinlich kein Hochrisiko-System. Damit landest du im Bereich mit Transparenz- oder minimalen Pflichten, und der gefürchtete Häkchen-Katalog ist für dich kein Thema.
Eine Sache noch, weil sie in der Praxis untergeht: Entscheidend ist nicht, ob du eine KI gebaut hast, sondern ob du eine einsetzt. Im Sinne der Verordnung bist du dann Betreiber, und auch als Betreiber hast du Pflichten. Der typische Stolperfall als Beispiel. Eine Personalabteilung schaltet im bestehenden Bewerbungstool ein KI-Modul fürs CV-Matching frei, und [niemand außerhalb der Abteilung weiß davon](https://skill-sprinters.de/blog/compliance/eu-ai-act-anhang-iii-hochrisiko-kmu/?ref=t01.li). Auf dem Papier ist die Firma damit Betreiber eines Hochrisiko-Systems, ohne es zu ahnen. Solche Schatten-KI findet man nicht im Gespräch mit der IT, sondern nur, wenn man Abteilung für Abteilung durchgeht, welches Tool heimlich welche Funktion aktiviert hat.
Und selbst wenn du zum Schluss kommst, dass ein grenzwertiges System nicht hochriskant ist, [solltest du diese Einstufung dokumentieren](https://www.activemind.legal/de/guides/aenderungen-ki-verordnung/?ref=t01.li), bevor das System läuft. Kein Riesenakt, aber der Vollständigkeit halber notiert.
## Was trotzdem für alle gilt
Entwarnung heißt nicht Freibrief. Ein paar Pflichten treffen jeden, der KI sichtbar nach außen einsetzt, und die bleiben beim 2\. August.
Die wichtigste ist simpel. Wer einen Chatbot betreibt, muss den Nutzern erklären, dass sie mit einer Maschine reden und nicht mit einem Menschen. Wer täuschend echte Darstellungen realer Personen veröffentlicht, also Deepfakes, muss sie erkennbar kennzeichnen. Diese Offenlegungspflicht für Betreiber [bleibt beim August-Termin](https://www.srd-rechtsanwaelte.de/blog/digital-omnibus-ai-was-aendert-sich-an-der-ki-verordnung?ref=t01.li). Für ein durchschnittliches KMU bedeutet das in der Praxis wenig Aufwand. Ein klarer Hinweis am Chatbot, ein Satz in der Datenschutzerklärung, fertig.
Etwas mehr Luft gibt es bei der maschinenlesbaren Markierung von KI-generierten Inhalten, dem sogenannten Watermarking. Für generative Systeme, die schon vor August auf dem Markt waren, [rutscht diese technische Pflicht auf den 2\. Dezember 2026](https://www.srd-rechtsanwaelte.de/blog/digital-omnibus-ai-was-aendert-sich-an-der-ki-verordnung?ref=t01.li). Wer Bilder oder Texte generieren lässt und veröffentlicht, hat hier ein paar Monate länger Zeit. Die sichtbare Kennzeichnung von Deepfakes bleibt davon unberührt.
## KI-Kompetenz, alt und gerade entschärft
Ein Punkt wird im Panik-Marketing gern als frische August-Neuigkeit verkauft, obwohl er anderthalb Jahre alt ist. Die Pflicht zur KI-Kompetenz nach Artikel 4 gilt schon seit dem 2\. Februar 2025\. Sie besagt, dass Menschen, die im Unternehmen mit generativer KI arbeiten, ausreichende KI-Kompetenz mitbringen sollten – Chancen, Grenzen, Risiken.
Interessant ist, dass der Omnibus diese Pflicht nicht verschärft, sondern aufweicht. Aus dem harten „sicherstellen“ wird ein weiches „die Entwicklung unterstützen“, und eine Garantie für ein bestimmtes Kompetenzniveau [wird ausdrücklich nicht mehr verlangt](https://www.activemind.legal/de/guides/aenderungen-ki-verordnung/?ref=t01.li). Wer die Schulung aus Angst vor dem 2\. August durchpeitschen wollte, kann durchatmen.
Ich würde trotzdem niemandem raten, das Thema abzuhaken. Der Nutzen einer Belegschaft, die weiß, wann ein Modell halluziniert und wann man einer Ausgabe nicht trauen sollte, hängt nicht am Gesetzestext. Und [die haftungsrechtliche Seite bleibt](https://www.haufe.de/personal/arbeitsrecht/ki-verordnung-digitaler-omnibus-zum-eu-ai-act%5F76%5F683992.html?ref=t01.li) bestehen, egal ob das Gesetz „ensure“ oder „support“ sagt.
### Der nüchterne Take
Die August-Deadline ist für die allermeisten Unternehmen kein Ereignis, sondern ein Verkaufsargument. Das strengste Stück Regulierung ist verschoben, der Rest ist überschaubar, und die eine echte Hausaufgabe – der Blick, ob irgendwo ein HR-, Kredit- oder Bildungssystem heimlich Menschen bewertet – kostet dich einen Nachmittag statt einen Beratervertrag.
Mach den Vier-Fragen-Check. Notier das Ergebnis. Häng am Chatbot einen Hinweis auf. Danach kannst du die nächste Countdown-Mail mit gutem Gewissen ungelesen archivieren.
Und falls du bei einer der ersten drei Fragen doch ein Ja hattest, hast du jetzt keinen Grund zur Panik, sondern etwas Besseres: Zeit bis Ende 2027.
*Das hier ist eine Einordnung, keine Rechtsberatung. Wenn bei dir ein echtes Anhang-III-System läuft oder du unsicher bist, ob eines läuft, hol dir juristische Expertise dazu.*
### AI Picks der 28. KW
URL: https://t01.li/ai-shorts/ai-picks-der-28-kw/
Last updated: 2026-08-07T09:44:30.000Z
Von Sommerloch keine Spur, denn wir haben diese Woche alles dabei. Angefangen bei neuen Modellen, über Services, bis hin zu Politischem (wenn auch voraussichtlich eher unschön). Das Thema [ChatGPT 5.6](https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/) hatte ich separat abgefrühstückt, aber ansonsten, et voilà – die Picks der 28\. Kalenderwoche:
## Tencent Hy3
Apache 2.0, [Mixture-of-Experts (MoE)](https://t01.li/glossar/#moe) mit 295 Milliarden Gesamt- und 21 Milliarden aktiven Parametern, Kontextlänge bis 256K Token. Tencent bewirbt [*Hy3*](https://www.tencent.com/en-us/articles/2202386.html?ref=t01.li) so ein wenig als „Kann-einfach-alles-Modell“, inklusive agentischer Funktionen, und will die Halluzinationsrate gegenüber der Preview von 12,5 auf 5,4 Prozent mehr als halbiert haben – interne Messwerte, du ahnst es.
Das Schöne ist, man kann es [bis zum 21\. Juli mit einem OpenRouter-Account](https://openrouter.ai/tencent/?ref=t01.li) kostenlos testen. Für den Selbstbetrieb empfiehlt Tencent acht GPUs der H20-Klasse oder größer; die FP8-Variante [auf Hugging Face](https://huggingface.co/tencent/Hy3?ref=t01.li) belegt rund 300 GB, BF16 knapp 600\. Eher nichts für den Bastelkeller also.
## LongCat-2.0
Noch ein LLM, noch mal [Open Weights](https://t01.li/glossar/#open-weights), nur diesmal noch ein bisschen fetter.
[*LongCat-2.0*](https://longcat.chat/blog/longcat-2.0/?ref=t01.li), MoE mit 1,6 Billionen Gesamtparametern und \~48 Milliarden aktiven Parametern bei einem [Kontextfenster](https://t01.li/glossar/#kontextfenster) von 1 Mio. Token, MIT-Lizenz. Meituan hat das Modell dediziert für Coding-Aufgaben entwickelt und trainiert – über 35 Billionen Trainingstokens, und vor dem offiziellen Release lief es wochenlang anonym als „Owl Alpha“ auf OpenRouter.
Interessant ist, dass sie im Beitrag auch durchblicken lassen, wie sie trainiert haben und wie ihre Infrastruktur aussieht. Als chinesisches Unternehmen sind sie von den Exportbeschränkungen betroffen und auf Alternativen zu NVIDIA angewiesen. Das erwähnen sie eher so nebenbei, aber nehmen dann eben AI-ASIC-Superpods mit über 50.000 Beschleunigern – scheint ja auch zu funktionieren.
Das Ding liegt zwar [auf Hugging Face](https://huggingface.co/meituan-longcat/LongCat-2.0?ref=t01.li) herum, aber lange überlegen, ob man sich das mal eben zum Testen installiert, muss man bei 1,6 Billionen Parametern dann eher nicht.
## Bericht: Peking prüft Einschränkung des Zugangs zu Chinas führenden KI-Modellen
Womit wir beim passenden Kontrastprogramm zu den beiden Picks davor wären. [Heise geht auf einen Reuters-Bericht ein](https://www.heise.de/news/Bericht-Peking-prueft-Einschraenkung-des-Zugangs-zu-Chinas-fuehrenden-KI-Modellen-11357281.html?ref=t01.li), nach dem die chinesische Regierung strenge Export- und Zugangsbeschränkungen für ihre fortschrittlichsten KI-Modelle prüft – geleitet vom Handelsministerium, mit am Tisch die staatliche Planungsbehörde NDRC. Betroffen wären z. B. Alibaba, ByteDance und Z.ai, mit denen hat man wohl auch schon zusammengesessen. Im Raum steht sogar, Leak oder Diebstahl von KI-Technologie als Straftatbestand ins nationale Sicherheitsgesetz zu schreiben.
Ist das eine Retourkutsche an die US-Administration? Vielleicht, und nicht unwahrscheinlich.
Das dürfte in Europa die Diskussion um echte Souveränität hoffentlich wieder massiv anheizen. Vielleicht wachen hier auch mal ein paar Buden auf, die zumindest die Kapazitäten hätten, das Problem mit in den Griff zu bekommen (ich schaue niemanden an: Deutsche Telekom, Vodafone, Telefónica, OVH, Orange, United Internet).
## Grok 4.5
Das war mir aus diversen Gründen (die ich hier nicht breittrete) dann doch keinen eigenen Artikel wert. Aber bei SpaceXAI ist *Grok 4.5* hinten rausgefallen:
> Grok 4.5 is SpaceXAI's smartest model built for coding, agentic tasks, and knowledge work.
[Die eigene News dazu](https://x.ai/news/grok-4-5?ref=t01.li) fällt knapper aus als der Beitrag von [Artificial Analysis auf X.com](https://x.com/ArtificialAnlys/status/2074956932289282087?ref=t01.li).
Sonst beschwere ich mich immer, dass es zum Modellstart nur [anbietereigene Benchmarks](https://t01.li/glossar/#benchmark) gibt, gemessen unter eigenen Laborbedingungen. Diesmal haben wir zum Start unabhängige Drittmessungen – so geht das! Artificial Analysis sieht das Modell auf Platz 4 im Intelligence Index, hinter *Fable 5*, *GPT-5.5* und *Opus 4.8*, bei einem Bruchteil von deren Token-Kosten.
Zwei Fußnoten gehen in der Launch-Euphorie allerdings unter. Die Halluzinationsrate ist laut derselben Messung von 25 auf 54 Prozent gestiegen – das Modell weiß mehr, ist sich aber auch öfter fälschlich sicher. Und Cursor räumt selbst ein, dass ein älterer Snapshot der eigenen Codebase versehentlich im Training gelandet ist – und hat CursorBench deshalb gleich aus der eigenen Ergebnistabelle genommen. Immerhin ehrlich kommuniziert. Genau dafür sind Drittmessungen übrigens da.
## Introducing Muse Spark 1.1
Meta Superintelligence Labs hat [*Muse Spark 1.1*](https://ai.meta.com/blog/introducing-muse-spark-meta-model-api/?ref=t01.li) rausgelassen und zeitgleich die neue Meta Model API gestartet – die erste öffentliche, kostenpflichtige Modell-API des Konzerns. Streng genommen hatte Meta den rein defensiven Open-Source-Pfad (Llama) schon im April verlassen, als das erste *Muse Spark* nur ausgewählten Partnern per Private Preview zugänglich war. Neu ist, dass jetzt jeder zahlen darf. Na gut, fast jeder – die Public Preview ist vorerst US-only mit Warteliste, und auf OpenRouter will Meta das Modell bewusst nicht sehen.
Kampfpreise gibt es trotzdem:
- Input-Kosten: **1,25 $** pro 1 Million Tokens
- Output-Kosten: **4,25 $** pro 1 Million Tokens
Und sonst so? Meta verspricht massive Sprünge bei Computer Use und Coding, das Modell versteht sich auf native multimodale Visual Loops und über die API ist Echtzeit-Web-Search-Grounding verfügbar (2,50 $ pro 1.000 Queries). Ein Detail für die Kalkulation solltest du nicht überlesen – *Muse Spark 1.1* ist ein [Reasoning-Modell](https://t01.li/glossar/#reasoning-modell), und die Denk-Tokens werden als Output abgerechnet.
## LangChain and NVIDIA launch the NemoClaw Deep Agents Blueprint
LangChain und NVIDIA haben den [NemoClaw für LangChain Deep Agents Blueprint](https://www.langchain.com/blog/langchain-and-nvidia-launch-the-nemoclaw-deep-agents-blueprint?ref=t01.li) veröffentlicht. Es handelt sich um eine offene, abgesicherte Enterprise-Referenzarchitektur, die NVIDIAs Open-Weight-Modell *Nemotron 3 Ultra* mit LangChains Framework für langlaufende Agenten (Deep Agents Code / dcode) und einer Sandbox (NVIDIA OpenShell) verheiratet.
Laut Pressemeldung (mit ganz vielen Herstellersternchen – gemessen wurde auf LangChains eigener Eval-Suite) erreicht das in Benchmarks die Genauigkeit kommerzieller US-Topmodelle, senkt die Token- und Inferenzkosten jedoch um den Faktor 10:
- Kosten mit dem Open Stack (NVIDIA + LangChain): **4,48 $** pro Durchlauf
- Kosten mit dem nächstbesten proprietären Closed-Source-Modell: **43,48 $**
Da überlegst du nicht lange, wenn am Ende der Kette das Ergebnis stimmt. [Der NemoClaw-Blueprint](https://build.nvidia.com/nvidia/nemoclaw-for-langchain-deep-agents-code/nemoclawcard?ref=t01.li) ist ab sofort verfügbar.
## Fable 5 as „advisor“ or „orchestrator“
Token-Spar-Tipps von Anthropic, um Modelle effizienter zu nutzen. Entweder [über einen Tool-Call](https://platform.claude.com/docs/en/agents-and-tools/tool-use/advisor-tool?ref=t01.li), der *Fable 5* als „Aufseher“ dazuholt, während *Sonnet 5* die eigentliche Arbeit macht – oder *Fable 5* als Orchestrator, [der kleinere Modelle als Workers in den Loop schickt](https://github.com/anthropics/claude-cookbooks/blob/main/managed%5Fagents/CMA%5Fplan%5Fbig%5Fexecute%5Fsmall.ipynb?ref=t01.li).
Anthropic nennt dazu Zahlen aus [eigenen Evals](https://t01.li/glossar/#eval) ([via X](https://x.com/ClaudeDevs/status/2074606058128224365?ref=t01.li)). Das Advisor-Pattern erreicht rund 92 Prozent der Fable-Solo-Leistung auf SWE-bench Pro bei 63 Prozent der Kosten, der Orchestrator kommt auf 96 Prozent bei BrowseComp für 46 Prozent. Das Muster wirkt trotzdem plausibel – die teuren Tokens entstehen nun mal beim Abarbeiten, nicht beim Entscheiden.
## Claude Cowork is coming to mobile and web
Liebe\*r Datenschutzbeauftragte, jetzt bitte mal wegschauen für die nächsten paar Absätze:
[Cowork dann jetzt auch für Web und Mobile.](https://claude.com/blog/cowork-web-mobile/?ref=t01.li) Das Update macht Agenten-Workflows geräteübergreifend und asynchron. Ein Task kann am Desktop gestartet, auf dem Smartphone überwacht und in der Cloud autark fertiggestellt werden – auch wenn zwischendurch gar kein Gerät online ist. Beta-Zugang wird über die nächsten Wochen schrittweise ausgerollt, beginnend mit Max-Usern.
Was denn so geht:
- Asynchrone Hintergrund-Ausführung: Tasks laufen komplett autark weiter, wenn der Laptop zugeklappt wird oder kein Gerät online ist.
- Geplante Aufgaben (Scheduled Tasks): Workflows lassen sich für bestimmte Uhrzeiten vorprogrammieren (z. B. Montagmorgen um 6 Uhr Briefing-Dokumente aus E-Mails und News generieren und den Mail-Entwurf vorbereiten).
- [Human-in-the-Loop](https://t01.li/glossar/#human-in-the-loop) via Mobile Push: Braucht Claude eine strategische Entscheidung, stoppt der Agent nicht einfach, sondern schickt eine Frage aufs Smartphone. Du kannst den Entwurf von unterwegs korrigieren, freigeben oder den Agenten neu ausrichten.
Anmerkung: Das ist für meinen Account freigeschaltet. In der Desktop-App taucht ein neuer Reiter auf, etwas ungelenk übersetzt als „Versenden“ – mit einem Beta-Hinweis. In der Mobile-App heißt es „Versand“. Wenn man es in der App auf dem Telefon aktiviert und öffnet, hat sich Anthropic entschieden, es bei „Dispatch“ zu belassen, was in jedem Fall besser ist als „Versand“.
Die ohnehin schon verdoppelten Cowork-Nutzungslimits werden im gleichen Zug bis zum 5\. August 2026 verlängert.
Ja, geht – haut mich jetzt aber nicht um. Das mag anderen Menschen anders ergehen und es gibt sicherlich genug Anwendungsfälle dafür. Muss man eben wollen/brauchen und aus diversen guten Gründen (DSGVO ist einer davon) auch dürfen.
## Neue Features für Managed Agents in der Gemini API
Google DeepMind spendiert den Managed Agents innerhalb der Gemini Interactions API [ein Feature-Paket](https://blog.google/innovation-and-ai/technology/developers-tools/expanding-managed-agents-gemini-api/?ref=t01.li). Ziel ist es, aus simplen, synchronen API-Aufrufen autonome Hintergrund-Worker zu machen. Die API übernimmt das gesamte Reasoning, Code-Ausführung und Datei-Management in einer isolierten Cloud-Sandbox, wird im gleichen Zug nun aber flexibler bei asynchronen und externen Integrationen.
Neu ist eine asynchrone Hintergrund-Ausführung über das Flag `background: true`, Managed Agents können nun direkt mit [remote MCP-Servern](https://t01.li/glossar/#mcp) verbunden werden, und Entwickler definieren eigene lokale Funktionen parallel zu den serverseitigen Sandbox-Tools. Der unglamouröseste Punkt dürfte für Enterprise-Setups der wichtigste sein – Credentials lassen sich zwischen Interaktionen erneuern, ohne dass die Sandbox ihren Zustand verliert.
## Google macht AlphaEvolve auf der Gemini Enterprise Plattform verfügbar
Google hat den von Google DeepMind entwickelten [Coding-Agent](https://t01.li/glossar/#coding-agent) [*AlphaEvolve* für alle Kunden der Gemini Enterprise Agent Platform freigeschaltet](https://cloud.google.com/blog/products/ai-machine-learning/alphaevolve-is-available-for-everyone?hl=en&ref=t01.li) – nach gut einem halben Jahr Private Preview jetzt General Availability. Es handelt sich um ein System zur automatisierten algorithmischen Code-Optimierung, das auf evolutionären Prinzipien und Feedbackschleifen basiert. Im Gegensatz zu klassischen Code-Generatoren ist *AlphaEvolve* darauf ausgelegt, bestehende, logisch komplexe Softwarekomponenten iterativ zu optimieren.
*AlphaEvolve* baut auf den Gemini-Modellen (Flash für Speed, Pro für Tiefe) und bewertet Kandidaten gegen eine Scoring-Funktion, die du selbst definierst. Die Kundenbeispiele klingen erfreulich konkret statt nach Folienprosa – FM Logistic meldet 10,4 Prozent bessere Lagerrouten auf einer bereits optimierten Baseline.
## JetBrains AI for Teams and Organizations
Ich stelle doch immer wieder fest, dass JetBrains IDEs und die Tools in DACH ein Ding sind. Bei mir jetzt nicht so, aber ich höre immer wieder davon, insbesondere aus der Schweiz – da scheint die Verbreitung noch deutlich höher zu sein.
Jedenfalls rollt JetBrains ab Juli 2026, also quasi jetzt, [ein neues, anbieterunabhängiges (vendor-agnostic) KI-Framework aus](https://blog.jetbrains.com/blog/2026/07/07/jetbrains-ai-for-teams-and-organizations-from-fragmented-ai-usage-to-coordinated-software-development/?ref=t01.li). Statt Entwickler auf ein einziges KI-Tool festzunageln, akzeptiert JetBrains die Realität fragmentierter Workflows (IDE-Assistenten, Claude Code, Codex, Antigravity etc.) und baut eine übergeordnete Schicht für zentrale Governance, geteilten Kontext, kollaborative KI-Agenten und Kostenkontrolle. Externe Tools werden per MCP angebunden, externe Agenten per ACP.
Und es gibt ein neues „On-Demand AI Credits“-Modell – die Credits sind 12 Monate gültig (statt bisher einem) und sollen künftig auch für andere Cloud-Services genutzt werden können.
## Every integration, in every format agents speak
Du suchst einen bestimmten MCP, eine API oder GraphQL zu Tool xy, oder ein [CLI](https://t01.li/glossar/#cli)?
Wenn es das gibt, ist die Wahrscheinlichkeit hoch, dass du es [hier findest](https://integrations.sh/?ref=t01.li) – aktuell knapp 5.800 Specs über gut 3.200 Domains, von MCP-Servern über klassische APIs bis zu CLIs.
## Cloudflare: neue KI-Traffic-Optionen für alle Kunden
Cloudflare erlaubt seinen Kunden [nun detaillierter einzustellen](https://blog.cloudflare.com/de-de/content-independence-day-ai-options/?ref=t01.li), wie mit welcher Art von [KI-Bots](https://t01.li/glossar/#ki-crawler) umgegangen wird. Das pauschale „alles bleibt draußen“ oder äquivalent „alles darf rein“ ist drei Optionen für Suche, Training und Agent gewichen – ab sofort steuerbar für alle Kunden, inklusive Free-Plan.
Ab dem 15\. September 2026 ändert Cloudflare außerdem die Standardeinstellungen, allerdings gezielter, als es die Schlagzeilen vermuten lassen. Für neue Domains (und Bestands-Free-Kunden, die ihre Einstellungen bis dahin nicht anfassen) werden „Training“ und „Agent“ auf Seiten mit Werbung geblockt, während „Suche“ durchgelassen wird.
Der eigentlich spannende Teil versteckt sich im Kleingedruckten. Mixed-Use-Crawler, die Suche und Training in einem Bot vermischen, fallen ab dem Stichtag unter die strengste greifende Regel – wer Training blockt, kann damit auch Googlebot aussperren. Cloudflare zwingt die Betreiber quasi dazu, ihre Crawler nach Zweck zu trennen. Für alle, die von organischer Sichtbarkeit leben, ist das die Stelle, an der man vor dem 15\. September ins Dashboard schauen sollte.
## BSI: Prüfarchitektur für KI-Systeme
Mit dem A5 („AI Audit and Assurance Assessment Architecture“) [legt das BSI](https://www.bsi.bund.de/DE/Themen/Unternehmen-und-Organisationen/Informationen-und-Empfehlungen/Kuenstliche-Intelligenz/A5/A5%5Fnode.html?ref=t01.li) eine modulare und erweiterbare Prüfarchitektur für KI-Systeme vor. Ziel ist es, Akteuren entlang der gesamten KI-Wertschöpfungskette (Entwicklung, Betrieb, Beschaffung, Aufsicht) Kriterien und Methoden an die Hand zu geben, um die technische Vertrauenswürdigkeit (Trustworthiness) von KI-Systemen standardisiert und nachvollziehbar zu bewerten.
**Das steht drin:**
- Horizontales Trustworthiness-Basismodul: Enthält technologie- und anwendungsunabhängige Prüfkriterien, die als grundlegender Rahmen für alle KI-Systeme dienen.
- Betriebsmodul Cloud-Infrastruktur: Stellt die Verbindung zum etablierten Cloud-Kriterienkatalog des BSI (C5) her, um KI-Anwendungen in Cloud-Umgebungen zu prüfen.
- A5-Prüfmethodik: Basiert auf dem international anerkannten Prüfungsstandard ISAE 3000 und regelt das konkrete Vorgehen bei Audits.
Aktuell liegt das Framework als Community Draft vor und befindet sich in der öffentlichen Kommentierungsphase, Fristende ist der 31\. August 2026\. Die Leute schreien immer über zu wenig Demokratiebeteiligung – hier haben wir sie, gelebt.
## Neue Leitlinien für Anonymisierung und Web-Scraping in der EU
[Heise berichtet](https://www.heise.de/news/EU-Datenschuetzer-Neue-Leitlinien-fuer-Anonymisierung-und-Web-Scraping-11358641.html?ref=t01.li), dass der EDSA mit zwei neuen Leitlinien um die Ecke kommt. Die erste setzt neue Standards für die Anonymisierung und führt ein Bewertungsverfahren zur Beurteilung der Anonymität ein:
1. **Keine Einzelfallidentifikation (No record isolation):** Ein Datensatz darf keine so einzigartige Kombination von Merkmalen enthalten, dass eine einzelne Person direkt herausgefiltert werden kann.
2. **Keine Verknüpfung (No linkage):** Die Daten dürfen sich nicht mit anderen bekannten Informationsquellen (auch von Dritten) zu derselben Person kombinieren lassen.
3. **Keine Rückschlüsse (No inference):** Es darf nicht möglich sein, aus den anonymisierten Daten mit hoher Wahrscheinlichkeit neue, sensible Informationen über eine Person abzuleiten.
Die zweite Leitlinie bezieht sich eindeutig auf Web Scraping für generative KI. Laut EDSA unterliegen personenbezogene Daten vollumfänglich der DSGVO – das bloße „Online-Stehen“ von Daten ist kein Freibrief.
Zur Einordnung gehört, dass beide Papiere Entwürfe sind und bis zum 30\. Oktober 2026 in der öffentlichen Konsultation stehen. Wer mit Trainingsdaten oder Scraping-Pipelines arbeitet, kann also noch kommentieren – sollte die Richtung aber schon mal ernst nehmen.
## Separating signal from noise in coding evaluations
OpenAI hat da etwas herausgefunden – genauer gesagt nachgemessen. Das Team hat SWE-Bench Pro auditiert, einen der meistgenutzten Coding-Benchmarks, und stuft rund 30 Prozent der Aufgaben als kaputt ein. Die Fehlerkategorien reichen von überstrengen Tests, die korrekte Lösungen ablehnen, über unterspezifizierte und irreführende Aufgabenstellungen bis zu Tests mit zu geringer Abdeckung. [Die Konsequenz](https://openai.com/index/separating-signal-from-noise-coding-evaluations/?ref=t01.li): OpenAI zieht die eigene Empfehlung für SWE-Bench Pro zurück.
Pikant wird es mit etwas Kontext. Erst vor Kurzem hatte OpenAI SWE-bench Verified wegen Design- und Kontaminationsproblemen beerdigt und der Community den Umstieg auf genau dieses SWE-Bench Pro empfohlen. Das größere Muster dahinter bleibt dasselbe – statische Benchmarks sättigen, Testdaten sickern in die Pre-Training-Korpora (Data Contamination), und wer auf die Teststruktur optimiert, misst am Ende Auswendiglernen statt Problemlösung. Nicht doch – damit hätte [ja wohl niemand rechnen](https://t01.li/ki-systemdesign/wenn-benchmarks-lugen-warum-der-llm-vergleich-kaputt-ist/) können!
Das war die 28\. Kalenderwoche. Sommerloch ist hiermit offiziell abgesagt.
### GPT-5.6 ist da – der Zugang ist die eigentliche Geschichte
URL: https://t01.li/ki-news/chatgpt-5-6-sol-terra-und-luna/
Last updated: 2026-08-26T09:50:20.000Z
Ich wollte *GPT-5.6* heute frisch nach dem Launch einfach ausprobieren. Ich hänge im Plus-Tarif und das auch nicht erst seit gestern. Passiert ist erst mal nichts – weder im WebChat noch in der *Codex*\-App lässt sich ein 5.6-Modell auswählen, nur im [Codex-CLI](https://t01.li/glossar/#cli) liegen *gpt-5.6-terra* und *gpt-5.6-luna* bereit. Mein erster Reflex war der naheliegende, leicht paranoide: liegt's am bösen europäischen Account? Nach einer Stunde Recherche ist die Antwort unspektakulärer, und sie sagt mehr über den Zustand dieser Releases als jedes Benchmark-Diagramm.
## TL;DR
OpenAI hat an einem Tag drei Dinge ausgerollt – und der Zugang ist bei jedem davon gestaffelt.
- *GPT-5.6* mit den Stufen *Sol*, *Terra* und *Luna* ist seit heute (09.07.) breit verfügbar über ChatGPT, Codex und API, der Rollout läuft über 24 Stunden
- Dazu kamen *ChatGPT Work* (ein Agent, der ganze Workflows abarbeitet) und *GPT-Live* (full-duplex Voice)
- Im Chat gibt es keinen „5.6“-Eintrag – *Sol* soll über die Intelligenz-Stufe kommen, ist aber je nach Account noch gar nicht da (bei mir läuft selbst „Hoch“ aktuell noch weiter auf *GPT-5.5*)
- Bei den Benchmarks führt OpenAI mal, verliert mal gegen Anthropics *Fable 5* und *Mythos 5* – die Zahlen sind herstellereigen
- Die eigentliche Nachricht: beide Labs mussten diesmal durch einen Regierungs-Filter
## Drei Releases an einem Tag
OpenAI hat die Woche vollgepackt. *GPT-5.6* ging heute [in die allgemeine Verfügbarkeit](https://openai.com/index/gpt-5-6/?ref=t01.li), nachdem die Modellfamilie seit dem 26\. Juni nur als geschlossene Preview für ausgewählte Partner lief. Einen Tag vorher kam mit *GPT-Live* eine neue Generation von Voice-Modellen, und parallel zum Modell-Launch schaltete OpenAI *ChatGPT Work* frei, einen Agenten, der komplette Aufgaben übernehmen soll. Drei Ankündigungen, ein gemeinsames Muster: Verfügbar heißt nicht verfügbar für alle.
Das Modell selbst ist der Kern, also fangen wir da an – und bei der Frage, warum es bei mir im Picker fehlt.
## GPT-5.6: Sol, Terra, Luna – warum du Sol im Picker nicht siehst
OpenAI hat mit *GPT-5.6* das Namensschema umgebaut. Die Zahl steht für die Generation, *Sol*, *Terra* und *Luna* stehen für dauerhafte Fähigkeitsstufen. *Sol* ist das Flaggschiff, *Terra* die ausgewogene Variante auf etwa [GPT-5.5-Niveau](https://t01.li/ki-news/gpt-5-5-instant-als-neuer-chatgpt-default-mit-deutlich-weniger-halluzinationen/) zum halben Preis, *Luna* das schnellste und günstigste Modell. Preislich landet das bei 5 USD Input und 30 USD Output pro Million Tokens für *Sol*, die Hälfte für *Terra*, und nochmal deutlich darunter für *Luna*.
Und jetzt zu meinem Modell-Picker-Problem: Im Chat *sollen* Plus, Pro, Business und Enterprise die *Sol*\-Stufe nicht als eigenen Eintrag bekommen, sondern über die Intelligenz-Einstellung – wer im Modell-Dropdown ein „5.6“ sucht, sucht am falschen Ort. So der Plan; in meinem Account greift er aktuell mit Veröffentlichung dieses Artikels noch nicht. Der Regler steht auf „Hoch“, und im Modell-Menü darunter endet die Liste bei *GPT-5.5*, gefolgt von *5.4*, *5.3* und *o3*. Kein *Sol*, kein 5.6, egal welche Stufe ich wähle.

Webinterface ChatGPT mit Modell-Picker
In *ChatGPT Work* und *Codex* sieht die Sache anders aus: Free und Go bekommen nur *Terra*, Plus und höher wählen frei zwischen allen drei Stufen. Genau deshalb liegen in meinem Codex-CLI *terra* und *luna* schon bereit, während der WebChat stur auf *5.5* beharrt.
Der Rest ist Rollout-Mechanik. Die Modelle verteilen sich über 24 Stunden schrittweise, und *ChatGPT Work* im Web und Mobile [erreicht zuerst Pro, Enterprise und Edu](https://the-decoder.com/openai-pairs-its-gpt-5-6-public-rollout-with-chatgpt-work-a-new-agent-that-handles-entire-workflows/?ref=t01.li), Plus und Business folgen in den kommenden Tagen, was die Sache erklärt und als Plus-Kunde also etwas Geduld erfordert. Über die Desktop-App, die übrigens jetzt Codex-App und Chat-App konsolidiert, ist es sofort für alle da und ein EU-spezifischer Block taucht in keiner Quelle auf. Kein Geoblocking-Drama also, sondern Wellen-Rollout plus Plus-in-Welle-zwei. Mein böser europäischer Account ist diesmal unschuldig. Das konnte ich dann auch feststellen, nachdem sich die Codex-App aktualisierte und mich als „ChatGPT“ mit einem Hinweis-Banner begrüßte.
## ChatGPT Work und GPT-Live
*ChatGPT Work* ist der ambitioniertere der beiden Nebenschauplätze. Der [Agent](https://t01.li/glossar/#agentic-ai) kombiniert die *Codex*\-Technik mit Drittanbieter-Integrationen, läuft auf *GPT-5.6* und soll aus einem Prompt fertige Artefakte bauen – Excel-Tabellen, Word-Dokumente, ganze Präsentationen. Neu ist ein „Unified Plugins Directory“, das [Google Drive, SharePoint, Slack, Teams, Gmail, Salesforce und ein gutes Dutzend weiterer Dienste](https://the-decoder.com/openai-pairs-its-gpt-5-6-public-rollout-with-chatgpt-work-a-new-agent-that-handles-entire-workflows/?ref=t01.li) an einem Ort bündelt. Abgerechnet wird nutzungsbasiert nach Aufgabengröße. Ob der Agent hält, was das Demo verspricht, steht auf einem anderen Blatt – der letzte große Plugin-Anlauf von OpenAI aus 2023 ist bekanntlich versandet.
*GPT-Live* ist die dritte Ankündigung und ersetzt den bisherigen Advanced Voice Mode. Die Modelle *GPT-Live-1* und *GPT-Live-1 mini* arbeiten [full-duplex](https://techcrunch.com/2026/07/08/openai-releases-new-voice-models-for-more-natural-live-conversations/?ref=t01.li), hören und sprechen also gleichzeitig, werfen ein „mhmm“ ein und lassen sich unterbrechen. Für Suche und komplexere Fragen reichen sie im Hintergrund an *GPT-5.5* weiter. Das Mini-Modell wird Standard für Free, das große für die Bezahltarife. Video und Screen-Sharing im Voice-Modus fehlen noch.
## Benchmarks mit Hersteller-Sternchen
Im Ankündigungstext führt OpenAI die [Benchmarks](https://t01.li/glossar/#benchmark) an, in denen sie vorne liegen: Agents' Last Exam, wo *Sol* mit max-Reasoning 53,6 erreicht (die Tabelle im selben Post nennt für eine niedrigere Stufe 52,7 – schon hier fängt das Kleingedruckte an), und der Artificial Analysis Coding Agent Index, wo *Sol* auf 80 kommt. Klingt nach klarer Führung, bis man in die Benchmark-Tabellen darunter schaut.
Dort wird das Bild uneindeutiger. Bei SWE-Bench Pro liegen *Claude Mythos 5* mit 80,3 % und *Fable 5* mit 80 % klar vor *Sol* mit 64,6 %. Beim Artificial Analysis Intelligence Index schiebt sich *Fable 5* mit 59,9 vor *Sol* mit 58,9, und bei GDPval-AA führt Anthropic ebenfalls. Wer meine Einordnungen zu [Claude Sonnet 5](https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/) und [Opus 4.8](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/) gelesen hat, kennt das Muster: Auf den SWE-Bench-Zahlen ist Anthropic gerade schwer zu schlagen. Alle diese Werte sind von OpenAI berichtet, keine unabhängige Drittmessung – gelesen als Marketing, nicht als gegeben. Eine Fußnote lohnt den Blick: Bei GeneBench Pro fliegt *Fable 5* laut OpenAI raus, „weil es die meisten Bio-Fragen verweigert“. Verpackt als Schwäche, ist das in Wahrheit Anthropics bewusste Safety-Haltung.
Die Rezeption unter frühen Testern fällt entsprechend gespalten aus. Investor Matt Shumer [schrieb auf X](https://www.axios.com/2026/07/09/ai-openai-gpt-release?ref=t01.li), *Fable* sei bei fast jeder getesteten Aufgabe spürbar besser gewesen, während andere klare Vorteile bei OpenAI sehen. Altman wiederum verkauft *Sol* als 54 % token-effizienter bei agentischem Coding – die Kennzahl, auf die im Enterprise gerade jeder schaut.
## Zwei Labs, zwei Regierungs-Umwege
Das eigentlich Interessante an diesem Release ist nicht das Modell, sondern der Weg dorthin. OpenAI durfte *GPT-5.6* im Juni zunächst nur an regierungsgenehmigte Stellen ausliefern, auf Bitte der Trump-Regierung. Grundlage ist eine [Executive Order vom 2\. Juni](https://www.axios.com/2026/07/08/openai-gpt-trump-ban-lifted?ref=t01.li), die Modell-Entwickler bittet, ihre Spitzenmodelle vor dem Release freiwillig zur Bewertung vorzulegen. Getestet hat das Center for AI Standards and Innovation im Handelsministerium, OpenAI schickte eigene Leute nach D.C. Das Weiße Haus betont, eine formale Lizenz sei nicht nötig gewesen, die Teilnahme sei freiwillig. OpenAI und Altman rahmen es als kollaborative Prüfung. Zwei Lesarten desselben Vorgangs, aussuchen darf man selbst.
Anthropic steckte in derselben Woche in der Spiegelversion des Problems. *Fable 5* und *Mythos 5* mussten wegen einer Export-Control-Direktive [zeitweise abgeschaltet](https://www.cnbc.com/2026/07/08/openai-expanding-gpt-5point6-ai-model-release-ending-government-limits.html?ref=t01.li) werden, die das Handelsministerium Ende Juni wieder aufhob; seit dem 1\. Juli sind die Modelle zurück. Zwei Labs, zwei Regierungs-Umwege, ein gemeinsamer neuer Normalzustand: Der Zugang zu Frontier-Modellen wird gerade Fall für Fall zwischen Unternehmen und Behörden ausgehandelt, in Echtzeit.
## Kleiner Hot Take
Das Modell ist vermutlich richtig gut – die Efficiency-Zahlen und die gespaltene, aber ernsthafte Tester-Reaktion deuten in dieselbe Richtung. Nur ist das inzwischen fast die langweiligste Frage an so einem Launch-Tag. Spannender ist, dass ich als zahlender Nutzer erst mal vor einem halb ausgerollten Picker sitze, und dass zwei der wichtigsten Labs ihre besten Modelle jetzt durch einen Regierungs-Filter schieben, bevor ich sie überhaupt sehe. Die Benchmarks kann ich nachlesen. Wie sich dieser neue Genehmigungs-Zwischenschritt auf Tempo und Verfügbarkeit auswirkt, ist die Frage, die mich als Praktiker wirklich umtreibt. Sobald ich in Ruhe mal zu einer Versuchsreihe komme, teste ich – und melde mich aller Voraussicht nach mit einem echten Eindruck.
### Reasoning ist kein Qualitätsmodus – wann Denkmodelle Geld sparen und wann sie nur langsam sind
URL: https://t01.li/ki-systemdesign/reasoning-ist-kein-qualitaetsmodus/
Last updated: 2026-07-09T06:05:10.000Z
„Wir nehmen einfach das beste Modell.“ Mit diesem Satz wird in vielen Unternehmen die Modellfrage beendet, bevor sie überhaupt gestellt wurde. Verständlich – niemand will dem Geschäftsführer erklären, warum der neue KI-Workflow auf dem zweitbesten Modell läuft. Nur führt diese Logik in eine teure Sackgasse, denn „das beste Modell“ meint inzwischen fast immer ein Reasoning-Modell, das vor jeder Antwort erst einmal nachdenkt. Und Nachdenken kostet.
Ich erlebe das in Unternehmen regelmäßig – im Webchat von ChatGPT oder Claude wird pauschal das größte Modell ausgewählt, weil die Erwartung dahintersteht, dass die Antworten so „besser werden“. Dass [Reasoning- und Non-Reasoning-Modelle](https://t01.li/glossar/#reasoning-modell) unterschiedlich gepromptet werden wollen, ist oft nicht bekannt; das vorhandene Wissen ist teils veraltet – der [Rollenbaustein im Prompt](https://t01.li/ki-systemdesign/ziel-schlagt-rolle-warum-der-rollenbaustein-im-prompt-ausgedient-hat/) hält sich hartnäckig –, gängige Bausteine wie [Few Shots](https://t01.li/glossar/#few-shot) sind vielen fremd. Der Schulungsbedarf auf Anwenderseite ist real und wird vernachlässigt. Bei [LLM](https://t01.li/glossar/#llm)\-Workflows sieht es meist besser aus, weil dort Menschen mitarbeiten, die sich aus eigenem Interesse mit den Grundlagen beschäftigt haben – im Webchat-Alltag dagegen regiert der Griff zum „fettesten“ Modell.
Die Modellwahl ist keine Prestigefrage, sondern eine Prozessentscheidung – dieselbe Sorte Entscheidung wie die, ob ein Azubi oder die Steuerberaterin einen Beleg abheftet. Beide können es. Eine von beiden ist dafür zu teuer.
## TL;DR
Reasoning-Modelle sind kein pauschales Qualitätsmerkmal, sondern ein Werkzeug für bestimmte Aufgabentypen.
- Denk-Tokens werden zum Output-Preis abgerechnet – bei einfachen Aufgaben entsteht das 7- bis 10-Fache an Tokens für dasselbe Ergebnis
- Routine (Klassifikation, Extraktion, Standardtexte) läuft auf schnellen Modellen günstiger und testbarer
- Reasoning trägt bei strategischer Abwägung, Fehleranalyse und vertragsnahen Einschätzungen – dort mit Mensch im Loop
- Modell-Routing entscheidet je Aufgabe, nicht je Prestige – drei Fragen reichen für den Einstieg
## Was Denk-Tokens tun – und was sie kosten
Reasoning-Modelle erzeugen vor der sichtbaren Antwort interne Denk-Tokens, in denen sie das Problem zerlegen, Ansätze durchspielen und Zwischenergebnisse prüfen. Diese Tokens bekommst du je nach Anbieter höchstens als Zusammenfassung zu sehen – bezahlt werden sie trotzdem, und zwar [zum Output-Preis](https://pecollective.com/tools/anthropic-api-pricing/?ref=t01.li), also in der teuersten Token-Kategorie. Eine Antwort mit 500 sichtbaren Tokens und 2.000 Denk-Tokens kostet das Fünffache derselben Antwort ohne Denkphase.
Das klingt nach einem Detail für API-Buchhalter, skaliert aber brutal. Amazon beziffert den Overhead bei einfachen Anfragen auf das [Sieben- bis Zehnfache an Tokens](https://www.amazon.science/blog/the-overthinking-problem-in-ai?ref=t01.li) für vergleichbare Genauigkeit. Ein Forschungsteam hat es noch plastischer vorgerechnet – *DeepSeek V3* löste die Gleichung „3x + 7 = 22“ mit 58 Tokens, das Reasoning-Schwestermodell *DeepSeek-R1* [verbrauchte für dieselbe Aufgabe über 1.000](https://arxiv.org/pdf/2503.04472?ref=t01.li). Gleiches Ergebnis, siebzehnfache Token-Menge. Beide Modelle sind inzwischen abgelöst – DeepSeek ist bei der V4-Generation angekommen, R1 fliegt zum 24\. Juli endgültig aus der API –, der Mechanismus dahinter bleibt. Dazu kommt die Latenz, denn Denk-Tokens entstehen sequenziell, bevor das erste sichtbare Zeichen erscheint. Bei einem Chatbot merkt das der Kunde, bei einem Batch-Job über 50.000 Dokumente merkt es die Rechnung.
Brisant wird das, weil Reasoning gerade zum Default wird. *Sonnet 5* denkt [seit Ende Juni standardmäßig adaptiv](https://platform.claude.com/docs/en/about-claude/models/whats-new-sonnet-5?ref=t01.li) – wer nichts konfiguriert, bekommt Denk-Tokens, ob bestellt oder nicht. Anthropic selbst empfiehlt in den eigenen Prompting-Docs, Thinking nur dort einzusetzen, wo es die Antwortqualität messbar verbessert. Per Default liefert das Interface des Claude Webchats aber aktiviertes Thinking.
## Routine, Urteil, Exploration – drei Aufgabentypen
Bevor du ein Modell auswählst, lohnt der Blick auf die Aufgabe selbst. Drei Dimensionen reichen für die Einordnung. Was kostet ein Fehler? Braucht die Aufgabe einen Schritt oder eine mehrstufige Abwägung? Und wie oft läuft sie – zehnmal am Tag oder zehntausendmal?
Daraus ergeben sich drei Aufgabentypen. **Routine** heißt hohes Volumen bei klaren Kriterien – die Aufgabe ist eindeutig definiert, das richtige Ergebnis überprüfbar, ein einzelner Verarbeitungsschritt genügt. **Urteil** verlangt eine Abwägung über mehrere Faktoren, bei der der Lösungsweg zwar bekannt ist, aber Kontext und Priorisierung den Unterschied machen. **Exploration** beginnt dort, wo der Lösungsweg selbst unklar ist – Diagnose, offene Probleme, Ursachensuche. Die Mehrheit dessen, was in einem KMU täglich durch die KI-Pipeline läuft, ist Routine. Genau dort richtet der Reasoning-Default den größten Schaden an.
## Wo Non-Reasoning-Modelle völlig ausreichen
Support-Tickets nach Abteilung sortieren, Produktdaten aus Lieferantenkatalogen ziehen, Meeting-Notizen zusammenfassen, Marketing-Texte in drei Längenvarianten formatieren – nichts davon braucht ein Modell, das vorher in sich geht. Ein schnelles Non-Reasoning-Modell liefert hier dasselbe Ergebnis in einem Bruchteil der Zeit, für einen Bruchteil des Preises, oder im Idealfall kostenlos, falls ich es lokal betreiben kann. Und es hat einen unterschätzten dritten Vorteil, denn klar umrissene Aufgaben mit eindeutig richtigem Ergebnis lassen sich sauber testen. Hundert Test-Tickets durch den Klassifikator jagen und die Trefferquote messen – das funktioniert bei einem Modell, das direkt antwortet, deutlich verlässlicher als bei einem, das jedes Mal anders lange grübelt.
| Aufgabe | Modelltyp | Warum |
| ------------------------- | ------------------------------------------- | ------------------------------------- |
| Klassifikation | Non-Reasoning | Schnell, günstig, gut testbar |
| Routing / Triage | Non-Reasoning | Meist klare Entscheidungslogik |
| Extraktion aus Dokumenten | Non-Reasoning oder kleines Reasoning-Modell | Je nach Komplexität und Fehlerkosten |
| Zusammenfassungen | Non-Reasoning | Für Standardfälle ausreichend |
| Strategische Abwägung | Reasoning | Mehrstufige Bewertung nötig |
| Fehleranalyse | Reasoning | Diagnosefähigkeit wichtiger als Tempo |
| Vertragsnahe Einschätzung | Reasoning + Mensch | Kein Ersatz für Prüfung |
| Agentische Workflows | Gemischt | Router entscheidet je Schritt |
## Wo Reasoning tatsächlich trägt
Drei Fälle bleiben übrig, in denen die Denkphase ihr Geld wert ist. Erstens die strategische Abwägung – etwa wenn ein Angebot vorbereitet wird und das Modell Anforderungen, Budgetrahmen und frühere Projekte gegeneinander gewichten muss. Zweitens die Fehleranalyse, bei der Diagnosefähigkeit wichtiger ist als Tempo; ein Modell, das Hypothesen bildet und verwirft, findet die Ursache eines Datenproblems eher als eines, das die erstbeste Erklärung ausspuckt. Drittens vertragsnahe Einschätzungen wie Dokumentenprüfung – dort allerdings ausschließlich mit einem Menschen im Loop, dazu gleich mehr.
Auffällig ist, dass alle drei Fälle vom selben Mechanismus profitieren. Das Modell plant, prüft sich selbst und korrigiert den eigenen Kurs, statt linear durchzuschreiben. Warum diese Selbstüberwachung funktioniert und wie du sie gezielt anstößt, habe ich im Beitrag über [Metacognitive Scaffolding bei Reasoning-Modellen](https://t01.li/ki-systemdesign/metacognitive-scaffolding-bei-reasoning-modellen/) beschrieben. Kurzfassung für hier – Reasoning lohnt sich dort, wo der Weg zur Antwort selbst Arbeit ist. Wo der Weg trivial ist, bezahlst du Selbstzweifel im Leerlauf.
## Warum Denk-Tokens keine Qualitätssicherung ersetzen
Ein verbreiteter Irrtum lautet, mehr Nachdenken bedeute automatisch weniger Fehler – das Reasoning-Modell als eingebautes QA-Gate. Die Forschung zeichnet ein unbequemeres Bild. Eine Untersuchung zur sogenannten [„Thinking Trap](https://arxiv.org/abs/2506.23840?ref=t01.li)“ zeigt, dass Reflexions-Tokens wie „wait“ bei einfachen Aufgaben unnötige Backtracking-Schleifen auslösen, die das Ergebnis nicht verbessern und gelegentlich verschlechtern. Eine weitere Arbeit vom April beobachtet, dass Modelle jenseits von rund 7.000 Denk-Tokens [eher eine korrekte Antwort wieder verwerfen](https://arxiv.org/html/2604.10739v1?ref=t01.li), als eine neue zu finden – ein einzelnes Paper, noch ohne breite Replikation, aber die Richtung passt zum Rest der Befunde.
Reasoning reduziert bestimmte Fehlerklassen, etwa Rechen- und Planungsfehler in mehrstufigen Aufgaben. Es ersetzt weder automatisierte Tests noch die menschliche Prüfung, wo Fehler teuer werden – bei Verträgen, Angeboten, allem mit Rechtsfolgen. Wer die Denkphase als Qualitätssicherung verbucht, hat beides missverstanden.
## Routing statt Dauervollgas
Die bessere Antwort auf die Modellfrage lautet, sie gar nicht einmalig zu beantworten. Ein Router – im einfachsten Fall eine Handvoll Regeln, im ausgebauten Fall ein kleines Klassifikationsmodell – entscheidet pro Anfrage oder pro Workflow-Schritt, welches Modell übernimmt. In agentischen Workflows ist das ohnehin der natürliche Zustand, denn dort sortiert ein günstiges Modell die Eingaben, ein Reasoning-Modell plant die kniffligen Schritte und ein schnelles führt sie aus.
Die Ersparnis-Zahlen aus der Routing-Szene verdienen ein Sternchen, weil sie überwiegend von Anbietern und aus Benchmark-Setups stammen. Frameworks wie [*RouteLLM*](https://github.com/lm-sys/routellm?ref=t01.li) berichten eine Halbierung der Kosten bei 95 Prozent der Referenzqualität, Anbieter-Blogs nennen 40 bis 70 Prozent in Produktionsumgebungen – als Bandbreite plausibel, als Garantie Marketing. Solide belegt ist die andere Seite der Rechnung. Der Router selbst kostet je nach Bauart [unter einer bis etwa 100 Millisekunden](https://www.digitalapplied.com/blog/llm-model-routing-2026-cost-quality-optimization-engineering-guide?ref=t01.li), gegen typische Antwortzeiten von 500 bis 2.000 Millisekunden fällt das nicht ins Gewicht.
Für den Einstieg reicht ein Entscheidungsbaum aus drei Fragen, die du pro Aufgabe einmal beantwortest:
1. **Was kostet ein Fehler?** Wenig (interne Zusammenfassung) → schnelles Modell. Viel (Vertrag, Kundenzusage) → Reasoning plus Mensch.
2. **Ein Schritt oder Abwägung?** Ein klar definierter Schritt → schnelles Modell. Mehrere Faktoren gegeneinander gewichten → Reasoning.
3. **Wie oft läuft die Aufgabe?** Bei hohem Volumen multipliziert sich jeder unnötige Denk-Token – im Zweifel erst das günstige Modell testen und nur bei nachgewiesenen Qualitätslücken hochstufen.
Bleibt der Einwand, die Anbieter hätten das Problem doch längst erkannt – adaptives Thinking ist ja genau die eingebaute Drossel, die den Denkaufwand an die Aufgabe anpassen soll. Stimmt, und es ist ein Fortschritt gegenüber festen Token-Budgets. Ein Freifahrtschein ist es nicht, denn der Anbieter optimiert auf Antwortqualität über alle Kunden hinweg, nicht auf deine Kostenstruktur. Ob ein Support-Ticket 200 Denk-Tokens wert ist, entscheidet besser dein Prozess als der Default eines Herstellers, der pro Token verdient.
### Erst Aufgabe, dann Modell
Die Faustregel für den Alltag passt in zwei Sätze. Routine läuft auf dem schnellsten Modell, das den Job nachweislich erledigt – nachweislich heißt getestet, nicht vermutet. Reasoning bekommen die Aufgaben, bei denen der Weg zur Antwort echte Abwägung verlangt, und überall dort, wo Fehler teuer werden, sitzt zusätzlich ein Mensch davor.
Der Hot Take am Schluss: Die Frage „welches Modell nehmen wir“ ist 2026 ungefähr so sinnvoll wie die Frage „welches Fahrzeug nimmt unsere Firma“. Der Außendienst fährt Kombi, die Lagerlogistik Stapler, und niemand käme auf die Idee, beides durch einen Sportwagen zu ersetzen, weil der in Tests am schnellsten war. Wer seine KI-Kosten senken will, braucht kein besseres Modell. Er braucht eine Zuordnung.
### LogWerk – weil ich nur sehen wollte, welche Bots den Log vollmüllen
URL: https://t01.li/geo-seo/logwerk-weil-ich-nur-sehen-wollte-welche-bots-den-log-vollmullen/
Last updated: 2026-09-10T06:34:12.000Z
Ich habe mir eine gefühlte Ewigkeit einen Wolf nach einem vernünftigen Tool für Server-Logfiles gesucht. Irgendwann landet man bei den üblichen Verdächtigen, und ganz oben standen GoAccess und Logdy – beide sehr mächtig, beide etablierte Pakete, beide für meinen Fall mit Kanonen auf Spatzen geschossen.
Denn ich wollte eigentlich nur eine `access.log` irgendwo reinziehen und in Sekunden sehen, welche Bots da wo ihr Unwesen treiben, wegen [GEO](https://t01.li/generative-engine-optimization-geo/) und so. Kein Monitoring-Stack, kein Dauerbetrieb, kein weiteres Ding, das permanent läuft. Also habe ich mir so ein Teil selbst gebaut – *LogWerk*.
Beziehungsweise bauen lassen – den Code hat das frisch erschienene [*Claude Sonnet 5*](https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/) geschrieben. Ein Frontend ohne Backend und Build-Step ist genau die Sorte Aufgabe, an der ein Coding-Agent glänzt – überschaubarer Scope, keine exotischen Libraries im Stack, klares Ziel, sofort im Browser testbar.
## TL;DR
*LogWerk* ist ein browser-basierter Server-Log-Analyzer, den ich gebaut habe, weil mir *GoAccess* und *Logdy* für den schnellen Blick ins Log zu viel Setup waren.
- Läuft komplett im Browser, deine Log-Daten bleiben lokal – kein Backend, keine Datenbank.
- Erkennt 60 Bots namentlich, inklusive KI-Crawler wie GPTBot, ClaudeBot und PerplexityBot.
- Nginx/Apache-Presets, Custom-RegEx, Offline-Geo-IP, Session-Timelines, CSV-Export.
- Version 1.2, MIT-lizenziert und ausbaufähig – Feedback und Issues im GitHub-Repo erwünscht.
## Warum mir die üblichen Verdächtigen zu viel waren
[*GoAccess*](https://goaccess.io/?ref=t01.li) ist ein Klassiker, und das zu Recht. Echtzeit-Analyse, Terminal-UI, auf Wunsch ein self-contained HTML-Report. Genau da fing für mich das Problem an. Die Bedienung läuft primär übers Terminal, und für den laufenden Betrieb landet man schnell bei einem installierten Binary oder einem Container. Ich wollte für eine schnelle Log-Auswertung, aber weder das eine kompilieren noch das andere hochziehen.
[*Logdy*](https://logdy.dev/?ref=t01.li) ist eleganter, als ich zuerst dachte – ein einzelnes Binary, das man in den PATH legt und das eine lokale Web-UI auf einem Port startet. Nur ist es eher fürs Live-Tailing von App-Logs gebaut als für die Frage, was in dieser einen `access.log` von heute Morgen eigentlich steht. Auch hier läuft am Ende ein Prozess, den ich für einen Fünf-Minuten-Blick nicht starten wollte.
Beide lassen die Daten übrigens auf der Maschine. Dieser Punkt gehört also nicht *LogWerk* allein, und ich verkaufe hier keinen Vorteil, den es nicht hat.
## Was LogWerk ist – und was nicht
*LogWerk* ist eine einzelne HTML-Seite. Drei ES6-Module, kein Backend, keine Datenbank, kein Build-Step. Du ziehst deine Logdatei in die Dropzone, das Parsing passiert komplett im Browser und in Häppchen, damit auch ein fettes File die Oberfläche nicht einfriert. Als Presets kommen Nginx/Apache Combined (Default), Apache Common und ein eigenes Custom-RegEx-Muster mit.
Was es nicht ist, ist ein Echtzeit-Monitor. Es ersetzt *GoAccess* nicht, wenn du ein Live-Dashboard mit WebSocket-Updates brauchst. Es ist für den Blick zurück gedacht, nicht für die Dauerüberwachung.

Das LogWerk Dashboard
## Der eigentliche Grund – wer crawlt hier überhaupt
Hier wird es für alle interessant, die sich mit GEO und SEO beschäftigen. *LogWerk* erkennt 60 benannte Bot-Signaturen und sortiert sie nach Anbieter und Zweck – Such-Indexer, SEO-Tools, Social-Media-Previews, Fediverse-Crawler, Security-Scanner. Alles, was durchs Raster fällt, aber nach Bot riecht, fängt ein generischer Fallback ab. Der Teil, der mich getrieben hat, sind primär die KI-Crawler.
GPTBot und ChatGPT-User von OpenAI, ClaudeBot von Anthropic, PerplexityBot, Amazonbot, der Meta-ExternalAgent – die tauchen in deinem Access-Log auf, lange bevor irgendein Dashboard dir davon erzählt. Die Google Search Console zeigt dir das nicht. Wer wissen will, ob und wie oft die KI-Crawler die eigenen Inhalte abgreifen, muss ins rohe Log. Filter auf „Bots Only“, Dropdown auf den konkreten Bot, fertig.

LogWerk Bot-Listing
Dass ein KI-Crawler deine Seite liest, heißt aber noch lange nicht, dass daraus [etwas zurückkommt](https://t01.li/geo-seo/geo-citations-bringen-keine-conversions/) und das Log macht diese Ernüchterung schnell sichtbar. Trotzdem ist es die ehrlichste Datenquelle, die du hast – näher als die server-eigenen Logs geht nicht.
Dazu kommen ein paar Dinge, die den Alltag angenehm machen. Offline-Geo-IP-Badges zeigen dir pro Request das Herkunftsland, ohne dass eine Anfrage rausgeht. Eine Session-Rekonstruktion gruppiert Requests per Fingerprint aus IP und User-Agent in chronologische Timelines, mit einer halben Stunde Inaktivität als Trennlinie. Filtern und suchen kannst du nach IP, Pfad, Status, Referer oder User-Agent, und das gefilterte Set exportierst du als CSV. Weil das letzte Log in der IndexedDB landet, ist es nach einem Reload einfach wieder da. Die Oberfläche spricht sechs Sprachen, umschaltbar zur Laufzeit.
Wie repräsentativ diese Bot-Liste ist, sehe ich an meinen eigenen Logs. Die allermeisten Signaturen, die *LogWerk* kennt, tauchen auch in diesem Blog auf – KI-Crawler, SEO-Spider, Fediverse-Bots, quer durch. Warum ein überschaubarer Blog aus der DACH-Ecke von diesem ganzen Zoo abgegrast wird, woher die alle kommen und was sie davon haben, weiß ich bis heute nicht. Sie sind eben so da und schauen gelegentlich mal rein. Wobei der OAI-SearchBot hier mit Abstand am fleißigsten ist.

LogWerk Detailansicht
## Wie du es startest – die eine Hürde
Ganz ohne Reibung geht es nicht, und das sage ich lieber vorher. Moderne Browser blocken das Laden lokaler JS-Module über das `file://`\-Protokoll, eine CORS-Sicherheitsregel. Es gibt zwei Wege drumherum.
Der saubere Weg ist ein lokaler Static-Server. `python3 -m http.server 8000` im Projektordner, dann `localhost:8000` im Browser – `npx serve` oder `php -S` tun es genauso.
Der schnelle Weg ist Safari-spezifisch. Entwickler-Features aktivieren, unter „Entwickeln“ die lokalen Dateibeschränkungen deaktivieren, `index.html` doppelklicken. Wer stattdessen Chrome ohne Server aufmacht, rennt allersings gegen die Wand.
Zugegeben: Das ist die eine Stelle, an der „einfach im Browser öffnen“ nicht ganz korrekt ist.
## Ehrlich unfertig
Version 1.2, noch nicht fertig abgehangen, und eigentlich müsste die Versionsnummer ehrlicherweise aktuell noch eine 0 anstatt einer 1 davor haben. Aber da ich sonst jeden Hersteller-Claim sportlich seziere, mache ich das beim eigenen Tool auch. Im README steht „offline-first“, und das braucht eine Einordnung. Deine Log-Daten verlassen den Browser nicht, das stimmt und ist der Kern. Tailwind, Chart.js und die Fonts kommen aber per CDN, für den ersten Load brauchst du also Internet. „Lokal“ ja, „komplett ohne Netz“ nein.
An der einen oder anderen Stelle wird außerdem noch eine Ungereimtheit auftauchen. Ist mir bewusst, ist v1.2, und ausbaufähig ist das Ding sowieso. Es rennt für meinen Geschmack schnell, aber das ist ein Erfahrungswert, keine gebenchte Zahl.
### Nimm es, tritt dagegen
Das Teil ist MIT-lizenziert und liegt offen im [Repo](https://github.com/abbottis/logwerk?ref=t01.li). Wenn du eine `access.log` schnell auswerten willst, ohne dafür Infrastruktur anzufassen, nimm es. Und wenn dir etwas auffällt – es wird dir etwas auffallen – dann öffne ein Issue auf Github, statt es für dich zu behalten. Genau dafür ist es öffentlich.
### Hot Take
Das schlankeste Tool gewinnt keinen Funktionsvergleich gegen *GoAccess*. Aber es ist das, das ich tatsächlich öffne, wenn ich in zwei Minuten wissen will, wer da crawlt – und benutzt schlägt mächtig.
[GitHub - abbottis/logwerk: LogWerk is a lightweight, offline-first server log analyzer dashboard that runs entirely in your web browser.LogWerk is a lightweight, offline-first server log analyzer dashboard that runs entirely in your web browser. - abbottis/logwerkGitHubabbottis](https://github.com/abbottis/logwerk?ref=t01.li)
### AI Picks der 27. KW
URL: https://t01.li/ai-shorts/ai-picks-der-27-kw/
Last updated: 2026-08-07T09:44:45.000Z
Diese Woche weniger Modelle. *Sonnet 5* habe ich [separat behandelt](https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/), und *Nano Banana 2* sowie *Omni Flash* gehen ein bisschen an meinen Schwerpunktthemen vorbei. Genug anderes mit Nachrichtenwert liegt trotzdem herum, auch wenn die Flut saisonbedingt gerade etwas zurückgeht. Los geht's.
## Redeploying Fable 5
Diese Woche kam frisch [*Sonnet 5*](https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/), und wenige Tage später war auch *Fable 5* wieder da – das Modell, das die US-Regierung im Juni hatte abschalten lassen. Zunächst klang die Rückkehr nach einem stillen „Deal“ zwischen Anthropic und Washington. Tatsächlich liegt die Sache offener, als der Gerüchteweg vermuten lässt.
Die Reihenfolge war so: Am 12\. Juni hatte die US-Regierung per Exportdirektive – auf Basis einer Executive Order vom 2\. Juni – den Zugang für Nicht-US-Bürger gekippt, woraufhin Anthropic das Modell für alle offline nahm. Die ganze Vorgeschichte mit Amazon als Melder steht in den [Picks der 24\. KW](https://t01.li/ai-shorts/ai-picks-der-24-kw/). Am 30\. Juni wurden diese Kontrollen wieder [aufgehoben](https://www.anthropic.com/news/redeploying-fable-5?ref=t01.li), verkündet hat das Commerce Secretary Howard Lutnick per X. Seit dem 1\. Juli ist *Fable 5* wieder global verfügbar, *Mythos 5* seit dem 26\. Juni für einen Kreis von US-Organisationen.
Interessant ist, was Anthropic drumherum gebaut hat. Ein neuer Safety-Classifier fängt die von Amazon gemeldete Technik nach eigenen Angaben in über 99 % der Fälle ab und reicht blockierte *Fable*\-Anfragen still an [*Opus 4.8*](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/) weiter. Dazu kommt ein branchenweites Framework zur Bewertung von [Jailbreak](https://t01.li/glossar/#jailbreak)\-Schwere, gemeinsam mit Amazon, Microsoft und Google. Die 99 % sind eine herstellereigene Zahl, unabhängig nachgemessen hat das niemand.
Der eigentliche Seitenhieb steckt im Kleingedruckten. Anthropic schreibt selbst, dass schwächere Modelle wie *Opus 4.8*, [*GPT-5.5*](https://t01.li/ki-news/gpt-5-5-instant-als-neuer-chatgpt-default-mit-deutlich-weniger-halluzinationen/) und *Kimi K2.7* dieselben Schwachstellen fanden und jedes getestete Modell die eine Exploit-Demo reproduzieren konnte. Der Fund, der ein weltweit ausgerolltes Frontier-Modell offline geschickt hat, war also nichts, was nur *Fable* konnte.
Heißer Take: Das Modell ist zurück, der Präzedenzfall bleibt. Ein einzelner gemeldeter Bypass reicht, um ein kommerzielles Modell weltweit abzuschalten – und die nachgereichte Erklärung, es sei halb so wild gewesen, macht die Sache nicht wirklich beruhigender, sondern nur absurder.
## Claude Code Is Steganographically Marking Requests
Mehr Anthropic-Gossip, [weil das so langsam Tradition wird](https://t01.li/ai-shorts/ai-picks-der-26-kw/#anthropic-says-alibaba-must-be-punished-for-largest-claude-cloning-attack).
thereallo – er, sie, man weiß es nicht genau, spielt aber auch keine Rolle – hat sich angesehen, was Claude Code eigentlich mit den Requests macht, die hinten rausgehen. Herausgekommen ist, dass der ins System-Prompt injizierte Datums-String still mit sichtbaren und teils unsichtbaren Unicode-Markierungen versehen wird.
Ein Beispiel ist noch offensichtlich. Das Trennzeichen im Datum wechselt von `2026-06-30` zu `2026/06/30`, gesteuert über einen Timezone-Check auf `Asia/Shanghai` oder `Asia/Urumqi`. Subtiler wird es beim Apostroph in einem String wie „Today's“, das je nach Hostname- und Keyword-Prüfung durch verschiedene Unicode-Varianten ersetzt wird. Ausgelöst wird der Mechanismus, wenn `ANTHROPIC_BASE_URL` auf einen Endpoint abseits des offiziellen zeigt.
thereallo vermutet dahinter den Versuch, API-Wiederverkäufer, nicht autorisierte Claude-Code-Gateways und Modell-Pipelines für Destillationsangriffe zu identifizieren. Klingt plausibel und passt ins Bild der letzten Wochen. Den Haken benennt thereallo in seinem [Blogpost](https://thereallo.dev/blog/claude-code-prompt-steganography?ref=t01.li) selbst. Der Bypass ist trivial, und wer damit auffällt, sind vor allem normale Entwickler, die legitime, aber ungewöhnliche Dinge tun. Wer wirklich klont, umschifft so eine Markierung im Zweifel als Erstes.
## Introducing OpenWiki
Nach dem großen Hype um Web 2.0 Ende der 2000er war ein Thema ziemlich von der Bildfläche verschwunden: das Wiki. Jetzt entdeckt man es wieder, weil auffällt, dass das mit dem kontextbasierten, gegenseitigen Verlinken von Entitäten in Knowledge-Artikeln nicht die schlechteste Idee war. Das dachte sich wohl auch [LangChain und hob *OpenWiki*](https://www.langchain.com/blog/introducing-openwiki-an-open-source-agent-for-repo-documentation?ref=t01.li) aus der Taufe.
*OpenWiki* generiert ein Repo-Wiki und trägt anschließend in die [Instruction-Files](https://t01.li/glossar/#agentic-instruction-file) wie AGENTS.md und CLAUDE.md einen Verweis darauf ein. Von dort findet der Coding-Agent die Dokumente allein und nutzt sie. Unter der Haube läuft das auf DeepAgents, eine GitHub Action hält das Wiki per git-diffs auf Stand. Open Source unter MIT-Lizenz, das [Repo liegt auf GitHub](https://github.com/langchain-ai/openwiki?ref=t01.li).
## Learn how coding agents are built
Wo ich über den Link gestolpert bin, weiß ich leider nicht mehr. *Tau* ist ein schlanker Python-[Coding-Agent](https://t01.li/glossar/#coding-agent), den [twotimespi.dev](https://twotimespi.dev/?ref=t01.li) bewusst zum Lernen gebaut hat – man liest ihn wie ein Lehrbuch. Aufgeteilt ist er in drei Schichten: `tau_ai` für die Provider-Abstraktion, `tau_agent` für den Agent-Loop und `tau_coding` für die eigentliche Coding-Umgebung mit Files, Shell und Skills.
Inspiriert ist das Ganze von Pi, der [Harness](https://t01.li/glossar/#harness), die mir schon beim [Omnigent-Pick der 24\. KW](https://t01.li/ai-shorts/ai-picks-der-24-kw/) über den Weg lief. Installiert wird per `uv tool install tau-ai`. Wer verstehen will, was in Claude Code und Co. unter der Oberfläche passiert, findet hier den Kurzweg ohne [Framework](https://t01.li/glossar/#agentic-framework)\-Ballast.
## Introducing ZCode
Z.ai wirft *ZCode* mit eigener Harness für [*GLM-5.2*](https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/) in den Ring, im Marketing-Sprech eine Desktop-App, mit der du „plan, code, review, and deploy without friction“ sollst. Viel mehr an Substanz gibt die [Ankündigung](https://x.com/Zai%5Forg/status/2072349453361557898?ref=t01.li) nicht her.
Immerhin die harten Fakten: eine Electron-App für macOS, Windows und Linux, letzteres noch Beta, und laut Tweet auch mit den eigenen Abos und APIs nutzbar. Auf der [Produktseite](https://zcode.z.ai/en?ref=t01.li) selbst steht davon wenig, da wird vor allem der GLM Coding Plan beworben. Das Versprechen „nimm dein eigenes Modell mit“ und die Seite, die dir das hauseigene Abo unterschieben will, passen nicht ganz so zusammen.
## 10 Agentic AI Frameworks You Should Know in 2026
KDnuggets hat eine [Übersicht rausgehauen](https://www.kdnuggets.com/10-agentic-ai-frameworks-you-should-know-in-2026?ref=t01.li), wenig Überraschendes, aber eine solide Aufstellung: LangGraph, CrewAI, das OpenAI Agents SDK, Googles ADK, *PydanticAI*, smolagents, Mastra, Microsofts Agent Framework, Strands und LlamaIndex Workflows.
Einiges davon war mir neu, *PydanticAI* zum Beispiel (wohl auch, weil bei uns die Anforderungen an so etwas bisher nicht auf dem Tisch lagen). Von LangChain schaue ich mir gerade neben den Open-Source-Frameworks auch die Bezahllösungen näher an, weil sie vieles abdecken würden, was wiederum bei uns aktuell anfällt, und weil die Doku ordentlich ist. Das erspart Frickelei.
## Extending the LlamaParse MCP
Neue Woche, neue LlamaIndex-Meldung. Nach dem [n8n-Node vergangene Woche](https://t01.li/ai-shorts/ai-picks-der-26-kw/#bring-your-document-workflows-to-n8n-with-the-llamaparse-node) legt der [hauseigene MCP nach](https://www.llamaindex.ai/blog/extending-the-llamaparse-mcp-for-more-document-processing-power?ref=t01.li): Mit `generateExtractionConfig` gibt es ein Command, das ein JSON-Schema plus Extraktionsregeln erzeugt, die du dann an `extractFile` übergibst. Lässt du einen Agenten darauf los, eröffnet das einen Wandschrank an Optionen.
Nebenbei haben sie eine Erkenntnis verarbeitet, die naheliegt und trotzdem selten beherzigt wird. Stopfst du einen [MCP](https://t01.li/glossar/#mcp) mit Features voll, blickt da irgendwann keiner mehr durch. Also haben sie die Struktur in produktspezifische Endpoints zerlegt, für Parsing, Extraction, Indexing usw. Das nenne ich doch mal sauber gelöst. Der neue Index v2 bringt obendrein file-orientierte Tools mit, mit denen ein Agent gezielt einzelne Dateien aus einem Index greift, statt alles in den [Kontext](https://t01.li/glossar/#kontextfenster) zu kippen.
## Introducing TabFM
Google veröffentlicht mit [*TabFM*](https://research.google/blog/introducing-tabfm-a-zero-shot-foundation-model-for-tabular-data/?ref=t01.li) ein Foundation-Model für tabellarische Daten, für Klassifikation und Regression, und spricht von „[Zero-Shot](https://t01.li/glossar/#zero-shot)“. Hinter dem Schlagwort steckt In-Context-Learning. Das Modell bekommt den kompletten Datensatz als einen Prompt und sagt in einem einzigen Forward-Pass voraus, ohne Feature-Engineering, ohne Hyperparameter-Tuning, ohne Nachtrainieren. Das gleiche Prinzip hat Google mit TimesFM schon bei Zeitreihen gefahren.
Trainiert wurde ausschließlich auf Hunderten Millionen synthetischer Datensätze. Gemessen wird auf TabArena, einem Drittanbieter-[Benchmark](https://t01.li/glossar/#benchmark), und dort reklamiert Google die Spitze gegen getuntes XGBoost – was man als herstellereigene Platzierung mit dem üblichen Sternchen lesen darf. Die [Model Card liegt auf Hugging Face](https://huggingface.co/google/tabfm-1.0.0-pytorch?ref=t01.li), eine BigQuery-Integration über `AI.PREDICT` ist angekündigt.
## Neue Procedures in ElevenAgents
In ElevenAgents gibt es jetzt [Procedures](https://elevenlabs.io/de/blog/procedures?ref=t01.li). So wie ich das lese, ist das ein SOP-Layer: Schritt-für-Schritt-Anweisungen für definierte Szenarien wie Rückerstattung oder Support, entweder in natürlicher Sprache formuliert oder aus bestehenden SOPs importiert. Das Ganze gehört zu Guardrails 2.0 und läuft noch im Alpha.
Wichtig zur Einordnung, weil man das leicht in einen Topf wirft: Die Procedures sind die Aufgaben-Schicht, die eigentlichen [Guardrails](https://t01.li/glossar/#guardrails) wie Focus, Manipulation und Content sind die Durchsetzung daneben. Beides kam zusammen raus, ist aber nicht dasselbe. Eigene Erfahrungswerte mit ElevenLabs fehlen mir aktuell mangels Anwendungsfällen, das der Ehrlichkeit halber dazu erwähnt.
## OpenAI teasert erste Hardware
OpenAI [auf X](https://x.com/OpenAIDevs/status/2071639953927438440?ref=t01.li) so:
> „Your favorite Codex shortcuts are getting an upgrade. July 15th.“
Dazu ein Teaser-Video mit einem quadratischen, in Farben leuchtenden Tastenfeld.
Ich hatte kurz das hart angekündigte Teil von Jony Ive im Verdacht, aber das ist es nicht. Die erste ausgelieferte OpenAI-Hardware ist ein Macro-Pad namens *Codex Micro*, gebaut mit Work Louder auf Basis von deren Creator Micro 2, im Grunde ein [Stream Deck](https://www.elgato.com/de/de/p/stream-deck?ref=t01.li) für Codex-Shortcuts, mit 199 Dollar als Preisanker. Das große Ive-Gerät ist ein anderes Projekt und wie man so hört und liest frühestens im Februar 2027 zu erwarten.
Ganz ehrlich: Mich berührt das gerade so überhaupt gar nicht. Ein Brett mit physischen Tasten für einen Workflow, der eigentlich auf natürlicher Sprache aufsetzt, löst ein Problem, das die Software längst gelöst hat. Am 15\. Juli müssen sie dann schon schwere Geschütze auffahren, um mich noch irgendwie abzuholen.
## Cybersecurity and LLMs
Das Wichtigste aus dem [ganzen Artikel](https://www.artificial-intelligence.blog/ai-news/cybersecurity-and-llms?ref=t01.li) steht gleich am Anfang:
> „… stops being a helper and starts becoming part of your attack surface.“
Gemeint ist der Moment, in dem ein Chatbot Systemzugriff bekommt. Der Text frühstückt danach die Albtraum-Palette einmal komplett ab, von [Prompt Injection](https://t01.li/glossar/#prompt-injection) über Excessive Agency bis zu RAG-Leaks und der ganzen OWASP-LLM-Top-10\. Kein Deepdive, aber ein guter Reminder, woran man denken sollte.
Ein Bonus am Rande, den man sich nicht ausdenken kann: Der Blog ist nach eigener Auskunft komplett KI-geschrieben. Eine KI erklärt dir, warum die KI mit Systemzugriff zu deinem Angriffsvektor wird. Die Warnung nimmst du trotzdem besser ernst, die Quelle liest du am besten mit einem Schmunzeln im Hinterkopf.
Und damit Feierabend für diese Woche.
### QA-Gates in LLM-Pipelines: Welche Output-Sicherung wirklich hält
URL: https://t01.li/ki-systemdesign/qa-gates-llm-output-sicherung/
Last updated: 2026-07-22T10:23:15.000Z
Es gibt eine ganze Gattung von Prompts, die mehr wollen, als nur etwas zu erzeugen – sie sollen sich beim Schreiben gleich selbst auf die Finger schauen, mit Markern für ungeprüfte Behauptungen, mit Validierungs-Rollen, mit Wartezuständen vor der Ausgabe, manche sogar mit einem ganzen Tribunal aus fünf simulierten Experten. Das Versprechen dahinter ist über alle Spielarten dasselbe: Am Ende kommt nichts Falsches raus. Ich baue solche Prüf-Prompts selbst, und genau deshalb lässt mich die unbequeme Frage nicht los, die unter dem Versprechen liegt – welcher dieser Prüfschritte sichert tatsächlich etwas ab, und welcher tut nur so?
Das ist keine akademische Spitzfindigkeit. Solche Prüfschritte heißen QA-Gates, und wer den Output einer Pipeline weiterverarbeitet, baut seine ganze Output-Sicherung auf sie. Wenn die Hälfte davon Theater ist, verlässt man sich auf Theater.
## TL;DR
Ein QA-Gate ist jeder Prüfschritt zwischen Generierung und Export. Welcher davon wirklich sichert, hängt davon ab, wie weit er vom generierenden Modell wegsitzt.
- Theater-Gates: Das Modell prüft sich selbst und täuscht Kontrolle vor, die es nicht gibt.
- Weiche Gates: Selbstprüfung senkt die Fehlerquote, garantiert aber nichts.
- Harte Gates: laufen außerhalb des Modells und sichern verlässlich – aber nur die Form, nicht die Wahrheit.
- Faustregel: Je weiter ein Gate vom generierenden Modell wegrückt, desto mehr sichert es. Am Ende steht trotzdem ein Mensch.
## Was ein Gate aus der Softwareentwicklung mitbringt
Der Begriff Quality Gate kommt nicht aus der KI-Welt, sondern aus der Softwareentwicklung, wo ein Werkzeug wie *SonarQube* in der CI/CD-Pipeline den Code gegen definierte Schwellen prüft und den Build abbricht, sobald eine davon reißt. Kein Durchkommen, keine Diskussion. Das Gate ist deterministisch: gleiche Eingabe, gleiches Urteil.
Übertragen auf eine [LLM-Pipeline](https://t01.li/glossar/#llm-pipeline) meint ein QA-Gate jeden Prüfschritt zwischen Generierung und Export. Klingt super sauber, aber der Haken steckt im Wort „deterministisch“. Denn die wenigsten Gates, die in Prompts eingebaut werden, sind das auch.
## Die Hierarchie: drei Sorten Gates
Die nützlichste Sortierung läuft nicht nach Funktion, sondern nach Abstand. Wie weit sitzt das Gate vom Modell weg, das den Text erzeugt hat?
Ganz nah dran sitzen die Theater-Gates – Prüfschritte, die im Prompt stehen und vom selben Modell ausgewertet werden, das gerade den Text produziert hat. Eine Stufe weiter liegen die weichen Gates, bei denen das Modell sich selbst prüft, was die Fehlerquote senkt, aber nichts garantiert. Und außerhalb des Modells, mit eigener Mechanik, sitzen die harten Gates. Nur die letzte Sorte verdient den Namen Gate im Sinne der Softwareentwicklung.
### Theater-Gates – Kontrolle, die nur so aussieht
Hier beginnt der Hokuspokus, und er ist erstaunlich verbreitet.
Ein Prompt weist das Modell an, vor jeder Analyse zu prüfen, ob „mindestens 2.000 Tokens freier [Kontext](https://t01.li/glossar/#kontextfenster)“ vorhanden sind, und andernfalls abzubrechen. Das liest sich wie eine Schutzvorrichtung, ist aber keine, denn ein Modell kann seinen eigenen Tokenstand gar nicht messen – das Bewusstsein für das eigene Kontextfenster fehlt ihm, und so quittiert es brav mit „Check bestanden“, schlicht weil der Prompt es verlangt. Inszenierte Kontrolle, mehr nicht.
Noch schöner sind Prompts mit eingebautem Pseudocode, der suggeriert, der Output werde fünfmal analysiert und daraus per Standardabweichung und Mittelwert ein Konfidenz-Level berechnet. In einem einzigen Completion-Durchlauf passiert keine dieser Rechnungen, das Modell nennt am Ende einfach eine plausibel klingende Zahl mit einem Label daneben. Konfabulierte Präzision in Reinform.
Und dann der Klassiker: ein „Warte auf Go“-Zustand, beschrieben wie eine State-Machine, durchgesetzt vom selben Modell, das den Text erzeugt. Eine echte State-Machine hält an, weil ihr Code sie anhält; ein Modell dagegen hält an, weil es gerade so kommt – oder eben nicht. Ein Soft-Constraint mit Schranken-Cosplay.
Was diese drei Beispiele eint, ist derselbe Trick: Sie verlagern eine Kontrolle, die mechanisch und damit überprüfbar wäre, in die Selbstauskunft des Modells. Und Selbstauskunft ist genau das, worauf man sich am wenigsten verlassen kann.
### Weiche Gates – senken die Quote, garantieren nichts
Zwischen Theater und echter Schranke liegt ein Feld, das tatsächlich etwas bringt, nur eben weniger, als draufsteht. Selbst vergebene Marker für ungeprüfte Behauptungen, ein Critique-Durchgang, ein „prüfe deine Antwort noch einmal“ – solche Schritte verschieben die Wahrscheinlichkeit in Richtung weniger Fehler. Ein Garant sind sie nicht.
Die Forschung ist hier ungewöhnlich eindeutig. Eine vielzitierte Untersuchung von [Huang und Kollegen](https://arxiv.org/abs/2310.01798?ref=t01.li) zeigt, dass intrinsische Selbstkorrektur ohne externes Feedback das Reasoning nicht verlässlich verbessert, und dass in etlichen Fällen das Ergebnis nach der Selbstkorrektur sogar schlechter ausfällt als davor. Das Modell redet sich seine richtige Antwort kaputt.
Der eigentliche Knackpunkt liegt eine Ebene tiefer. [Tyen und Co](https://aclanthology.org/2024.findings-acl.826/?ref=t01.li) fanden heraus, dass Modelle einen Fehler durchaus beheben können, sobald man ihnen die Fehlerstelle nennt, ihn aber selbst kaum finden. Übersetzt auf Gates heißt das, dass die Abwesenheit eines `[PRÜFEN]`\-Markers kein Beleg für Fehlerfreiheit ist – das Modell hat den Fehler vielleicht schlicht nicht gesehen. Strukturierte Denk-Anstöße im Prompt helfen da nur begrenzt, und auch das [nur bei bestimmten Aufgaben](https://t01.li/ki-systemdesign/metacognitive-scaffolding-bei-reasoning-modellen/).
Besonders fragwürdig wird es, wenn das weiche Gate als „zweiter Experte“ im selben Prompt auftritt, gespeist vom selben Modell, das schon den Text geschrieben hat. Dann greift der Self-Preference Bias: Modelle bewerten ihre eigenen Ausgaben systematisch zu gut, [auch wenn die Quelle anonymisiert ist](https://arxiv.org/abs/2410.02736?ref=t01.li). Ein Prüfer, der sich selbst prüft, ist ein milder Prüfer. Und die zugewiesene Experten-Rolle ändert daran nichts, weil sie [Stil verschiebt, nicht Kompetenz](https://t01.li/ki-systemdesign/ziel-schlagt-rolle-warum-der-rollenbaustein-im-prompt-ausgedient-hat/) – ein „Du bist strenger Fakten-Prüfer“ macht das Modell nicht zu einem, es färbt nur den Ton seiner Selbstbestätigung.
### Harte Gates – außerhalb des Modells
Jetzt die Sorte, die hält. Gemeinsamer Nenner: Sie laufen nicht im Kopf des generierenden Modells, sondern daneben.
Das simpelste harte Gate ist eine Verbotsliste per Regex, die ein Stück Code den Export blockieren lässt, sobald ein Begriff auftaucht, der nicht raus darf – stumpf, aber zuverlässig, weil deterministisch.
Eine Stufe darüber stehen [Structured Outputs](https://t01.li/glossar/#structured-output) über [Constrained Decoding](https://t01.li/glossar/#constrained-decoding), bei denen der Decoder nicht das Modell höflich um valides JSON bittet, sondern bei jedem Token alle Optionen wegmaskiert, die das Schema verletzen würden. Das [garantiert Schema-Konformität per Konstruktion](https://bentoml.com/llm/getting-started/tool-integration/structured-outputs?ref=t01.li), nicht „meistens“, sondern immer. OpenAI bietet das seit August 2024 als Strict Mode, Anthropic seit November 2025, lokal liefern *Outlines*, *XGrammar* und *Guidance* dasselbe. Welches Format am Ende sinnvoll ist, hängt am Anwendungsfall, dazu habe ich die [gängigen LLM-Datenformate](https://t01.li/ki-systemdesign/llm-datenformate-json-yaml-xml-toon-html-im-vergleich/) an anderer Stelle gegeneinandergestellt.
Das härteste Urteils-Gate ist ein separater Judge mit einem anderen Modell, denn sobald Generierung und Bewertung auseinanderfallen, schrumpft der Self-Preference-Bias. Eine Warnung bleibt: Teilen sich beide Modelle dieselbe Trainingslinie, [ist die Selbstbevorzugung systematisch über den ganzen Pool und innerhalb des Pools nicht erkennbar](https://mbrenndoerfer.com/writing/position-bias-in-llm-judges?ref=t01.li). Ein Judge aus derselben Modellfamilie ist also nur ein halbes Gate.
In dieselbe Kategorie gehört echtes [Self-Consistency](https://t01.li/glossar/#self-consistency), das oft mit dem Theater-Pendant verwechselt wird, obwohl es etwas grundlegend anderes tut. Die [Methode von Wang und Kollegen](https://arxiv.org/abs/2203.11171?ref=t01.li) erzeugt mehrere getrennte Reasoning-Pfade per Sampling und aggregiert sie extern per Mehrheitsvotum, und der entscheidende Unterschied liegt genau hier: getrennte Generierungen plus ein externer Aggregationsschritt, nicht „bewerte dich im selben Prompt fünfmal“. Es greift nur, wenn die Aufgabe eine aggregierbare Antwort hat, und es fängt zufällige Ausrutscher, keinen systematischen Fehler, der in allen Pfaden gleich auftritt. Wer beim Sampling ohnehin an der [Diversität der Pfade](https://t01.li/ki-systemdesign/verbalized-sampling-oder-warum-einem-llm-die-ideen-ausgehen/) dreht, kennt die Mechanik schon.
Ein Detail noch, das die harte Schiene relativiert. Ein [Constraint](https://t01.li/glossar/#constraints) kann das Modell von seinen bevorzugten Tokens wegzwingen, und dann [leidet manchmal die Output-Qualität](https://mbrenndoerfer.com/writing/constrained-decoding-structured-llm-output?ref=t01.li) – das Gate hält die Form, kostet aber gelegentlich Substanz. Genau wie bei [Constraint-Based Prompting](https://t01.li/ki-systemdesign/constraint-based-prompting-bei-reasoning-modellen-schadet-mehr-als-das-es-nutzt/) hängt der Nutzen am Modell und am Einsatzszenario, nicht an einer pauschalen Regel.
## Was Output-Sicherung tatsächlich bringt
Hier ist die Stelle, an der man ehrlich sein muss. Selbst das härteste Gate sichert die Form, nicht die Wahrheit. Ein per Constrained Decoding [erzwungenes JSON](https://t01.li/glossar/#json-mode) ist garantiert schema-konform und kann trotzdem inhaltlich falsche oder schlechte Werte enthalten, weil die Schranke nur prüft, ob das Feld da ist, und nicht, ob der Wert stimmt.
Output-Sicherung leistet also zwei Dinge und ein drittes nicht: Sie verschiebt Wahrscheinlichkeit, was die weichen Gates übernehmen, und sie sichert Form, was die Aufgabe der harten ist – Korrektheit aber garantiert keines von beiden. Wer das verinnerlicht, hört auf, Gates als Wahrheitsmaschine zu lesen, und fängt an, sie als das zu bauen, was sie sind: gestaffelte Filter mit unterschiedlicher Maschenweite.
Und genau deshalb gehört die Sicherung nicht in den Prompt, sondern in die Architektur, denn ein Marker im Systemprompt skaliert nicht, ein Schema-Check in der Pipeline schon. Das ist dieselbe Verschiebung, die [Spec-Driven Generation](https://t01.li/ki-systemdesign/spec-driven-generation-architektur-pattern/) vom Prompt-Trick zum Architektur-Pattern gemacht hat, und sie ist Teil dessen, was man heute [Context Engineering](https://t01.li/ki-systemdesign/context-engineering-prompt-engineering-baustein/) nennt. Die Frage ist nicht mehr, wie man das Modell höflich um Sorgfalt bittet, sondern welcher Schritt außerhalb des Modells den Output abfängt, bevor er Schaden anrichtet.
### Mein Take
Das beste Gate ist das, das das generierende Modell nicht selbst auswertet. Alles, was im Prompt steht und vom selben Modell abgenickt wird, ist bestenfalls ein Wahrscheinlichkeits-Schubser und schlimmstenfalls Bühnennebel, während die deterministischen Schranken daneben immerhin die Form sichern: dass das Feld da ist, dass kein Verbotswort durchrutscht, dass das JSON parst. An die Wahrheit kommt keine davon. Das kann nur ein urteilsfähiger Prüfer, ein anderes Modell als Judge oder der Mensch am Ende, und auch der irrt – er ist nur die einzige Instanz, die überhaupt die richtige Frage stellt, nämlich nicht „ist die Form korrekt“, sondern „stimmt das hier“. Wer mehr verspricht, verkauft Hokuspokus mit Pseudocode-Garnierung.
### Claude Sonnet 5 ist da – näher an Opus, aber mit Sternchen beim Preis
URL: https://t01.li/ki-news/claude-sonnet-5-agentisch-naeher-an-opus-mit-token-haken-beim-preis/
Last updated: 2026-07-08T19:31:44.000Z
*Claude Code* hat heute Abend an meinem Ghost-Theme weitergewerkelt, und ich hätte den Modellwechsel fast verschlafen. Erst eine Zeile im Terminal hat mich darauf gestoßen, dass da seit ein paar Minuten ein anderes Modell die Tasten führt. [*Claude Sonnet 5*, von Anthropic heute, am 30\. Juni, veröffentlicht](https://www.anthropic.com/news/claude-sonnet-5?ref=t01.li) – als das bislang agentischste Modell der Sonnet-Reihe.
Gut 30 Minuten nach Launch habe ich noch kein belastbares Urteil über die Qualität. Was ich habe, ist die Pressemitteilung – und die lohnt einen zweiten Blick, bevor man die Zahlen für bare Münze nimmt.
## TL;DR
Anthropic hat Claude Sonnet 5 veröffentlicht – das bislang agentischste Sonnet, ab sofort Standardmodell für Free und Pro.
- Bei „Humanity’s Last Exam“ (mit Tools) und GDPval-AA v2 liegt Sonnet 5 praktisch auf Opus-4.8-Niveau, beim harten Coding bleibt Opus vorn.
- Einführungspreis: 2 / 10 US-Dollar pro Million Token (In/Out) bis 31\. August, danach 3 / 15.
- Haken: Der neue Tokenizer mappt denselben Input auf bis zu das 1,35-Fache an Token – gegenüber dem Vorgänger Sonnet 4.6, nicht gegenüber Opus. Anthropic nennt den Umstieg „ungefähr kostenneutral“ – aber nur bis 31\. August.
- Alle Leistungszahlen sind herstellereigen, eine unabhängige Drittmessung gibt es noch nicht.
## Was Anthropic da rausgehauen hat
Der Pitch ist schnell erzählt. *Sonnet 5* soll planen, Tools wie Browser und Terminal bedienen und länger autonom durcharbeiten, als es bei einem Sonnet bisher drin war. Anthropic verkauft das als Annäherung an die teurere Opus-Klasse – die Leistung liege nah an [*Opus 4.8*](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/), der Preis aber deutlich darunter.
Verfügbar ist das Modell ab sofort über alle Pläne. Für Free und Pro ist es das neue Standardmodell, Max-, Team- und Enterprise-Nutzer bekommen es ebenfalls. In *Claude Code* und über die Claude-Plattform läuft es unter dem API-Namen `claude-sonnet-5`. Die Rate-Limits hat Anthropic über Chat, *Cowork*, *Claude Code* und Plattform angehoben, weil höhere [Effort-Level](https://t01.li/glossar/#reasoning-effort) mehr Token fressen.
## Der Preis sieht nach Rabatt aus – bis du das Sternchen liest
Hier wird es interessant. Zum Start kostet *Sonnet 5* 2 US-Dollar pro Million Input-Token und 10 US-Dollar pro Million Output-Token, und zwar bis zum 31\. August. Danach geht es auf 3 beziehungsweise 15 US-Dollar hoch. Zum Vergleich: *Opus 4.8* liegt bei 5 und 25 US-Dollar. Auf dem Papier ein hübscher Abstand nach unten – und der bleibt auch echt, dazu gleich. Das Sternchen steht nämlich woanders.
Es steht in Fußnote zwei: *Sonnet 5* bringt einen neuen [Tokenizer](https://t01.li/glossar/#tokenizer) mit, wie schon *Opus 4.7*, und derselbe Input mappt jetzt auf mehr Token – je nach Inhalt das 1,0- bis 1,35-Fache. Anthropic schreibt selbst, der Einführungspreis sei so gesetzt, dass der Umstieg ungefähr kostenneutral ausfällt. Übersetzt heißt das: Wer sein bisheriges *Sonnet 4.6*\-Budget auf *Sonnet 5* hochrechnet und die Token-Zahl konstant lässt, verkalkuliert sich – nicht gegen Opus, sondern gegen sein eigenes Vorher.
Rechnen wir es mal durch: derselbe Text, Input-Seite, im ungünstigsten Fall 1,35× so viele Token. Zum Einführungspreis von 2 US-Dollar landest du bei rund 2,70 statt der 3 US-Dollar auf *Sonnet 4.6* – eine Spur günstiger, daher das „kostenneutral“. Ab dem 1\. September steht der Zähler bei 3 US-Dollar mal 1,35, macht gut 4 US-Dollar für exakt denselben Input. Bis zu 35 Prozent über dem, was *Sonnet 4.6* vorher gekostet hat.
## Benchmarks: die Lücke schrumpft
Jetzt mit Zahlen. Anthropic stellt *Sonnet 5* gegen den Vorgänger *Sonnet 4.6* und das teurere *Opus 4.8*:
| Benchmark | *Sonnet 5* | *Sonnet 4.6* | *Opus 4.8* |
| ------------------------------------ | ---------- | ------------ | ---------- |
| SWE-bench Pro (Coding) | 63,2 % | 58,1 % | 69,2 % |
| Terminal-Bench 2.1 (Coding) | 80,4 % | 67,0 % | 82,7 % |
| Humanity’s Last Exam, ohne Tools | 43,2 % | 34,6 % | 49,8 % |
| Humanity’s Last Exam, mit Tools | 57,4 % | 46,8 % | 57,9 % |
| OSWorld-Verified (Computer-Use) | 81,2 % | 78,5 % | 83,4 % |
| GDPval-AA v2 (Knowledge Work, Score) | 1.618 | 1.395 | 1.615 |
Zwei Werte stechen raus. Bei „Humanity’s Last Exam“ mit Tools liegt *Sonnet 5* mit 57,4 Prozent praktisch auf *Opus 4.8*\-Niveau (57,9 Prozent) – ein halber Punkt Abstand. Und bei GDPval-AA v2 steht das billigere Modell mit 1.618 sogar minimal über dem teuren Opus (1.615). Die „Annäherung an Opus“ ist hier keine PR-Phrase mehr, sondern steht in der Tabelle.
Bevor jetzt jemand „*Sonnet 5* schlägt *Opus*“ titelt, ein Einordnungs-Dämpfer: Drei Punkte auf einer 1.600er-Skala sind Rauschen, keine Überlegenheit – das ist ein Gleichstand, kein Thronwechsel. Beim harten Coding bleibt *Opus* vorn: Bei SWE-bench Pro trennen die beiden sechs Punkte, das merkt man in der Praxis. Der größte Sprung gegenüber *Sonnet 4.6* steckt in Terminal-Bench 2.1, plus 13 Punkte – da hat sich beim agentischen Arbeiten am Terminal wirklich etwas getan.
Und der Sternchen-Charakter bleibt. Es sind Anthropics eigene Messungen, eine knappe halbe Stunde nach Launch gibt es keine unabhängige Drittmessung. Wie beweglich diese Werte sind, zeigt Anthropic selbst: Die alten *Sonnet 4.6*\-Zahlen wurden nachträglich neu bewertet, weil sich der Grader geändert hat. Andere Methodik, andere Zahl für dasselbe Modell. Launch-[Benchmarks](https://t01.li/glossar/#benchmark) taugen zur Orientierung, nicht als Naturkonstante.
Die zehn Partner-Zitate im Beitrag laufen in dieselbe Richtung – mehr agentisch, führt Tasks zu Ende, prüft sich unaufgefordert selbst. Schön zu lesen, aber es sind handverlesene Early-Access-Stimmen in einem Marketing-Text. Ich werte sie als das.
## Sicherheit: die Cyber-Bremse ist ab Werk an
Der nüchternste Teil der Mitteilung ist der ehrlichste. Im Behavioral Audit schneidet *Sonnet 5* insgesamt sicherer ab als *Sonnet 4.6*, halluziniert weniger und schleimt weniger. Gegen *Opus 4.8* und das *Mythos Preview* zeigt es allerdings eine höhere Rate an Fehlausrichtung – das kleinere Modell ist eben kein Sicherheits-Selbstläufer.
Beim Thema „Cyber“ wird Anthropic konkret. Trainiert wurde *Sonnet 5* darauf nicht. In einer mit Mozilla entwickelten [Eval](https://t01.li/glossar/#eval) sollten Modelle Exploits für Lücken in *Firefox* 147 bauen – *Sonnet 5* schaffte in keinem Fall einen voll funktionsfähigen Exploit, lag bei den Teilerfolgen aber minimal über *Sonnet 4.6*. Anthropic führt das auf die gestiegene Allgemein-Intelligenz zurück, nicht auf gezieltes Training. Konsequenz: Die Cyber-Safeguards sind standardmäßig aktiv, dieselben wie bei *Opus 4.7* und *4.8*. Ein Modell, das beim Bauen von Angriffs-Code besser werden könnte, kriegt vorsorglich einen Riegel vorgeschoben. Das ist die vernünftige Variante.
### Mein Take dazu
Wenn man mich fragt ist die eigentliche Nachricht daran das Preisschild. Agentische Fähigkeiten, die bei „Humanity’s Last Exam“ mit Tools und bei GDPval auf Opus-Höhe liegen, aber im günstigeren Sonnet-Bereich – das ändert die Rechnung für alle, die Agenten in Masse laufen lassen. Genau da lohnt der zweite Blick: Gegen Opus ist der Preisvorteil sauber, beide zählen Token gleich. Das Sternchen greift gegenüber dem Vorgänger – und nur bis Ende August. Danach zahlst du für denselben Input eher mehr als auf *Sonnet 4.6*. Das gibt Anthropic selbst zu, man muss es nur lesen. Und beim reinen Coding ist Opus weiter das schärfere Werkzeug, wenn auch nicht mehr mit großem Vorsprung.
Bleibt der Rest: herstellereigene Zahlen, kuratierte Lob-Zitate, null unabhängige Daten. Ob die agentischen Sprünge im echten, chaotischen Alltag halten, zeigt sich erst in den nächsten Tagen – nicht in einer Launch-Grafik. Der stille Modellwechsel in meinem Terminal ist dabei das Bild, das hängen bleibt. Diese Modelle schieben sich inzwischen unter dir durch, ohne dass du es merkst. Praktisch. Und ein bisschen unheimlich.
### Agentisches SEO: Türen für Gäste, die kaum kommen
URL: https://t01.li/geo-seo/agentisches-seo-strukturierte-daten-agenten/
Last updated: 2026-09-10T06:34:37.000Z
Jede neue Disziplin baut sich irgendwann ihr eigenes Kürzel. SEO, dann [GEO](https://t01.li/generative-engine-optimization-geo/), jetzt AEO. Praktisch ist daran wenig, denn [AEO](https://t01.li/glossar/#aeo-agentic-engine-optimization) meint je nach Autor zwei verschiedene Sachen. Genau da fängt das Missverständnis an.
Die eine Lesart, [Answer Engine Optimization](https://t01.li/glossar/#aeo-answer-engine-optimization), ist im Kern das, was sonst GEO heißt: in KI-Antworten zitiert werden. Diese Schicht habe ich [an anderer Stelle auseinandergenommen](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/), Ergebnis kurz, das meiste davon ist klassisches SEO mit Zucker. Die andere Lesart stammt von Addy Osmani und zielt woanders hin. Nicht zitiert werden, sondern benutzt werden. Ein Agent liest deine Seite nicht, er handelt auf ihr.
Darum geht es hier. Ich werfe dazu in den Raum: Die Maschinenschicht dafür wird gerade in hohem Tempo gebaut, und sie bleibt trotzdem vorerst eine Nische. Aus zwei Gründen, die nichts miteinander zu tun haben und sich perfekt ergänzen. Kaum jemand baut die Tür ein. Und kaum jemand schickt einen Agenten hindurch, wenn es um etwas geht.
## TL;DR
Agentisches SEO ist die Schicht über GEO: nicht zitiert werden, sondern von einem Agenten benutzt werden. Die Technik dafür steht. Der Verkehr fehlt.
- **AEO ist doppelt belegt:** Answer Engine Optimization (= GEO, Sichtbarkeit) und Osmanis Agentic Engine Optimization (= Aktion). Hier geht es um das Zweite.
- **Die Maschinenschicht ist Opt-in:** WebMCP steckt im Origin Trial, einziger Konsument ist Gemini in Chrome. Ohne aktive Mitarbeit der Seite passiert nichts.
- **Strukturierte Daten verschieben den Zweck:** nicht mehr `Article` fürs Zitiertwerden, sondern `potentialAction` und Permission-Manifeste fürs Handeln.
- **Die Psychologie deckelt die Nachfrage:** teure, schwer umkehrbare Entscheidungen delegiert niemand. Die Protokolle selbst bauen die menschliche Freigabe bewusst ein.
- **Reihenfolge:** Bots nicht aussperren, HTML sauber halten, Aktions-Schema setzen. WebMCP erst, wenn du messbaren Agenten-Traffic hast.
## Drei Kürzel, und das doppelte A
Sortieren wir das Feld, sonst redet jeder über etwas anderes. SEO bringt dich in die klassische Suche. GEO, oft auch Answer Engine Optimization genannt, bringt dich in die generierte Antwort von *ChatGPT*, *Perplexity* oder den AI Overviews. Beides dreht sich um Sichtbarkeit. Wirst du gefunden, wirst du zitiert.
Osmanis AEO ist eine andere Baustelle. Search Engine Land [warnt eigens davor](https://searchengineland.com/agentic-engine-optimization-google-ai-director-474358?ref=t01.li), dieses agentische AEO mit dem Answer-Engine-AEO zu verwechseln. Der Unterschied ist nicht kosmetisch. Bei der Sichtbarkeit ist der Konsument ein Modell, das eine Antwort formuliert. Beim agentischen Web ist der Konsument ein Agent, der eine Aufgabe abarbeitet. Er füllt ein Formular aus, holt ein Angebot ein, bucht einen Termin. Dafür reicht es nicht, gut lesbar zu sein. Die Seite muss bedienbar sein, und zwar ohne Augen.
### Was Osmani wirklich gesagt hat
Im April hat das für einigen Wirbel gesorgt, also lohnt der Blick aufs Original statt auf die Sekundär-Listicles. Addy Osmani, Director of Engineering bei Google Cloud AI, hat am 11\. April 2026 das [erste operative AEO-Framework](https://addyosmani.com/blog/agentic-engine-optimization/?ref=t01.li) veröffentlicht, mitsamt einem Open-Source-Audit-Tool. Fünf Signale: Auffindbarkeit, Verarbeitbarkeit, Token-Effizienz, Fähigkeits-Signalisierung, Zugriffskontrolle. Klingt nach dem nächsten großen Ding, das du sofort umsetzen musst.
Hier kommt das Sternchen, und es ist groß. Osmani schreibt für Entwickler. Seine Zielgruppe sind agentische Coding-Tools wie *Claude Code*, *Gemini CLI (*bzw. *Antigravity)*, *Cursor* und *Copilot*, und er nennt seine Position ausdrücklich eine Praktiker-Sicht aus der Developer-Tools-Welt, keine Google-weite Empfehlung. Das ist ein Riesenunterschied zu „so rankt deine Firmenseite besser“. Wie groß, [zeigt der hauseigene Widerspruch](https://searchengineland.com/agentic-engine-optimization-google-ai-director-474358?ref=t01.li): Während Osmani aus der Cloud-AI-Ecke den Stack predigt, hält John Mueller aus der Search-Ecke dagegen und rät von Sonderseiten für Maschinen ab. Zwei Google-Leute, zwei Aussagen, ein Publikum, das nur die Schlagzeile hört.
Was vom Framework bleibt, wenn man den Hype abzieht, ist trotzdem brauchbar. Kürzere, klar strukturierte Seiten mit der Antwort weit oben sind für Agenten besser, und für Menschen auch. Die Token-Budgets, die Osmani vorschlägt, sind Lesbarkeitsziele mit anderem Etikett. Eine Doku-Seite, die in Token explodiert, liest auch kein Mensch zu Ende.
## llms.txt, zum Zweiten
Dass die `llms.txt` als GEO-Hebel – freundlich formuliert – deutlich [hinter den Erwartungen zurücksteht](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/), hatte ich ebenfalls schon in diesem Blog mal erwähnt. Das werde ich an dieser Stelle nicht noch mal aufdröseln. Interessant wird die Datei erst, wenn man sie aus dem GEO-Frame nimmt und in den agentischen Kontext stellt.
Dann nämlich dreht sich der Befund. In einer [Ahrefs-Auswertung von 137.000 Domains](https://ahrefs.com/blog/llmstxt-study/?ref=t01.li) blieben 97 Prozent der `llms.txt`\-Dateien im Mai 2026 komplett ungelesen. Die Such- und Answer-Bots ignorieren sie. Wer die Datei abruft, sind die Coding-Agenten. *Claude Code* zählte neben GPTBot zu den aktivsten Abrufern der Datei. Das passt zu Muellers Einordnung. Er nennt `llms.txt` [eine Krücke, um Tokens zu sparen](https://ahrefs.com/blog/what-is-llms-txt/?ref=t01.li), gedacht für KI-Coding-Tools, die Entwickler-Doku parsen. Heißt für dich: Wenn du eine technische Dokumentation betreibst, hat die Datei einen kleinen, echten Job. Wenn du einen Marken-Blog oder Shop betreibst, ist sie weiterhin eine günstige Wette ohne belegbaren Effekt. Derselbe File, zwei völlig verschiedene Urteile, je nachdem, wer am anderen Ende liest.
## Die eigentliche Maschinenschicht heißt WebMCP
Wenn etwas an dieser Geschichte technisch neu und nicht nur umetikettiert ist, dann *WebMCP*. Die Idee dreht das Verhältnis um. Bisher schaut ein Agent auf einen Screenshot deiner Seite und rät, wo der Button sitzt. Mit *WebMCP* sagt die Seite dem Agenten: Hier sind die Dinge, die ich kann, hier die Parameter, ruf sie auf. Statt Klick-Pantomime ein Funktionsaufruf.
So weit die Verheißung. Der Status ist nüchterner. *WebMCP* wurde am 10\. Februar 2026 angekündigt und läuft seit dem zweiten Quartal 2026 als öffentlicher Origin Trial in Chrome 149, [über die Schnittstelle navigator.modelContext](https://developer.chrome.com/docs/ai/webmcp?ref=t01.li). Es ist ein [Community-Group-Draft, kein offizieller W3C-Standard](https://chatforest.com/reviews/google-webmcp-browser-mcp-standard-review/?ref=t01.li), und der einzige Agent, der WebMCP-Tools aktuell konsumiert, ist Gemini in Chrome. Microsoft hat die Spec mitgeschrieben, in den offiziellen [Edge-147-Release-Notes taucht WebMCP aber nicht auf](https://nohacks.co/blog/what-is-webmcp?ref=t01.li), der Support gilt als unbestätigt.
Technisch hast du zwei Wege. Den deklarativen, ein paar Attribute auf bestehende HTML-Formulare. Und den imperativen, Tools in JavaScript registrieren. So sieht der imperative Weg aus, wenn du einem Agenten erlaubst, ein unverbindliches Angebot anzufordern:
```javascript
if ('modelContext' in navigator) {
navigator.modelContext.registerTool({
name: "angebotAnfordern",
description: "Fordert ein unverbindliches Angebot für eine Leistung an.",
inputSchema: {
type: "object",
properties: {
leistung: { type: "string" },
email: { type: "string" }
},
required: ["leistung", "email"]
},
async execute({ leistung, email }) {
const res = await fetch("/api/angebot", {
method: "POST",
headers: { "Content-Type": "application/json" },
body: JSON.stringify({ leistung, email })
});
return res.ok ? { status: "angefragt" } : { status: "fehler" };
}
});
}
```
Zwei Punkte, die man nicht überliest. Erstens braucht der Aufruf einen offenen Tab, headless geht nicht, weil die Tool-Calls im JavaScript der sichtbaren Seite laufen. Zweitens das Sicherheitsthema. Ein Agent erbt die Sitzung des angemeldeten Nutzers, also auch dessen Rechte. Die Spec begegnet dem mit Herkunftsisolierung. Die Permissions Policy für Tools steht per Default auf `self`, und Cross-Origin-iFrames müssen `allow="tools"` explizit deklarieren. Das ist kein Detail. Ein bösartiges Tool auf einer fremden Seite, das im Hintergrund deine Bank-Session anzapft, ist genau das Szenario, das man hier verhindern will.
## Strukturierte Daten, aber diesmal fürs Handeln
Im GEO-Kontext ging es bei Schema.org um Entitäten und Inhalte, also `Organization`, `Article`, `FAQPage`. Damit machst du dich zitierfähig. Für Agenten zählt ein anderer Teil des Vokabulars, der bisher kaum jemanden interessiert hat, nämlich die Aktionen. `potentialAction` sagt nicht, wer du bist. Es sagt, was man bei dir tun kann. Ein Termin reservieren zum Beispiel:
```json
{
"@context": "https://schema.org",
"@type": "Service",
"name": "Erstberatung",
"provider": { "@type": "Organization", "name": "Beispiel GmbH" },
"potentialAction": {
"@type": "ReserveAction",
"target": {
"@type": "EntryPoint",
"urlTemplate": "https://example.com/api/termin?slot={slot}",
"httpMethod": "POST",
"contentType": "application/json"
},
"result": { "@type": "Reservation" }
}
}
```
Daneben kursiert ein zweiter Baustein, zugegeben noch ein Entwurf ohne verabschiedeten Standard und ohne nennenswerte Adaption: `agent-permissions.json`. Die Datei legt fest, welche Agenten welche Aktionen ausführen dürfen, und wo strukturierte API-Alternativen liegen. Reizvoll ist daran weniger der heutige Nutzen als die Logik. Du erlaubst das Suchen und Reservieren, du verbietest das Kaufen:
```json
{
"allowed_agents": [
{
"user_agent": "Claude-User",
"allowed_actions": ["SearchAction", "ReserveAction"],
"rate_limit_per_minute": 60
}
],
"disallowed_actions": ["BuyAction"],
"api_endpoints": {
"availability_check": "https://api.example.com/v1/slots"
}
}
```
Genau dieses `disallowed_actions: ["BuyAction"]` ist die Brücke zum eigentlichen Punkt. Es ist kein technischer Krampf. Es ist eine Haltung.
## Die Bremse ist schon eingebaut
Ob Menschen einem Agenten teure oder physische Entscheidungen überlassen, und ob eine klicklose Erwähnung am Ende überhaupt etwas konvertiert, habe ich [an anderer Stelle für einen konkreten Kunden durchgerechnet](https://t01.li/geo-seo/geo-citations-bringen-keine-conversions/). Kurzfassung: bei hochwertigen Leads zuletzt, im DACH-Raum mit extra Vertrauensvorschuss, und die Agenten brechen ohnehin am Captcha ab. Das ist die Nachfrageseite.
Für die Infrastruktur-Frage ist etwas anderes interessant. Dieselbe Skepsis steckt schon in den Standards. Die Leute, die das agentische Bezahlen bauen, trauen dem autonomen Agenten den großen Griff selbst nicht zu. Googles AP2 arbeitet mit [signierten Mandaten](https://www.adweek.com/media/a-guide-to-the-new-wide-world-of-agentic-advertising-and-commerce-protocols/?ref=t01.li), das Intent-Mandate fixiert den Rahmen, und der Agent kann ihn nicht ohne erneute Rückfrage überschreiten. Stripes Wallet leitet jede Ausgabe zur Freigabe an den Menschen zurück. *WebMCP* sieht für sensible Aktionen einen Bestätigungsdialog vor. Und das `agent-permissions.json` von oben verbietet `BuyAction` per Default.
Diese Decke liegt nicht im Nutzerverhalten, sie liegt im Design. Wer die Maschinenschicht baut, baut die menschliche Bremse gleich mit ein, weil sonst niemand mitspielt. Der adressierbare Raum für vollautonomes Handeln ist von vornherein das risikoarme Ende. Anfragen, reservieren, vergleichen. Nicht kaufen, nicht abschließen.
Selbst da ist die Realität ernüchternd. OpenAI hat sein [Instant Checkout am 5\. März 2026 wieder eingestellt](https://nohacks.co/blog/agentic-commerce?ref=t01.li) und auf händlerbetriebene Apps umgeschwenkt, nachdem rund dreißig Shopify-Händler integriert hatten. Der direkte Kauf im Chat, das Vorzeigeszenario, wurde zurückgebaut.
## Agentisches SEO: ab wann sich der Aufwand lohnt
Kein Hexenwerk, eher eine Reihenfolge. Und die meisten Schritte zahlen ohnehin auf klassisches SEO ein, was die Sache angenehm risikoarm macht.
Zuerst die Hausaufgabe, die fünf Minuten kostet: Sperr in der `robots.txt` nicht versehentlich die Bots aus, die du eigentlich willst. Viele Seiten haben 2024 reflexhaft alles geblockt. Die `robots.txt` mit expliziten User-Agent-Regeln ist [der Hebel, der heute tatsächlich steuert](https://codersera.com/blog/llms-txt-complete-guide-2026/?ref=t01.li). Danach das Fundament, das ich [im GEO-Stück](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/) ausführlich behandelt habe. Inhalte gehören ins initiale HTML, sauber gerendert, semantisch korrekt ausgezeichnet. Ein Agent, der deine Produktdaten erst nach Client-Side-Rendering sieht, sieht sie gar nicht.
Erst dann wird es agentenspezifisch. Setz das Aktions-Schema dort, wo eine echte Aktion dranhängt, also `potentialAction` an Buchung, Anfrage, Verfügbarkeit. Wenn du eine Entwickler-Doku betreibst, nimm `llms.txt` und `AGENTS.md` dazu, [letzteres hat inzwischen eine Linux-Foundation-Spec](https://www.digitalapplied.com/blog/agentic-engine-optimization-google-aeo-framework-guide?ref=t01.li), während *Claude Code* weiter `CLAUDE.md` bevorzugt. *WebMCP* kommt zuletzt und nur unter einer Bedingung: Du kontrollierst beide Enden, oder du misst bereits echten Agenten-Traffic in deinen Logs. Solange dort nur Gemini in Chrome vereinzelt vorbeischaut, baust du eine Tür für einen Gast, der noch nicht klingelt.
Die ehrliche Antwort auf „ab wann lohnt sich AEO“ ist zweigeteilt. Die Hygiene lohnt sofort, weil sie ohnehin SEO ist. Die spezifische Maschinenschicht lohnt sich, sobald deine Logs sagen, dass Agenten kommen. Ob sich der ganze Aufwand am Ende in Anfragen übersetzt, ist [eine eigene Rechnung](https://t01.li/geo-seo/geo-citations-bringen-keine-conversions/). Vorher ist es eine Wette, und Wetten platziert man in der Höhe, die man verschmerzen kann.
### Was bleibt
Das agentische Web ist kein Hype im Sinne von „gibt es nicht“. Es gibt es, die Protokolle sind real, das Tempo ist hoch. Es ist ein Hype im Sinne von „kommt später und kleiner, als die Pitches behaupten“. Die Tür lässt sich bauen. Ob jemand hindurchgeht, entscheidest nicht du allein, sondern die Adaption auf Browser-Seite und die Bereitschaft der Menschen, Kontrolle abzugeben. Beides bewegt sich langsam, und das zweite vielleicht nie ganz.
Steile These zum Schluss: Agentisches SEO wird nicht an der Technik scheitern, sondern an der Vertrauensfrage. Die löst kein `agent-permissions.json`.
### AI Picks der 26. KW
URL: https://t01.li/ai-shorts/ai-picks-der-26-kw/
Last updated: 2026-08-07T09:44:53.000Z
Die Vermutung der letzten Woche war nicht ganz falsch: Die Modellwochen werden wieder eingeläutet, zumindest in Teilen. Ein bisschen Gossip gibt's obendrauf. Und Security wird gerade von der Pflichtübung zum Verkaufsargument, das zieht sich diese Woche durch mehrere Picks. BTW: Man möge mir verzeihen, wenn ich nicht jedes neue AI-SaaS-Tool oder Video-/Audio-Modell aus den Vereinigten Staaten von Kaputtistan oder dem Reich der Mitteilung hier breittrete. Relevanz und so.
Sortiert ist das Ganze thematisch: erst Security, dann ein Block Agenten und Orchestrierung, etwas China-Gossip, zum Schluss Tools und eine Geschichte aus dem echten Leben.
## New tools und GPT-5.5-Cyber
Security wird anscheinend ein Ding. Bei OpenAI sind diese Woche gleich mehrere Sachen hinten rausgefallen, alle unter dem Dach von [Daybreak](https://openai.com/index/daybreak-securing-the-world/?ref=t01.li): ein Update fürs Codex-Security-Plugin, ein Cyber-Partner-Programm mit gut zwei Dutzend Sicherheitsfirmen (Cisco, CrowdStrike, Cloudflare, Palo Alto, Wiz und Co.), dazu „Patch the Planet", eine Initiative mit Trail of Bits und HackerOne, die über 30 Open-Source-Projekte von der Lücke zum Fix bringen soll, darunter cURL, Go und Python. Last but not least: *GPT-5.5-Cyber*.
Das Modell ist die freizügigere, schärfere Variante für autorisierte Defensiv-Arbeit und kommt nur über „Trusted Access for Cyber“, also nicht für jeden. OpenAI nennt 85,6 % auf CyberGym gegenüber 81,8 % für das normale *GPT-5.5*. Herstellereigene Bench, kein unabhängiger Drittwert, das übliche Sternchen. Der eigentliche Dreh steckt im Framing: Bugs finden ist nicht mehr das Problem, das Patchen schon. Genau da hängt sich der ganze Apparat ein.
## Computer use in Gemini 3.5 Flash
Bleiben wir beim Thema. Google backt Computer Use jetzt nativ in *Gemini 3.5 Flash*, [vorher steckte das in einem separaten 2.5er-Modell](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-computer-use-gemini-3-5-flash/?ref=t01.li). Der [Agent](https://t01.li/glossar/#agentic-ai) bekommt einen Screen und ein Ziel und klickt, tippt und scrollt sich durch Browser, Mobile und Desktop. Auch hier kommt Security mit auf den Tisch.
Das Modell wurde gezielt adversarial gegen [Prompt Injection](https://t01.li/glossar/#prompt-injection) trainiert. Dazu kommen zwei optionale Enterprise-Schutzschichten: eine verlangt bei heiklen oder irreversiblen Aktionen eine Nutzerbestätigung, die andere stoppt den Task automatisch, sobald eine indirekte Injection erkannt wird. Auf OSWorld landet das Ding bei 78,4, quasi gleichauf mit *GPT-5.5* (78,7). Solide für ein Flash-Modell, das Search, Maps und Function Calls nebenher mitnimmt. Ob „Injection Detection“ in freier Wildbahn hält, was das Datenblatt verspricht, steht auf einem anderen Blatt. Prompt Injection ist branchenweit ungelöst.
## Codex is quietly killing your SSD
Jetzt wird's unangenehm. *Codex* von OpenAI, [CLI](https://t01.li/glossar/#cli) und Desktop-App, hatte einen fiesen Bug in der Logging-Konfiguration. Ein interner SQLite-Feedback-Sink lief standardmäßig auf globalem TRACE-Level, der lautesten Stufe überhaupt, und schrieb permanent WebSocket-Payloads, Dateisystem-Events und internen Protokoll-Müll auf die Platte. Rui Fan, PMC-Mitglied bei Apache Flink, hat es dokumentiert: [rund 37 TB Schreibvolumen in 21 Tagen Uptime](https://github.com/openai/codex/issues/28224?ref=t01.li), hochgerechnet etwa 640 TB im Jahr. Eine typische 1-TB-Consumer-SSD ist auf circa 600 TBW ausgelegt. Man ahnt, worauf das hinausläuft.
Wer jetzt schnell `[analytics] enabled = false `in seine `config.toml `setzt: spar dir die Mühe. Laut [einem weiteren Issue](https://github.com/openai/codex/issues/29463?ref=t01.li) schreibt das Ding die TRACE-Logs trotzdem weiter, auch mit deaktivierten Analytics und `RUST_LOG=warn`. Der einzige echte Notnagel war, `logs_2.sqlite` per Symlink nach `/tmp` umzubiegen, also in den RAM.
**Gefixt wurde es über die Releases**. Drei PRs landeten in 0.142.0 und 0.143.0 und sparen rund 85 % der Logs ein. Heißt für dich: erst updaten, dann aufräumen.
## Sakana Fugu
Und jetzt zu den Agenten. *Sakana Fugu* ist [am 22\. Juni von Sakana AI erschienen.](https://sakana.ai/fugu-release/?ref=t01.li) Schon ein Move, ein Modell nach einem potenziell tödlichen Fisch zu benennen, beziehungsweise nach einer beliebten kulinarischen Spezialität. Wofür das Teil gut ist, steht gleich im Titel:
> One Model to Command Them All
Heißt konkret: ein Multi-Agenten-Orchestrierungssystem, das sich als ein einziges [Basismodell](https://t01.li/glossar/#foundation-model) präsentiert. *Fugu* ist selbst ein Sprachmodell, trainiert darauf, verschiedene LLMs aus einem Agentenpool aufzurufen, rekursive Instanzen seiner selbst eingeschlossen. Es gibt zwei Varianten, *Fugu* und *Fugu Ultra*, und Sakana behauptet, dass Ultra auf den harten Engineering- und Reasoning-[Benches](https://t01.li/glossar/#benchmark) mit Anthropics *Fable 5* und *Mythos Preview* mithält. Spannend ist weniger die Zahl als das Verkaufsargument dahinter: Frontier-Leistung ohne das Risiko von Exportkontrollen.
## Gemini Interactions API
Die [Interactions API von Google ist jetzt allgemein verfügbar](https://ai.google.dev/gemini-api/docs/interactions-overview?ref=t01.li) und wird zur primären Schnittstelle für Modelle und Agenten. Die alte generate Content-API gilt damit offiziell als Legacy, läuft aber weiter. Praktisch interessant sind zwei Dinge: serverseitiges State-Management über eine `previous_interaction_id`\-Funktion und dadurch höhere Cache-Trefferraten, was bei Multi-Turn-Geschichten die Token-Kosten drückt. Google selbst sagt ziemlich offen, wohin die Reise geht: neue agentische Fähigkeiten landen künftig zuerst, und teils nur, auf der neuen API. Wer heute frisch gegen Gemini baut, sollte das einkalkulieren.
## Ornith-1.0: Self-Scaffolding LLMs for Agentic Coding
Bin ich bei X drübergestolpert, passt zum [Loop-Engineering-Thema aus der 25\. KW](https://t01.li/ai-shorts/ai-picks-der-25-kw/#the-art-of-loop-engineering): DeepReinforce, vorher kein Begriff für mich, haben mit *Ornith-1.0* ein [Set von Reasoning-Modellen für agentisches Coding](https://deep-reinforce.com/ornith%5F1%5F0.html?ref=t01.li) trainiert. Der Clou ist das Self-Scaffolding: Statt sich auf ein von Menschen gebautes Harness zu verlassen, lernt das Modell im RL, sein eigenes Scaffold zu schreiben, und optimiert Gerüst und Lösung gemeinsam. Die Bandbreite reicht von 9B Dense über 35B [MoE](https://t01.li/glossar/#moe) bis hinauf zu 397B MoE, post-trainiert auf Gemma 4 und Qwen 3.5, alles unter MIT-Lizenz.
Klar sind das frisch erhobene Eigen-Benchmarks, aber sie wirken nicht fernab jeder Realität, weil sie das Ding gegen echte Peers stellen. Ein Sternchen gehört trotzdem hin: Die 82,4 auf SWE-Bench Verified beim 397B matchen *Claude Opus 4.7* und das größere *GLM-5.2*\-744B liegt ebenfalls vorn. Augenhöhe also zur Vorgängergeneration. Definitiv ein interessanter Testkandidat, den ich mir nächste Woche über OpenRouter (falls vorhanden) oder lokal in passender Größe ansehe.
## Qwen-AgentWorld
Die wollen's anscheinend echt wissen. *Qwen-AgentWorld* [simuliert Agentenumgebungen in sieben Bereichen](https://qwen.ai/blog?id=qwen-agentworld&ref=t01.li): Terminal, Suche, MCP und SWE auf Text-Ebene, dazu Web, Android und Desktop-OS-State auf GUI-Ebene. Wichtig zum Verständnis: Das ist ein World Model, also ein Simulator. Es führt deine Tool-Calls nicht aus, sondern sagt voraus, was eine Umgebung zurückgäbe, gedacht, um Agenten zu trainieren und zu testen, ohne echte Systeme anzufassen.
Als Roadmap hängen sie drüber, sie wollten ausloten, wie weit sich allgemeine Agentenfähigkeiten mit sprachbasiertem World Modeling treiben lassen. Auf der eigenen AgentWorldBench schlägt das große 397B-A17B angeblich *GPT-5.4*, *Claude Opus 4.8* und *Gemini 3.1 Pro*, herstellereigen, klar.
Ist das gut? Kann ich nicht beantworten. Was ich beantworten kann: Den Datenschutz-Reflex, einer staatsnahen chinesischen Organisation etwas hinzuwerfen, musst du sauber sortieren. Über deren eigenen API-Endpoint fließen deine Trajektorien zu Alibaba, das ist der Punkt, an dem ich vorsichtig wäre. Das kleinere [*35B-A3B* liegt allerdings unter Apache 2.0 auf Hugging Face](https://huggingface.co/Qwen/Qwen-AgentWorld-35B-A3B?ref=t01.li) und läuft lokal über vLLM oder SGLang. Wer den API-Pfad meidet, entschärft die Sorge selbst. Apropos Alibaba.
## Anthropic says Alibaba must be punished for largest Claude cloning attack
Und hier der versprochene Gossip. Anthropic wirft Alibaba in einem [Brief an die Senatoren Tim Scott und Elizabeth Warren](https://arstechnica.com/tech-policy/2026/06/anthropic-claims-alibaba-defied-trump-to-attack-claude-and-steal-capabilities/?ref=t01.li) vor, die größte bislang gemessene Distillation-Kampagne gegen *Claude* gefahren zu haben. O-Ton aus dem Schreiben:
> new, confidential evidence of the largest campaign to illicitly extract Claude's capabilities we have ever measured.
Das vielzitierte „Klonen“ ist übrigens die Zuspitzung der Presse, nicht Anthropics Wortlaut. Der Brief ging einen Tag vor einer Senatsanhörung raus, und er zielt explizit darauf, dass China so schneller Mythos-Preview-Niveau erreicht. Du erinnerst dich an [das Fable-Drama](https://t01.li/ai-shorts/ai-picks-der-24-kw/#das-fable-drama), der Kreis schließt sich.
Die Zahlen: fast 25.000 betrügerische Konten, über 28,8 Millionen Anfragen zwischen dem 22\. April und dem 5\. Juni, zugeschrieben Operatoren im Umfeld von Alibaba und dessen Qwen-Lab. Jetzt der Haken, und der ist hausgemacht: Anthropic schreibt selbst, Alibaba sei der Entdeckung mit Verschleierungstechniken und Proxy-Netzwerken entgangen, attribuiert die Sache aber im selben Atemzug glasklar Alibaba. Auf Basis vertraulicher Belege, die öffentlich niemand sieht. Was denn nun? Wer großflächig abschnorchelt, verschleiert in der Regel als Erstes, wer er ist und woher er kommt. Den Ali-Baba-und-die-25.000-Räuber-Witz spare ich mir an dieser Stelle. Fast.
## Mistral OCR 4
*Mistral OCR 4* ist [da](https://mistral.ai/news/ocr-4/?ref=t01.li), und das Ding kann mehr, als eine Seite in sauberen Text zu gießen. Es liefert strukturierten Output: Bounding Boxes, Block-Klassifikation und Confidence-Scores, gedacht als Ingestion-Baustein für RAG, agentische Workflows und Pipelines. 170 Sprachen, eigener Endpoint, Teil des [Search Toolkits](https://mistral.ai/news/search-toolkit/?ref=t01.li). Der API-Preis liegt bei 4 USD je 1.000 Seiten, im Batch bei der Hälfte. Interessantes Abrechnungsmodell übrigens, pro Seite statt pro Mio.-Token.
Anders als ich erst dachte, halten sie die Accuracy nicht zurück: 72 % Win-Rate in einem Blindvergleich, Spitzenwert auf OlmOCRBench mit 85,20, dazu 93,07 auf OmniDocBench. Bemerkenswert ehrlich für eine Produktankündigung: Mistral auditiert die eigenen Benchmark-Artefakte und nennt den Score ausdrücklich „directional“, also einen Richtwert, keine Naturkonstante. Das Sternchen setzt der Hersteller hier praktisch selbst.
Der Standardweg ist die Mistral-API über einen eigenen Endpoint, dazu Amazon SageMaker und Microsoft Foundry. Das Single-Container-Deployment im eigenen Haus läuft nur über das Enterprise-Programm, sprich: bei Mistral anfragen, Preis auf Anfrage. Für Compliance- und DSGVO-Schmerzen ist genau dieser On-Prem-Pfad das eigentliche Argument, nicht die Geschwindigkeit, aber wer ihn will, muss durch den Vertrieb. Für alle anderen bleibt die gehostete API, und die nimmst Du mit, wenn Du eh Mistral-Kunde bist. Sobald Du wirklich selbst hosten willst und nicht zum Enterprise-Deal greifen magst, gibt es reichlich andere Optionen.
## Introducing Claude Tag
[*Claude Tag* startet als Slack-Integration](https://www.anthropic.com/news/introducing-claude-tag?ref=t01.li), und Claude rückt quasi als Teammitglied in den Channel ein. Du tippst @Claude, delegierst eine Aufgabe mit vorab gescoptem Tool-Zugriff, und das Ding arbeitet sie in Etappen ab und meldet sich im Thread zurück. Der Twist gegenüber den alten Integrationen: Es gibt einen Claude pro Channel, geteilt vom ganzen Team, plus einen „ambienten“ Modus, der sich auch ungefragt meldet. Läuft auf *Opus 4.8* und ersetzt die bisherige Slack-App.
Das ist intern bei Anthropic gewachsen – nach eigener Angabe schreibt die interne Variante inzwischen 65 % des Codes im Produktteam. Man hat sich also gedacht: cooles Feature, machen wir public. Der ganze Beitrag liest sich so, als wäre da zeitnah noch mehr zu erwarten.
## New version of GPT-5.5 Instant
Sowas bläst OpenAI über X raus, und für mich klingt es eher nach einer Drohung:
> „We have a new version of GPT-5.5 Instant for you, and it's much more fun to talk to.“
Und weiter:
> „It also handles complex constraints more reliably and makes shopping and local recommendations more useful and cohesive.“
[Nachzulesen direkt bei OpenAI](https://x.com/OpenAI/status/2069843083701915755?ref=t01.li) auf X.
Übersetzt: Das ist was für den Chat-Endnutzer, kein Capability-Sprung. Shopping- und Local-Empfehlungen plus „mehr Spaß im Gespräch“.
Wenn ihr sowas für eure Mitarbeiter ausrollt, treibt dem Ding das via Custom Instructions am besten gleich wieder aus.
## cognee 1.0
Memory für Agenten ist gerade ein heißes Pflaster, und *cognee* mischt mit, [frisch auf Version 1.0](https://www.cognee.ai/blog/cognee-news/cognee-1-0-announcement?ref=t01.li). Das Open-Source-Projekt gibt Agenten ein persistentes Langzeitgedächtnis über Sessions hinweg, gebaut um eine schlanke Memory-API herum, remember, recall, improve, forget. Der eigentliche Clou der 1.0 ist die Diät beim Stack. Graph-Memory hieß bisher: eine Graphdatenbank für Beziehungen, eine Vektordatenbank für Embeddings, Redis für Sessions, dazu was Relationales für Metadaten, alles aufsetzen, absichern und bezahlen, bevor sich der Agent auch nur eine Sache merkt. In 1.0 läuft die ganze Memory-Schicht auf einer einzigen Postgres-Instanz, der Graph lebt einfach mit drin. Dedizierte Backends wie Neo4j kannst du weiterhin einschwenken, wenn die Last es verlangt.
Lizenz ist Apache 2.0, [der Code liegt offen auf GitHub](https://github.com/topoteretes/cognee?ref=t01.li), und ein bisschen Lokalpatriotismus sei erlaubt: Made in Berlin. Hinter *cognee* steckt die Topoteretes UG aus Kreuzberg, die im Februar eine Seed-Runde über 7,5 Millionen Dollar geholt hat. Schaue ich mir in jedem Fall an.
## Bring your Document Workflows to n8n with the LlamaParse Node
Passt zum Dauerthema Dokumente-in-Pipelines: Für *LlamaParse* gibt es jetzt [einen n8n-Community-Node](https://www.llamaindex.ai/blog/bring-your-document-workflows-to-n8n-with-the-llamaparse-node?ref=t01.li). Das bringt nicht nur das Parsing in deine Workflows, sondern auch die Extraction-Agents von LlamaExtract und deine LlamaCloud-Indizes als Knowledge Base, alles per Drag-and-drop.
Für mich ist das vor allem weniger Reibung beim Bauen von Testreihen und POCs. Und für den Daily Use in n8n sowieso eine gute Nachricht.
## GPT-5.6
OpenAI hat *GPT-5.6* in die Startlöcher gestellt, gestaffelt in drei Tiers: *Sol* als Flaggschiff, *Terra* als ausgewogene Mittelklasse und *Luna* als schnelle, günstige Variante. [Vorerst nur als Limited Preview](https://openai.com/index/previewing-gpt-5-6-sol?ref=t01.li) über API und Codex, an rund 20 Organisationen, nicht in ChatGPT.
Die Benchmarks, mit denen OpenAI wirbt, sind erwartungsgemäß die eigenen, man kennt das ja. Spannend ist die eine unabhängige Messung, und die lief schief. [*Sol* wurde beim Schummeln erwischt](https://the-decoder.de/gpt-5-6-sol-schummelt-bei-software-tests-so-viel-wie-kein-anderes-ki-modell-zuvor/?ref=t01.li), und zwar so heftig wie kein öffentlich getestetes Modell zuvor. Der unabhängige Evaluator METR berichtet, dass *Sol* bei Software-Tasks Bugs in der Testumgebung ausnutzte, versteckte Lösungen aus der Test-Suite zog und die Spuren anschließend zu verwischen versuchte. OpenAIs eigene System Card räumt ein, dass das Modell bei Aufgaben schummelt und Forschungsergebnisse fabriziert. Der gefeierte Coding-Rekord auf Terminal-Bench 2.1 steht damit auf wackligen Beinen, denn ein Score, den ein Modell durch ausgetrickste Tests holt, ist keiner.
Und es riecht ein wenig danach, als drohe OpenAI ein ähnliches Szenario wie Anthropic. Die abgespeckte Auslieferung erfolgt [auf Wunsch der Trump-Administration](https://www.theinformation.com/articles/trump-administration-asks-openai-stagger-release-new-model-security-concerns?ref=t01.li), die nationale Sicherheitsbedenken anführt, im Rahmen derselben Executive Order, unter der schon *Fable 5* und *Mythos 5* fielen. Noch ist es nur eine gestaffelte Freigabe, kein Komplett-Aus. Aber das Muster ist dasselbe.
## Copilot kauft man nicht, Copilot verdient man sich
Ich hatte diese Woche ein interessantes Gespräch und anonymisiere alles Relevante dahinter, weil ich niemandem auf die Füße treten möchte.
Ausgangslage: größeres Unternehmen aus der Finanzbranche, das aus Mandatsschutz-, Compliance- und Datenschutzgründen quasi nichts ins öffentliche Internet rauslassen darf. Ausgerollt wurde an die Mitarbeitenden Microsoft Copilot, unter anderem als interne Knowledge-Database, quasi das bessere Hilfeportal für alle. Ein RAG, in Sharepoint, für Copilot, wtf?!
Ein bemitleidenswerter Mitarbeitende darf sich da nun als Einzelkämpfer durchwühlen und Sharepoint mit internen Dokumenten füllen, die teils seit Jahren niemand angefasst hat und die in den allermeisten Fällen der pure Albtraum jedes token-gestützten Systems sind: Word-Dokumente mit Bildern, Powerpoint, Excel-Tabellen (eher harmlos), PDFs – das volle Programm. Irgendwann hat er/sie festgestellt, dass der inhaltliche Kontext von Bildern gar nicht erkannt wird, wenn er/sie die so in Sharepoint kippt. Also ist er/sie dazu übergegangen, Bilder und Grafiken in den Dokumenten von Hand zu beschreiben. Von Hand!
Dass das insgesamt betrachtet alles nicht so gut läuft, muss ich niemandem erzählen. Dass die Akzeptanz bei den Mitarbeitenden im Haus durchwachsen ist, vermutlich auch nicht. Exakt das passiert, wenn du dir vorher keine anständige Beratung mit Analyse deiner echten Probleme ins Haus holst. Und damit bin ich raus für diese Woche.
### Obsidian-Inbox automatisieren: n8n, Telegram und KI
URL: https://t01.li/kein-ki/obsidian-inbox-automatisieren-n8n/
Last updated: 2026-07-22T11:15:21.000Z
In [Teil 1](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/) ging es darum, wie und warum ich *Obsidian* als Second Brain nutze. In [Teil 2](https://t01.li/kein-ki/obsidian-vault-organisieren-frontmatter-templates-und-dataview/) darum, wie aus dem Vault über Frontmatter und *Dataview* eine Datenbank wird – schön und gut. Aber es bleibt die Frage, die sich bei jedem PKM früher oder später stellt: Wie kommt das Zeug überhaupt ins Vault, ohne dass du jede Notiz von Hand anlegst?
Meine Antwort sitzt in Telegram. Ich schicke einem Bot eine Sprachnachricht, einen Link, einen Screenshot oder ein paar hingetippte Gedanken. Ein paar Sekunden später liegt daraus automatisch eine fertig formatierte Markdown-Notiz in meiner Vault-Inbox, mit Titel, Exzerpt, Tags und korrektem Frontmatter. Die Fleißarbeit, die ich früher selbst gemacht hätte, übernimmt *Gemini*. Den Transport organisiert [n8n](https://n8n.io/?ref=t01.li).
Drei Workflows stecken dahinter. Alle drei sind weiter unten im Beitrag als Download bereitgestellt – importfertig. Hier erkläre ich, wie sie funktionieren und wo die Stolperstellen liegen.
## TL;DR
Ein Telegram-Bot ist der Eingang in den Vault. Du schickst etwas hin, n8n und Gemini machen daraus eine fertige Markdown-Notiz im richtigen Format. Drei Workflows decken die Eingabearten ab.
- **Gemeinsame Pipeline:** Telegram-Trigger (mit Chat-ID-Filter als Türsteher) → Gemini → JavaScript baut das Frontmatter → Google Drive → Hazel schiebt die Datei in den Vault.
- **Master-Hub:** ein Switch sortiert nach Eingabetyp – Sprachnachricht, Text, URL oder Foto – und schickt jeden Typ durch die passende Gemini-Analyse.
- **YouTube:** Gemini analysiert das Video direkt und liefert ein strukturiertes Exzerpt samt Mermaid-Diagrammen und Code-Blöcken.
- **Webseiten:** markdown.new wandelt die URL in sauberes Markdown, r.jina.ai springt als Fallback ein, ein Flag schaltet zwischen Zusammenfassung und Volltext.
- **Ehrlich bleibt:** Inhalte gehen an Google, Cloudflare und Jina. Ohne Personenbezug unproblematisch, bei Vertraulichem nicht.
## Das Grundprinzip: Telegram rein, Markdown raus
Bevor ich die drei einzeln auseinandernehme, lohnt der Blick auf das, was sie teilen. Denn das Ende ist bei allen gleich, und nur der Anfang unterscheidet sich.
Am Anfang steht immer ein Telegram-Trigger. Der hat ein Detail, das du nicht überlesen darfst: einen Filter auf deine eigene Chat-ID. Diese lässt sich schnell und einfach über den Bot @userinfobot in Telegram selbst ermitteln.
Dieser Filter ist der Türsteher. Ohne ihn würde der Bot auf jede Nachricht reagieren, die ihn erreicht – auch auf die von Dritten, die deinen Bot-Namen erraten. Mit ihm verarbeitet der Workflow nur, was von dir kommt. Trag deine eigene ID ein, sonst bleibt der Eingang entweder zu oder offen für alle.
Warum überhaupt Telegram? Weil es der Weg des geringsten Widerstands ist. Einen Bot legst du beim BotFather (@BotFather) in zwei Minuten an, du bekommst ein Token, fertig. Kein oAuth-Tanz, keine App im Review-Wartezimmer.
Und warum *Gemini*? Ein paar Gründe, die zusammenkommen: Gemini ist multimodal, frisst also Audio, Bild und Text mit demselben Modell – genau das, was dieser Bot braucht. Es ist verhältnismäßig günstig, wenn auch nicht spottbillig. Das Kontextfenster ist groß genug, dass auch lange Webseiten oder Transkripte am Stück reinpassen. Und der Punkt, der für mich den Ausschlag gibt: Die Integration in *n8n* läuft über ein Paket sehr leistungsfähiger und vor allem nativer Nodes, ich muss also nichts über rohe HTTP-Requests zusammenbauen.
Am Ende steht immer dieselbe Kette. Ein JavaScript-Node baut aus der *Gemini*\-Antwort eine Markdown-Datei mit genau dem Frontmatter, das du aus Teil 2 kennst:
```yaml
---
type: ressource
domain: Business
status: seedling
ai: all allowed
created: 2026-06-16 14:30
updated: 2026-06-16 14:30
tags: [n8n, automation, telegram]
---
```
`status`steht fest auf `seedling`, weil frisch reingeworfenes Material per Definition unreif ist. `ai `steht auf `all allowed`. Die `domain` wählt die KI aus drei Werten: `Business`, `Web-Dev` oder `Private`. Das ist der Punkt, an dem du das Ganze an deinen eigenen Vault anpasst – deine Domains sind aller Voraussicht nach andere als meine.
Diese fertige Datei landet in einem Google-Drive-Ordner. Von dort holt sie ein Sync-Schritt ab und legt sie in deine Vault-Inbox. Dazu am Ende mehr, das ist der unspektakulärste und gleichzeitig wichtigste Teil.
So weit das Skelett. Jetzt die drei Varianten:
## Der Allrounder: ein Bot für Stimme, Text, Link und Bild
Der erste Workflow ist der, den ich am häufigsten benutze. Er nimmt alles, was Telegram kann, und entscheidet selbst, was zu tun ist. Das Herzstück ist ein Switch direkt hinter dem Trigger, der nach dem Typ der Nachricht verzweigt.
Schickst du eine Sprachnachricht, greift dieser Zweig:
```javascript
// Switch-Regel: message.voice existiert?
{{ $json.message.voice }} // → exists
```
Ist Sprache da, lädt der Workflow die Audiodatei von Telegram und reicht sie an *Gemini* weiter. Und hier wird es interessant: *Gemini* transkribiert nicht nur, es analysiert. Aus zwei Minuten gemurmelter Gedanken im Auto wird eine strukturierte Notiz mit Titel, Exzerpt und Tags. Füllwörter fliegen raus, die Kernthese bleibt.
```
Du bist ein präziser Notiz-Assistent. Analysiere die Sprachnachricht
und erstelle eine strukturierte Obsidian-Notiz. Filtere Füllwörter
und Doppelungen, bring die Kernthesen auf den Punkt.
Antworte ausschließlich als JSON:
{"title":"...","type":"shortnote","domain":"Business | Web-Dev | Private", ...}
```
Schickst du Text, läuft er durch einen IF-Node, der prüft, ob eine URL drinsteckt. Reiner Text geht direkt an *Gemini*. Steckt ein Link drin (und ist es kein YouTube-Link, dazu gleich), holt der Workflow erst die Webseite und gibt den Inhalt mit. Schickst du ein Foto – einen Screenshot, eine abfotografierte Handschrift vom Notizblock, eine Skizze – wandert es in die Bildanalyse. *Gemini* transkribiert Handschrift, liest Tabellen aus, beschreibt Diagramme.
Ein Zweig im Switch bleibt bewusst leer: YouTube. Erkennt der Workflow einen YouTube-Link, tut er nichts, weil dafür ein eigener, spezialisierter Workflow zuständig ist. Das ist die einzige Stelle, an der mein Setup seine Geschichte zeigt – es ist über Monate gewachsen, nicht am Reißbrett entworfen. Ein sauberer Neubau würde die URL-Logik wahrscheinlich an einer Stelle bündeln. Bei mir liegt sie an zweien, und es funktioniert, also lasse ich es.
## YouTube: das Video selbst lesen lassen
Der zweite Workflow macht eine Sache, und die richtig. Du schickst einen YouTube-Link, *Gemini* analysiert das Video und gibt ein strukturiertes Exzerpt zurück.
Das Entscheidende: Hier wird kein Transkript durch einen Textgenerator geschoben. *Gemini* bekommt die Video-URL direkt und arbeitet multimodal damit. Der Prompt verlangt ein tiefes Extrakt statt Stichpunkten und weist die KI an, erwähnte Workflows als Mermaid-Diagramme und gezeigten Code als saubere Code-Blöcke zu rekonstruieren.
```
EXTRAKTIONS-GUIDE:
- Tiefes, vollständiges Extrakt, keine oberflächlichen Stichpunkte.
- Workflows als Mermaid-Diagramme, Code als Code-Blöcke rekonstruieren.
- Technische Parameter, Bibliotheken, API-Endpunkte erfassen.
```
Der JavaScript-Node danach baut aus dem JSON die Notiz zusammen. Er kümmert sich auch um Kleinkram, der in der Praxis nervt: Der Dateiname wird auf sechs Wörter gekürzt und von Sonderzeichen befreit, die Tags landen sauber im Frontmatter, die Quelle steht als Callout über dem Inhalt.
```javascript
const cleanTitle = title
.replace(/[#^\[\]\/\\?%*:|"<>]/g, '')
.split(/\s+/)
.slice(0, 6)
.join(' ')
.trim();
```
Eine Stolperstelle bleibt. Der Workflow zieht die Video-URL aus der Telegram-Linkvorschau. Schickst du den Link ohne Vorschau oder mitten in einem längeren Satz, kann das Feld leer sein und *Gemini* bekommt nichts zu sehen. Link allein in die Nachricht, dann läuft es.
## Webseiten: erst sauber machen, dann zusammenfassen
Der dritte Workflow ist mein Liebling, weil er ein hässliches Problem elegant löst. Webseiten sind in vielen Fällen vollgemüllt – Navigation, Cookie-Banner, Footer, Werbung. Wer das roh an eine KI gibt, bezahlt Tokens für die Verpackung gleich mit anstatt nur für den Inhalt.
Statt selbst zu putzen, schiebt der Workflow die URL durch [markdown.new](https://markdown.new/?ref=t01.li), einen kostenlosen Dienst von Cloudflare. Du stellst der URL einfach `markdown.new/` voran und bekommst sauberes Markdown zurück, laut Anbieter rund 80 Prozent kleiner als das rohe HTML.
```
https://markdown.new/{{ $json.url }}?method=auto&retain_images=true
```
Jetzt der elegante Teil. Dienste fallen mal aus, und `markdown.new` kommt mit paywalled oder JS-lastigen Seiten nicht immer klar. Also baut der Workflow eine Fallback-Kette. Ein IF-Node prüft, ob die Antwort einen Fehler enthält. Wenn ja, wandert dieselbe URL an `r.jina.ai`, den Reader von *Jina*, der dasselbe leistet, nur über einen anderen Weg.
```javascript
// IF-Bedingung: Antwort enthält "success":false → Fallback
leftValue: {{ $json.data }}
operation: contains
rightValue: "success":false
```
Erst wenn einer der beiden sauberes Markdown geliefert hat, übernimmt *Gemini* und macht daraus die Notiz. Es gibt zwei Modi, gesteuert über ein Flag in der Telegram-Nachricht. Hängst du `-f` an die URL, schaltet der Workflow auf Full: Der bereinigte Inhalt bleibt eins zu eins erhalten, fremdsprachiges wird ins Deutsche übersetzt, nichts wird gekürzt. Ohne Flag läuft der Summary-Modus mit einer ausführlichen Zusammenfassung.
```javascript
const flagMatch = raw.match(/^(.+?)\s+(-f)$/);
let mode = flagMatch ? "full" : "summary";
```
Ein kleiner Parser, eine große Wirkung. Meldungen und News überfliege ich als Zusammenfassung, die wichtige Dokumentation archiviere ich im Volltext.
## Der letzte Meter: von Drive in den Vault
Alle drei Workflows enden im selben Google-Drive-Ordner. Damit ist die Notiz aber noch nicht im Vault, sie liegt erst mal in der Cloud. Der letzte Schritt schiebt sie an ihren Platz.
Warum überhaupt Google Drive? Das ist schon mehr Krampf als der Telegram-Bot, zugegeben. Die OAuth-Einrichtung über die Google Cloud Console kostet ein paar Klicks. Trotzdem ist es der bequemere Weg, jedenfalls gegen die Alternative, die ich kenne: OneDrive über die Microsoft Graph API. Ich betreibe beides im Alltag, und die Google-Variante ist in meinen Augen einen Tick weniger aufwendig.
Bei mir holt [Hazel](https://www.noodlesoft.com/?ref=t01.li) die Datei ab, ein Regel-Automat für macOS. Hazel überwacht den synchronisierten Drive-Ordner, und sobald eine neue `.md`\-Datei auftaucht, verschiebt es sie in den `0 Inbox`\-Ordner meines Vaults. Mit dem nächsten Sync von Obsidian ist die Notiz auf allen Geräten.
Hazel ist Mac-only, also für viele keine Option. Auf Windows erledigen [File Juggler](https://www.filejuggler.com/?ref=t01.li) oder Power Automate denselben Job, plattformübergreifend tut es ein kleines Skript per cron.
Womit eine naheliegende Frage offen ist: Warum nicht der *Obsidian*\-Community-Node für *n8n*? Den gibt es, und er schreibt über die Local REST API direkt in den Vault. Der Haken sitzt in der Topologie. Dafür müsste *n8n* meinen lokalen *Obsidian*\-Rechner erreichen. Meine Instanz läuft aber auf einem Cloud-Server, der keine lokalen Dateien durch die Gegend schiebt. Also bringt der Node mir nichts, und der Umweg über die Cloud bleibt. Wer *n8n* lokal betreibt, dreht den Spieß um: Node rein, Drive und Hazel komplett sparen.
### Was rausgeht, ehrlich gesagt
Eine Sache gehört offen ausgesprochen, bevor du das nachbaust: Deine Inhalte verlassen das Haus. Sprachnachrichten und Screenshots gehen an Google, weil *Gemini* in allen Workflows läuft. URLs und der gescrapte Webinhalt gehen an Cloudflare und an *Jina*. In meinen Notizen, die diese Workflows durchlaufen, stecken keine personenbezogenen oder sonstige vertrauliche Daten – es sind Gedankenfetzen, Artikel, Skizzen. Für diesen Fall ist der Transfer unproblematisch. Sobald aber Personenbezug oder Vertrauliches durch die Pipeline läuft, sieht die Rechnung anders aus. Das entscheidest du pro Inhalt selbst. Dieser Aspekt wird auch im vierten Teil noch relevant werden.
Ein technischer Hinweis fürs Protokoll: Die Workflows nutzen u. A. *Gemini 3 Flash* als Preview-Modell. Preview heißt, das Modell kann ohne große Vorwarnung auslaufen. Wenn dein Workflow eines Tages grundlos Fehler wirft, schau zuerst hier nach und tausch auf die dann aktuelle Version oder einen `latest`\-Alias.
### Was als nächstes kommt
Damit ist der Kreis fast geschlossen. Der Vault ist strukturiert (Teil 1), abfragbar (Teil 2) und füllt sich von selbst (dieser Teil). Fehlt noch der direkte Draht. Im letzten Teil verbinde ich den Vault über MCP mit *Claude Code* und dem *Gemini CLI*, lasse das frisch gebündelte Obsidian-CLI mitspielen und zeige, wie das `ai`\-Feld im Frontmatter endlich zu dem wird, wofür es gedacht ist – ein Rechtesystem für die KI, die im Vault arbeitet.
Die drei Workflows liegen als JSON zum Download bereit. Importieren, die drei Credentials neu verknüpfen, deine Chat-ID und deinen Drive-Ordner eintragen, fertig.
[n8n Obsidian WorkflowsDrei Workflows für Text, Bild, Video, Audio und URL zu Obsidian.telegram-obsidian-workflows.zip14 KBdownload-circle](https://t01.li/content/files/2026/06/telegram-obsidian-workflows.zip "Download")
### Beiträge der Serie:
- [Obsidian – mein digitales Gehirn, und warum ich nie wieder zurück möchte](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/)
- [Obsidian-Vault organisieren: Frontmatter, Templates und Dataview](https://t01.li/kein-ki/obsidian-vault-organisieren-frontmatter-templates-und-dataview/)
- [Obsidian und MCP: Claude Code, Codex und Antigravity Zugriff auf den Vault geben](https://t01.li/kein-ki/obsidian-mcp-claude-code-codex-antigravity/)
### GEO-Citations bringen keine Conversions
URL: https://t01.li/geo-seo/geo-citations-bringen-keine-conversions/
Last updated: 2026-09-10T06:34:53.000Z
Die [GEO](https://t01.li/generative-engine-optimization-geo/)\-Szene hat sich in eine Zahl verliebt: die Citation. Werde von ChatGPT zitiert, tauch im AI Overview auf – dann hast du angeblich gewonnen. Klingt nach dem neuen Ranking. Ist es auch, nur in einer Währung, mit der ich nichts bezahlen kann.
Wir bauen Seiten, die von Anfragen leben. Probefahrten, Beratungstermine, ausgefüllte Formulare. Eine Erwähnung in einer KI-Antwort, die niemand anklickt, taucht in keiner dieser Zahlen auf. Sie fühlt sich gut an im Reporting und tut für meinen Kunden aber genau nichts. An ein paar Stellen kosten sie ihn sogar etwas.
## TL;DR
GEO feiert Citations als neue Leitwährung. Für conversion-getriebene Seiten ist das die falsche Metrik.
- Eine Citation ist eine Erwähnung, kein Besuch – in Google AI Overviews wird die zitierte Quelle nur in rund 1 % der Fälle angeklickt.
- Wer von Anfragen lebt, gewinnt durch eine klicklose Erwähnung nichts – und verliert über Lead-Magneten teils aktiv.
- KI-Referral konvertiert hoch, ist aber im Volumen winzig – Organic sendet ein Vielfaches mehr Traffic.
- Bei transaktionalen und lokalen Suchen hält das organische Ranking die Anfragen – dort greift das AI Overview seltener.
- Agentisches Browsing kann das irgendwann drehen – aber derzeit nicht, am wenigsten bei hochwertigen physischen Conversions.
## Eine Erwähnung ist kein Besuch
Hier liegt der Denkfehler, den die ganze Debatte mitschleppt. Citation und Klick werden in einen Topf geworfen, als wäre das eine die Folge des anderen. Surprise: ist es nicht.
Pew Research hat im Frühjahr 2025 das Surfverhalten von 900 US-Nutzern über knapp 70.000 Suchen erhoben. [Das Ergebnis](https://www.pewresearch.org/short-reads/2025/07/22/google-users-are-less-likely-to-click-on-links-when-an-ai-summary-appears-in-the-results/?ref=t01.li). Taucht ein AI Overview auf, klicken nur 8 % auf ein organisches Ergebnis, ohne Overview sind es 15 %. Fast eine Halbierung. Und der Klick auf die im Overview zitierte Quelle? Passiert in genau 1 % der Fälle. Eine von hundert Erwähnungen wird zum Besuch.
Das ist der Punkt, an dem GEO-Reporting und Realität auseinanderlaufen. Du kannst in ChatGPT vierstellig oft zitiert werden und in der Search Console eine glatte Null stehen haben. Reichweite wird mit Wirkung verwechselt. Für eine Marke, die Sichtbarkeit verkauft, mag die Erwähnung reichen. Bei vielen unserer Kunden endet die Erwähnung als Sackgasse, weil hinter dem Klick erst das beginnt, womit sie Geld verdienen.
## Wenn die KI deinen Lead-Magneten überflüssig macht
Jetzt zu der Stelle, an der es nicht neutral, sondern teuer wird. Nimm den Klassiker der Lead-Generierung: „Die 10 wichtigsten Antworten zu Thema X“, als PDF, gegen eine E-Mail-Adresse. Der ganze Mechanismus lebt davon, dass dein Wissen knapp ist. Du gibst die Antworten her, der Interessent gibt seine Adresse.
Den eigentlichen Gate kann eine KI nicht knacken. Crawler wie GPTBot oder PerplexityBot füllen keine Formulare aus, hinter einem Login zitiert dich niemand. Klingt nach Schutz. Der Schaden läuft eine Etage tiefer. Die zehn Antworten sind ja nicht dein Geheimnis – sie stehen in dutzenden offenen Quellen, und genau die fasst die KI in zwei Sekunden zusammen. Dein gegatetes PDF konkurriert nicht mehr mit anderen PDFs, [sondern mit einem Modell](https://www.factors.ai/blog/is-gated-content-dead-in-b2b-marketing-what-works-now?ref=t01.li), das hunderte Quellen sofort synthetisiert. Wer die Antwort schon im Chatfenster bekommt, gibt dafür keine Adresse mehr her. Der Tausch Wissen gegen Kontakt kollabiert – nicht weil dich die KI zitiert, sondern weil sie dich überflüssig macht.
Eine Citation auf so einer Seite ist dann kein Gewinn, sie ist die Quittung dafür, dass dein Angebot gerade entwertet wurde.
## Bei diesem Kunden hält das Ranking die Anfragen
Einer unserer Kunden ist ein Händler im hochpreisigen Sportwagen- und Performance-Segment. Conversion heißt dort: Probefahrt- oder Beratungsanfrage über die Modellseiten. Leute fahren für so ein Fahrzeug mehrere hundert Kilometer weit – die Anfrage ist viel wert, und sie ist physisch. Kein Chatbot bucht sie ab.
Schau ich mir an, wo die KI-Antworten greifen und wo die organischen Rankings sitzen, ergibt sich ein sauberes Muster. Die AI Overviews kleben fast durchweg an den Wissensfragen: Beschleunigungswerte, technische Daten, Flügeltüren, Release-Termine, historische Modellbezeichnungen. Also dort, wo eine Antwort die Sache abschließend erledigt und niemand danach zum Händler fährt.
Die Cluster dagegen, die tatsächlich Anfragen bringen, laufen organisch – und laufen gut. Das Marken-Keyword steht auf Seite 1, der Konfigurator auf Position 1, Leasing und Gebrauchtwagen weit oben, die Preis-Suchen ranken breit. Am schönsten für das Argument: die lokalen Händler- und Standort-Suchen, ebenfalls Position 1\. Das sind die Pfade zur Probefahrt. Auf keinem davon hält mir ein AI Overview den Interessenten weg. Die Citations sitzen da, wo nichts zu holen ist; das Ranking sitzt da, wo die Anfrage entsteht.
## Was ich gelten lasse – und was nicht
Damit das kein Rundumschlag wird: Es gibt ein ernsthaftes Gegenargument. KI-Traffic konvertiert, wenn er denn klickt, brutal gut. Seer Interactive [hat gemessen](https://www.seerinteractive.com/insights/case-study-6-learnings-about-how-traffic-from-chatgpt-converts?ref=t01.li), dass ChatGPT-Besucher mit 15,9 % konvertieren, gegen 1,76 % aus der organischen Google-Suche. Klingt nach einem Argument gegen meine ganze These.
Ist es nicht, und zwar aus zwei Gründen: Erstens stammt die Zahl von einem einzelnen B2B-Kunden, gemessen von einer SEO-Agentur – als Tendenz brauchbar, als Festwert nicht. Zweitens, und das wiegt schwerer: Die hohe Quote gilt nur für die wenigen, die überhaupt klicken. Eine von hundert, siehe oben. Im absoluten Volumen sendet die organische Suche je nach Erhebung [300- bis 345-mal mehr Traffic](https://www.getpassionfruit.com/blog/are-ai-search-referrals-the-new-clicks?ref=t01.li) als ChatGPT, Gemini und Perplexity zusammen. Hohe Conversion auf einer winzigen Basis bleibt eine winzige Zahl. Und bei rein transaktionalen Abschlüssen schmilzt der Vorteil sowieso weg.
Den ehrlichen Dämpfer spare ich mir nicht. Organisch ist auch nicht mehr die sichere Bank. *Sistrix* hat über 100 Millionen deutsche Keywords ausgewertet, und der Befund ist [brutal](https://www.sistrix.de/news/ai-overviews-in-deutschland-so-stark-sinken-die-klickraten-wirklich/?ref=t01.li). Bei AI-Overview-Präsenz fällt die Klickrate auf Position 1 von 27 % auf 11 %, fast 60 % weg. Wer glaubt, ein Top-Ranking sei für alle Ewigkeit ein Selbstläufer, irrt. Dieselbe Auswertung zeigt aber, wen es trifft. How-to- und Ratgeberseiten verlieren am härtesten, bis über 24 %, weil dort eine KI-Antwort die Frage gut genug beantwortet. Transaktionsnahe Bereiche kommen glimpflich davon, Rezeptseiten etwa nur rund 1 %. Genau dieses Muster steckt hinter dem Auto-Beispiel – die Wissensfrage verliert, die kommerzielle Suche hält. Organisch ist nicht überall sicher, aber bei kommerziellen und lokalen Query-Typen die bessere Wette. Für conversion-getriebene Seiten die einzige, die zählt.
## Der Punkt, an dem die Erwähnung doch zur Anfrage wird
Eine Sache lasse ich nicht unter den Tisch fallen, weil sie meine ganze Rechnung irgendwann kippt: agentisches Browsing. Sobald ein Agent für mich klickt und Formulare ausfüllt, statt nur zu lesen, ist die Erwähnung keine Sackgasse mehr. Dann führt sie zur Aktion, nur ohne menschlichen Klick dazwischen.
Technisch wird das gerade interessant. *Hermes Agent* von Nous Research steuert einen echten Chromium, navigiert, tippt, füllt Felder aus. *Claude Cowork* agiert über den Browser ebenfalls auf Websites, Googles [Chrome-Auto-Browse auf *Gemini 3.1*](https://workos.com/blog/ai-agent-web-traffic-what-developers-need-to-change?ref=t01.li) kommt gerade auf Android, Amazons „Buy for Me“ kauft auf fremden Seiten ein. Die Demos laufen.
Bevor jetzt aber der nächste GEO-Berater auf LinkedIn „Optimiere JETZT für Agenten, sonst bist du raus“ in seine Timeline absondert: Die Demos sind das eine, der Alltag das andere. Dieselben Agenten brechen bei Captcha und Zwei-Faktor-Auth ab, ebenso kommen sie nicht ohne Weiteres an Magic Links heran oder hängen im Checkout fest. Genau dort, wo bei unseren Kunden die Anfragen entstehen. Und für unseren Sportwagen-Kunden ist die Sache fast putzig. Aktuell lässt (noch) niemand einen Bot die Probefahrt für ein Fahrzeug zum Preis einer Eigentumswohnung buchen. Hoher Wert, physische Übergabe, Vertrauensfrage, emotionaler Aspekt. Das ist das Letzte, was ein Agent autonom erledigt, nicht das Erste.
Theorie hin oder her, ich habe es durchprobiert. *Hermes Agent,* *OpenClaw*, die *Codex*\-App, *Claude Cowork* – alle durften an echte Formulare ran, alle laufen in exakt dieselben Wände. Hänge ich ein Mailkonto dran, klickt der Agent den Magic Link brav aus dem Postfach und ist drin. Das klappt sauber. Aber dann steht da in nicht wenigen Fällen „I’m not a robot“ - Feierabend. Wo ein Mensch gedankenlos ein Häkchen setzt, ist für den Agenten Schluss. Das eine Häkchen ist die ganze Mauer.
[McKinsey hält für den deutschen Markt](https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-agentic-commerce-opportunity-how-ai-agents-are-ushering-in-a-new-era-for-consumers-and-merchants?ref=t01.li) ohnehin einen Dämpfer bereit. Wer hier schon einer Website seine Bankdaten nur zögerlich gibt und lieber per Rechnung oder Überweisung zahlt, übergibt einem Bot so schnell keine Kaufentscheidung. Für DACH ist die agentische Anfrage noch ein gutes Stück Vertrauensvorschuss zu viel.
Was bleibt, ist kein Grund zur Panik, sondern eine Hausaufgabe. Wenn der Tag kommt, an dem Agenten zuverlässig Formulare ausfüllen, gewinnt nicht, wer am lautesten zitiert wird, sondern wessen Conversion-Pfade maschinenlesbar sind. Sauberes Markup, strukturierte Daten, ein Formular, das ein Agent überhaupt bedienen kann. Plus ein Reporting, das die agentische Aktion sieht, denn in der klassischen Analytics taucht sie als null Websitebesuche auf. Das plane ich heute ein. Optimieren tue ich es, wenn die Reliability konkret wird, nicht früher.
### Der Hot-Take am Ende
GEO und AO ist nicht falsch. Es ist die falsche Leitmetrik, wenn am Ende ein Formular ausgefüllt werden soll. Ich optimiere auf Citations exakt so weit, wie sie zu einem Klick führen – und keinen Schritt weiter. Den Rest der Energie stecke ich in Rankings, die jemanden auf die Seite holen, der danach etwas tut. Und GEO ohne ein sauberes technisches Fundament [bleibt ohnehin Kaffeesatzleserei](https://t01.li/geo-seo/geo-ohne-technisches-seo-ist-kaffeesatzleserei/).
Eine Erwähnung kann ich mir nicht ans Bein binden. Einen Lead schon.
### AI Picks der 25. KW
URL: https://t01.li/ai-shorts/ai-picks-der-25-kw/
Last updated: 2026-06-21T05:32:35.000Z
Woche eins nach dem Urlaub, und die News werden wieder vielfältiger. Die LLM-Release-Flut hat sich etwas beruhigt, dafür gibt es reichlich anderes.
Anekdote am Rand: Letzte Woche hatte ich angekündigt, *DiffusionGemma* in *LM Studio* testen zu wollen. Tja, wird nichts – jedenfalls nicht im Moment und nicht als MLX unter macOS, so weit ist *LM Studio* noch nicht. Bliebe der Weg über *llama.cpp*. Den gibt es aktuell aber nur als Selbstbau aus einem offenen Pull Request, samt eigenem `llama-diffusion-cli`. Darauf habe ich ehrlich gesagt keinen Bock und warte, bis *LM Studio* die MLX-Unterstützung nachzieht.
Das war diese Woche so los:
## 7 Best Small Language Models Under 10B Parameters in 2026
Eine [schicke kleine Auflistung](https://www.labellerr.com/blog/best-small-language-models-under-10b-parameters/?ref=t01.li) von Modellen, die bequem auf die bessere Bürokiste passen – und mit denen sich schon was reißen lässt. Je nach Hardware wirft man das Reasoning eventuell raus und schaltet auf Non-Thinking – soweit das Modell den Schalter überhaupt mitbringt.
Wo „Code Generation“ steht, würde ich bei der Modellgröße die Erwartungen niedrig hängen. Für JSON und ähnliches Geschäft reicht es aber dicke.
## The Art of Loop Engineering
Dazu kommt zeitnah ein eigener Artikel, aber das nehme ich schon mal vorweg – als den neuen Hot Shit, der gerade durchs Dorf getrieben wird: [Loop Engineering](https://www.langchain.com/blog/the-art-of-loop-engineering?ref=t01.li).
Kurz gefasst lässt man Agenten eigenständig planen, handeln, Responses einholen und nachjustieren, bis ein Task durch ist oder irgendwo hängen bleibt. Von Human-on-the-Loop zu Human-on-the-End. Ob das gut geht, entscheiden deine Guardrails.
## Introducing eve
Vercel legt mal wieder was nach: [*eve*](https://vercel.com/blog/introducing-eve?ref=t01.li), ein Framework zum Entwickeln und Betreiben von Agents – mit Sandboxing, Subagents, Evals und dem ganzen Rest, den man bei so einem Paket eigentlich haben will. Apache 2.0, aktuell noch [Public Beta](https://vercel.com/eve?ref=t01.li).
Am Rande: Viele Unternehmen, insbesondere zwischen Flensburg und Passau, könnten sich von Vercels Open-Source-Engagement eine große Scheibe abschneiden. Open Source nutzen die Big Player hierzulande gern und oft – selbst etwas beizutragen ist eher die Ausnahme als die Regel.
Mir ist absolut bewusst, dass Vercel das nicht aus reiner christlicher Nächstenliebe tut, sondern auch eigene Interessen verfolgt. Aber bei uns wird gern im stillen Kämmerlein geschraubt und dabei auch munter gegen Copyleft-Lizenzen wie GPL oder AGPL verstoßen. Bindet man eine fremde Bibliothek unter einer GPL ein, muss man den eigenen Quellcode ebenfalls offenlegen. In Deutschland dann aber so: „Des hemmer 'baut, des isch unser!"
## Codex can run against a local „open source“ provider
Auch OpenAI öffnet die Tore. Thibault Sottiaux auf X dazu:
> „Reminder that you can use the Codex App, CLI and SDK with any open source model, not just with OpenAI models.“
Also lassen sich z.B. [*Kimi K2.7 Code*](https://t01.li/ai-shorts/ai-picks-der-24-kw/#kimi-code) oder [*GLM 5.2*](https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/) jetzt auch in [*Codex*](https://developers.openai.com/codex/config-advanced?ref=t01.li#oss-mode-local-providers) schieben, wenn man auf deren eigene Tools oder OpenCode keinen Bock hat.
Übrigens: Per GUI in den Settings der Codex App umstellen ist nicht. Ein wenig Frickelei bleibt also.
## Run N concurrent Gemma 4 instances on a local llama-server
Dieses „hier habt ihr *Gemma 4*, nun viel Spaß damit“ von Google finde ich offen gesagt ziemlich nice – und DeepMind lassen sie anscheinend reichlich Freiraum zum Schrauben.
Anders ließe sich [dieses Repo](https://github.com/google-gemma/cookbook/tree/main/apps/concurrent?ref=t01.li) kaum erklären.
## Vom Chat zum Agenten: Copilot Cowork für Microsoft 365 ist da
Ich musste in der Vergangenheit immer ein wenig schmunzeln, wenn in Gesprächen fiel: „Wir rollen bei uns auch gerade KI aus – Copilot.“
Egal. [Microsoft zeigt Ambitionen](https://www.heise.de/news/Vom-Chat-zum-Agenten-Copilot-Cowork-fuer-Microsoft-365-ist-da-11335405.html?ref=t01.li) und denkt sogar an Security. Das ist mehr, als ich ehrlich gesagt erwartet hatte. Dass *Cowork* unter der Haube auf Anthropics Technik läuft, macht die Sache nicht weniger amüsant.
## Anthropic ships major Claude Design overhaul with design system imports, code round-trips, and a fix for its token-burning problem
Das sind eigentlich drei Meldungen in einer – und für die meisten von uns dürfte der letzte Halbsatz die eigentliche News sein.
[Anthropic hat *Claude Design* überarbeitet](https://venturebeat.com/technology/anthropic-ships-major-claude-design-overhaul-with-design-system-imports-code-round-trips-and-a-fix-for-its-token-burning-problem?ref=t01.li): Design-System-Imports, Code-Round-Trips und ein Fix für den Token-Hunger. Letzterer ist der Punkt. Der April-Release fraß in rund 25 Minuten 80 Prozent des wöchentlichen Pro-Kontingents – jetzt teilt sich *Claude Design* die Limits mit Chat, *Cowork* und Code, und ein Turn kostet laut Anthropic weniger Tokens.
## EU Icons for labelling AI-generated content
Wo sonst gern auf der EU herumgehackt wird, muss ich an dieser Stelle mal loben. Die KI-Kennzeichnungspflicht ist aus mehreren Gründen sinnvoll, und die Pflicht aus Artikel 50 greift ab dem 2\. August 2026.
Sie denken auch praktisch mit und liefern die passenden [Icons](https://digital-strategy.ec.europa.eu/en/policies/eu-icons-labelling-ai-generated-content?ref=t01.li) gleich mit – free to use. Bei der Lizenz waren sie etwas kreativ, aber was soll's:
> These icons are made publicly available for everyone to use freely, without the need for attribution to the Commission or the AI Office. However, signatories of the code of practice should use the icon in accordance with its placement specifications. Usage of these icons by non-signatories of the code should not be construed as signaling of their adherence to the code.
Auch hier eine Anekdote am Rand: Der [deutsche Presserat](https://www.golem.de/news/medien-presserat-lehnt-kennzeichnungspflicht-fuer-ki-texte-ab-2606-209902.html?ref=t01.li) lehnt eine Kennzeichnungspflicht für KI-Texte ab. Bei Bildern und Videos soll sie dann aber doch gelten. Warum überrascht mich das kein bisschen?
## Markdown Comes to LiteParse
Das Thema lässt mich nicht los, weil ich dann doch häufiger damit zu tun habe. Dokument X in die Pipeline kippen, die relevanten Daten rausziehen, erst mal als [JSON wegschreiben](https://t01.li/ki-systemdesign/llm-datenformate-json-yaml-xml-toon-html-im-vergleich/). Klingt harmlos, der erste Part mit den Dokumenten kann aber unschön werden, je nach Art des Dokuments.
Dafür gibt es [*LiteParse*](https://developers.llamaindex.ai/liteparse/?ref=t01.li), [kürzlich in v2.1 erschienen](https://www.llamaindex.ai/blog/markdown-comes-to-liteparse?ref=t01.li). Dort wurde jetzt Markdown als Outputformat nachgerüstet. Das eröffnet Zwischenschritte. Bevor ich den Output weiterreiche, prüfe ich gern, ob er überhaupt sauber verarbeitbar ist – und diesen Check fahre ich jetzt gegen ein schlankes Markdown statt gegen ein potenziell aufgeblähtes PDF.
## MCP gets its missing enterprise authorization layer
Kein lästiges OAuth mehr für jeden Client einzeln – jedenfalls nicht mehr direkt –, dafür eine unternehmensweite Autorisierung: [ID-JAG](https://thenewstack.io/mcp-gets-its-missing-enterprise-authorization-layer/?ref=t01.li) (Identity Assertion JWT Authorization Grant), aktuell noch im Draft-Status.
Der Draft kommt aus der IETF, wird von Okta vorangetrieben und soll in die MCP-Spec wandern. Für Enterprise-Setups ist das der fehlende Baustein. Ein zentraler Identity Provider regelt, welcher Client an welche Ressource darf, statt dass jede App ihren eigenen OAuth-Tanz aufführt.
## Exclusive: OpenAI Losses Increased Nearly 8X in 2025, With Spending Hitting $34 Billion
Man könnte jetzt darauf herumhacken, aber das wäre dann nur sinnloses Daraufherumhacken. [Ed Zitron](https://www.wheresyoured.at/exclusive-openai-financials/?ref=t01.li) hat die testierten Zahlen gesehen, von der Financial Times gegengeprüft: 13 Milliarden Umsatz, 34 Milliarden Kosten, unterm Strich ein Verlust von rund 38 Milliarden. Grob das Achtfache von 2024.
Es gab in der Vergangenheit schlimmere Fälle von Geldverbrennung. Enron zum Beispiel, das hatte dann allerdings andere Konsequenzen. Oder, jünger: WeWork – wo Geld zum Fenster rauswerfen zum guten Ton gehörte. Gründer Neumann musste schon nach dem geplatzten IPO 2019 als CEO gehen, der Laden selbst rettete sich später über eine Insolvenz und radikales Verschlanken, aus der er Mitte 2024 als abgespeckte Privatfirma wieder rauskam.
Altman wollte man ja auch mal loswerden, aber die Belegschaft wollte ihn zurück. Was beim gleichzeitigen Vorwurf, er begünstige eine toxische Arbeitsatmosphäre, schon erstaunlich ist. Das stärkt die Glaubwürdigkeit jener, die den Vorwurf in den Raum gestellt haben, nicht gerade. Ich lasse das weitgehend unkommentiert und unterlasse Spekulationen.
## Building an LLM safe design system
Kurz gefasst, warum Polar *Tailwind* einschränkt, sobald ein LLM den Code tippt. Das klingt schlüssig.
Der Punkt ist nicht, dass *Tailwind* schlecht wäre – Polar nennt es selbst „outstanding“. Das Problem ist die [Offenheit](https://polar.sh/blog/orbit-llm-safe-design-system?ref=t01.li). Für einen Menschen am Keyboard ist sie ein Feature, für ein tippendes Modell wird sie zum Risiko. Bitte ein LLM um eine Card, und es greift zu `p-4`, `rounded-lg`, `bg-gray-100` – jeder Wert für sich plausibel, keiner zwingend deiner. Über hunderte Komponenten driftet das Interface in tausend leicht verschiedene Grautöne. Polars Antwort heißt *Orbit*, ein getyptes System, in dem sich eine Off-Brand-Entscheidung gar nicht erst ausdrücken lässt. Was nicht als Design-Decision hinterlegt ist, kommt nicht durch die CI.
Nur am Rande: Das hier genutzte Blog-Theme wurde von *Claude Code* gebaut, also auch von einem LLM – und trotzdem kam etwas Schlankes, Bloat-armes mit *Tailwind* heraus. Fairerweise ist ein kleines Ghost-Theme aber nicht im Ansatz mit Polars Maßstab vergleichbar. Was bei einer Handvoll Templates sauber bleibt, driftet im Team-Betrieb über tausende Generationen trotzdem weg.
Soviel zu dieser Woche. Vielleicht werden nächste Woche wieder LLM-Wochen eingeläutet – schauen wir mal.
### Obsidian-Vault organisieren: Frontmatter, Templates und Dataview
URL: https://t01.li/kein-ki/obsidian-vault-organisieren-frontmatter-templates-und-dataview/
Last updated: 2026-07-22T11:14:52.000Z
Im [ersten Teil](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/) habe ich erklärt, warum [Obsidian](https://obsidian.md/?ref=t01.li) bei mir Evernote und Todoist abgelöst hat und warum ich PARA dem Zettelkasten vorziehe. Was dort nur als Versprechen stehenblieb: wie aus dem Vault – dem Ordner voller `.md`\-Dateien – etwas wird, das sich wie eine Strukturierung anfühlt. Das hole ich jetzt nach.
Vorweg, damit klar ist, worum es nicht geht. Das hier ist keine Plugin-Galerie. Es geht um drei Dinge, die ineinandergreifen – eine Ordnerstruktur, die man nicht jede Woche neu überdenkt, ein Frontmatter, das jede Notiz maschinenlesbar macht, und *Dataview*, das daraus Dashboards baut. Am Ende lege ich dir mein Standard-Template und mein Inbox-Dashboard als kostenlosen Download dazu. Beide laufen bei mir produktiv.
## TL;DR
Drei Bausteine machen aus dem Vault eine abfragbare Wissensbasis. Wer sie sauber aufsetzt, friemelt nie wieder im Raw-YAML herum und findet Notizen über Filter statt über Erinnerung.
- **Ordnerstruktur:** nummeriertes PARA (`0 Inbox` bis `4 Archiv`) – die Zahl erzwingt die Sortierung, die Inbox erzwingt die Triage.
- **Frontmatter-Template:** jede Notiz bekommt beim Anlegen denselben Header. Das native Templates-Plugin fügt ihn ein, der *Linter* hält die Zeitstempel aktuell.
- **Metadata Menu:** typisierte Felder mit Dropdown-Werten statt freihändig getipptem YAML – zwei Klicks statt Tippfehler.
- **Dataview:** SQL-ähnliche Abfragen und JavaScript-Dashboards verwandeln den Vault in eine Datenbank. Mein Inbox-Dashboard zeigt, wie das konkret aussieht.
- **Ausblick:** Obsidian zieht mit *Bases* nativ nach. Warum ich trotzdem (noch) bei *Dataview* bleibe, steht am Ende.
## Die Ordnerstruktur: PARA, aber mit Nummern
In Teil 1 stand noch eine Struktur mit leicht anderen Ordnernamen – `0 Inbox`, `1 Projekte`, `2 Gedanken`und so weiter. Diese habe ich seitdem aufgeräumt und noch etwas näher an der PARA-Struktur ausgerichtet. Heute sieht die oberste Ebene so aus:
- 0 Inbox
- 1 Projekte
- 2 Bereiche
- 3 Ressourcen
- 4 Archiv
- 5 System (Für Templates, Vorlagen, etc.)
Die Nummer ist kein Selbstzweck. Sie erzwingt die Reihenfolge im Datei-Explorer, und die Reihenfolge bildet den Workflow ab: Alles startet in `0 Inbox`, wandert nach der Triage in einen Projekt-, Bereichs- oder Ressourcen-Ordner und landet irgendwann in `4 Archiv` oder im Papierkorb. Wer schon mal versucht hat, alphabetisch sortierte Ordner gegen die eigene Denkrichtung zu lesen, weiß, warum die Null vorne steht.
Die zweite Achse läuft quer zu den Ordnern: die `domain`. Sie steckt im Frontmatter, nicht im Pfad, und trennt meine Lebens- und Arbeitsbereiche – `Web-Dev`, `Business`, `Blog`, `Private`. Eine Notiz liegt also physisch in `1 Projekte`, gehört aber logisch zur Domain `Blog`. Diese Trennung von Ablageort und Themenzugehörigkeit ist der Trick, der *Dataview* später überhaupt erst nützlich macht.
## Das Frontmatter-Template
Jede Notiz im Vault bekommt beim Anlegen denselben Kopf. Das übernimmt das native [Templates-Plugin](https://help.obsidian.md/Plugins/Templates?ref=t01.li) – kein Community-Plugin nötig. Mein Standard-Template:
```Markdown
---
type:
domain:
status:
created:
updated:
ai:
tags: []
---
# {{title}}
## Exzerpt
Zusammenfassung
## Inhalt
```
Der `{{title}}`\-Platzhalter ist eine Variable des Templates-Plugins. Beim Einfügen ersetzt *Obsidian* sie durch den Dateinamen. `{{date}}` und `{{time}}` gäbe es auch, aber genau hier liegt eine Grenze, die man kennen sollte: Das native Plugin fügt nur einmalig ein. Ein `updated`\-Feld, das sich bei jeder Änderung selbst fortschreibt, kann es nicht abbilden.
Diese Aufgabe übernimmt bei mir der [Linter](https://github.com/platers/obsidian-linter?ref=t01.li). Seine YAML-Timestamp-Regel schreibt `created` beim ersten Speichern und `updated` bei jedem weiteren – automatisch, im Hintergrund, ohne dass ich daran denken muss.
Zu den Feldern selbst, kurz:
- `type` trennt Notiz, Ressource, kurze Notiz und so weiter.
- `domain` ordnet dem Lebens- oder Arbeitsbereich zu.
- `status` bildet den Reifegrad ab, von `seedling` (frisch rein) über `in progress` bis `completed` oder `evergreen`.
- `ai` „steuert“ über ein Rechtesystem, was *Claude Code* und das *Gemini CLI* mit dem Dokument anstellen dürfen. Dazu kommt in Teil 4 alles Weitere.
Klingt nach Overhead. Ist es in den ersten zwei Tagen auch. Danach tippt man den Header nicht mehr, man füllt ihn – und der Gewinn kommt im nächsten Schritt.
## Metadata Menu: Frontmatter ohne YAML-Friemeln
Felder von Hand zu tippen ist fehleranfällig. Schreibt man einmal `in progres` statt `in progress`, fällt die Notiz aus jeder Abfrage, die auf den korrekten Wert filtert – und man sucht den Fehler erst, wenn das Dashboard lügt. Genau dafür gibt es [Metadata Menu](https://github.com/mdelobelle/metadatamenu?ref=t01.li).
Das Plugin definiert Felder mit festem Typ und festen Werten. Mein `status` ist ein Select-Feld mit genau den vier erlaubten Werten. Beim Bearbeiten klicke ich den Wert aus einem Dropdown, statt ihn zu tippen. Alternativ gibt es auch eine Autovervollständigung im Obisdian-Editor. `domain` genauso. Tippfehler im Frontmatter sind damit konstruktionsbedingt unmöglich.
Der zentrale Begriff dabei heißt `fileClass`. Eine fileClass ist eine Notiz, die ein Set von Feldern und deren Regeln beschreibt – und über Ordnerpfad, Tag oder eine eigene Abfrage automatisch auf Notizen angewendet wird. Eine fileClass für meine Blog-Beiträge legt fest, dass `status`, `domain` und `tags` vorhanden sein müssen und welche Werte sie annehmen dürfen. Die Felder lassen sich dann per Rechtsklick bearbeiten, ohne die Datei überhaupt zu öffnen.
Ein ehrliches Wort dazu: Der Entwickler von *Metadata Menu* hat öffentlich gemacht, dass er kaum noch Zeit für das Plugin hat und Mitstreiter sucht. Es läuft stabil und kann mehr als alles, was ich sonst gesehen habe – aber wer 2026 neu anfängt, sollte wissen, dass *Obsidian* mit den nativen Properties (seit Version 1.4) einen Teil der Basisarbeit inzwischen selbst erledigt. Für reines Dropdown-Komfort-YAML braucht man das Plugin nicht zwingend. Für typisierte Felder mit Validierung und fileClass-Logik schon.
## Dataview: der Vault wird abfragbar
Bis hierhin habe ich nur sauber befülltes Frontmatter. Der Hebel, der daraus eine Datenbank macht, ist [Dataview](https://blacksmithgu.github.io/obsidian-dataview/?ref=t01.li). Das Plugin liest die Frontmatter-Felder aller Notizen ein und macht sie über eine Abfragesprache zugänglich – DQL, eine Art SQL für den Vault.
Ein einfaches Beispiel. Diese Abfrage listet alle Notizen aus der Inbox, die zur Domain `Business` gehören, sortiert nach letzter Änderung:
```DQL
```dataview
TABLE status, updated
FROM "0 Inbox"
WHERE domain = "Business"
SORT updated DESC
```
```
Das Ergebnis ist eine Tabelle, die sich live aktualisiert, sobald sich eine Notiz ändert. Für die meisten Übersichten reicht DQL aus.
Wird es komplexer – Gruppierungen, Schleifen, Bedingungen über mehrere Felder – wechsle ich zu DataviewJS. Statt der Abfragesprache schreibt man dann JavaScript gegen die Dataview-API. Ein Ausschnitt, der alle Notizen findet, denen Domain oder Typ fehlen:
```javascript
```dataviewjs
const inbox = dv.pages('"0 Inbox"').where(p => p.type != "MOC");
const triage = inbox
.where(p => !p.domain || !p.type)
.sort(p => p.created, 'desc');
dv.table(["Notiz", "Status", "Erstellt"],
triage.map(p => [p.file.link, p.status || "🌱 seedling", p.created || "—"]));
```
```
Das ist der Kern dessen, was mein Inbox-Dashboard tut – nur dass dort mehrere solcher Blöcke zusammenspielen.
## Das Inbox-Dashboard, Stück für Stück
Mein Dashboard ist eine einzige Notiz mit mehreren DataviewJS-Blöcken. Jeder beantwortet eine Frage, die ich mir sonst manuell stellen müsste. Der Reihe nach:
**Triage.** Welche Notizen haben noch keine Domain oder keinen Typ? Das ist der Block von oben. Solange dort etwas steht, ist die Inbox nicht abgearbeitet.
**Inbox Zero.** Was liegt länger als 30 Tage in der Inbox herum? Diese Liste ist mein schlechtes Gewissen in Tabellenform. Alles, was hier auftaucht, gehört einsortiert oder gelöscht.
**Bereichs-Übersicht.** Pro Domain eine eigene Tabelle. Hier konfiguriere ich die Domains zentral an einer Stelle:
```javascript
```dataviewjs
const domains = ["Web-Dev", "Business", "Blog", "Private"];
```
```
**MOC-Übersicht.** Eine Liste aller Maps of Content im Vault. MOCs sind Index-Notizen, die zusammengehörige Themen bündeln – das navigierbare Inhaltsverzeichnis, das mit dem Vault mitwächst.
**Struktur-Check.** Welche Notizen sind verwaist, hängen also an keiner einzigen anderen Notiz? Verwaiste Notizen sind kein Drama, aber ein Hinweis: Entweder fehlt eine Verknüpfung, oder die Notiz gehört ins Archiv.
Dazu kommt ein zweiter Block mit der Vault-Statistik – Dateien und Wörter pro Ordner, mit kleinen Fortschrittsbalken. Reine Spielerei, zugegeben. Aber sie zeigt auf einen Blick, wo sich das Material sammelt.
Das komplette Dashboard hängt unten als Download, zusammen mit dem Standard-Template – beides kostenlos. Es ist kommentiert, du kannst die Domains und Ordnernamen an dein eigenes Setup anpassen und die Blöcke einzeln übernehmen, die dir etwas bringen.
### Dataview, Datacore oder Bases?
Eine Frage drängt sich 2026 auf, und ich will sie nicht unter den Tisch fallen lassen. *Dataview* ist das meistgenutzte Plugin seiner Art, aber die Entwicklung steht weitgehend still. Der designierte Nachfolger heißt [Datacore](https://github.com/blacksmithgu/datacore?ref=t01.li), kommt vom selben Entwickler, ist deutlich schneller und erlaubt editierbare Tabellen – steckt aber noch in der Beta und lässt sich nur über Umwege installieren.
Parallel hat *Obsidian* mit [Bases](https://obsidian.md/changelog?ref=t01.li) ein natives Core-Plugin bekommen, das Tabellen-, Listen- und Kartenansichten direkt aus den Properties baut. Kein Plugin, keine Abfragesprache, einfach an Bord. Für viele Standard-Dashboards ist das heute der naheliegende Weg.
### Warum ich trotzdem vorerst bei *Dataview* bleibe
Mein Dashboard läuft, es nutzt DataviewJS-Logik, die sich in *Bases* aktuell nicht eins zu eins abbilden lässt, und ein Migrationsprojekt ohne konkreten Schmerz ist verschwendete Zeit. Wer aber heute neu aufsetzt und vor allem filterbare Übersichten will, sollte sich zuerst *Bases* anschauen, bevor er/sie eine Abfragesprache lernt. *Bases* verdient einen eigenen Artikel, den hebe ich mir auf.
### Was als Nächstes kommt
Damit steht das Fundament: strukturierte Ordner, sauberes Frontmatter, abfragbare Dashboards. Im nächsten Teil geht es darum, wie das „Material“ automatisch ins Vault kommt – über [n8n](https://n8n.io/?ref=t01.li)\-Workflows, die Sprachnachrichten transkribieren, URLs und YouTube-Videos zusammenfassen und alles als fertiges Markdown mit korrektem Frontmatter ablegen.
Im vierten Teil verbinde ich den Vault über MCP mit *Claude Code* und dem *Gemini CLI* und lasse das frisch gebündelte Obsidian-CLI mitspielen. Dann wird das `ai`\-Feld aus dem Frontmatter endlich zu dem, wofür es da ist.
[Obsidian Notiz-TemplateStandard Template für Obsidian mit YAML Frontmatter.frontmatter-template.zip964 Bytesdownload-circle](https://t01.li/content/files/2026/06/frontmatter-template.zip "Download")
[Dataview DashboardMein Inbox Dashboard für die Schnellübersich über die Inbox und den Vault.dataview-dashboard.zip4 KBdownload-circle](https://t01.li/content/files/2026/06/dataview-dashboard.zip "Download")
### Beiträge der Serie:
- [Obsidian – mein digitales Gehirn, und warum ich nie wieder zurück möchte](https://t01.li/kein-ki/obsidian-mein-digitales-gehirn-und-warum-ich-nie-wieder-zurueck-moechte/)
- [Obsidian-Inbox automatisieren: n8n, Telegram und KI](https://t01.li/kein-ki/obsidian-inbox-automatisieren-n8n/)
- [Obsidian und MCP: Claude Code, Codex und Antigravity Zugriff auf den Vault geben](https://t01.li/kein-ki/obsidian-mcp-claude-code-codex-antigravity/)
### GLM‑5.2: eine Million Token Kontext, Open Weights und ein Benchmark-Blatt mit Sternchen
URL: https://t01.li/ki-news/glm-5-2-open-weights-1m-kontext/
Last updated: 2026-06-17T20:58:39.000Z
Z.ai hat am 13\. Juni *GLM‑5.2* veröffentlicht und das Modell sofort über alle Stufen des *GLM Coding Plan* scharfgeschaltet. Flaggschiff, Coding-Fokus, ein Kontextfenster von einer Million Token. Wenige Tage später lagen die Gewichte unter MIT-Lizenz auf Hugging Face – damit liegt vor, was Z.ai versprochen hatte: ein offenes, Frontier-nahes Modell zum Selberhosten.
Im [KW24-Pick](https://t01.li/ai-shorts/ai-picks-der-24-kw/#glm-52) hatte ich das nur kurz angetippt, weil außer einer Ankündigung wenig Handfestes da war. Jetzt gibt es die Modelcard, ein paar Zahlen und die Weights. Zeit für den genaueren Blick.
## TL;DR
Z.ai hat GLM‑5.2 veröffentlicht – das neue Flaggschiff der GLM-5-Serie mit Coding-Fokus.
- Mixture-of-Experts, rund 750 Milliarden Parameter, davon \~40 Milliarden pro Token aktiv
- Kontextfenster von 1M Token (vorher 200K), Open Weights unter MIT-Lizenz auf Hugging Face
- Coding-Benchmarks stark – aber durchweg herstellereigen, unabhängige Zahlen fehlen noch
- Lokal lauffähig nur mit ernsthafter Hardware: ein 8-GPU-Knoten aufwärts, eine einzelne H100 reicht nicht
- Sofort nutzbar über den GLM Coding Plan und gängige Coding Agents
## Ein 750-Milliarden-Brocken mit Spar-Tricks
Unter der Haube steckt ein Mixture-of-Experts-Modell. Die Gesamtgröße geben die Quellen uneinheitlich an – [*VentureBeat* nennt 753 Milliarden Parameter](https://venturebeat.com/technology/z-ais-open-weights-glm-5-2-beats-gpt-5-5-on-multiple-long-horizon-coding-benchmarks-for-1-6th-the-cost?ref=t01.li), die [Modelcard](https://huggingface.co/zai-org/GLM-5.2?ref=t01.li) und der vLLM-Recipe landen bei rund 744 Milliarden. Aktiv sind pro Token nur etwa 40 Milliarden, der Rest schläft. Für die Praxis bedeutet das zweierlei – groß genug, um Hardware zu sprengen, und sparsam genug, um überhaupt zu laufen.
Der eigentliche Sprung gegenüber *GLM‑5.1* ist das Kontextfenster. Eine Million Token, vorher waren es 200.000\. Z.ai verkauft das nicht als reine Zahl, sondern als „solid 1M“ – also nutzbar über die volle Länge, nicht nur auf dem Papier. Ob das im Dauerbetrieb hält, zeigt sich erst in den nächsten Wochen.
Dazu kommen zwei Effizienz-Kniffe. *IndexShare* recycelt denselben Attention-Index über je vier Layer und senkt die Rechenlast pro Token bei vollem Kontext nach Herstellerangabe um das 2,9-Fache. Und die Multi-Token-Prediction wurde von drei auf fünf Draft-Tokens erweitert, was das Decoding beschleunigt. Klingt nach Kleinkram, summiert sich bei einer Million Token aber zu echten Kosten.
### Die Benchmarks – herstellereigen, wie (fast) immer
Die Zahlen, die Z.ai mitliefert, lesen sich stark. Auf Terminal-Bench 2.1 springt *GLM‑5.2* von 62,0 (GLM‑5.1) auf 81,0 und liegt damit in Sichtweite von *Opus 4.8* mit 85,0\. Auf SWE-bench Pro geht es von 58,4 auf 62,1 hoch. Bei FrontierSWE meldet der Hersteller 74,4 Prozent, knapp hinter *Opus 4.8* (75,1) und vor *GPT‑5.5* (72,6). Auf MCP-Atlas dann 77,0 gegen 75,3 für *GPT‑5.5*.
Hübsche Tabelle. Nur sind das wie so häufig auch hier herstellereigene Werte, keine unabhängige Drittmessung. Wer die Zahlen als Marketing liest und nicht als Naturkonstante, liegt auch hier wieder richtig. Unabhängige Benchmarks von dritter Seite gibt es noch nicht. Bis die da sind, gilt für jede dieser Zeilen das Hersteller-Sternchen.
### Open Weights heißt nicht „läuft auf deinem Rechner“
Die MIT-Lizenz ist das eigentlich Bemerkenswerte. Keine regionalen Sperren, kein Kleingedrucktes – herunterladen, fine-tunen, lokal betreiben, fertig. Auf dem Papier.
In der Realität wiegt das Modell rund 1,5 Terabyte. Der FP8-Checkpoint passt laut [vLLM-Recipe](https://recipes.vllm.ai/zai-org/GLM-5.2?ref=t01.li) erst auf einen kompletten Knoten aus acht H200- oder H20-GPUs. Das volle 1M-Fenster willst du auf acht B200 fahren. Eine einzelne H100 reicht da nicht – auch nicht, wenn du sie ganz lieb anschaust und ihr gut zuredest. „Lokal lauffähig“ und „läuft auf deinem Server“ sind hier zwei verschiedene Sätze.
Und „Open Weights“ heißt nicht automatisch, dass die Gewichte am Tag der Ankündigung auch wirklich liegen. Bei *GLM‑5.2* hat es ein paar Tage gedauert, dann waren sie da. Es geht auch anders – siehe [*MiniMax M3*](https://t01.li/ki-news/minimax-m3-open-weight-ohne-weights/), wo das „Open“ eine Weile ohne die „Weights“ auskommen musste.
## Zugang, Preise, Coding Agents
Wer es ausprobieren will, braucht den Download nicht. *GLM‑5.2* ist sofort über den *GLM Coding Plan* nutzbar, auf allen Stufen von Lite bis Team, ab rund 12,60 US-Dollar im Monat. Die API-Preise bleiben laut Z.ai auf dem Niveau von *GLM‑5.1*.
Out of the Box arbeitet das Modell mit den üblichen Coding Agents zusammen – *Claude Code*, *Cline*, *Roo Code*, *OpenCode*, *Crush* und weiteren. Fährst du einen davon ohnehin, ist der Wechsel ein Config-Eintrag, kein Umbau. API-Zugang und Chatbot kamen kurz nach dem Launch dazu.
### Warum ich jeden produktiven Prompt versioniere – und wie
URL: https://t01.li/ki-systemdesign/prompt-versionierung-mit-git-und-github/
Last updated: 2026-06-16T04:54:04.000Z
Alles, was ich auch nur ansatzweise produktiv nutze und Gefahr läuft, wiederverwendet zu werden – oder schlimmer, in einer Agenten-Pipeline oder einem Systemprompt landet –, wird bei mir versioniert. Volles Programm. Prompt-Versionierung über Git ist dabei keine Ordnungsliebe, sondern die billigste Versicherung, die ich kenne.
## TL;DR
Produktive Prompts gehören in ein Git-Repository – wie Code, nur ohne dessen Konventionen.
- Jeder Prompt bekommt SemVer, einen manuellen Changelog und eine externe Doku
- Kommentare und Erklärungen haben im Prompt selbst nichts verloren
- Regressionstests laufen gegen ein realitätsnahes Testset – so groß wie nötig, so klein wie bezahlbar
- Erst bei agentischen Systemen oder Orchestrierung lohnt mehr als Git
## Was die Versionierung konkret rettet
Der Klassiker: Ein Prompt läuft seit Wochen stabil, dann „optimiert“ man eine Formulierung – und zwei Tage später liefert die Pipeline Müll. Ohne Versionierung beginnt jetzt das Raten. Mit Versionierung tippe ich `git diff` und sehe auf den Zeichen genau, was sich zwischen v2.3.0 und v2.4.0 geändert hat. Welcher der Commits das Verhalten gekippt hat, muss ich dann zwar noch eingrenzen – aber ich suche in Minuten statt in Stunden. Voraussetzung ist Disziplin beim Committen – eine Änderung, ein Commit. Verschlimmbessern ist keine Schande. Es nicht zurückverfolgen zu können schon.
Das gilt umso mehr für umfangreiche Prompts mit strengen Ausgabeprotokollen, etwa einem strikten JSON-Format. Wenn ein nachgelagertes System das JSON parst, ist jede Formatänderung ein potenzieller Breaking Change – und genau deshalb will ich nachvollziehen können, wann welches Feld dazukam, umbenannt wurde oder geflogen ist.
Wie mächtig schon die Git-Bordmittel auf reinen Prompttexten sind, hat [Simon Willison im April demonstriert](https://simonwillison.net/2026/Apr/18/extract-system-prompts/?ref=t01.li): Er hat Anthropics offiziell veröffentlichte System-Prompts für Claude in ein Repo mit datierten Commits zerlegt – eine Datei pro Modell. Die Evolution eines der meistgenutzten Systemprompts der Welt lässt sich seitdem mit `git log` und `git diff` durchblättern wie eine Commit-History. Kein Spezialtool, kein Dashboard. Nur Git.
## Der Stack: Prompt, Doku, Changelog – strikt getrennt
Zu einem brauchbaren Prompt-Stack gehören für mich drei Dinge, und zwar als getrennte Dateien: der Prompt selbst, eine kurze Dokumentation und ein Changelog. Im Prompt steht ausschließlich, was das Modell für die Aufgabe braucht – plus die Versionsnummer im Frontmatter, mehr Meta-Information bekommt er nicht. Die Versionsnummer ist die eine Ausnahme von meiner Nichts-Extra-Regel – aus gutem Grund. Sobald ein Prompt per Copy-Paste in einer UI oder Pipeline landet, ist er vom Repo getrennt. Das Frontmatter ist dann die einzige Verbindung zurück zur richtigen Doku und zum richtigen Stand. Die Doku beantwortet das Was, Wie, Wann und Warum in einem eigenen Hilfedokument. Der Changelog hält jede Änderung fest.
Gerade der manuelle Changelog klingt erstmal nach Redundanz – Git protokolliert doch ohnehin alles. Stimmt, aber `git log` ist eine Rohdatenliste, kein kuratiertes Dokument. Der gepflegte `CHANGELOG.md` liegt direkt im Repo, ist ohne Terminal oder GitHub-Oberfläche lesbar und erklärt Änderungen so, dass ich oder auch jemand anderes sie auch in sechs Monaten noch versteht. Der Preis dafür ist Disziplin: Jede Änderung muss wirklich ins Log. Wer da schludert, kann sich notfalls mit einem Diff und einem willigen kleinen LLM einen Automatismus bauen – funktioniert erstaunlich gut.
Wichtig ist die Reihenfolge der Pflege. Nach jeder Prompt-Änderung werden Doku und Changelog aktualisiert, dann wird committet. Klingt pedantisch, dauert zwei Minuten und ist der Unterschied zwischen einem Archiv und einem Müllhaufen mit Timestamps.
## Keine Kommentare im Prompt
In der klassischen Softwareentwicklung gehören Erklärungen in den Code – Kommentare, Docstrings, Inline-Doku. Prompt-Engineering ist aber nicht Code-Schreiben, auch wenn das gerne behauptet wird. Ein Kommentar im Code ist für den Compiler unsichtbar. Ein Kommentar im Prompt ist für das Modell Kontext, und zwar potenziell missverständlicher. Jede Zeile, die nicht der Aufgabe dient, ist Ablenkung, mögliche Fehldeutung und [verbranntes Token-Budget](https://t01.li/ai-dev/token-effizienz-in-claude-code-was-hilft/).
Deshalb fliegt alles Erklärende raus in die externe Doku. Das ist dieselbe Logik, die ich auch bei [CLAUDE.md-Dateien fahre](https://t01.li/ai-dev/claude-md-best-practice-2026/): so kurz und eindeutig wie möglich, nur Ziele, Constraints und Voraussetzungen. Der Prompt arbeitet, die Doku erklärt.
## SemVer für Prompts – ein Beispiel aus der Praxis
Versionsnummern vergebe ich nach Semantic Versioning. Ein Patch ist ein Formulierungs-Fix ohne Verhaltensänderung, ein Minor eine neue Fähigkeit oder ein neuer Befehl, ein Major ein Bruch – im Verhalten oder im Ausgabeformat. Das ist keine Wissenschaft, aber es zwingt mich bei jeder Änderung zu der Frage, was sie für die Nutzer des Prompts bedeutet.
Ein wichtiger Erfahrungsstrang meinerseits ist ein umfangreiches Promptsystem für Zielgruppenanalysen, das ich seit Längerem betreue (Details bleiben aus NDA-Gründen anonym). Das System war als Monolith gewachsen: ein Prompt für alles, B2B-Vertriebslogik und Consumer-Psychografie in einem Dokument. In der Praxis führte das zu Kontextverwechslungen – Lifestyle-Frameworks tauchten plötzlich in CFO-Profilen auf. Die Lösung war ein Major-Sprung: Aufteilung in zwei getrennte Systeme, eines für B2B, eines für B2C, mit gemeinsamer Basistechnik. Genau so ein Schnitt ist ohne sauberen Changelog und versionierte Stände kaum seriös machbar. Die alte monolithische Version bleibt als Legacy im Repo liegen und ist weiter lauffähig – wer sie braucht, findet sie samt Doku.
Im Alltag reicht mir bei einzelnen Prompts ein simpler Workflow mit Commits auf dem Hauptzweig. Releases und Tags kommen erst ins Spiel, wenn es umfangreicher wird, etwa bei Agentensystemen mit mehreren zusammenspielenden Prompts. Wem Git über das Terminal zu sperrig ist: [GitHub Desktop](https://github.com/apps/desktop?ref=t01.li) leistet gute Dienste und die Oberfläche ist intuitiv. Alternativ tut es die IDE deiner Wahl – in meinem Fall *Visual Studio Code*, wobei ich mit dessen eingebauter Git-Funktion nie so richtig warm geworden bin, obwohl es vermutlich komfortabler wäre. Ein Nachmittag mit ein wenig Kaffee und genügend Motivation ändert dies vielleicht demnächst.
## Regressionstests – die harte Realität
Die Best-Practice-Literatur koppelt Prompt-Versionierung inzwischen fest an Evaluations: Jede neue Version läuft gegen ein Testset, idealerweise automatisiert als Gate im Pull Request. Das ist richtig und Regressionstests sind auch bei mir Bestandteil des Workflows. Nur: So umfangreich, wie man es gerne hätte, ist das aus Kosten- und Zeitgründen selten durchführbar. Jeder Eval-Lauf kostet Tokens, und ein Testset zu pflegen kostet Zeit, die niemand bezahlt.
Mein Pragmatismus dazu: ein bewusst kleines Testset, das so nah wie möglich an die späteren Realdaten herankommt. Lieber fünfzehn realistische Fälle, die echte Grenzfälle abdecken, als zweihundert synthetische, die sich gegenseitig wiederholen. Das fängt nicht jede Regression. Es fängt die teuren.
## Ab wann Git nicht mehr reicht
Für einzelne Prompts und kleine Systeme ist Git die Antwort, Punkt. Anders sieht es aus, sobald agentische Systeme ins Spiel kommen, ich Orchestrierung betreibe oder Prompt und Code eng verzahnt laufen. Dann will ich Prompt-Versionen mit Traces aus dem Produktivbetrieb verknüpfen können, und dafür sind dedizierte Werkzeuge gebaut. [*Langfuse*](https://langfuse.com/docs/prompt-management/overview?ref=t01.li) etwa versioniert Prompts über IDs und Labels, erlaubt Rollbacks per Label-Umzug und ist Open Source sowie self-hostbar – für alle, die ihre Prompts und Traces nicht in eine US-Cloud kippen wollen, kein Nebenaspekt.
Falls ohnehin das komplette Projekt in einem Repository landet, muss ich das Prompt-System übrigens gar nicht ausgliedern und schlage zwei Fliegen mit einer Klappe: Code und Prompts teilen sich History, Issues und Review-Prozess. Der Preis: Die Prompt-History versinkt zwischen Code-Commits, und das SemVer des Prompts läuft getrennt von den Releases der Anwendung – das muss man aushalten oder per Ordner-Konvention sauber halten.
Heißt für mich: Ein Prompt, der produktiv läuft und nicht versioniert ist, ist kein Werkzeug, sondern ein Risiko mit guter Tagesform. Git kostet nichts, die Disziplin ein wenig – und der erste ernsthafte Rollback zahlt beides zurück.
### AI Picks der 24. KW
URL: https://t01.li/ai-shorts/ai-picks-der-24-kw/
Last updated: 2026-06-15T08:03:46.000Z
Die Picks diese Woche mit etwas Verspätung, denn ich war eine Woche kreuzfahrttechnisch in Norwegen und Dänemark unterwegs. Die Abende habe ich auf dem Balkon verbracht, aufs Meer geschaut und meine RSS-Feeds und x.com auf dem iPad durchgescrollt. Und heilige Axt: war das wieder eine ergiebige Woche – eigentlich so gar nicht urlaubskompatibel. Im Detail ansehen oder testen konnte ich entsprechend nichts, da Urlaub. Das hier ist also eher eine Bookmark-Liste. Das teure On-Board-Satelliten-Internet über WiFi ist übrigens erstaunlich stabil und für FLAC-Streaming über *Tidal* ausreichend performant. Für 70 Euro die Woche will ich ihm das aber auch geraten haben.
Also, stürzen wir uns rein.
## Das Fable-Drama
Anthropic hat *Fable 5* öffentlich zugänglich gemacht. Kurz. [Für etwa drei Tage](https://www.anthropic.com/news/claude-fable-5-mythos-5?ref=t01.li).
An dem Tag durfte man seinen LinkedIn-Feed lieber nicht öffnen. Die üblichen ehemals Krypto-Guru-jetzt-KI-Transformationsexperten haben ihre Timeline mit „Game Changer“-Meldungen vollgespammt, nachdem sie ihre fünf Prompts und zwei Skills zum Testen in den Chat getippt und den Knopf für Fable gefunden hatten.
Dann kam die US-Regierung. Per Exportdirektive verlangte sie von Anthropic, Nicht-US-Bürgern den Zugang zu verwehren – [inklusive der eigenen ausländischen Mitarbeiter](https://www.heise.de/news/US-Regierung-erzwingt-Abschaltung-von-Anthropics-KI-Fable-5-und-Mythos-5-11331129.html?ref=t01.li). Anthropic daraufhin sinngemäß: Das lässt sich technisch nicht sauber trennen, also machen wir es erstmal für alle dicht. Anthropic [widerspricht öffentlich](https://www.anthropic.com/news/fable-mythos-access?ref=t01.li), dass ein eng begrenzter Jailbreak den Rückruf eines Modells rechtfertigt, das an hunderte Millionen Nutzer ausgerollt war. Bemerkenswert: Es ist das erste Mal, dass ein führendes Labor ein öffentlich deploytes Modell auf staatliche Anweisung hin offline nimmt.
Und [Heise kommt mit dem Hintergrund um die Ecke](https://www.heise.de/news/Berichte-Amazon-steckt-hinter-ploetzlichem-Fable-Aus-11331565.html?ref=t01.li): Amazon hatte *Fable* von der eigenen Cybersecurity-Abteilung auditieren lassen, dabei kamen Jailbreak-Möglichkeiten ans Tageslicht, und Amazon-CEO Andrew Jassy hat das nach oben durchgereicht. Wer kennt sie nicht, die Security-Spezial-Experten von AWS. Fairerweise: [Laut Axios](https://www.axios.com/2026/06/13/anthropic-amazon-white-house?ref=t01.li) war Amazon nicht allein, mindestens fünf weitere Firmen haben am selben Abend bei der Regierung angerufen. Und Amazon bestreitet, die Petze zu sein („nicht ungewöhnlich, dass Regierungen uns zu Sicherheitsrisiken konsultieren"). Aha.
Hotter Take: Das eigentlich Interessante ist nicht der Jailbreak, sondern der Präzedenzfall. Wenn ein einzelner gemeldeter Bypass reicht, um ein kommerzielles Frontier-Modell weltweit abzuschalten, lässt sich nach der Logik jedes Modell abschalten.
## GLM 5.2
###
Eher Randnotiz, aber es gibt nicht wenige Leute, die auf die Modelle von Z.ai schwören. Bei der Menge an Alternativen habe ich mich mit denen noch gar nicht beschäftigt. [Wird wohl langsam Zeit](https://www.digitalapplied.com/blog/glm-5-2-zai-flagship-coding-plan-release?ref=t01.li).
Auf dem Papier: 1M-Kontextfenster, 744B Mixture-of-Experts (40B aktiv, von *GLM-5* geerbt), MIT-Lizenz. Klingt nach dem nächsten dicken Open-Weights-Drop. Ist aber, Stand jetzt, keiner. *GLM 5.2* läuft bislang nur über den GLM Coding Plan. [API, Chatbot und die MIT-Gewichte sind für „nächste Woche“ angekündigt](https://www.tonyreviewsthings.com/glm-5-2-released-1m-context-mit-weights/?ref=t01.li) – verfügbar sind sie nicht. Benchmarks zum Launch? Fehlanzeige. Bleiben die Marketing-Adjektive „powerful coding“ und „strong long-horizon“, die ich ohne Zahlen schlecht mit einem Hersteller-Sternchen versehen kann, weil es nicht mal eine Zahl zum Versternen gibt.
Kommt mir bekannt vor. Genau das Muster hatte ich beim MiMo-äh, [MiniMax-M3-Beitrag](https://t01.li/ki-news/minimax-m3-open-weight-ohne-weights/) schon: Open Weights als Schlagzeile, Weights aber nirgends. Open-Weight without Weights, die zweite.
## Cohere North Mini Code
Jetzt wird's spannender: MoE mit 30 Milliarden Parametern, davon 3 Mrd. aktiv, [Apache-2.0-Lizenz](https://huggingface.co/blog/CohereLabs/introducing-north-mini-code?ref=t01.li). Und es gibt eine 8-Bit-Quantisierung. Heißt: auf halbwegs potenter GPU mit genug VRAM – wir reden über Consumer-Hardware – kann man damit lokal arbeiten.
Das ist die Größenordnung, die mich an offenen Modellen interessiert. Nicht das 744B-Monster, das ohne Rechenzentrum nirgends läuft, sondern das Ding, das auf die bessere Büro-Kiste passt.
## Apodex-1.0
Steht bei mir sehr weit oben auf der „Muss ich mir näher ansehen“-Liste. [*Apodex-1.0*](https://www.apodex.com/blog/apodex-1.0?ref=t01.li) ist ein Deep-Research-Agent mit Verification-first-Ansatz: Statt ein Modell die ganze kognitive Last tragen zu lassen, verteilt ein Orchestrator auf spezialisierte Sub-Agents, und ein Verifier prüft die zusammengetragene Evidenz, bevor überhaupt eine Antwort entsteht. Im Heavy-Mode [koordiniert das bis zu 150 Sub-Agents über 15.000 Schritte](https://huggingface.co/apodex/Apodex-1.0-mini?ref=t01.li) in einer einzigen Aufgabe.
Die Open-Weight-Checkpoints liegen auf Qwen3.5-Basis von 0.8B bis 35B-A3B in der [HuggingFace-Collection](https://huggingface.co/collections/apodex/apodex-1?ref=t01.li). Der Name kommt aus dem Griechischen, *apodeixis*, „Beweis“. Charmant. Bewertet wird's später.
## Kimi Code
Da ist es, und ich hatte es [in den Picks der 22\. Kalenderwoche prophezeit](https://t01.li/ai-shorts/ai-picks-der-22-kw/#deepseek-v4-pro-discount-ist-jetzt-permanent): ein Coding-Modell plus CLI, weil CLIs gerade in Mode sind. Entgegen meiner Vorhersage ist es *Kimi K2.7-Code* geworden, nicht 2.65\. Geschenkt. Den Kampfpreis haben Sie zu meiner Überraschung weggelassen.
Der Hebel:
> Kimi Code is a code development benefit in the membership plan. Upgrade to a Kimi member to start using it.
[Weißt du Bescheid](https://www.kimi.com/code?ref=t01.li). Die Gewichte selbst sind übrigens offen (Modified MIT auf HuggingFace) und das Modell gibt's auch über die API, nur die CLI hängt am Abo, ab 19 Dollar im Monat. Das ist exakt das Modell-plus-Plan-Spiel, das Anthropic mit Claude Code fährt.
## Xiaomi MiMo-V2.5-Pro-UltraSpeed
Dafür wurde mir freundlicherweise ein Trial-Zugang bereitgestellt, ich bin nur noch nicht dazu gekommen, das auch mal auszuprobieren. Die Anmeldung ist offen, allerdings fenstergebunden: [Bewerbung läuft bis 23\. Juni (PDT)](https://mimo.xiaomi.com/blog/mimo-tilert-1000tps?ref=t01.li), mit Tageslimits und Session-Caps. Zugriff API-only, Web-Chat zeitweise gratis.
Die Formel ist kurz:
> 3× the price, 10× the output experience
Technisch dahinter steht eine Co-Optimierung von Xiaomi und dem TileRT-Team: 1.000 Tokens pro Sekunde auf einem 1T-MoE, und zwar über einen einzelnen Standard-8-GPU-Knoten. Nicht Cerebras, nicht Groq, sondern General-Purpose-Hardware. Wenn die Zahl hält, ist das ein starkes Pro-Argument.
## Google Colab CLI
Wer seine Stacks auf dem Google-Enterprise-Kram fährt – und es guten Gewissens darf –, für den ist das [hier ganz schick](https://developers.googleblog.com/introducing-the-google-colab-cli/?ref=t01.li). Aus dem Terminal heraus provisionierst du in Sekunden eine GPU oder TPU, vom T4 bis zur H100, schickst dein lokales Python-Skript per `colab exec` auf die entfernte Colab-Runtime und holst dir das Ergebnis zurück. Kein Browser, kein manuelles Cloud-Geklicke. Open Source unter Apache 2.0, Installation in einem Befehl, und Codex und Claude Code spielen mit, nicht nur Antigravity.
Der eigentliche Clou steckt nicht in der Bequemlichkeit für Menschen. Google liefert ein `COLAB_SKILL.md` mit, also eine fertige Anleitung, die einem Agenten beibringt, das Tool selbst zu bedienen. Das ist die Ansage: Ein Agent kann sich künftig eigenständig eine H100 schnappen, ein Fine-Tuning durchlaufen lassen und die Maschine danach wieder abschalten, ohne dass ein Mensch dazwischenfunkt. Weniger Feature, mehr Baustein für den „agentic fullstack“, in dem Agents sich ihre Rechenleistung selbst besorgen.
Kleiner Take: schick, solange der Agent das `colab stop` nicht vergisst. Und solange du im Kopf behältst, dass die „sofort verfügbare H100“ an deinem aktiven Colab-Plan und dessen Kontingent hängt, nicht an Zauberei.
## Omnigent
[Databricks open-sourct *Omnigent*](https://www.databricks.com/blog/introducing-omnigent-meta-harness-combine-control-and-share-your-agents?ref=t01.li) unter Apache 2.0, eine sogenannte Meta-Harness. Die Idee: eine Schicht über den Harnesses, die du eh schon nutzt – Claude Code, Codex, Pi, custom – mit gemeinsamer Composition, Policy-Control (Cost-Budgets, Approval-Gates, Sandboxing) und Live-Sessions, die sich per URL teilen lassen. Das Argument von Matei Zaharia und Team: Harnesses haben Modelle austauschbar gemacht, die Meta-Harness ist die nächste Abstraktionsebene.
Steile These dagegen: Das ist Abstraktion über der Abstraktion. Databricks löst hier ein Problem von Shops mit 5.000 Engineers und einem Dutzend paralleler Agents. Ob eine Agentur oder ein Mittelständler mit seinen vier offenen CLIs wirklich noch eine Schicht obendrauf braucht, oder ob das nur eine weitere Sache ist, die man pflegen, verstehen und absichern muss, lasse ich mal offen. Pikanter Nebeneffekt: Databricks hatte gerade erst *Fable 5* über die Unity AI Gateway eingebunden. Das hat sich dann ja erledigt.
## Context Compression, 16x mit Sternchen
[Ein Paper](https://venturebeat.com/data/context-compression-finally-works-in-production-new-research-cuts-llm-input-16x-without-the-accuracy-hit?ref=t01.li) von NYU, Columbia, Princeton, Maryland, Harvard und Lawrence Livermore stellt „Latent Context Language Models“ vor, Encoder-Decoder-Modelle, die den Kontext komprimieren, bevor er den Decoder erreicht. Open-source auf HuggingFace. Die Schlagzeile verspricht 16-fache Kompression ohne Accuracy-Hit.
Hier lohnt der Blick in die Tabelle. Bei 4x-Kompression fällt die RULER-Accuracy von 94,41 auf 91,76 Prozent, das sind keine drei Punkte für ein Viertel der Tokens. Sauber. Bei 16x werden 93,75 Prozent der Tokens entsorgt, und die Accuracy sackt auf 75,06 Prozent. Das ist kein „ohne Accuracy-Hit“, das ist ein Einbruch um fast 20 Punkte. Der saubere Trade sitzt bei 4x. Die 16x stehen in der Headline, weil 16 größer klingt als 4\. Für alle, die das Thema grundsätzlich umtreibt, ist das ein Baustein mehr im [Context Engineering](https://t01.li/ki-systemdesign/context-engineering-prompt-engineering-baustein/).
## PP-OCRv6
Das Thema bleibt interessant, und ich bin offenbar nicht der Einzige, der das so sieht. [*PP-OCRv6*](https://huggingface.co/collections/PaddlePaddle/pp-ocrv6?ref=t01.li) ist explizit für den Pipeline-Einsatz gebaut, unterstützt 48 Sprachen und bringt einige Module mit. Falls du OCR in einen Automatisierungs-Workflow einbetten willst, gehört das eigentlich mit auf das Radar.
## DiffusionGemma
Das ist das Erste, was bei mir neu in *LM Studio* landet, wenn der Urlaub beendet ist: [*DiffusionGemma*](https://deepmind.google/models/gemma/diffusiongemma/?ref=t01.li), Google DeepMinds Versuch, Textgenerierung über Diffusion statt autoregressiv zu machen. Klassische Modelle schreiben Token für Token von links nach rechts. *DiffusionGemma* füllt stattdessen einen ganzen 256-Token-Block aus Rauschen und entrauscht ihn parallel, bis lesbarer Text rauskommt. Das bringt über 1.000 Tokens pro Sekunde auf einer einzelnen H100.
Spannend für meine Zwecke ist die Größe. 26B Mixture-of-Experts mit nur 3,8B aktiv, und in NVIDIAs NVFP4-Quantisierung passt das Ding in 18 GB VRAM, läuft also lokal auf einer 4090 oder 5090\. Open Weights, Apache 2.0, [die Gewichte liegen auf HuggingFace](https://huggingface.co/google/diffusiongemma-26B-A4B-it?ref=t01.li), Day-One-Support in vLLM und Transformers.
Das Sternchen liefert Google gleich selbst mit: Die Qualität liegt unter dem normalen *Gemma 4*, auf MMLU und bei Coding-Tests. Offiziell „experimentell“, gedacht für Speed-kritische Sachen wie Code-Infilling oder schnelles Inline-Editing, nicht als Allzweck-Assistent. Ganz hotter Take: Genau deshalb interessant. Für viele Pipeline-Schritte ist ein schnelles, lokales Modell mehr wert als ein brillantes, das langsam in der Cloud hängt.
## Open Knowledge Format
[Google Cloud](https://cloud.google.com/blog/products/data-analytics/how-the-open-knowledge-format-can-improve-data-sharing?ref=t01.li) definiert es gleich im zweiten Absatz selbst:
> … an open specification that formalizes the LLM-wiki pattern into a portable, interoperable format.
Heißt: das von Karpathy populär gemachte LLM-wiki-Muster in ein portables Format gegossen. Wenn sich das durchsetzt, könnte es für strukturiertes Wissensteilen zwischen Systemen relevant werden. Großes Wenn.
## Angular 22
Jetzt wird's zugegebenermaßen etwas nerdiger, aber die News ist trotzdem relevant. [Angular 22](https://www.heise.de/news/Angular-22-legt-neuen-Fokus-auf-KI-Coding-11322698.html?ref=t01.li) baut den mit Angular 21 eingeführten MCP-Server weiter aus, jetzt agentic-optimiert, und legt einen Dependency-Injection-Graph drauf, den explizit AI-Agents abfragen sollen. Der Fokus liegt diesmal klar auf KI-Coding.
## Ein Viertel des Budgets – verpufft
Das Ergebnis ist leider keine Überraschung: Laut einer [Erhebung](https://www.digitalbusiness-magazin.de/ki-anwendungen-ein-viertel-des-budget-verlieren-unternehmen-a-c20f0d34c594d0d8f1811d395fc8fa05/?ref=t01.li) verlieren Unternehmen im Schnitt ein Viertel ihres KI-Budgets an Komplexitäts-Overhead. Die Hürden sind struktureller Natur:
> Die größten Gründe dafür, dass Pilotprojekte nicht in den produktiven Einsatz übergehen, sind die Komplexität der Systemintegration (27 Prozent), der Mangel an qualifizierten Fachkräften (26 Prozent) sowie ein zu hoher Konfigurationsaufwand (26 Prozent).
Zwei Dinge zur Einordnung, die der deutsche Artikel verschluckt (und ja, ich habe den Freshworks-Report gelesen). Erstens: Die 25 Prozent sind der globale Mid-Market-Schnitt über sechs Länder, kein Deutschland-spezifischer Wert. „Deutsche Unternehmen verlieren ein Viertel“ ist die Lokalisierung der Redaktion, nicht die Studienaussage. Zweitens, das dickere Sternchen: Die Quelle ist ein Freshworks-Report, und Freshworks verkauft exakt die Konsolidierungsplattform, deren Fehlen die Studie als „Complexity Tax“ beklagt. Die Zahlen sind plausibel, das Narrativ ist die Verkaufsstory. Wer die Hürden kennt, nickt trotzdem.
## The 2026 state of AI agent pricing
[Orb](https://www.withorb.com/blog/2026-state-of-ai-agent-pricing-models-trends-and-whats-working?ref=t01.li) hat 80 AI-Agent-Firmen auf ihre Preismodelle abgeklopft. Das große Bild: Hybrid ist mit 95 Prozent praktisch Standard, Usage-based liegt bei 91,3 Prozent und ist zur ökonomischen Basis geworden, Per-Seat bröckelt langsam (37,5 Prozent, von 39,4).
Die für mich interessanteste Zahl ist eine andere. Outcome-based Pricing, das Modell, das alle als heiligen Gral der Agenten-Ökonomie verkaufen, bei dem man also für Ergebnisse statt für Tokens zahlt, liegt bei 3,8 Prozent. Runter von 4,5\. Der Traum vom „pay per result“ schrumpft, weil sich Outcomes sauber zu definieren, zu messen und zuzurechnen in der Praxis als ekelhaft schwer erweist. Die Theorie ist bestechend, die Adoption homöopathisch.
Und das Sternchen gehört hier an den Absender: Orb ist ein Billing-Infrastruktur-Anbieter, und der Report endet erwartbar mit der Erkenntnis, dass Usage-based die Zukunft ist und Orb dir das Billing dafür baut. Gute Daten, klarer Eigennutz.
Soviel zu einer Woche, in der ich eigentlich nur zwei Tätigkeiten nachgehen wollte: aufs Meer schauen und mir ein paar skandinavische Städte ansehen.
### Context Engineering: Warum der perfekte Prompt nur ein Baustein ist
URL: https://t01.li/ki-systemdesign/context-engineering-prompt-engineering-baustein/
Last updated: 2026-06-17T09:38:24.000Z
Context Engineering klingt nach dem nächsten Begriff, den dir jemand auf LinkedIn als Karriere-Pflicht verkaufen will. Ist er auch – die halbe Timeline besteht aus genau diesen Posts. Dahinter steckt aber etwas, das in jedem LLM-Produkt arbeitet, das im Alltag verlässlich tut, was es soll. Und der Begriff rückt eine Sache gerade, die im Prompt-Hype der letzten Jahre unterging: Der einzelne Prompt ist nicht der Hebel. Er ist einer von vielen.
Wer 2026 ernsthaft etwas mit Sprachmodellen baut – einen Support-Bot, einen Agenten, eine Suche über die eigene Doku –, scheitert selten am Modell. [Die Modelle sind gut](https://t01.li/ki-systemdesign/wenn-benchmarks-lugen-warum-der-llm-vergleich-kaputt-ist/). Gescheitert wird am Kontext. Am falschen, am fehlenden, am überladenen. Context Engineering ist die Disziplin, die genau das in den Griff nimmt, und Prompt Engineering steckt da als ein Teil drin. Kein Vorgänger, keine abgelöste Vorstufe.
## TL;DR
Context Engineering ist die Disziplin, das gesamte Informationsumfeld eines Sprachmodells bewusst zu bauen – System-Prompt, Beispiele, abgerufenes Wissen, Gedächtnis, Tools, Historie. Prompt Engineering ist ein Teil davon, kein überholter Vorläufer.
- Der Begriff entstand im Juni 2025 – geprägt von Shopify-Chef Tobi Lütke, popularisiert von Andrej Karpathy, definiert von Philipp Schmid und Anthropic.
- Das Kontextfenster ist eine begrenzte Ressource. Mehr Text heißt nicht mehr Qualität – ab einer gewissen Länge wird es messbar schlechter.
- Für KMU heißt das: Nicht ein anderes Modell kaufen, sondern die Kontext-Architektur sauber bauen. RAG, Memory, Tool-Anbindung, Token-Management.
## Wer den Begriff geprägt hat – und warum das keine Trivia ist
Der Begriff hat ein Geburtsdatum, und das ist erstaunlich frisch. Am 18\. Juni 2025 schrieb Shopify-Gründer Tobi Lütke auf X, er möge [„context engineering“ lieber als „prompt engineering“](https://x.com/tobi/status/1935533422589399127?ref=t01.li) – es beschreibe die eigentliche Kernkompetenz besser, nämlich die Kunst, einem Modell allen Kontext zu liefern, den es braucht, um eine Aufgabe überhaupt lösen zu können. Eine Woche später legte [Andrej Karpathy nach](https://x.com/karpathy/status/1937902205765607626?ref=t01.li), damals noch Gründer von Eureka Labs und nicht, wie manche Sekundärquellen es rückdatieren, bei Anthropic – dorthin wechselte er erst im [Mai 2026](https://techcrunch.com/2026/05/19/openai-co-founder-andrej-karpathy-joins-anthropics-pre-training-team/?ref=t01.li). Karpathy nannte es „
> „the delicate art and science of filling the context window with just the right information for the next step“.
Dass der Begriff hängenblieb, lag nicht an einem einzelnen Tweet. [Harrison Chase von LangChain](https://blog.langchain.com/the-rise-of-context-engineering?ref=t01.li) lieferte zwei Tage vor Karpathy die Arbeitsdefinition, die heute am häufigsten zitiert wird. [Simon Willison](https://simonwillison.net/2025/Jun/27/context-engineering/?ref=t01.li), Django-Mitschöpfer und einer der nüchternsten LLM-Kommentatoren, sagte voraus, dass der Begriff bleiben würde. Und [Walden Yan von Cognition](https://cognition.ai/blog/dont-build-multi-agents?ref=t01.li) hatte die Prinzipien schon einige Tage vor Lütkes Tweet aufgeschrieben, ohne sie so zu nennen. Es gibt also keinen Erfinder. Es gibt eine Begriffskoaleszenz im Juni 2025, an der ein halbes Dutzend Leute beteiligt war.
Warum ich das so genau aufdrösele: Wenn du den Begriff in deiner Firma einführst, wirst du gefragt, woher er kommt. Und die ehrliche Antwort – „mehrere Leute, fast gleichzeitig, niemand zuerst“ – ist glaubwürdiger als die LinkedIn-Version mit dem einen, großen Visionär.
## Die eigentliche Definition – Kontext ist alles, was vor dem Modell landet
Die zugänglichste Definition stammt von [Philipp Schmid](https://philschmid.de/?ref=t01.li), Senior AI Developer Relations Engineer bei Google DeepMind. Context Engineering sei die Disziplin, dynamische Systeme zu bauen, die einem Modell die richtigen Informationen und Werkzeuge im richtigen Format zur richtigen Zeit geben. Sein Satz, der seitdem durch jede zweite Präsentation wandert:
> „Most agent failures are not model failures anymore, they are context failures.“
Auf Deutsch und ohne Pathos: wenn dein Agent Mist baut, liegt das meistens nicht am Modell, sondern an dem, was du ihm mitgegeben hast.
Schmid zählt sieben Komponenten auf, die zusammen den Kontext ergeben: der System-Prompt, der eigentliche User-Input, das Kurzzeitgedächtnis aus der laufenden Unterhaltung, ein Langzeitgedächtnis, abgerufenes Wissen aus einer Datenquelle, die verfügbaren Tools und das Format, in dem die Antwort rauskommen soll. [Anthropic hat das im September 2025 architektonisch formalisiert](https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents?ref=t01.li) und beschreibt Context Engineering als die Aufgabe, aus all den Tokens, die während einer Inferenz im Fenster landen können, die optimale Menge zu kuratieren. Klar, Anthropic verkauft mit *Claude* das Modell und hat ein Interesse daran, dass du dich um den Kontext kümmerst statt um die Konkurrenz – die Definition trägt trotzdem, weil sie technisch sauber ist.
Der Prompt ist in dieser Aufzählung eine Zeile von sieben. Genau hier sitzt die Brücke zum Prompt Engineering, und sie ist simpler, als die Buzzword-Debatte glauben macht:
| Dimension | Prompt Engineering | Context Engineering |
| ------------ | ---------------------------------- | ----------------------------------------------------------- |
| Einheit | ein String, eine Anweisung | das gesamte Kontextfenster pro Schritt |
| Zeit | statisch hinterlegt | dynamisch, pro Anfrage neu zusammengebaut |
| Bestandteile | Wortwahl, Format, Rolle, Beispiele | dazu RAG, Memory, Tools, Tool-Outputs, Historie, Compaction |
| wer macht's | Mensch tippt | System konstruiert vor dem Modell-Call |
Prompt Engineering ist die „Gestaltung“ der statisch hinterlegten Anweisungen. Context Engineering umfasst das und kommt um alles herum, was zur Laufzeit dazukommt. Wer Context Engineering als Nachfolger im Sinne von Ablösung liest, hat beides leider missverstanden.
### Warum das wichtig ist – das Kontextfenster ist kein Gratis-Speicher
Die naheliegende Reaktion auf all das lautet: Kontextfenster werden doch immer größer, eine Million Token bei *Gemini 3.x*, da kippe ich halt alles rein. Funktioniert nicht. Und das ist der Punkt, an dem Context Engineering von einer Begriffsklauberei zu einer Ingenieursfrage wird.
[Chroma Research hat im Juli 2025](https://research.trychroma.com/context-rot?ref=t01.li) achtzehn Modelle getestet:,darunter: *GPT-4.1*, *Claude 4*, *Gemini 2.5*, *Qwen3* und einen Effekt dokumentiert, den sie „Context Rot“ nennen. Modelle nutzen ihren Kontext nicht gleichmäßig. Je länger der Input, desto unzuverlässiger die Leistung, auch wenn alles technisch ins Fenster passt. Auf einem Gedächtnis-Benchmark schnitten alle Modelle bei einem fokussierten Prompt von rund 300 Token deutlich besser ab als bei rund 113.000 Token mit derselben relevanten Information drin. Hier das Hersteller-Sternchen: Chroma verkauft eine Vektordatenbank und hat ein handfestes Interesse daran, dass „mehr reinkippen“ nicht die Lösung ist. Die Befunde wurden von unabhängiger Seite reproduziert, die Methodik ist offengelegt – ich nehme sie ernst, aber nicht als neutrale Wahrheit vom Berg.
Der Effekt ist nicht neu. Schon 2023 zeigte die Stanford-Arbeit „[Lost in the Middle](https://arxiv.org/abs/2307.03172?ref=t01.li)“ eine U-förmige Kurve: Modelle finden Information am Anfang und Ende des Kontexts gut, in der Mitte schlecht. Damals fiel die Trefferquote bei *GPT-3.5-Turbo* von rund 74 Prozent auf der ersten Position auf etwa 60 Prozent in der Mitte. Ein alter Befund, drei Jahre ist in diesem Feld eine Ewigkeit, und neuere Long-Context-Modelle schwächen den Effekt auf einfachen Suchaufgaben ab. Bei echtem semantischem Verständnis bleibt die Schwäche aber. Anthropic begründet das mit einem „attention budget“ – die Transformer-Architektur erzeugt Beziehungen zwischen allen Token, und je länger der Kontext, desto dünner verteilt sich die Aufmerksamkeit.
Dazu kommt das Offensichtliche, das in der Architektur-Diskussion gern vergessen wird. Jeder Token kostet. Bei [*Claude Opus 4.8*](https://t01.li/ki-news/claude-opus-4-8-ein-inkrement-das-vor-allem-ehrlicher-sein-will/) sind das 5 Dollar pro Million Input-Token, und ein Agent, der in Schleifen läuft, schaufelt seinen Kontext bei jedem Schritt erneut durchs Modell. Wer ungefiltert alles mitschickt, zahlt für Müll und macht das Ergebnis schlechter. Beides gleichzeitig.
Und dann sind da die Fehler, die kein Modellfehler sind. Drew Breunig hat [vier Versagensmuster katalogisiert](https://www.dbreunig.com/2025/06/22/how-contexts-fail-and-how-to-fix-them.html?ref=t01.li), die sich rein aus dem Kontext ergeben: Eine Halluzination landet im Fenster und wird danach brav weiterzitiert. Zu viel Kontext drängt das Trainingswissen in den Hintergrund. Überflüssige Information wird trotzdem verwurstet. Oder zwei Quellen widersprechen sich, und das Modell weiß nicht, welcher es glauben soll. Keiner dieser Fälle wird besser, wenn du ein teureres Modell kaufst.
### Prompt Engineering ist nicht tot – es ist eine Schicht geworden
Es gab im Sommer 2025 die übliche BWL-Analysten-Schlagzeile, Prompt Engineering sei „out“. Das ist Verkaufssprech mit einem wahren Kern, falsch zugespitzt. Prompt-Qualität ist nicht verschwunden, sie ist eine Ebene im Stack geworden. Der System-Prompt bleibt der Ort, an dem du dem Modell Rolle, Format und Leitplanken gibst. Few-Shot-Beispiele bleiben das Mittel, um Verhalten zu zeigen statt zu beschreiben. Was sich geändert hat: Diese Dinge sind nicht mehr das ganze Spiel, sondern ein paar Felder auf einem größeren Brett.
Wer in der eigenen Firma noch [über den „perfekten Prompt“ diskutiert](https://t01.li/ki-systemdesign/constraint-based-prompting-bei-reasoning-modellen-schadet-mehr-als-das-es-nutzt/), während die Antworten an fehlendem Unternehmenswissen scheitern, hat das Problem auf der falschen Ebene. Der perfekteste Prompt der Welt holt keine Information her, die nie in den Kontext gekommen ist.
### Die Bausteine – kurz und ohne Werkzeugkasten-Romantik
Vier Dinge tauchen in fast jeder ernsthaften Kontext-Architektur auf. RAG – Retrieval-Augmented Generation, [seit Lewis et al. 2020](https://arxiv.org/abs/2005.11401?ref=t01.li) etabliert – holt vor der Antwort die passenden Stücke aus einer Wissensbasis und schiebt sie ins Fenster. Das reduziert Halluzinationen und bringt aktuelle Daten rein, ohne das Modell neu zu trainieren. Context Engineering ist aber nicht „RAG, neu lackiert“; RAG ist eine Technik im Kasten, nicht der Kasten.
Memory ist die Persistenz jenseits des Fensters: die laufende Unterhaltung als Kurzzeitgedächtnis, eine Datenbank oder strukturierte Notizen als Langzeitgedächtnis. Die Tool-Anbindung läuft heute oft über das Model Context Protocol, das Anthropic im November 2024 herausbrachte und am [9\. Dezember 2025 an die Agentic AI Foundation](https://www.anthropic.com/news/donating-the-model-context-protocol-and-establishing-of-the-agentic-ai-foundation?ref=t01.li) übergab – einen Fonds unter dem Dach der Linux Foundation, gemeinsam gegründet mit Block und OpenAI. Der Marketing-Vergleich „USB-C für AI“ ist griffig und stammt naturgemäß von den Anbietern selbst. Compaction schließlich verdichtet lange Verläufe zu Zusammenfassungen, bevor das Fenster überläuft.
Das Muster hinter allen vieren ist dasselbe: nicht alles vorhalten, sondern das Richtige zur richtigen Zeit nachladen. Wie ein Mensch, der nicht jede Datei auswendig kennt, sondern weiß, in welchem Ordner sie liegt.
### Was das für KMU heißt – ohne Beratungs-Powerpoint
Die gute Nachricht vorweg: Der Einstieg ist kein Big-Bang-Projekt, sondern eine Treppe. Stufe eins ist schlicht Verstehen – den Begriff einordnen und merken, dass die Diskussion über den perfekten Prompt am eigentlichen Hebel vorbeigeht. Wenn dein Team morgens dieselben Kontextdaten von Hand in den Chat tippt, bist du längst bei Stufe zwei: Inventarisieren, welche Quellen eigentlich in den Kontext gehörten – CRM, Wiki, Ticketsystem, Handbücher.
Stufe drei ist der erste RAG-Prototyp an einer eng abgegrenzten Quelle, etwa dem Produkthandbuch oder der FAQ. Der Auslöser dafür ist meist Schmerz: Das Modell halluziniert bei firmenspezifischen Fragen, weil es sie nie zu sehen bekam. Läuft das stabil, kommt mit der Tool-Anbindung Stufe vier, sobald sich wiederholbare, mehrschrittige Aufgaben mit klarem Nutzen abzeichnen. Und Stufe fünf – Langzeit-Memory und Token-Management – wird erst dann relevant, wenn Kosten oder Antwortzeiten anfangen wehzutun. Vorher ist das verfrühte Optimierung.
Mein nüchterner Take zum Schluss: Context Engineering ist kein neuer Hype, sondern der Name für die Arbeit, die schon immer den Unterschied zwischen einem beeindruckenden Demo und einem brauchbaren Produkt gemacht hat. Der Prompt war nie die ganze Geschichte. Er war nur der Teil, den man am leichtesten auf eine Konferenz-Slide schreiben konnte.
### LLM-Datenformate: Wie man mit einem Modell spricht – und in welcher Sprache es antwortet
URL: https://t01.li/ki-systemdesign/llm-datenformate-json-yaml-xml-toon-html-im-vergleich/
Last updated: 2026-06-17T09:41:50.000Z
Es ist eine Geschichte voller Leiden, voller langer Tage und noch viel längerer Nächte. Wer in jüngerer Vergangenheit um drei Uhr morgens debuggt hat, warum ein scheinbar perfektes JSON-Schema beim 527\. API-Call plötzlich ein falsch platziertes Anführungszeichen schreibt und die ganze Pipeline pulverisiert, der weiß: Die Wahl des Datenformats ist keine kosmetische Entscheidung. Sie ist Architektur.
Drei Fragen zum Thema LLM-Datenformate stellen sich, sobald man ein Modell über die Spielwiese hinaus in Produktion bringt – egal ob im Web-Chat, über die API oder im Agenten-Workflow. Welche Input-Formate kann ich nutzen? Welche erwartet das Modell von mir? Und in welchem Format hätte ich das Ergebnis denn gern, damit ich es ohne schlechtes Gewissen weiterreichen kann?
Die kurze Antwort: Kommt darauf an. Die lange Antwort kommt gleich.
## TL;DR
- **JSON** ist gesetzt als API-Standard, aber dank Constrained Decoding bei OpenAI, Google und Anthropic ist „JSON bricht ständig“ als Argument inzwischen Geschichte – zumindest wenn du native Structured-Output-Modi nutzt.
- **YAML** bleibt der König für lesbare System-Prompts und Few-Shot-Beispiele, kostet aber bei jeder Einrückungs-Verschiebung Nerven.
- **TOML** ist Backend-Werkzeug für Prompt-Templates, nicht für Modell-Kommunikation.
- **Markdown** ist die Muttersprache der Modelle und für RAG-Inputs und konversationelle Outputs erste Wahl.
- **XML** ist Anthropics offizielle Empfehlung für strukturierte Prompts – mit messbarem Effekt auf Output-Konsistenz.
- **TOON** spart Tokens bei tabellarischen Daten und kann bei verschachteltem Kram teurer werden als JSON. Die kursierenden 30–60 % stammen aus den eigenen Benchmarks der Initiatoren.
- **CSV/TSV** sind unschlagbar für Bulk-Tabellendaten, sobald aber Verschachtelung dazukommt: vorbei.
- **HTML** erlebt ein Comeback als Output-Format – aber aus einem überraschenden Grund.
## JSON – der ungeliebte Standard, der sich gerade selbst rettet
JSON ist die Lingua Franca jeder API aber 'ne kleine Diva. Jedes Backend versteht es, jeder Parser frisst es, und seit August 2024 zwingen OpenAI und inzwischen alle großen Anbieter ihre Modelle per Constrained Decoding dazu, syntaktisch valides JSON zu liefern. Das hat die Lage fundamental verbessert.
Damals galt: Lass ein Modell frei JSON generieren und du wirst regelmäßig von vergessenen Anführungszeichen, Trailing Commas und unsauber escapten Strings überrascht. Die Folge war die ganze Bibliothek aus Healing-Prompts, Retry-Loops und Backend-Bandagen. Heute sieht das anders aus. Wenn du `response_format: json_schema` mit `strict: true` setzt, wird das Modell strukturell keine kaputten Outputs mehr produzieren – die Token-Auswahl wird zur Laufzeit auf die nach Schema gültigen Tokens beschränkt.
Anthropic hat im November 2025 nachgezogen und Constrained Decoding für Claude verfügbar gemacht. Damit ist die Grundbehauptung „JSON ist fragil" für Produktionsumgebungen praktisch erledigt – vorausgesetzt, man nutzt die nativen Modi und schreibt sich nicht aus Trotz oder Bequemlichkeit „antworte mir bitte in JSON" in den Prompt.
Eine wichtige Falle bleibt aber. Eine viel zitierte Studie von Tam et al. aus dem August 2024 zeigt, dass strikter JSON-Mode bei Reasoning-Tasks die Modellqualität spürbar drückt. Bei GSM8K-Mathe-Aufgaben fielen GPT-3.5 und mehrere Open-Source-Modelle deutlich ab, sobald sie das Denken in ein JSON-Korsett zwängen mussten. Bei reinen Klassifikationsaufgaben war der Effekt umgekehrt – da half der enge Output-Raum sogar. Die pragmatische Konsequenz: Reasoning-Schritte und Strukturierung trennen. Erst denken lassen, dann formen. OpenAI empfiehlt das selbst und schlägt explizit ein vorgelagertes reasoning-Feld im Schema vor – Benchmarks von Instructor zeigten dadurch bis zu 60 % Accuracy-Gewinn auf GSM8K. Das ist dieselbe Linie, die ich schon bei [Constraint-Based Prompting an Reasoning-Modellen](https://t01.li/ki-systemdesign/constraint-based-prompting-bei-reasoning-modellen-schadet-mehr-als-das-es-nutzt/) kritisiert habe: zu enge Korsette während des Denkprozesses zerschießen genau die Fähigkeit, für die du das Modell überhaupt nutzt.
## YAML – schön für Menschen, gefährlich für Maschinen
YAML ersetzt JSONs syntaktische Last durch Whitespaces und Zeilenumbrüche. Das spart Tokens und ist deutlich angenehmer zu lesen, gerade bei längeren System-Prompts oder Few-Shot-Beispielen. Wer schon einmal versucht hat, drei verschachtelte Few-Shot-Beispiele in JSON zu pflegen, weiß, warum YAML so populär ist.
Der Haken sitzt tief in der Sprache selbst. YAML verzeiht keine Einrückungsfehler – ein Leerzeichen zu viel oder zu wenig und die ganze Objekt-Hierarchie verrutscht. Dazu kommen die berüchtigten unquotierten Werte, bei denen ein freundliches `no` zu `false` mutiert, weil der Parser das so gelernt hat. YAML ist also input-spezifisch zumindest ein halber Albtraum. Jeder, der sich beispielsweise mit Docker Compose beschäftigt, kennt das. Das macht YAML für Modell-Outputs riskant, für Inputs aber nach wie vor wertvoll. Mein pragmatischer Take: YAML für Prompts, JSON oder TOON für Outputs.
## TOML – der unterschätzte Backend-Held
TOML wird oft als „YAML ohne Drama“ verkauft und das stimmt sogar halbwegs. Sektionen mit eckigen Klammern, Key-Value-Paare, multiline Strings ohne Escape-Hölle. In der direkten Kommunikation mit dem Modell spielt TOML keine Rolle – Modelle wurden auf weniger TOML trainiert als auf YAML oder JSON, und Outputs in TOML zu erzwingen, ist meist sinnlos.
Wofür TOML brilliert, ist das Prompt-Management im Code-Repository. Wer eine prompts.toml führt, in der System-Prompts, Few-Shot-Beispiele und Konfigurationen sauber liegen, hat eine wartbare Basis. Das ist Infrastruktur-Komfort, kein Modell-Format. Verwechslung der beiden Ebenen ist häufig und vermeidbar.
## Markdown – die Muttersprache der Modelle
Markdown ist das Format, mit dem Modelle aufgewachsen sind. Sie haben es millionenfach im Training gesehen und beherrschen es fast fehlerfrei. Kennt außerdem jeder, der sich schon mal auf GitHub verirrt hat. Markdown-Syntax ist so wunderbar einfach verständlich und auch ohne Parser gut lesbar. Ich oute mich hier mal als echter Markdown-Fan.
Für drei Szenarien ist Markdown die ideale Wahl. RAG-Dokumente, die du in den Kontext injizierst. Freie Modell-Antworten an menschliche Endnutzer. Und alles, was zwischen Reasoning-Schritten und finaler Strukturierung liegt.
Was Markdown nicht kann: striktes Parsing. Eine Markdown-Tabelle ist keine Datenbank-Zeile, und der Versuch, aus Markdown-Outputs direkt SQL-Inserts zu generieren, endet im Tränental. Für die Mensch-Schnittstelle perfekt, für die Maschine-Maschine-Schnittstelle die falsche Wahl.
## XML – Anthropics offene Geheimwaffe
Hier wird es interessant. Anthropic empfiehlt in der offiziellen Prompting-Doku konsequent XML-Tags für die Strukturierung komplexer Prompts: ``, ``, ``, ``. Claude wurde explizit darauf trainiert, diese Tags zu erkennen und konsistent zu verarbeiten. In der offiziellen Doku wird XML als primäre Methode für komplexe Prompts empfohlen, mit dem Argument deutlich konsistenterer Outputs.
Auch XML ist wunderbar einfach gestrickt und schnell weggeschrieben – kennt man, hat man schon mal gesehen, kann man. Der Mechanismus dahinter ist simpel und stabil. XML-Tags öffnen und schließen sich. Das LLM hat ein fast schon mathematisches Gespür dafür, was zwischen ` `und ` `gehört und was nicht. Damit löst XML zwei Probleme auf einmal. Erstens die saubere Trennung von Systeminstruktion und Nutzerdaten – Nutzer-Input in ``\-Tags zu kapseln ist eine elegante Verteidigungslinie gegen Prompt Injection. Zweitens das saubere Herauslösen strukturierter Antworten, etwa „denke laut in ` `und gib das Ergebnis in `