Token-Effizienz in Claude Code: Was wirklich hilft – und was überholt ist
Was beim Token-Verbrauch in Claude Code wirklich hilft: /usage als Diagnose, /clear, Effort, eine kurze CLAUDE.md und die richtige Modellwahl seit Opus 5.5. Dazu die Tipps, die überholt sind, und ein Fehler aus der ersten Fassung.
Im Mai hatte ich an dieser Stelle aufgeschrieben, was beim Token-Verbrauch in Claude Code tatsächlich etwas bringt; der Anlass waren zwei Dinge: Ich nutze Claude Code im Max 5x Plan, vor allem für Python, Handlebars, PHP und TypeScript, und stoße dabei erstaunlich selten ans Limit (das ist abhängig vom Aufkommen und natürlich davon, was man so mit Claude Code treibt – das ist mir durchaus bewusst). Und durchs Netz geisterte ein Medium-Artikel, der mit ein paar Tricks 90 % weniger Tokens versprach.
Seitdem sind mehr als 150 Versionen von Claude Code erschienen und aus Opus 4.7 und Sonnet 4.6 wurden Opus 5.5, Sonnet 5.5 und Haiku 5.5. /usage zeigt inzwischen selbst an, wohin die Tokens fließen. Beim Nachprüfen bin ich auch über einen Fehler in meinem eigenen Text gestolpert: Die .claudeignore, die ich als einen von sechs belastbaren Hebeln empfohlen hatte, wertet Claude Code gar nicht aus. Grund genug, meinen Text zur Token-Effizienz in Claude Code gründlich zu überarbeiten.
TL;DR
Token-Effizienz in Claude Code ist vor allem eine Frage der Ausgabequalität. Jeder Request schickt den gesamten Verlauf mit, und ein voller Kontext liefert schlechteren Code, auch wenn das Kontextfenster inzwischen eine Million Tokens fasst.
- Zuerst messen:
/usagezeigt auf Pro und Max, welche Skills, Subagents, Plugins und MCP-Server den Verbrauch treiben, und schlägt Korrekturen vor. - Die Grundhebel gelten weiter:
/clearzwischen unabhängigen Aufgaben, eineCLAUDE.mdunter 200 Zeilen, Plan Mode und konkrete Prompts. - Neu dazugekommen sind
/effort(Thinking-Tokens zählen als Output), Skills und pfadbezogene Regeln, die nur bei Bedarf laden, sowie Hooks, die lange Ausgaben filtern. - Claude Code startet auf Pro und Max mit Opus 5.5. Für Alltagsaufgaben reicht meist Sonnet 5.5, das über die API die Hälfte kostet.
- Subagents und Agent Teams kosten zusätzliche Tokens. Eine
.claudeignorewirkt nicht, Dateien sperrt man mit Read-Regeln in dersettings.json.
Ursprünglich am 28. Mai 2026 erschienen, jetzt grundlegend überarbeitet. Gestrichen ist die Empfehlung einer .claudeignore, die Claude Code nie ausgewertet hat. Neu sind die Abschnitte zu /usage, Prompt Caching, Effort und Hintergrund-Verbrauch. Modelle, Preise und die Einordnung von Subagents und Agent Teams sind auf dem aktuellen Stand, den Abschnitt zum Medium-Artikel habe ich gekürzt.
Wohin die Tokens in Claude Code gehen
Bei jedem Request schickt Claude Code den gesamten bisherigen Verlauf mit – Prompts, Antworten, jede gelesene Datei, jeden Tool-Output, dazu die CLAUDE.md und alles, was sonst noch im Kontextfenster liegt. Nutzt Claude innerhalb eines Turns Tools, geht mit jeder Runde Ergebnisse ein weiterer Request raus. Was das Modell über die Session weiß, steckt komplett in diesem Context. Wie sich das summiert, beschreibt Anthropic auf der Costs-Seite: Eine einzeilige Frage in einer Session, die seit dem Morgen offen ist, zieht Usage für die gesamte Unterhaltung.
Daran haben sich seit Mai zwei Dinge verschoben: Das erste ist die Größe des Kontextfensters. Opus 4.7 und neuer, Sonnet 5.5, Haiku 5.5 und die Fable-Modelle laufen in Claude Code standardmäßig mit einer Million Tokens, die automatische Zusammenfassung (Auto-Compaction) greift laut Modell-Doku erst bei rund 967.000 Tokens. Dass eine Session vollläuft, kommt damit kaum noch vor, am Qualitätsproblem ändert das wenig. Die API-Doku nennt es „context rot“: Mit jedem zusätzlichen Token im Kontext lassen Genauigkeit und Erinnerung nach. Eine Million Tokens heißt in der Praxis also auch, dass man deutlich länger in einem verschmutzten Context weiterarbeitet, bevor irgendetwas eingreift. Wer das begrenzen will, setzt mit /autocompact 200k eine eigene Schwelle.
Das zweite ist der Preis der Wiederholung. Claude Code nutzt Prompt Caching, der unveränderte vordere Teil der Unterhaltung wird beim nächsten Request also aus dem Cache gelesen. Bei Opus 5.5 und Sonnet 5.5 kostet das laut Preisliste 5 % des normalen Input-Preises, bei den meisten anderen Modellen 10 %. Auf einem Abo hält der Cache rund eine Stunde, mit API-Key fünf Minuten, für Subagents gelten auch im Abo fünf Minuten (es ist schon merkwürdig genug, dass hier Abo und API unterschiedlich gehandhabt werden). Wer nach einer längeren Pause weiterschreibt, lässt den kompletten Kontext neu verarbeiten und neu in den Cache schreiben, und das kostet mehr als normaler Input. Ruhende Sessions über rund 200.000 Tokens fasst Claude Code im Abo inzwischen kurz vor Ablauf des Caches von selbst zusammen, nach der Mittagspause geht es dann mit einer Zusammenfassung weiter.
Die vielzitierte Zahl von Sascha Hoffmann, nach der 98,5 % der Tokens ins Lesen gehen und nur 1,5 % in den Output, bezog sich zwar auf Claude im Web, aber in Claude Code dürfte das Verhältnis wegen Datei-Reads, Bash- und MCP-Ausgaben eher noch schiefer ausfallen. Beim Geld relativiert sich das ein wenig. Output kostet in der ganzen aktuellen Modellfamilie pro Token das Fünffache von Input und der größte Teil des Lesens läuft zum Cache-Tarif. Teuer wird das Lesen durch Cache-Misses und durch schiere Menge.
Erst messen, dann sparen
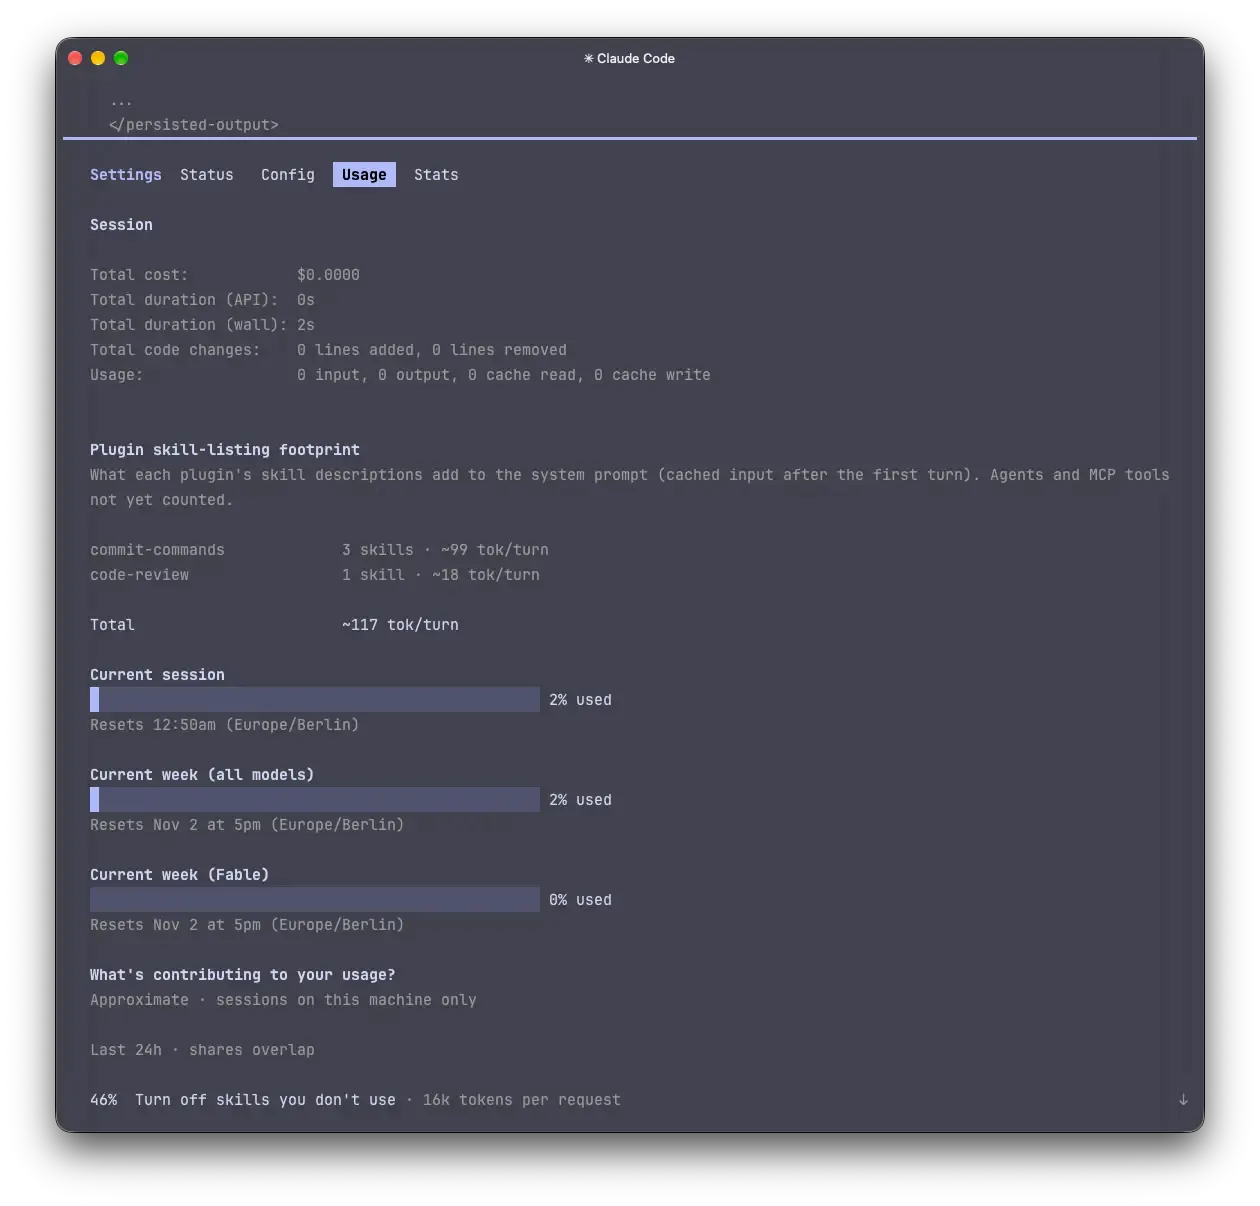
Im Mai hatte ich am Ende auf /usage und /cost verwiesen. /cost gibt es nur noch als Kürzel, beide Befehle sind laut Changelog in /usage aufgegangen. Und das kann inzwischen einiges mehr. Auf Pro, Max, Team und Enterprise schlüsselt /usage den Verbrauch der letzten 24 Stunden oder sieben Tage nach Skills, Subagents, Plugins und einzelnen MCP-Servern auf. Darunter stehen Empfehlungen für alles, was mindestens 10 % der eigenen Usage ausmacht, zum Beispiel „Trim ~/code/api/CLAUDE.md · 49k tokens per request“ oder der Wechsel von max auf high Effort. Seit Version 2.1.305 setzt die Taste f einen Teil davon direkt um.
Die Prozentwerte geben an, welchen Anteil der Usage eine Empfehlung betrifft. Was die Änderung einspart, steht dort nicht, und weil ein Request mehreren Zeilen zugerechnet werden kann, kommen in der Summe auch mal mehr als 100 % heraus. Gerechnet wird nur mit der lokalen Session-Historie, Nutzung auf anderen Geräten oder in claude.ai fehlt. Wer wissen will, was gerade im Kontext steckt, bekommt mit /context die Aufteilung auf System-Prompt, CLAUDE.md, Skills, MCP-Tools und Verlauf.
Die Token-Hebel, die wirken
Die Grundlagen aus dem Mai haben gehalten. Anthropic nennt sie auf der aktuellen Best-Practices-Seite fast wortgleich.
/clear zwischen unabhängigen Aufgaben. Nach wie vor der einfachste Ansatzpunkt, und laut Doku kostet er nichts. Wer die Session später wiederfinden will, benennt sie vorher mit /rename und holt sie mit /resume zurück. Anthropic empfiehlt /clear inzwischen auch nach zwei gescheiterten Korrekturen, weil Claude bei jedem weiteren Turn beide Fehlversuche mitliest. Ein frischer Prompt, der das Gelernte zusammenfasst, funktioniert dann fast immer besser. /compact mit einem Fokus ist die Alternative, wenn der Verlauf noch gebraucht wird. Der Befehl kostet selbst einiges, denn für die Zusammenfassung liest Claude die gesamte Unterhaltung.
Eine kurze CLAUDE.md. Sie wird zu Beginn jeder Session geladen und bleibt im Kontext. Anthropic nennt in der Memory-Doku inzwischen eine Zielgröße von unter 200 Zeilen pro Datei. Die 300 bis 600 Tokens aus der ersten Fassung waren eine Praktiker-Faustregel, als Faustregel würde ich sie heute nicht mehr verkaufen. Spezielle Anweisungen gehören in Skills, die erst beim Aufruf laden, oder in pfadbezogene Regeln unter .claude/rules/. @-Importe räumen nur auf, sparen aber nichts, weil die importierten Dateien mitgeladen werden. Und Architektur samt Verzeichnisbaum kann raus, Claude liest das Repo selbst. Wie das konkret aussieht, steht in meinem Text darüber, wie ich meine CLAUDE.md auf 87 Zeilen gekürzt habe.
Plan Mode für nicht-triviale Änderungen. Shift+Tab schaltet ihn ein, Claude untersucht erst den Code und schlägt einen Weg vor, bevor etwas geändert wird. Das verhindert das teuerste Muster überhaupt, nämlich Schleifen aus Ausprobieren, Scheitern und Korrigieren, bei denen jede Runde den gesamten Context erneut durch die Mühle schickt.
Konkrete Prompts. Vage Anfragen wie „improve this codebase“ lösen laut Costs-Seite breites Scannen aus, eine Anfrage wie „add input validation to the login function in auth.ts“ kommt mit wenigen Datei-Reads aus. Dateien per @ referenzieren und Prüfkriterien mitgeben, etwa Tests oder erwartete Ausgaben, spart Suchschleifen. Mehr dazu, wie sich Kontext gezielt zusammenstellen lässt, steht im Text über Context Engineering als Baustein im Prompt.
Die .claudeignore, die es nie gab
Update vom 28. Oktober 2026: In der ersten Fassung stand hier, eine .claudeignore wirke wie .gitignore und halte Lock-Files, node_modules und Build-Artefakte von Claude fern. Das war einfach und schlicht falsch. Claude Code wertet die Datei nicht aus, die Permissions-Doku sagt das inzwischen ausdrücklich und empfiehlt, die Einträge in Read-Deny-Regeln zu überführen. Der Dateiname klingt so plausibel, dass er in etlichen Tipp-Listen auftaucht, meine eingeschlossen.
Der funktionierende Weg ist ein deny-Block in der settings.json des Projekts:
{
  "permissions": {
    "deny": [
      "Read(./node_modules/**)",
      "Read(./dist/**)",
      "Read(./package-lock.json)"
    ]
  }
}
Die Muster folgen der gitignore-Syntax. Sie greifen bei Claudes Datei-Werkzeugen, bei @-Erwähnungen und bei Bash-Befehlen, die Claude Code als Dateizugriff erkennt, etwa cat, head oder tail. Ein grep -r über das ganze Verzeichnis oder ein Skript, das Dateien selbst öffnet, rutscht durch.
Opus ist jetzt Standard, und das kostet
Seit dem Mai hat sich die Ausgangslage bei der Modellwahl umgedreht. Damals ging es darum, nicht reflexhaft Opus zu wählen. Heute startet Claude Code auf Pro, Max, Team und Enterprise laut Doku von sich aus mit Opus 5.5. Die Costs-Seite rät trotzdem weiter zu Sonnet für die meisten Coding-Aufgaben und zu Opus für Architekturentscheidungen und mehrstufiges Denken. Der Befehlt /model ist dein Freund. opusplan gibt es weiterhin, damit plant Opus im Plan Mode und Sonnet setzt um.
Kleine Anmerkung dazu: Sonnet auf xhigh ist momentan mein Way to go für die allermeisten Aufgaben, die über den Routine-Kram hinausgehen. Und zugegebenermaßen hatte ich noch nichts, was Sonnet nicht gelöst hat.
Für Kleinkram wie Lookups, Umbenennungen oder Formatierung bietet sich Haiku 5.5 an, Anthropic empfiehlt es auch ausdrücklich für einfache Subagent-Aufgaben. Über die API gilt der niedrige Preis von 0,10 $ und 0,50 $ nur für Prompts bis 100.000 Tokens. Darüber kostet jeder Request das Fünffache, und in einer längeren Claude-Code-Session ist diese Grenze schnell erreicht.
Ein Wechsel mitten in der Session hat übrigens seinen Preis. Das neue Modell kann den Cache des alten nicht nutzen, deshalb fragt Claude Code bei warmem Cache vor dem Wechsel nach.
Der zweite Regler heißt Effort, und den gab es in der ersten Fassung noch gar nicht. Thinking-Tokens werden als Output abgerechnet, also zum fünffachen Input-Preis. Auf Opus 5.5, Sonnet 5.5, Haiku 5.5 und den Fable-Modellen lässt sich Thinking nicht abschalten, gesteuert wird über /effort mit den Stufen low bis max. Voreingestellt ist bei den 5.5-Modellen medium. Für triviale Aufgaben reicht low, und wer dauerhaft auf max arbeitet, bekommt in /usage womöglich den Rat, eine Stufe herunterzugehen. Den Cache kostet ein Effort-Wechsel bei den 5.5-Modellen und Fable 5.1 nicht mehr. Und Formulierungen wie „think hard“ im Prompt heben die Stufe nicht an, das ist laut Anthropic normaler Prompt-Text. Wirkung hat nur ultrathink, und das auch nur für den einen Turn. Wie Reasoning Effort modellübergreifend funktioniert, steht im Glossar.
Subagents, Teams und was im Hintergrund mitläuft
In der ersten Fassung standen Subagents unter den Spar-Hebeln. Anthropic hat die Gewichtung inzwischen selbst verschoben. In der Liste „What you can stop doing“ der Best Practices steht „Use subagents to protect your context window“ als überholter Rat:
„Running out of context is rarely the problem anymore. Subagents are still great for parallel work, keeping noisy output out of your way, and independent review, but each of those costs extra tokens.“
Für lange Testläufe, Logs oder Doku-Recherche lohnt sich ein Subagent weiterhin. Die Ausgabe bleibt in seinem eigenen Kontext, zurück in die Hauptunterhaltung kommt eine Zusammenfassung. Günstig wird das trotzdem nicht, weil jeder Subagent mit eigenem System-Prompt startet und seinen Cache neu aufbaut. Dazu kommt ein Detail, das man leicht übersieht: Der eingebaute Explore-Subagent läuft auf dem Modell der Hauptunterhaltung, also standardmäßig auf Opus 5.5. Laut Subagent-Doku lässt sich das mit einer eigenen Explore-Definition samt model: haiku ändern oder für alle Subagents über die Variable CLAUDE_CODE_SUBAGENT_MODEL.
Agent Teams sind etwas anderes als mehrere Subagents, das hatte ich im Mai unsauber zusammengeworfen. Ein Team besteht aus getrennten Claude-Code-Instanzen mit jeweils eigenem Kontextfenster, das Feature ist weiterhin experimentell und standardmäßig ausgeschaltet. Die Zahl aus der Doku gilt unverändert, rund siebenmal so viele Tokens wie eine normale Session, wenn die Teammates im Plan Mode laufen. Ein Bericht auf DEV beschreibt, wie fünf parallele Subagents einen Pro-Plan in 15 Minuten leergesaugt haben, sequenziell hätte derselbe Job 30 Minuten gedauert und deutlich weniger gekostet. Parallelität kauft Zeit und bezahlt mit Tokens. Bei meinem Workload aus einzelnen Modulen waren Subagents im Mai die Ausnahme und Agent Teams kein Thema.
Neu ist der Verbrauch, der ohne eigenes Zutun entsteht. Ein /loop, die Check-ins eines aktiven Goals, Nachrichten aus anderen Sessions und die Vorschläge für den nächsten Prompt schicken jeweils den Kontext mit. Bei den Prompt-Vorschlägen sind das laut Doku überwiegend günstige Cache-Reads, bei einem /loop mit kurzem Intervall auf einer großen Session summiert sich das. Die Costs-Seite listet alle Fälle unter „Why usage climbs in a long session“.
MCP, Hooks und Plugins
Ein früher oft gehörter Tipp war, ungenutzte MCP-Server abzuschalten, weil ihre Tool-Definitionen den Kontext unnötig füllen. Das hat an Gewicht verloren, da Claude Code die Definitionen inzwischen erst lädt, wenn es ein Tool tatsächlich auch nutzt. Bis dahin stehen nur Namen und Server-Anweisungen im Kontext. Kommandozeilen-Werkzeuge wie gh bleiben laut Anthropic trotzdem sparsamer als der entsprechende MCP-Server.
Hooks können Ausgaben filtern, bevor Claude sie zu sehen bekommt. Die Doku nennt einen Hook, der aus einer Logdatei mit 10.000 Zeilen nur die Fehlerzeilen durchreicht und den Kontext so von Zehntausenden Tokens auf ein paar hundert drückt, und einen PreToolUse-Hook, der Testläufe auf die Fehlschläge eindampft. Für typisierte Sprachen gibt es Code-Intelligence-Plugins, die einen Language Server anbinden. Ein „Go to definition“ ersetzt dann die Kette aus grep und mehreren gelesenen Kandidaten-Dateien.
Was weiterhin nicht hilft
Beim Medium-Artikel von Mehul Gupta mit den 90 % im Titel bleibt es bei meiner Einschätzung aus dem Mai. Sieben Tipps, keine Quelle, keine Messung, und die 90 % kommen im Text nie wieder vor. Zwei der Tipps widersprechen der Anthropic-Doku heute noch deutlicher als im Mai. „Batch tasks instead of splitting them“ packt alles in einen Riesen-Prompt, der Context explodiert dann eben während der Ausführung, und Plan Mode wird praktisch unmöglich. „Keep prompts simple and direct“ führt zu genau dem breiten Scannen, vor dem die Costs-Seite warnt.
Ähnlich alt sehen inzwischen ein paar Gewohnheiten aus der Anfangszeit aus. Anweisungen in Großbuchstaben, „loop until done“ im Prompt oder der Subagent als Mittel für bessere Antworten stehen alle in Anthropics Liste der Ratschläge, die man streichen sollte.
Der Max-Plan rechnet nicht anders
Mein Bauchgefühl im Mai war, dass der Token-Verbrauch im Max-Plan anders gestaffelt sei als in den günstigeren Tarifen. Die Recherche hatte das damals schon widerlegt, und daran hat sich nichts geändert. Derselbe Prompt mit denselben Dateien verbraucht in Pro, Max 5x und Max 20x gleich viele Tokens, nur der Pool, gegen den sie laufen, ist größer. Es gibt ein Session-Fenster und ein Wochenlimit, beide gelten für alle Modelle gemeinsam, dazu kommen die eigenen Limits für Opus und Sonnet. Feste Token-Zahlen für diese Limits nennt Anthropic in der Claude-Code-Doku nicht.
Einen Vorteil hat das Abo beim Cache. Er hält eine Stunde statt fünf Minuten, kurze Pausen kosten deshalb kaum etwas. Das gilt nur innerhalb der Plan-Usage, wer über das Limit hinaus mit Usage Credits weiterarbeitet, fällt auf den Fünf-Minuten-Cache zurück. Mein Eindruck der „anderen Staffelung“ war damit vermutlich schlicht Pool-Größe, mein Nutzungsprofil aus einzelnen Anwendungen und mittellangen Sessions lief im Mai einfach nicht in die Limits.
Kleiner hotter Take zum Schluss: Die wirksamsten Hebel kosten nichts und stehen in der Doku – /clear, eine kurze CLAUDE.md, ein bewusst gewähltes Modell mit passendem Effort. Neu ist, dass /usage heute zeigt, welcher davon im eigenen Setup am meisten bringt. Und wer in einer Tipp-Liste eine Datei mit plausibel klingendem Namen empfohlen bekommt, schaut besser kurz nach, ob Claude Code sie überhaupt kennt. Das hätte ich im Mai auch tun sollen.