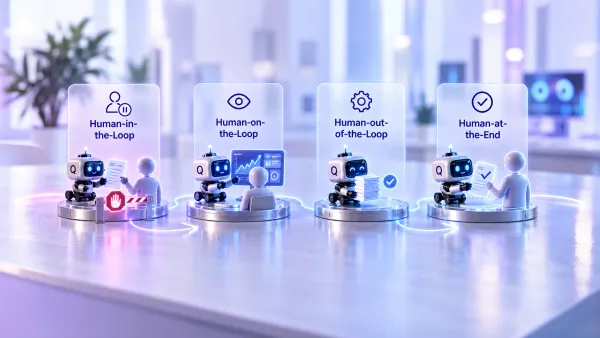
Human Oversight im Loop Engineering: in, on, at-the-End oder out?
Human-in-, on-, at-the-End oder out-of-the-Loop: Wo menschliche Kontrolle in Agentenprozessen wirklich wirkt und wann der Freigabe-Button nur Governance-Dekoration ist.
Wie man Modelle so füttert, dass etwas Brauchbares rauskommt. Prompt-Strategien, Context-Engineering und der Aufbau verlässlicher KI-Systeme.
17 Beiträge
Leitfaden Prompt Engineering und Context Engineering Begriffe, Vergleich und Praxis: Prompting als System statt als Einzelanweisung. Zum Guide
Human-in-, on-, at-the-End oder out-of-the-Loop: Wo menschliche Kontrolle in Agentenprozessen wirklich wirkt und wann der Freigabe-Button nur Governance-Dekoration ist.
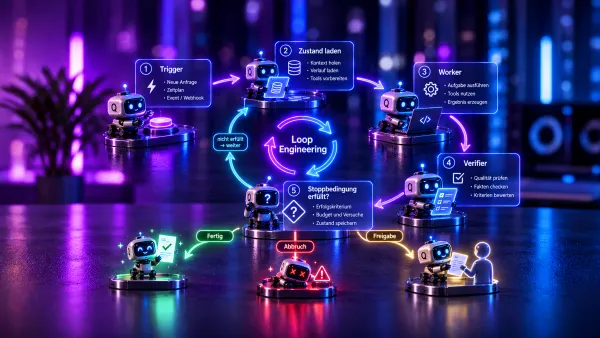
Loop Engineering ersetzt den nächsten manuellen Prompt durch ein System aus Triggern, Verifikation, Zustand und Grenzen. Was daran Substanz hat und wo nur ein neues Label auf alten Mechaniken klebt.
Drei aktuelle Studien zeigen dasselbe Muster: Bei KI-Agenten entscheiden Datenqualität, enger Scope und klare Ownership oft mehr als die Modellwahl. Was McKinsey, Salesforce und Teradata dazu messen – und welche drei Fragen vor dem Modellnamen gehören.
Fünf Prompt-Vorlagen für die Aufgaben, die im Arbeitsalltag ständig anfallen: Extraktion, Klassifikation, Analyse, Recherche und Texte. Zum Kopieren, Anpassen und Weitergeben ans Team – plus die zwei Querschnittsregeln, die jede Vorlage besser machen.

Reasoning-Modelle wollen anders angesprochen werden als klassische LLMs – wer beide gleich promptet, verschenkt Qualität oder Geld. Wann welcher Modelltyp die richtige Wahl ist, was ihm hilft, was ihm schadet und welche Few-Shot-Regeln 2026 gelten.

CO-STAR, RISEN, RTF – die Akronym-Frameworks von 2023 sind Checklisten, keine Best Practice mehr. Was moderne LLMs stattdessen brauchen, welche Prompt-Tricks du streichen kannst und eine Vorlage, die du direkt an dein Team weiterreichen kannst.

Reasoning ist zum Default geworden – bezahlt wird jeder Denk-Token zum Output-Preis. Warum die Mehrheit der KMU-Aufgaben kein Denkmodell braucht, wo Reasoning wirklich trägt und wie du mit drei Fragen routest, statt Dauervollgas zu bezahlen.
Marker, Validierungs-Rollen, ein Tribunal aus fünf simulierten Experten: Viele Prompts sollen sich selbst prüfen. Nur sichert die Hälfte davon nichts ab. Drei Sorten QA-Gates, sortiert nach Wirkung – und warum das stärkste nie dasselbe Modell auswertet, das den Text geschrieben hat.
Jeder produktive Prompt wandert bei mir in ein Git-Repo – mit SemVer, manuellem Changelog und Doku außerhalb des Prompts. Warum das mehr ist als Ordnungsliebe, was Regressionstests realistisch leisten und ab wann Git allein nicht mehr reicht.
Context Engineering ist die Disziplin hinter zuverlässigen KI-Systemen – und Prompt Engineering nur ein Baustein davon. Woher der Begriff kommt, warum mehr Kontext nicht automatisch besser ist und was das für KMU heißt.