Seit 2012 im Online-Marketing. Heute: Prompt Engineering, KI-Agenten und Automatisierung im Agenturalltag. Was davon wirklich funktioniert – und was nicht – steht hier.
Claude Haiku 5.5 kostet über die API bei Prompts bis 100.000 Tokens ein Zehntel des Tokenpreises von Haiku 4.5 und springt bei Artificial Analysis von 17 auf 43 Punkte. Die 43 gelten für Max-Effort, voreingestellt ist Medium. Was das Modell für Tool-Use und Subagents taugt.
Claudes neue Projekte verteilen Arbeit über einen Koordinator an Threads in der Cloud. Wie sich Ziel, Projektanweisungen und CLAUDE.md sauber trennen lassen – und warum der lokale MCP erst mal weg ist.
Sonnet 5.5, GPT-6.1 Sol und Gemini 4 Argon in einer Woche, dazu ein vollgepackter OpenAI DevDay mit Dots, MCP Extensions und MCP Events. Außerdem: Claude Code Mods, AG-UI 1.0, Vast-10M mit 10 Mio. Tokens Kontext und die Frage, wer haftet, wenn Agenten fremde Systeme hacken.
Googles neues Spitzenmodell Gemini 4 Argon schreibt bis zu 1 Mio. Tokens und glänzt in Herstellerbenchmarks. Nutzen dürfen es vorerst nur Cyber-Verteidiger, und laut Bloomberg zweifeln Google-Mitarbeitende am Frontend-Coding. Eine Einordnung der Papierlage.
GPT-6.1 Sol kommt sieben Tage nach GPT-6 Sol, zum gleichen Tokenpreis und mit halbiertem Cache-Preis. Ich hätte das fast als Iteration abgehakt. Artificial Analysis misst allerdings bis zu acht Punkte mehr, am deutlichsten auf Low und Medium.
Claude Sonnet 5.5 kostet so viel wie Sonnet 5 und liegt in Benchmarks nah an Opus 5.5. Artificial Analysis setzt ein Sternchen dran, und der Developer-Guide zeigt, wofür Anthropic das Modell wirklich sieht: als Arbeitspferd für wiederkehrende Agenten-Tasks.
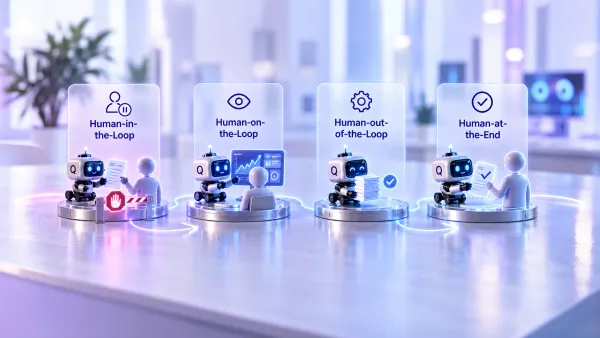
Human-in-, on-, at-the-End oder out-of-the-Loop: Wo menschliche Kontrolle in Agentenprozessen wirklich wirkt und wann der Freigabe-Button nur Governance-Dekoration ist.
Opus 5.5 und GPT-6 Sol/Luna erscheinen am selben Tag und drücken die API-Preise. Dazu Grok 4.7, Xiaomis MiMo-V2.6 als Open Weights, eine Welle an Sprach- und TTS-Modellen, die nächste Irregular-Panne und Werkzeuge von AX bis OpenWiki.
OpenAI bringt GPT-6 Sol und Luna und senkt die API-Preise deutlich. Der Artificial-Analysis-Index bewegt sich kaum, einzelne Task-Evals schon. Was davon für Agenten und Pipelines zählt.
Anthropic bringt Claude Opus 5.5 auf Fable-5.1-Niveau mit 40 % weniger Betriebskosten. Artificial Analysis sieht das Modell im Intelligence Index vorn und misst auf Medium fast exakt diese Ersparnis gegenüber Opus 5. Preise, Benchmarks, Safeguards und was ich als Nächstes damit teste.