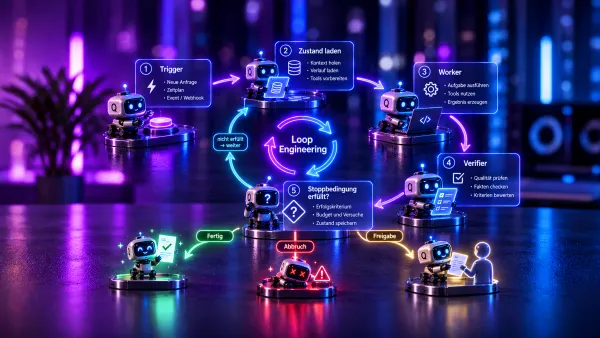
Loop Engineering: Der Agent ist nicht der Prozess
Loop Engineering ersetzt den nächsten manuellen Prompt durch ein System aus Triggern, Verifikation, Zustand und Grenzen. Was daran Substanz hat und wo nur ein neues Label auf alten Mechaniken klebt.
Loop Engineering ersetzt den nächsten manuellen Prompt durch ein System aus Triggern, Verifikation, Zustand und Grenzen. Was daran Substanz hat und wo nur ein neues Label auf alten Mechaniken klebt.
Jev von TypeSafe schreibt keinen Text, nur Wahrscheinlichkeiten – und soll 400-mal billiger sein als ein LLM. Was an dem Hype dran ist, wann 30 Zeilen Python die bessere Wahl bleiben, wofür Jev taugt und wie ein Einsatz mit personenbezogenen Daten in Deutschland aussieht.
Harness-Woche: Antigravity und Muse Code sandboxen per Default, DeepSeek Harness liefert im Tagesrhythmus, Zed will PRs abschaffen. Dazu Gemini 3.8 Live, ein Stealth-Modell, ChatGPT-Entitäten für lokale Firmen, die Claude/Cowork-Fusion und ein Rant über Token-Verbrennung.
Genannt, empfohlen, zitiert – drei verschiedene Dinge. Was KI-Sichtbarkeit für dein KMU wirklich bedeutet, welche Faktoren belegt wirken, wie sich ChatGPT, Gemini, Claude und Google unterscheiden und was man technisch selbst in der Hand hat.
Ruhige Modellwoche mit ein paar Highlights: DeepSeek V4.1-Flash und Mercury 2.5 drücken die Preise, Cognition SWE-2 kratzt an Fable 5.1, Sakana Fugu setzt auf Orchestrierung – dazu drei frische OpenAI-Releases.
Die llms.txt gilt vielen als Pflicht für die KI-Sichtbarkeit. Ich habe drei Monate Server-Logs von fünf Websites mit Logwerk ausgewertet: Kein einziger Search- oder AI-Bot ruft die Datei ab. Google ignoriert sie offiziell. Wo sie trotzdem taugt und wo nicht.
GPT-6 Astra, Claude Fable 5.1, Muse Spark 1.3 und Gemini 3.8 Flash in vier Tagen, dazu Qwen3.8-Max-0902, iFlyteks Spark-X2.5, Quasar 438B mit chinesischem Motor, Metas Transkriptionsmodell für 0,18 $ die Stunde und drei Handwerksstücke zu Agenten-Infrastruktur.
GPT-6 Astra löst GPT-5.6 Sol als OpenAIs Spitzenmodell ab. Der Sprung liegt bei Computer Use, langen Codex-Sessions und Cyber-Fähigkeiten – nicht im unabhängigen Intelligence Index. Die Tokenpreise steigen auf das 2,5-Fache, die Kosten pro Aufgabe nicht überall.
Gemini 3.8 Flash legt bei Agenten und Coding zu. Warum gleicher Tokenpreis nicht gleiche Kosten bedeutet, was die Time per Task verrät und welche Thinking-Stufe für produktive Workflows taugt.
Meta legt Muse Spark 1.3 nach. Artificial Analysis misst einen klaren Sprung bei Agenten-Aufgaben – bei unverändert niedrigen Tokenpreisen. Warum das Modell bei mir auf die Testliste kommt.