Prompt Engineering und Context Engineering: Prompting als System
Prompt Engineering, Context Engineering, Harness- und Loop Engineering sind Schichten, keine Ablösungen. Was ein Prompt 2026 noch leistet, warum der Kontext den größeren Hebel hat und wo Graph Engineering steht – die Übersicht mit allen Beiträgen.
Zuletzt aktualisiert
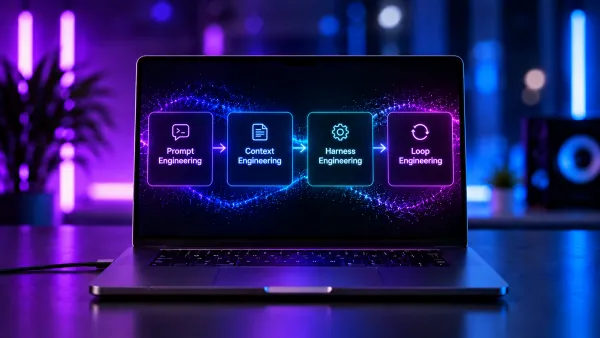
Vor drei Jahren war „Prompt Engineering“ das Versprechen, dass man mit dem richtigen Satz alles aus einem Sprachmodell herausholt. Es gab Kurse, Zertifikate und Akronym-Frameworks, die man auswendig lernen sollte. Die Definition steht heute noch bei Wikipedia und IBM, aber die Praxis ist weitergezogen – erst zu Context Engineering, dann zu Harness- und Loop Engineering, und seit August 2026 kursiert mit Graph Engineering ein weiterer Begriff aus der Forschung.
Das Problem an dieser Begriffsleiter ist nicht, dass sie falsch wäre. Es ist, dass jede Stufe als Ablösung der vorherigen verkauft wird, während sie in Wirklichkeit eine Schicht darüber ist. Der Prompt ist nicht tot. Er ist nur nicht mehr die Stellschraube, an der die Qualität hängt.
Diese Seite sortiert Prompting einmal von unten nach oben – was ein Prompt 2026 noch leistet, warum Reasoning-Modelle die alten Regeln kippen, was Context Engineering davon übrig lässt, und ab wann die Frage nicht mehr lautet „wie formuliere ich das“, sondern „wer oder was formuliert das eigentlich“.
TL;DR
Prompt Engineering, Context Engineering, Harness- und Loop Engineering sind keine Ablösungen, sondern Schichten. Jede umschließt die vorherige. Wer 2026 noch an der Formulierung feilt, arbeitet an der untersten.
- Prompt Engineering steuert die Ausgabe eines Modells, ohne seine Gewichte zu ändern. Das gilt weiterhin – nur wirken die Techniken von 2023 auf Reasoning-Modellen oft nicht mehr oder schaden.
- Context Engineering (Begriff seit Juni 2025) meint alles, was im Kontextfenster landet – System-Prompt, Verlauf, abgerufene Dokumente, Tools, Ausgabeformat. Der Prompt ist darin ein Baustein.
- Harness- und Loop Engineering (2026) verschieben die Arbeit vom Formulieren zum Bauen – Werkzeuge, Prüfschritte, Schleifen, die den Agenten selbst prompten.
- Graph Engineering ist ein Forschungsvorschlag vom August 2026, kein Praxisstandard.
- Für KMU zählt vor allem die zweite Schicht. Die meisten Qualitätsprobleme sitzen im Kontext, nicht im Prompt.
Was Prompt Engineering 2026 noch ist
Die nüchternste Definition kommt vom Fraunhofer IESE. Prompt Engineering umfasst demnach Techniken, „die darauf abzielen, die Ausgabe eines Sprachmodells zu steuern und zu verbessern …, ohne die internen (trainierten) Gewichte des Modells zu verändern“. Das schließt den einzelnen Chat-Prompt genauso ein wie Few-Shot-Beispiele, Chain-of-Thought oder das Anbinden externer Quellen. Als Definition trägt das noch. Als Handlungsanweisung taugt es nicht mehr, und das liegt an den Modellen.
Die Techniken, die 2023 messbar etwas brachten – Rollenzuweisung, Denkanweisungen, harte Constraints –, wurden für Modelle entwickelt, die ohne Hilfe nicht planen konnten. Reasoning-Modelle tun das intern. Wer ihnen trotzdem vorschreibt, wie sie zu denken haben, engt ihren Suchraum ein. Ich habe das an drei Stellen einzeln auseinandergenommen. Der Rollenbaustein beeinflusst nur noch den Stil, nicht die Qualität, Constraint-Based Prompting kehrt sich auf Reasoning-Modellen ins Gegenteil, und Metacognitive Scaffolding hat seinen Job gewechselt – vom Denkgerüst zum Output-Vertrag.
Was davon bleibt: Ziel klar benennen, Ausgabeformat festlegen, Beispiele nur dort, wo das Modell den Stil nicht erraten kann. Die Akronym-Frameworks aus 2023 sind Checklisten geblieben, keine Best Practice. Und die Prompt-Vorlagen fürs Team, die ich weitergebe, sind deshalb kürzer als das, was ich vor zwei Jahren verteilt habe.
Reasoning-Modelle oder nicht: der Modelltyp entscheidet über den Prompt
Bevor du an einem Prompt arbeitest, lohnt eine andere Frage. Welches Modell steht dahinter? Ein Reasoning-Modell und ein klassisches LLM brauchen unterschiedliche Prompts – wer beide gleich anspricht, verschenkt entweder Qualität oder Geld. Reasoning-Modelle wollen das Ziel und die Kriterien, nicht den Weg. Non-Reasoning-Modelle brauchen den Weg, weil sie ihn nicht selbst finden.
Dazu kommt, dass Reasoning kein Qualitätsmodus ist. Für Extraktion, Klassifikation und Formatierung ist ein schnelles Modell mit knappem Prompt die bessere Wahl, für mehrstufige Analyse das Denkmodell mit offenem Ziel. Die Entscheidung fällt vor dem Prompt, nicht in ihm.
Und dann gibt es Effekte, die kein Prompt der Welt behebt. Wenn einem Modell bei der zwanzigsten Variante die Ideen ausgehen, liegt das am Training, nicht an deiner Formulierung. Mode Collapse heißt das. Verbalized Sampling hilft, aber es ist ein Workaround um eine Eigenschaft des Modells herum – kein Prompt-Trick.
Context Engineering: der Prompt wird zum Baustein
Am 25. Juni 2025 schrieb Andrej Karpathy auf X:
+1 for ‚context engineering‘ over ‚prompt engineering‘.
Sein Argument war, dass die meisten mit einem Prompt die kurze Aufgabenbeschreibung aus dem Alltag verbinden, während in jeder ernsthaften LLM-Anwendung die eigentliche Arbeit darin besteht, das Kontextfenster mit genau der richtigen Information zu füllen – „the delicate art and science of filling the context window with just the right information“. Tobi Lütke von Shopify hatte kurz davor ähnlich formuliert, und Phil Schmid lieferte am 30. Juni die brauchbarste Definition nach. Context Engineering ist demnach:
the discipline of designing and building dynamic systems that provides the right information and tools, in the right format, at the right time.
Was in dieses Kontextfenster gehört, ist mehr als der Prompt. Schmid zählt sieben Bestandteile auf, nämlich System-Prompt, User-Prompt, Verlauf, Langzeit-Memory, abgerufene Dokumente, verfügbare Tools und das Ausgabeformat. Der Prompt ist einer davon. Warum Prompt Engineering nur ein Baustein bleibt, habe ich ausführlich beschrieben. Kurz gesagt entstehen die meisten Fehler, die ich in produktiven Pipelines sehe, nicht durch schlechte Formulierungen, sondern durch falschen, fehlenden oder zu viel Kontext.
Zu viel ist dabei der unterschätzte Fall. Anthropic beschreibt in seinem Leitfaden zum Context Engineering vom September 2025 das Phänomen Context Rot – je mehr Tokens im Fenster liegen, desto schlechter erinnert das Modell einzelne davon. Die Empfehlung lautet deshalb nicht „gib ihm alles“, sondern „gib ihm die kleinste Menge an Tokens mit hohem Signal“. Daraus folgen Techniken wie Compaction, Just-in-Time-Retrieval statt Vorab-Laden und Sub-Agenten mit eigenem, sauberem Kontext.
Zwei Dinge aus dieser Schicht sind handfest und sofort umsetzbar. Erstens das Format. Ob du dem Modell JSON, YAML, XML oder TOON in den Kontext legst, entscheidet über Token-Kosten und Fehlerquote, und die Antwort hängt vom Modell und vom Anwendungsfall ab. Zweitens das Ausgabeformat als Vertrag – nicht als Bitte im Prompt, sondern als Structured Output, den das Modell technisch nicht umgehen kann.
Harness- und Loop Engineering: was um das Modell herum passiert
Ab hier verlässt die Arbeit den Prompt endgültig. Der Begriff Harness meint alles in einem KI-Agenten außer dem Modell selbst – Werkzeuge, Rechte, Prüfschritte, Speicher, Sandbox. Birgitta Böckeler von Thoughtworks hat das im April 2026 auf martinfowler.com für Coding-Agenten beschrieben, und ihr Satz dazu verbindet die Schichten sauber, ohne einen Bruch zu behaupten:
Engineering a user harness for a coding agent is a specific form of context engineering.
Wie weit das gehen kann, hat OpenAI im Februar 2026 vorgeführt. Ein Team von anfangs drei Leuten hat über fünf Monate rund eine Million Zeilen Code und 1.500 Pull Requests produziert, ohne eine einzige Zeile von Hand zu schreiben. Die Arbeit der Entwickler bestand darin, den Agenten arbeitsfähig zu machen. Herstellerbericht, keine unabhängige Messung – aber die Richtung ist unstrittig, und Lilian Weng hat sie im Juli in ihrem Blog auf einen Satz gebracht – das Optimierungsziel wandert von
instruction prompts → structured context → workflow → harness code → optimizer code.
Loop Engineering ist die Etage darüber. Der Begriff stammt von Addy Osmani und ist auf den Tag datierbar, den 7. Juni 2026, ausgelöst durch einen Satz von Boris Cherny, der bei Anthropic Claude Code verantwortet.
„I don’t prompt Claude anymore. I have loops running that prompt Claude and figuring out what to do. My job is to write loops.
Osmani leitet daraus ab, dass Loop Engineering heißt, sich selbst als denjenigen zu ersetzen, der den Agenten promptet, und stattdessen das System zu bauen, das es tut. Mit Automationen auf Zeitplan, isolierten Worktrees, Skills, Sub-Agenten und einem persistenten Zustand, der weiß, was erledigt ist.
Bevor das als neue Disziplin durchgeht, ein kleiner Fallstrick: Eine Schleife, die ein Modell aufruft und das Ergebnis prüft, ist ein Muster, das älter ist als jedes LLM. Neu ist nur das Tooling drumherum. Ich halte den Begriff trotzdem für nützlich, weil er die richtige Frage stellt – nicht „wie formuliere ich“, sondern „was prüft das Ergebnis, bevor es weitergeht“. Genau da liegt die Substanz. Welche QA-Gates in einer LLM-Pipeline wirklich halten, habe ich durchgetestet, und das stärkste sitzt außerhalb des Modells. Wer seine Anforderungen als Spezifikation statt als Prompt ablegt, baut den ersten Baustein eines Harness. Und wer produktive Prompts wie Code versioniert, merkt schnell, dass der Prompt selbst der kleinste Teil des Repos ist.
Graph Engineering: ein Ausblick mit Datum
Am 21. August 2026 erschien auf arXiv ein Preprint mit 35 Autoren, das die Begriffsleiter ausdrücklich fortschreibt: „Graph Engineering in the Era of LLM Agents“. Die Autoren ordnen Prompt-, Context-, Harness- und Loop Engineering als Stufen ein, die einzelne Agenten besser machen, und behaupten eine Grenze. Ein Agent allein reicht demnach nicht mehr. Aufgaben mit heterogenem Fachwissen, voneinander abhängigen Teilschritten, paralleler Ausführung und unabhängiger Prüfung übersteigen das, was ein einzelner Agent organisieren kann. Ihre Antwort sind explizite, dynamische Graphen, die Aufgaben, Agenten und Systemzustände abbilden – „System Intelligence“ statt Einzelintelligenz.
Das ist ein Forschungsvorschlag, kein Praxisstandard. Das Paper ist erst einige Wochen alt, ohne Peer-Review, und außerhalb der Autorengruppe verwendet den Begriff bisher kaum jemand. Die Idee dahinter ist allerdings älter als der Name. Wer Agenten-Workflows als gerichtete Graphen mit Zustand baut, macht das seit LangGraph und Konsorten. Dass die Forschung dafür jetzt eine eigene Stufe aufmacht, sagt vor allem etwas darüber, wo die Komplexität hingewandert ist – weg vom einzelnen Aufruf, hin zur Organisation vieler Aufrufe.
Ich nehme den Begriff deshalb hier auf, aber mit Datum. Wenn er sich in einem Jahr in Stellenanzeigen wiederfindet, war das Paper früh dran. Wenn nicht, war es ein Etikett.
Die Schichten im Vergleich
| Prompt Engineering | Context Engineering | Harness Engineering | Loop Engineering | Graph Engineering | |
|---|---|---|---|---|---|
| Was wird gestaltet | die einzelne Anweisung an das Modell | alles, was im Kontextfenster landet | alles um das Modell herum – Tools, Rechte, Prüfschritte, Speicher | das System, das den Agenten wiederholt promptet und prüft | Graphen aus Aufgaben, Agenten und Zuständen über viele Agenten hinweg |
| Kernfrage | Wie formuliere ich das? | Was weiß das Modell in diesem Moment? | Was darf und kann der Agent? | Wer promptet den Agenten, wenn ich es nicht mehr tue? | Wie organisieren sich viele Agenten zu einem Ergebnis? |
| Begriff seit | 2022/2023 | Juni 2025 (Lütke, Karpathy, Schmid) | Anfang 2026 (OpenAI, Böckeler) | 7. Juni 2026 (Osmani, nach Cherny) | 21. August 2026 (arXiv-Preprint) |
| Reifegrad | etabliert, Techniken von 2023 teils überholt | etabliert, Konsens über die Definition | Praktiker-Begriff aus dem Coding-Agent-Umfeld | Praktiker-Begriff, Tooling jung | Forschungsvorschlag ohne Peer-Review |
| Typische Werkzeuge | Vorlagen, Few-Shot, Ausgabeformat | RAG, Compaction, Memory, Structured Output | Sandbox, MCP, Guardrails, Evals | Automationen, Worktrees, Sub-Agenten, persistenter State | Orchestrierungs-Frameworks, Zustandsgraphen |
| Hebel für KMU | klein – eine Stunde Einarbeitung reicht | groß – hier sitzen die meisten Fehler | mittel – ab dem ersten produktiven Agenten | mittel – ab täglichen Durchläufen ohne Aufsicht | derzeit keiner |
Woran du erkennst, auf welcher Schicht das Problem liegt
Die Schichten helfen vor allem bei der Diagnose, denn die meisten Leute reparieren am Prompt herum, obwohl der Fehler zwei Etagen höher sitzt. Ein paar Muster, die ich immer wieder sehe.
Wird dasselbe Ergebnis mit einem Wechsel des Modelltyps schlagartig besser – Reasoning statt schnell oder umgekehrt –, lag das Problem in der ersten Schicht. Der Prompt passt nicht zum Modelltyp, meist weil er einem Reasoning-Modell den Weg vorschreibt oder einem schnellen Modell zu viel Spielraum lässt. Ignoriert das Modell angehängtes Material, widerspricht es sich nach einer halben Stunde selbst oder wird in einem langen Verlauf immer flacher, ist es die zweite. Zu viel oder falscher Kontext, Context Rot, kein sauberer Neustart. Läuft das Ergebnis im ersten Durchlauf sauber, aber niemand schaut beim zehnten noch hin, und beim fünfzigsten ist etwas Falsches in der Datenbank gelandet, dann fehlt alles, was über dem Kontext liegt – ein Prüfschritt außerhalb des Modells und eine Schleife, die ihn erzwingt.
Diese Zuordnung dauert fünf Minuten. Sie spart die Stunden, in denen man Synonyme im Prompt austauscht und hofft.
Was davon für dein Unternehmen zählt
Für die meisten KMU, mit denen ich zu tun habe, ist die Antwort ernüchternd einfach. Die Schicht mit dem größten Hebel ist die zweite. Nicht der Prompt, noch nicht die Schleife. Der Kontext.
Die typischen Fehler sehen so aus: Ein Mitarbeiter kopiert einen Prompt aus einer Vorlage, hängt ein 40-seitiges PDF an und wundert sich über eine oberflächliche Antwort. Oder eine Automatisierung schiebt bei jedem Aufruf den kompletten Gesprächsverlauf mit und wird nach zwanzig Schritten unbrauchbar. In beiden Fällen ist der Prompt nicht das Problem. Das Problem ist, was sonst noch im Kontextfenster liegt.
Prompt Engineering im Sinne von 2023 – Kurse, Zertifikate, Framework-Poster – ist für ein Unternehmen keine Investition mehr wert. Was sich lohnt, ist eine Stunde darüber, welches Modell für welche Aufgabe passt, ein Ausgabeformat, das technisch erzwungen wird, und ein Prüfschritt außerhalb des Modells, bevor ein Ergebnis irgendwo landet. Harness und Schleife kommen, sobald dieselbe Aufgabe täglich läuft und ein Mensch nicht mehr jeden Durchlauf anschauen will. Vorher sind sie Overhead, den sich niemand leisten muss.
Take dazu: Der Prompt ist die Schicht, an der jeder anfängt, und die Schicht, an der niemand bleiben sollte. Alles darüber ist KI-Systemdesign. Genau darum geht es auf diesen Seiten.
FAQ
Was ist Prompt Engineering?
Prompt Engineering umfasst alle Techniken, die die Ausgabe eines Sprachmodells steuern, ohne das Modell selbst zu verändern – von der Formulierung einer Anweisung über Beispiele bis zum vorgegebenen Ausgabeformat. Die Definition gilt weiterhin; viele Techniken von 2023 wirken auf Reasoning-Modellen aber nicht mehr oder schaden.
Ist Prompt Engineering tot?
Nein. Es ist die unterste Schicht geworden. Context Engineering, Harness- und Loop Engineering bauen darauf auf, sie ersetzen den Prompt nicht. Was überholt ist, sind Akronym-Frameworks, Rollenzuweisungen und harte Denkanweisungen für Modelle, die selbst planen.
Was ist der Unterschied zwischen Prompt Engineering und Context Engineering?
Prompt Engineering gestaltet die Anweisung. Context Engineering gestaltet alles, was das Modell im Moment der Anfrage sieht – System-Prompt, Verlauf, abgerufene Dokumente, verfügbare Tools, Ausgabeformat. Der Prompt ist darin ein Baustein von sieben.
Was bedeutet Loop Engineering?
Loop Engineering meint, das System zu bauen, das einen Agenten wiederholt promptet, prüft und weiterarbeiten lässt, statt ihn selbst Schritt für Schritt anzuleiten. Der Begriff stammt von Addy Osmani (Juni 2026) und geht auf einen Satz von Boris Cherny zurück: „My job is to write loops.“
Was ist Graph Engineering?
Graph Engineering ist ein Vorschlag aus einem arXiv-Preprint vom August 2026. Gemeint sind explizite, dynamische Graphen, die Aufgaben, Agenten und Systemzustände abbilden, damit viele Agenten gemeinsam ein Ergebnis erarbeiten. Das Paper hat kein Peer-Review, der Begriff ist außerhalb der Forschung kaum in Gebrauch.
Lohnt sich ein Prompt-Engineering-Kurs für mein Unternehmen?
Im Sinne von 2023 – Frameworks, Zertifikate, Prompt-Poster – nicht mehr. Der größere Hebel liegt im Kontext: welches Modell für welche Aufgabe, welches Ausgabeformat, welcher Prüfschritt außerhalb des Modells. Das lässt sich in einer Stunde erklären und ohne Kurs umsetzen.