Human Oversight im Loop Engineering: in, on, at-the-End oder out?
Human-in-, on-, at-the-End oder out-of-the-Loop: Wo menschliche Kontrolle in Agentenprozessen wirklich wirkt und wann der Freigabe-Button nur Governance-Dekoration ist.
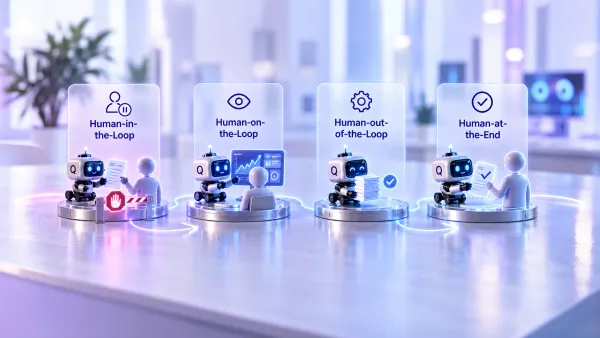
Ein Mensch klickt auf „Freigeben“. Damit ist Human-in-the-Loop eingebaut, Human Oversight erledigt, das Governance-Häkchen gesetzt und alle schlafen etwas besser. Zumindest solange, bis jemand fragt, was dieser Mensch eigentlich gesehen hat, ob er genug Zeit zum Prüfen hatte und ob die Mail nicht längst raus war.
Im vorherigen Artikel über Loop Engineering ging es um Trigger, Verifikation, Zustand und Stoppbedingungen. Der Agent war dort ein Teil des Prozesses, nicht der Prozess selbst. Offen blieb die Stelle, an der Menschen in diesen Ablauf gehören. „Mit menschlicher Aufsicht“ beschreibt allerdings noch keine Architektur.
Prompt Engineering, Context Engineering und Harness sind die unteren Ebenen, der Loop liegt eine Etage darüber. Human Oversight liegt quer dazu: Der Mensch kann einen einzelnen Tool-Aufruf freigeben, einen laufenden Prozess überwachen, nur die Veröffentlichung kontrollieren oder im einzelnen Run gar nicht auftauchen. Das Risiko entscheidet über die Variante und nicht die eine Slide im Strategie-Meeting.
TL;DR
- Beim Human-in-the-Loop stoppt der Run und wartet auf eine menschliche Entscheidung.
- Beim Human-on-the-Loop läuft der Prozess weiter, solange der Mensch nicht eingreift.
- Beim Human-at-the-End ist die Arbeit erledigt, die letzte folgenreiche Aktion bleibt aber bis zur Freigabe blockiert.
- Beim Human-out-of-the-Loop ist im einzelnen Run keine menschliche Entscheidung vorgesehen.
- Je schlechter ein Ergebnis prüfbar, je schwerer eine Aktion umkehrbar und je höher ihr Schadenspotenzial ist, desto früher gehört der Mensch in den Loop.
Vier Positionen im Loop – keine vier Glaubensrichtungen
Die Begriffe beschreiben, wo Menschen einen konkreten Agent-Loop kontrollieren. Sie sind keine vier vollständigen Systemarchitekturen und schließen sich auch nicht gegenseitig aus. Entscheidend ist, was ohne menschliche Reaktion passiert.
| Modell | Was passiert ohne menschliche Reaktion? | Rolle des Menschen | Typischer KMU-Einsatz |
|---|---|---|---|
| Human-in-the-Loop | der Run stoppt an einem Gate | prüfen, ändern, freigeben oder ablehnen | Zahlung, Vertragsantwort, Deployment |
| Human-on-the-Loop | der Prozess läuft innerhalb seiner Grenzen weiter | beobachten, stoppen oder eskalieren | Support-Triage, Kampagnen-Monitoring |
| Human-at-the-End | die Arbeit ist fertig, die Außenwirkung bleibt blockiert | Ergebnis final freigeben | Newsletter, Angebot, Veröffentlichung |
| Human-out-of-the-Loop | der Run wird ohne Einzelfreigabe abgeschlossen | Grenzen vorab bauen und später auditieren | Klassifikation, Formatprüfung, Read-only-Recherche |
Human-in-, on- und out-of-the-Loop sind in Forschung und Praxis gebräuchliche Perspektiven. Human-at-the-End ist dagegen kein wirklich etablierter Fachbegriff. Ich verwende ihn hier als praktisches Label für einen nützlichen Sonderfall: Das System arbeitet bis zum fertigen Ergebnis autonom, aber Veröffentlichung, Versand oder Übergabe warten auf eine menschliche Freigabe. Technisch ist das meist ein spätes Human-in-the-Loop-Gate. Die eigene Bezeichnung beschreibt seine betriebliche Bedeutung, nicht mehr.
Eine im Juni 2026 veröffentlichte Interviewstudie mit 17 erfahrenen Entwickler*innen fand ohnehin eine andere, zeitliche Aufteilung der Aufsichtsarbeit: Kontrolle vorab, gemeinsames Planen, Echtzeit-Monitoring und nachträgliche Prüfung. Das widerspricht den vier Begriffen nicht. Es zeigt nur, dass es keine amtliche Vier-Schubladen-Lehre gibt.
Human-in-the-Loop: Die Aktion wartet wirklich
Beim Human-in-the-Loop hält der Run an einem definierten Gate an. Erst nach Freigabe darf der Agent eine Mail senden, einen Datensatz ändern, Geld bewegen, Code deployen oder eine andere Aktion mit Folgen ausführen.
Das Gate muss vor der Aktion liegen. Klingt banal, wird aber gern umso kreativer ausgelegt. Wenn der Agent die Kundenmail bereits verschickt hat und jemand sie später im Log liest, war der Mensch nicht in diesem Loop, er war in der Schadensdokumentation.
Technisch braucht ein brauchbares Gate mehr als einen Button. Der Prozess muss seinen Zustand dauerhaft speichern, damit er nach der Entscheidung an derselben Stelle weiterläuft. Wer prüft, sollte mindestens die geplante Aktion, ihre Argumente, relevante Quellen, mögliche Auswirkungen und die erlaubten Entscheidungen sehen. In der Deep-Agents-Doku von LangChain zu Human-in-the-Loop gehören deshalb ein Checkpointer und die Entscheidungen Approve, Edit, Reject und Respond zusammen. Das ist eine Framework-Umsetzung und kein allgemeiner Standard, aber das Muster dahinter stimmt.
Für ein KMU bedeutet Human-in-the-Loop vor allem kontrollierten Durchsatz. Ein Support-Agent kann einen Erstattungsfall vollständig vorbereiten, darf die Gutschrift oberhalb eines Grenzwerts aber erst nach Freigabe auslösen. Im Deployment kann ein Coding-Agent Tests ausführen und Änderungen vorschlagen, während der produktive Rollout wartet. Der Mensch entscheidet nicht über jeden Arbeitsschritt, sondern über die Aktion, deren Fehler teuer wird, oder die allein schon aus rechtlicher Sicht einer finalen menschlichen Entscheidung bedarf.
Die prüfende Person braucht auch echte Macht. „Ablehnen“ darf nicht bedeuten, dass der Agent denselben Aufruf drei Sekunden später leicht umformuliert erneut versucht. Die Entscheidung muss den Tool-Call, den Run oder die zugrunde liegende Policy verändern können. Sonst beschäftigt das System Menschen, ohne sich von ihnen kontrollieren zu lassen – eine erstaunlich menschliche Organisationsidee.
Human-in-the-Loop passt, wenn eine einzelne Aktion schwer umkehrbar ist oder unmittelbaren Schaden anrichten kann. Es passt eher nicht zu hundert banalen Entscheidungen pro Stunde. Wer jede harmlose Leseoperation freigeben lässt, trainiert Menschen auf reflexhaftes Klicken. Das Gate bleibt formal erhalten und verliert damit praktisch seinen Zweck.
Human-on-the-Loop: Aufsicht scheitert gern an Aufmerksamkeit
Beim Human-on-the-Loop läuft der Prozess selbstständig. Menschen sehen Traces und Kennzahlen, erhalten Warnungen und können eingreifen. Das ergibt Sinn, wenn einzelne Fehler begrenzte Folgen haben, das Volumen hoch ist und Abweichungen maschinell erkennbar sind.
Dafür braucht der Loop Schwellenwerte, Budgets, Eskalationsregeln und einen Kill Switch. Rollback gehört ebenfalls dazu, sofern der Prozess Änderungen vornimmt. Ein Dashboard ohne Interventionsweg ist keine Aufsicht, sondern ein Live-Ticker. Wer so etwas strickt, baut also nicht bloß ein Monitoring, sondern einen Steuerkanal zurück in den Prozess.
Der Schwachpunkt sitzt (wie in so vielen Fällen) vor dem Bildschirm: Menschen überwachen zuverlässige Automatisierung schlecht, weil über lange Zeit nichts passiert. Wenn dann eine Warnung erscheint, wirkt die plausible Systemausgabe oft überzeugender als der eigene Zweifel. Eine im Mai 2026 in AI and Ethics erschienene Arbeit zu „meaningful human oversight“ verweist auf Automatisierungsbias, Nachlässigkeit und unangemessenes Vertrauen als lange bekannte Human-Factors-Probleme. Mehr Erklärtext löst das nicht automatisch; ein sauber formulierter Irrtum kann sogar leichter durchrutschen.
Gute On-the-Loop-Kontrolle verteilt Aufmerksamkeit deshalb gezielt. Sie nutzt risikogewichtete Stichproben, unabhängige Checks, Abweichungssignale und Fälle, in denen das System ausdrücklich auf eine Entscheidung verzichtet. Der Mensch prüft nicht alles, aber er prüft die Stellen, an denen sein Urteil den Ausgang wahrscheinlich verändert.
Im KMU kann ein Agent eingehende Support-Tickets klassifizieren, beantworten und nur bei ungewöhnlichen Erstattungsquoten, negativer Stimmung oder bestimmten Kundengruppen Alarm schlagen. Der Betrieb gewinnt Tempo, trägt aber die Kosten für Monitoring und Bereitschaft. Wer niemanden benennt, der auf Warnungen reagieren darf und kann, betreibt Human-on-the-Loop nur auf dem Organigramm.
Human-at-the-End: Die letzte Tür bleibt zu
Beim Human-at-the-End erledigt das System Recherche, Entwurf und formale Prüfungen selbstständig. Der Artikel bleibt aber Draft, die Kampagne bleibt pausiert, der Pull Request bleibt ungemergt und die Mail bleibt im Postausgang, bis ein Mensch die letzte Tür öffnet.
Diese Variante ist für viele Wissensprozesse im Mittelstand attraktiv. Sie unterbricht den Lauf nicht an jeder Zwischenstation, behält die Außenwirkung aber beim Menschen. Ein Vertriebsagent kann Daten zusammentragen und ein Angebot ausformulieren; versendet wird es erst nach Prüfung durch die zuständige Person. Für Newsletter, Stellenanzeigen, Vertragsentwürfe oder öffentliche Reports gilt dasselbe.
Wer am Ende prüft, braucht einen überprüfbaren Output: Quellen, Diffs, fehlgeschlagene Evals, Warnungen und offene Unsicherheiten. Ein fertiges Dokument ohne Herkunft und Prüfsignale zwingt dazu, die gesamte Arbeit zu wiederholen oder blind zu vertrauen. Meist gewinnt Option zwei, weil Kalender existieren.
Der Name ist nur dann verdient, wenn bis zur Freigabe noch nichts Wesentliches passiert ist. Hat der Agent bereits Anzeigenbudget ausgegeben, Kundendaten überschrieben oder eine Nachricht versendet, ist die Endkontrolle nachträglich. Das kann als Audit sinnvoll sein, schützt aber nicht vor dem ersten Schaden. Genau hier liegt die Abgrenzung zum allgemeinen Human-in-the-Loop: At-the-End meint nicht irgendein Gate im Ablauf, sondern das eine Gate zwischen fertigem Arbeitsergebnis und wirksamer Außenhandlung.
Human-out-of-the-Loop: Auch das kann vernünftig sein
Nicht jeder Run braucht einen Menschen. Eine Quelle abrufen, ein Format prüfen, Dubletten markieren oder einen Report in einem internen Ordner aktualisieren kann vollständig automatisiert laufen, wenn Rechte und Folgen begrenzt sind.
Human-out-of-the-Loop ist vertretbar, wenn vier Dinge zusammenkommen: Das Ergebnis lässt sich zuverlässig prüfen, Fehler sind leicht umkehrbar, das Schadenspotenzial ist klein und das System arbeitet innerhalb enger Berechtigungen. Read-only zuerst ist eine gute Default-Regel. Schreibrechte kommen später, wenn nötig, und dann kleinteilig.
Der Mensch verschwindet dabei nur aus dem einzelnen Run. Jemand muss Werkzeuge, Budgets, Guardrails, Tests und Eskalationen entwerfen. Jemand muss die Resultate stichprobenartig prüfen und den Prozess abschalten, wenn sich Daten, Regeln oder Nutzung verschieben. Out-of-the-Loop ist kein Verantwortungsexport an das Modell.
Für den Mittelstand ist das oft der wirtschaftlichste Einstieg. Ein Agent kann Rechnungen nach bekannten Merkmalen sortieren, Support-Tickets routen oder Wettbewerberseiten read-only beobachten, ohne dass jedes Ergebnis eine Freigabeschleife erzeugt. Sobald derselbe Agent Zahlungen auslöst, Kundenzusagen macht oder Datensätze löscht, ändert sich die Ausgangslage. Dann ist aus der harmlosen Routine ein Prozess mit Wirkung geworden.
Das zeigt auch ein Einblick in den internen Einsatz von Codex bei OpenAI vom Mai 2026: Niedrigriskante Aktionen sollen innerhalb technischer Grenzen ohne Reibung laufen, riskantere Aktionen stoppen zur Prüfung. Sandbox, Freigabepolitik und Telemetrie arbeiten zusammen. Ein Auto-Review-Modus genehmigt bestimmte Anfragen über die Sandbox-Grenze hinaus sogar automatisch – ein Modell entscheidet also über die Wünsche eines anderen Modells. Ein wenig unter Vorbehalt: Das ist eine Herstellerbeschreibung des eigenen Systems, aber als konkretes Designbeispiel ist sie gut brauchbar.
Vom Agentenlauf zum Prozess: alle vier Varianten in einem System
Der Vorgängerartikel hat den einzelnen Agenten in ein System aus Triggern, Verifikation, Zustand und Grenzen eingeordnet. Die vier Oversight-Varianten beantworten nun für jeden dieser Schritte dieselbe Frage: Was darf weiterlaufen, wenn gerade kein Mensch reagiert?
Einen redaktionellen Prozess zum Beispiel würde ich nicht pauschal auf „in“ oder „out“ stellen. Die Position hängt vom Schritt ab. Dasselbe Prinzip gilt im KMU für Support, Marketing, Vertrieb oder Softwareentwicklung.
| Prozessschritt | Oversight | Warum |
|---|---|---|
| neue Quellen beobachten | out-of-the-Loop | read-only, geringe Folgen, leicht prüfbar |
| Widersprüche und ungewöhnliche Behauptungen markieren | on-the-Loop | automatische Signale, menschliche Stichprobe |
| Thema und These festlegen | in-the-Loop | prägt Richtung und Auswahl des gesamten Artikels |
| recherchieren und formale Checks ausführen | out-of-the-Loop | wiederholbar, begrenzbar, mit Quellen und Tests prüfbar |
| Artikel veröffentlichen | at-the-End | bis zur Freigabe geht nichts nach draußen |
| Prompt, Skills oder Bewertungsregeln ändern | in-the-Loop | verändert alle späteren Runs, nicht nur einen Output |
Gerade der letzte Punkt wird unterschätzt. Wenn ein Optimierungs-Loop Prompts, Tools oder Bewertungskriterien selbst verändert, arbeitet er am Harness und damit an den Regeln künftiger Läufe. Ein einzelner fehlerhafter Artikel ist ärgerlich. Eine fehlerhafte Regel, die hundert Artikel beeinflusst, skaliert den Ärger immerhin effizient.
Die Schleifentypen aus dem vorherigen Artikel lassen sich ähnlich zuordnen. Im Agent Loop sitzt ein Gate vor sensiblen Tools. Im Verification Loop prüfen Menschen Grenzfälle und Stichproben, während deterministische Tests den Rest abfangen. Event-driven Loops brauchen Monitoring, Limits und Stoppsignale. Beim Hill-climbing Loop sollten Menschen Änderungen an Prompts, Tools, Skills und LLM-as-a-Judge-Kriterien freigeben. Das ist meine Abbildung auf die Loop-Taxonomie von LangChain, keine Norm.
Drei Fragen entscheiden über die Kontrolle
Für die Platzierung menschlicher Kontrolle reichen drei Fragen meist weiter als eine lange Governance-Policy.
Wie gut ist das Ergebnis prüfbar? Ein JSON-Schema, ein Unit-Test oder eine harte Geschäftsregel liefert ein deutliches Signal. Tonalität, Fairness oder strategische Passung bleiben unschärfer. Ein zweites Modell kann beim Vorsortieren helfen, ist aber kein objektiver Richter.
Wie gut lässt sich die Aktion umkehren? Ein interner Draft kann gelöscht werden. Eine versendete Mail lässt sich nur noch erklären. Ein gelöschter Datensatz braucht ein Backup, eine öffentliche Entscheidung womöglich juristischen Beistand. Je später ein Fehler korrigierbar ist, desto früher gehört das Gate in den Ablauf.
Wie groß ist der mögliche Schaden? Kosten, Datenverlust, Rechtsfolgen und Reputationsschäden gehören in diese Betrachtung. Ebenso der Umfang: Ein Fehler in einem Run kann klein sein, dieselbe falsche Regel in einem dauerhaften Prozess nicht.
| Prüfbarkeit | Umkehrbarkeit | Schadenspotenzial | Sinnvolle Default-Position |
|---|---|---|---|
| hoch | hoch | gering | out-of-the-Loop, ergänzt um Stichproben |
| hoch | mittel | mittel | on-the-Loop mit Limits und Rollback |
| mittel | hoch | mittel | at-the-End vor Veröffentlichung oder Übergabe |
| gering | gering | hoch | in-the-Loop vor der kritischen Aktion |
Das ist eine Heuristik. Sie ersetzt weder eine Risikoanalyse noch branchenspezifische Pflichten. Für den ersten Architekturentwurf verhindert sie aber die beliebte Methode „Wir setzen irgendwo einen Approval-Step hin und nennen das dann Responsible AI“.
Ein Name im Organigramm ist noch keine Human Oversight
Human Oversight wird gern als Rollenfrage behandelt: Irgendjemand aus Fachbereich, IT oder Geschäftsführung bleibt verantwortlich, also sei die Sache geregelt. Im Betrieb hilft diese Zuständigkeit wenig, wenn das System keine Stelle besitzt, an der diese Person wirksam eingreifen kann.
Wirksame Aufsicht beginnt mit einer überprüfbaren Entscheidungsvorlage. Vor der Entscheidung muss sichtbar sein, was der Agent tun will, worauf sich die Entscheidung stützt, welche Regeln geprüft wurden und wo Unsicherheit bleibt. Quellen und Tool-Ergebnisse gehören dazu. Bei Änderungen helfen Diffs mehr als eine wortreiche Zusammenfassung des Agenten. Ablehnen, bearbeiten, eskalieren, stoppen und zurückrollen sind unterschiedliche Aktionen; mindestens eine davon muss den Ausgang tatsächlich ändern können.
Zeit und Kompetenz sind ebenfalls Teil der Architektur. Eine Freigabe-Warteschlange mit 300 Fällen am Freitagnachmittag produziert keine Sorgfalt, sondern einfach nur Durchsatz. Maker-Checker klingt ordentlich, garantiert aber keine Qualität, wenn beide Seiten dasselbe Signal falsch lesen oder die prüfende Seite nur noch auf „Grün“ klickt.
Die bereits erwähnte Arbeit in AI and Ethics trennt deshalb die operative Arbeit des Systems von der bewertenden Rolle des Menschen. Gute Aufsicht muss dort drei Dinge leisten: Kontrolle, Anfechtbarkeit und Kompetenz – gestützt auf Aufzeichnungen, mit denen sich eine Entscheidung später rekonstruieren lässt. Die Arbeit räumt selbst ein, dass ihr Rahmen konzeptionell und nicht experimentell validiert ist. Der Designgedanke passt trotzdem gut zum KMU-Alltag: Der Mensch muss den Lösungsweg nicht komplett wiederholen. Er muss Ergebnis, Belege und Folgen beurteilen können.
Auch der EU AI Act verlangt in Artikel 14 für Hochrisiko-KI-Systeme, dass zuständige Personen Fähigkeiten und Grenzen verstehen, Automatisierungsbias berücksichtigen, Ausgaben verwerfen oder rückgängig machen und das System sicher stoppen können. Das gilt nicht pauschal für jeden Support-Bot oder Marketing-Agenten im Mittelstand, und seit dem Digital Omnibus greifen die Hochrisiko-Pflichten für Anhang-III-Systeme ohnehin erst ab dem 2. Dezember 2027. Als Architektur-Checkliste taugt Artikel 14 trotzdem: verstehen, widersprechen, rückgängig machen, stoppen.
Zur Farce wird Human Oversight, wenn das Gate erst nach der Aktion erscheint oder der Dialog ohne Kontext fragt: „Agent möchte Tool X verwenden. Zulassen?“ Das ist formal eine Entscheidung und praktisch Münzwurf mit Corporate Design. Dasselbe gilt für Alert-Flut. Wenn jedes harmlose Ereignis Aufmerksamkeit fordert, verschwinden relevante Warnungen im Lärm. Observability muss Signale liefern, auf die jemand rechtzeitig reagieren kann.
Erklärungen und Scores sind nur Eingaben für die Prüfung. Eine plausible Begründung kann falsch sein; ein LLM-as-a-Judge kann dieselben blinden Flecken wie das erzeugende Modell teilen. Das System braucht zusätzlich eine belastbare Prozesshistorie: Wer hat wann was freigegeben, welche Evidenz lag vor, welche Policy-Version galt und was passierte danach? Memory bedeutet hier weniger Langzeitgedächtnis des Modells als nachvollziehbare Entscheidungen.
Verantwortung sitzt außerhalb des Runs
Ein Ende August 2026 veröffentlichtes Position Paper, das Margaret Mitchell von Hugging Face mitverfasst hat, argumentiert, dass heutige Agentendesigns Menschen aus wirksamer Kontrolle drängen und längere Nutzung ausgerechnet die Fähigkeiten schwächen könnte, die für Aufsicht nötig sind. Das ist eine zugespitzte These, keine empirisch bewiesene allgemeine Wirkung. Der Hinweis trifft trotzdem einen wunden Punkt: Je autonomer der Ablauf wirkt, desto leichter behandeln Organisationen seine Entscheidungen als Eigenschaft des Systems.
Dabei bleibt die Verantwortung bei den Menschen, die Ziele, Rechte und Grenzen festlegen. Dass Agenten eher an Daten, Scope und Ownership scheitern als an der Modellwahl, lässt sich hier direkt weiterdenken. Wer den Prozess verantwortet, braucht die Befugnis, ihn zu verändern oder abzuschalten, ein Name in einer Tabelle reicht nicht.
Human Oversight entsteht an zwei Stellen. Zur Design-Zeit entstehen Rollen, Berechtigungen, Budgets, Tests, Protokolle und Eskalationswege. Zur Laufzeit greifen Menschen dort ein, wo Prüfung sinnvoll und Wirkung noch möglich ist. Die zweite Ebene kann die erste nicht reparieren. Wer einem Agenten zu breite Rechte gibt, löst das nicht mit einer aufmerksamen Aushilfe vor einem Dashboard.
Mein Take: Automatisiere die Arbeit, überwache den Prozess und behalte die folgenreiche Entscheidung dort beim Menschen, wo Prüfbarkeit, Umkehrbarkeit oder Schadenspotenzial es verlangen. Der Mensch muss nicht überall im Loop sitzen. An der richtigen Stelle sollte er allerdings mehr können als klicken.