Muse Code im Hackathon: zehn Tage Muse Spark 1.3 mit wenig Kopfschmerzen
Zehn Tage Metas Global AI Developer Hackathon mit Muse Code und Muse Spark 1.3. Wie /grill meinen Plan zerlegt hat, wo es geknirscht hat, warum ich Muse Wonder weggelassen habe und was gut 2 Milliarden Input-Tokens am Ende gekostet haben.
Kurz und knapp vorab: Ich hatte mit deutlich mehr Ärger gerechnet. Zehn Tage lief Metas Global AI Developer Hackathon, und in dieser Zeit habe ich mit dem Gespann aus Muse Code und Muse Spark 1.3 einen Log-Analyzer gebaut, den ich am 3. November eingereicht habe. Ein Coding-Agent, den ich im August nur kurz angetestet hatte, ein Modell, das ich 20 Minuten mit Kleinkram genervt habe („testen“ kann man das nicht nennen), dazu ein festes Budget. Ja knorke, das lädt doch förmlich dazu ein, ein Projekt mit ordentlich Tamtam und Fanfaren gegen die Wand zu fahren.
Gelaufen ist es dann doch flüssiger als zuerst befürchtet. Muse Spark 1.3 antwortet schnell, schwafelt wenig und trifft einen angenehmen Ton (Spark 1.2 hatte ich damals noch eine sehr übertrieben zurückhaltende Persönlichkeit attestiert). Ebenfalls zu meiner Überraschung brauchte es für die meisten Aufgaben weniger Durchgänge, als ich eingeplant hatte. Gewartet habe ich trotzdem, und zwar fast immer auf Tests. Dieser Text ist der Recap zum Hackathon und zur Arbeit mit Muse Code. Das Projekt selbst hat nun auch einen eigenen Artikel.
TL;DR
Zehn Tage, 150 $ Guthaben und ein Log-Analyzer mit LLM-Support und API nach draußen. Mein Fazit aus Metas Hackathon fällt besser aus, als ich es vorher erwartet hätte.
- Muse Spark 1.3 arbeitet schnell, ist knapp im Ton und kam mit überraschend wenigen Durchgängen aus. Muse Wonder habe ich bewusst weggelassen.
/grillist mein Lieblingsbefehl in Muse Code. Ein Interview, das den Plan Frage für Frage auseinandernimmt, bevor Code entsteht.- Die Zeit ging in Prüfschleifen. Allein der Nachbau der LogWerk-Funktionen dauerte gut 15 Stunden bis zum geprüften Stand.
- Verbraucht habe ich 86,05 $ bei 2,065 Milliarden Input-Tokens und 97,3 % Cache-Treffern. Ab dem 1. November lief Muse im günstigeren Contributor-Modus.
Zehn Tage, zwei Tracks und 150 $ Guthaben
Der Hackathon war ein Online-Wettbewerb von Meta über die Plattform von Cerebral Valley, offen für bis zu 20.000 zugelassene Teilnehmende weltweit. Los ging es am 26. Oktober mit einem Kickoff-Livestream, bis zum 4. November liefen Workshops und Office Hours auf Discord. Abgabeschluss war der 4. November um 21 Uhr Ostküstenzeit, bei uns also der 5. November um 3 Uhr morgens (Meta-Veranstaltungsseite). Die Preise verteilt Meta auf zwei Tracks, einen für Indie-Entwickler sowie Studierende und einen für Startups.
Ich bin im Indie-Track mit dem Thema „Build for Your World“ angetreten, also mit einem Problem aus dem eigenen Alltag. Bewertet werden dort Kreativität, technischer Anspruch und ob das Ding funktioniert. Seit dem 4. November sitzt die Jury, die Gewinner gibt Meta am 9. November bekannt. Pflicht war die Arbeit mit Metas Modellen, und für die Meta Model API gab es nach einem Claim 150 $ Guthaben. Mehr verbrauchen durfte man, nur eben auf eigene Rechnung, ein automatisches Limit setzen die Credit Terms nicht.
Warum ich auf Muse Wonder verzichtet habe
Meta hatte im Oktober mit Muse Wonder ein stärkeres Modell nachgelegt. Für LogCarve habe ich es bewusst links liegen lassen. Ein Log-Analyzer ist keine Raketenwissenschaft, und Wonder kostet pro Million Tokens 4 $ Input und 20 $ Output, Muse Spark 1.3 dagegen 1,25 $ und 4,25 $ (Preisseite). Bei 150 $ Budget war die Rechnung schnell gemacht.
Gearbeitet habe ich mit mittlerem Reasoning Effort und ab dem 1. November mit der Contributor-Variante von Spark 1.3. Die kostet 0,10 $ Input und 0,20 $ Output pro Million Tokens, Cache-Treffer 0,002 $. Im Gegenzug darf Meta Prompts, Code, Dateien und Antworten zum Training künftiger Modelle verwenden. Wer den Schalter umlegt, sollte das also im Hinterkopf behalten. Wonder kennt diesen Tarif übrigens nicht.
Der Deal an dieser Stelle ist fair: Das Guthaben habe ich im Rahmen des Events für das Projekt spendiert bekommen, der Code liegt ohnehin unter Apache-2.0 öffentlich auf GitHub, und im Contributor-Modus hat Muse nur öffentlichen Quellcode und synthetische Testdaten gesehen. Bei einem Kundenprojekt sähe meine Antwort definitiv anders aus.
LogCarve in Kurzform
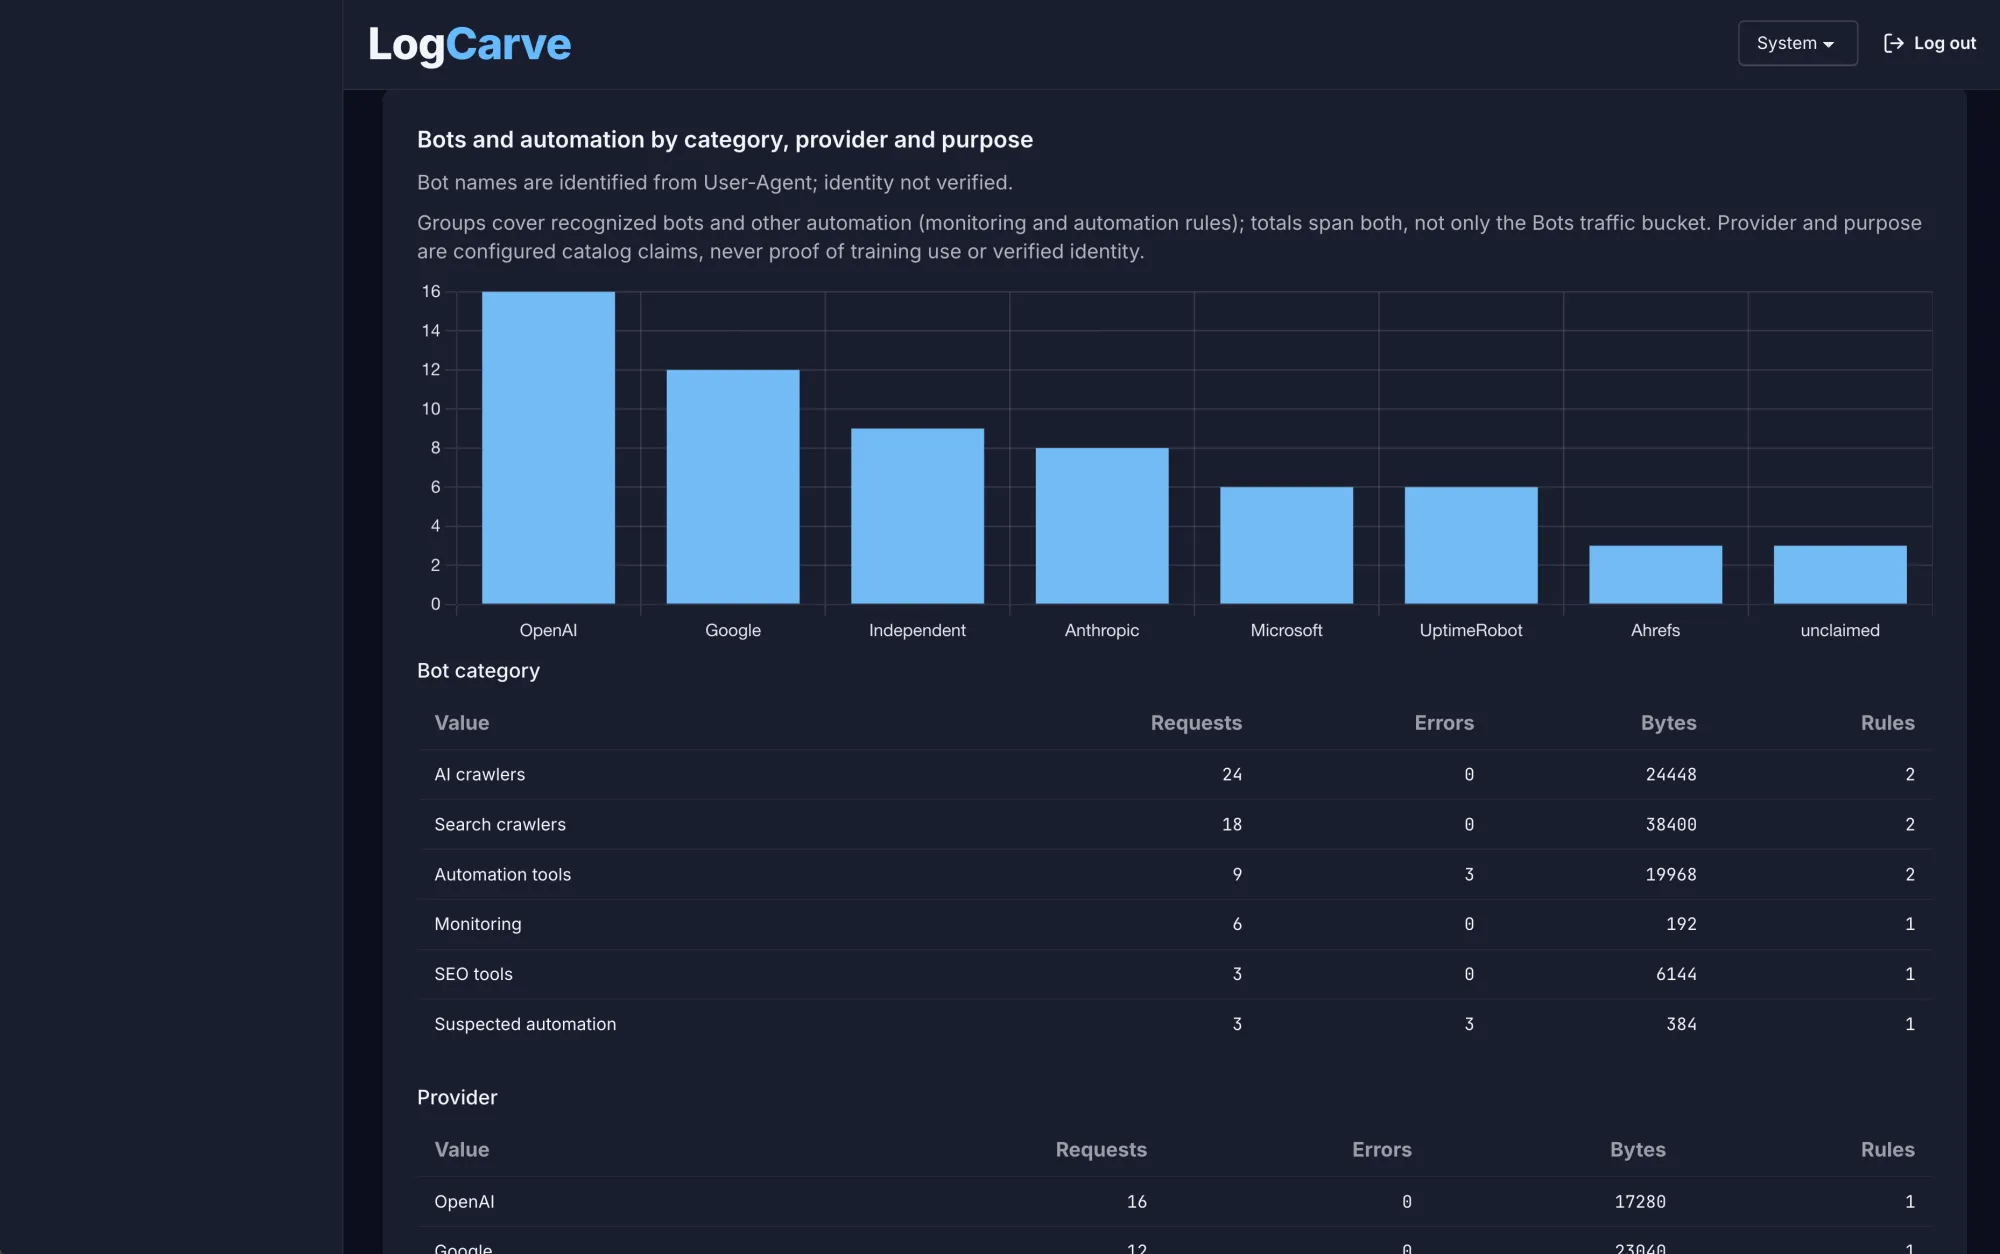
LogCarve ist ein self-hosted Analyzer für Access-Logs von Nginx und Apache, so etwas wie der große Bruder von LogWerk. LogWerk läuft als einzelne HTML-Seite im Browser, LogCarve importiert die Logs in eine lokale SQLite-Datenbank und wertet sie nach Zeitraum, Quelle und weiteren Filtern aus. Dashboard, authentifizierte REST-API und der optionale KI-Assistent ziehen ihre Zahlen aus derselben Analyseschicht. Eine Zahl aus einer KI-Antwort lässt sich deshalb im Dashboard oder per API nachprüfen und auch ohne KI-Schicht funktioniert das Ding immer noch.
Der Stack ist gar nicht mal so spektakulär: Python, FastAPI, SQLite, Jinja2, htmx und Chart.js. Beim Import verwirft LogCarve standardmäßig Query-Werte, kürzt Referrer und pseudonymisiert Client-Adressen (wegen Datenschutz und so). Aus LogWerk stammen 70 Erkennungsmuster für den Bot-Katalog samt erhaltenem MIT-Hinweis, Anwendung, Speicherlogik und Oberfläche sind eine eigene Implementierung. Die lokale Demo startet per Docker Compose mit 120 synthetischen Requests. Den eingereichten Stand führe ich als Preview, den Containerbetrieb habe ich ehrlicherweise bisher nur auf ARM64 ergo Apple silicon getestet.
Erst die Regeln, dann der Code
Am Anfang stand meine Spezifikation, aus der Muse ein Projektgerüst mit technischem Entwurf, Abnahmekriterien und Arbeitsplan gebaut hat. Einer der ersten Schritte war die AGENTS.md, also die Regeln für das Repository: wie mit Logdaten umzugehen ist, dass Tests nur mit synthetischen Daten laufen und wo die Grenzen für Modellaufrufe und Veröffentlichungen liegen.
Bevor Muse in meinem Fall eine Zeile Code schreiben durfte, sollte es den Bestand prüfen und die offenen Entscheidungen auflisten. Im Terminal habe ich mich anfangs viel mit /help orientiert, Sitzungen mit /name benannt und mit /mcp geprüft, ob Context7 und Chrome DevTools als Entwicklungswerkzeuge erreichbar sind.
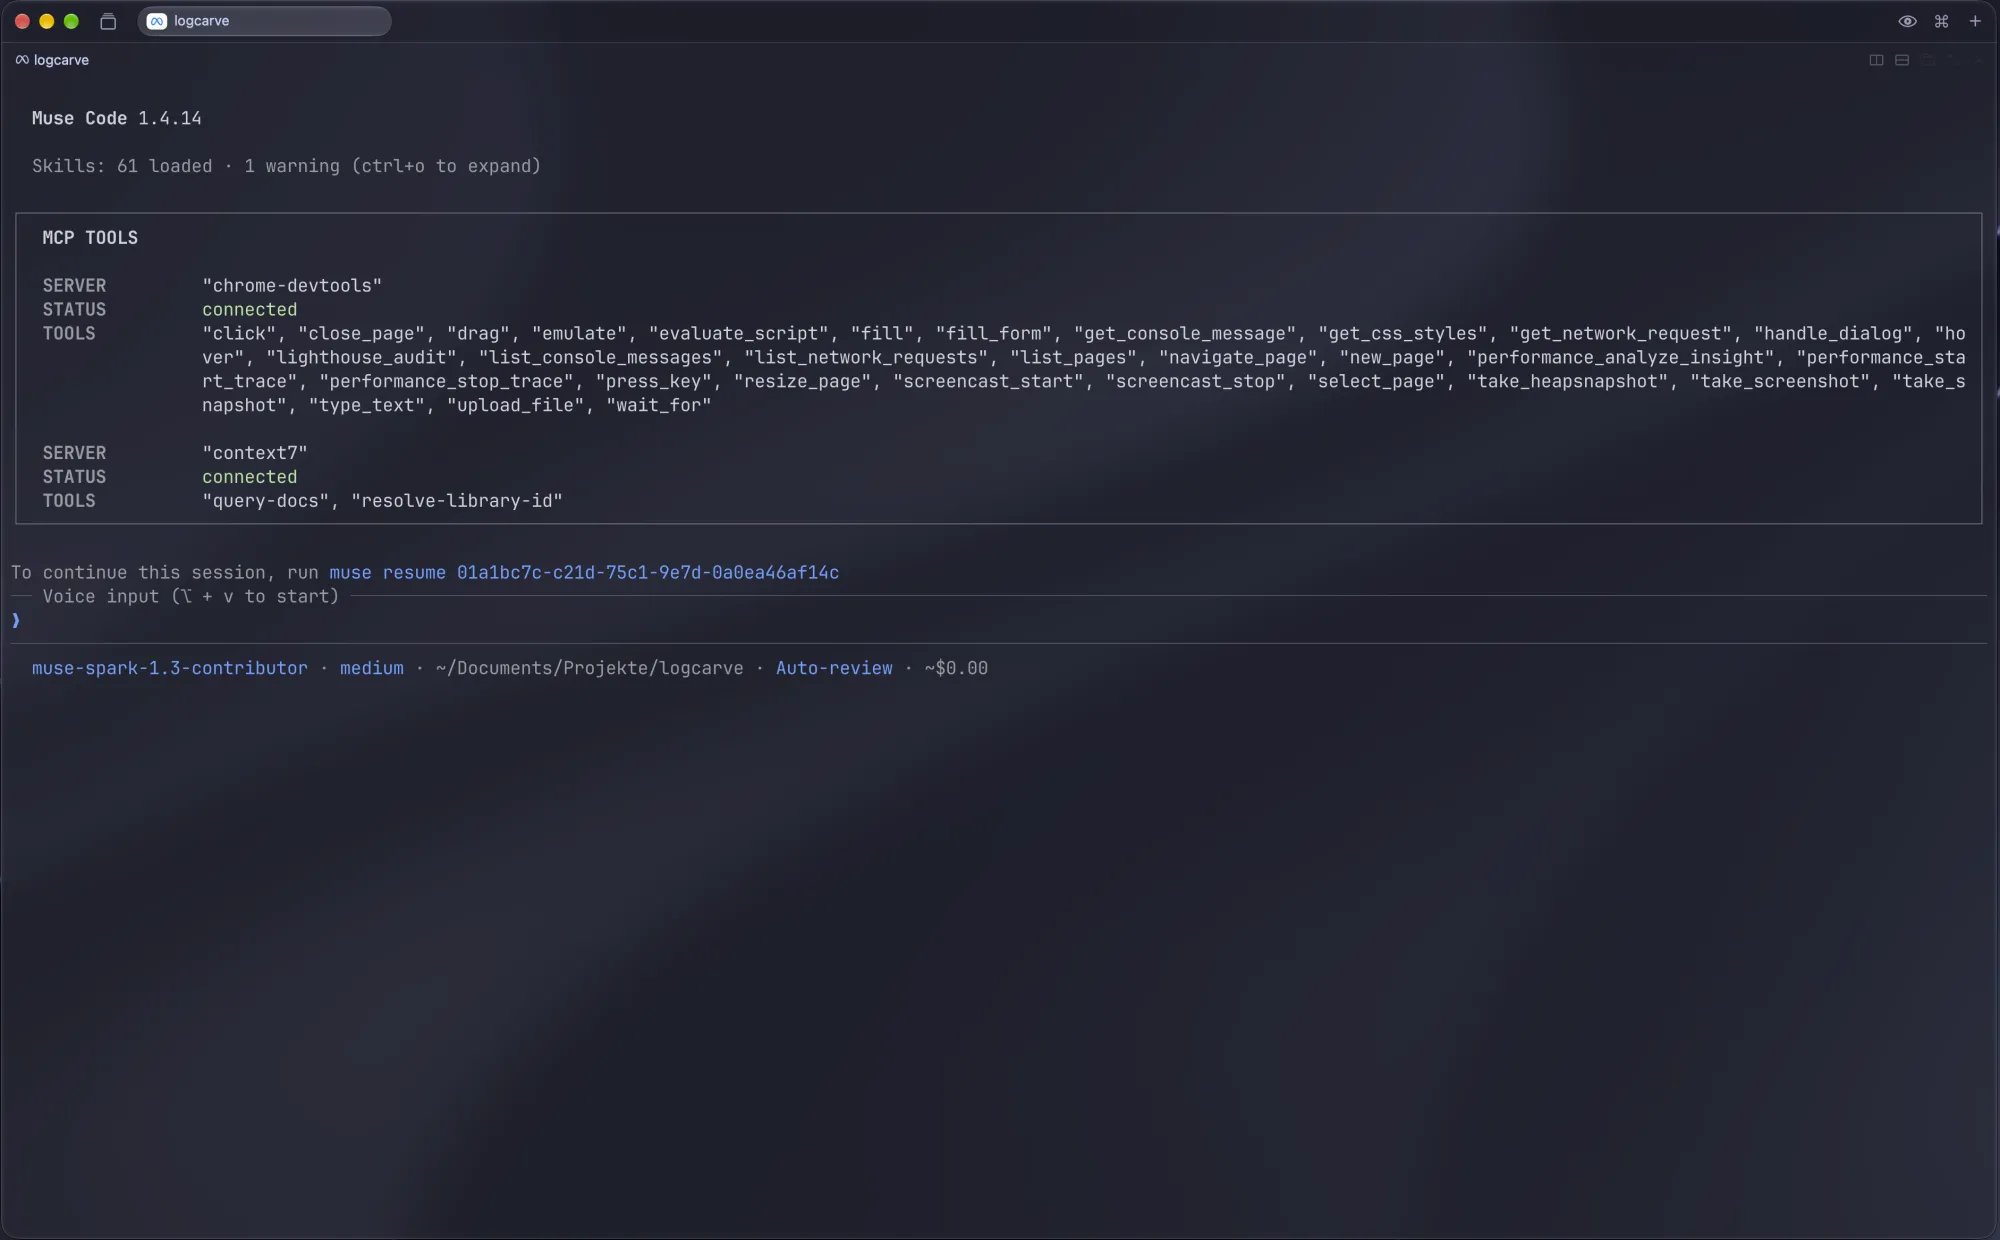
Mit /plan wurden danach in Muse Code die Umsetzung danach in Arbeitspakete zerlegt. Zuerst kamen Parser, Speicherung und ein reproduzierbarer Import, danach die gemeinsamen Auswertungen und die API (MVP-Plan). Den Assistenten hat Muse zunächst gegen simulierte Modellantworten entwickelt und getestet. Für den ersten echten Aufruf bei Meta gab es eine eigene Freigabe mit harten Grenzen von drei Untersuchungen, zwölf Requests und höchstens 1 $, alles mit synthetischen Daten. Für die Oberfläche kam später /taste dazu, eine Checkliste gegen die Muster, an denen man KI-generierte UIs sofort erkennt (siehe Meta-Cookbook).
/grill: das Interview vor dem ersten Commit
Mein absoluter Lieblingsbefehl in Muse Code heißt /grill. Der Agent nimmt sich den Plan noch einmal komplett vor, stellt genau eine Frage, wartet auf meine Entscheidung und hält sie fest. Dann kommt die nächste. Umgesetzt wird erst, wenn Ziele, Nicht-Ziele, Randbedingungen und Prüfkriterien geklärt sind.
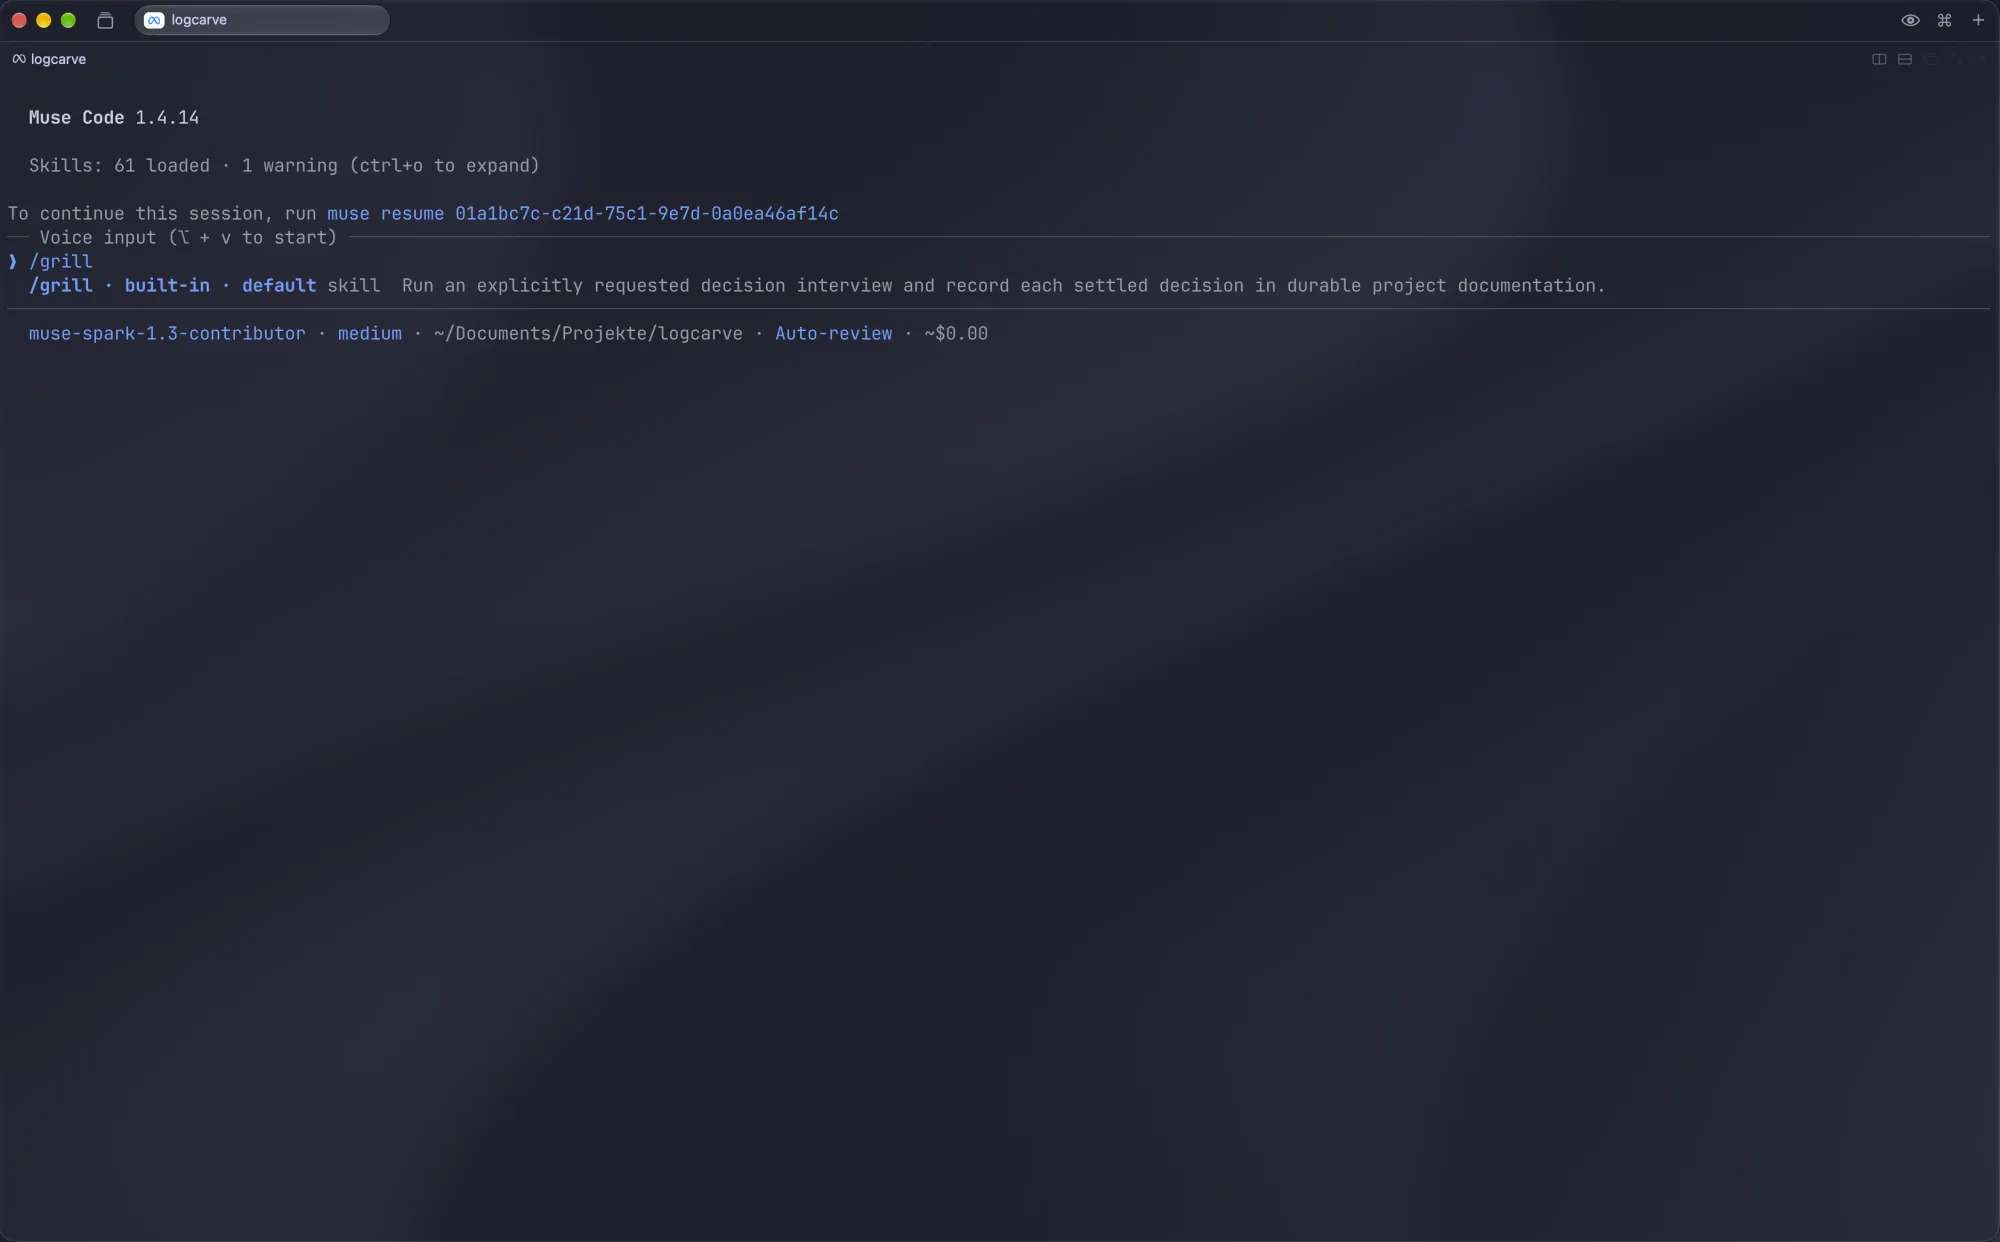
Eine der Fragen betraf die Aufbewahrung der Logs. Ich habe mich für 30 Tage als einstellbaren Standard entschieden, und die Frist gilt nur für die Kopie in LogCarve, die Quelldateien bleiben schreibgeschützt. Auch Backup und Wiederherstellung musste ich festlegen, einschließlich eines Restore-Tests in einer isolierten Umgebung. Im Protokoll vom 29. Oktober stehen sechs Entscheidungen, darunter die Lizenz, die LogWerk-Übernahmen, die Zielumgebung und die Bedingungen für echte Modellaufrufe. Erst danach habe ich den nächsten Arbeitsschritt freigegeben.
Kleiner Stolperstein für alle, die das nachbauen wollen: Mein lokaler Build führte den Befehl als /grill, in Metas Cookbook heißt er widersprüchlich /grilling. Dort steht außerdem /grill-with-docs, das die Antworten gleich in ein Projektdokument schreibt.
Ein Ziel, eine schreibende Sitzung
Für längere Arbeitspakete habe ich /goal genutzt. Das Ziel bleibt dann über mehrere Turns bestehen, Muse arbeitet nach einem Turn selbstständig weiter und hakt vor dem Abschluss die genannten Kriterien einzeln ab. Mit /goal pause und /goal resume lässt sich das anhalten und fortsetzen (Muse-Doku zu Zielen).
Geschrieben hat immer nur eine Muse-Sitzung. Implementierung, Review und Verifikation habe ich getrennt. Hatte ein Review einen Fehler gefunden und reproduziert, ging er als gezielter Korrekturauftrag zurück an die schreibende Sitzung. Subagents, die Muse als eigene, begrenzte Aufträge kennt (auf Wunsch mit eigenem Git-Worktree pro Auftrag), habe ich für fachliche Aufgaben nicht eingesetzt, der Session-Export weist dafür accepted_spawns: 0 aus.
Subtasks tauchen in den Sitzungsprotokollen trotzdem auf. Das sind die Hintergrundhelfer, die Muse für Ziel- und Prüfreminder startet. Laut Doku laufen standardmäßig vier solcher Beobachter mit, und die verbrauchen zusätzliche Tokens.
Wo es geknirscht hat
Muse hat ganze Teile am Stück umgesetzt, den Parser genauso wie Datenbank, API und Oberfläche. Von mir kamen Anforderungen, Freigaben und Abnahmekriterien. Ein typischer Zyklus bestand aus Implementierung, Diff-Prüfung, Reproduktion eines gefundenen Fehlers, gezielter Korrektur und erneutem Test. Vier Fälle zeigen, wo die Arbeit steckte.
Der erste echte Aufruf beim Assistenten
Muse lieferte beim ersten echten Aufruf einen gültigen Tool-Call. Danach brach LogCarve ab. Schuld war ein älteres Textlimit von 4.000 Zeichen, das zusätzlich auf den strukturierten Verlauf angewendet wurde und nach zwei ausführlichen Werkzeugergebnissen schon voll war. Muse hat die beiden Verarbeitungspfade getrennt und die Grenzen für Datenübertragung und Kosten unverändert gelassen. Der nächste freigegebene Lauf lieferte eine Antwort mit sieben Evidenzlinks, und die genannten 28 HTTP-404-Requests deckten sich mit der unabhängigen API-Abfrage (siehe Testprotokoll).
Der Importer nach einem Neustart
Bei einer überlangen Logzeile verwirft der Importer den Rest dieser Zeile. Startete er mitten in diesem Verwerfen neu, konnte der übrige Teil ein zweites Mal verarbeitet werden. Jetzt landet dieser Zustand im Checkpoint. Geprüft wurde das mit Neustart, Rotation, exaktem Dateioffset und der Zahl verworfener Zeilen (siehe Importtests).
Befunde später erneut prüfen
Richard Ng (Native) hatte mich im Austausch dankenswerterweise angehalten, die Herkunft eines Befunds festzuhalten, damit sich die Belege später erneut prüfen lassen, etwa nach einer Logrotation. LogCarve signiert dafür Quelle, Generation, Zeitraum und Filter zusammen mit einem Hash des Ergebnisses, beim Recheck läuft dieselbe Abfrage lokal noch einmal. Das Review fand trotzdem ein Loch. Ein Befund ohne Herkunftsdaten konnte zunächst als aktuell durchgehen. Die korrigierte Fassung markiert unvollständige Evidenz als unverified und behandelt Speicherfehler getrennt.
Ein frisches Linux-System in der CI
Der erste Lauf auf einem frischen Linux-System in GitHub Actions endete mit fünf roten Tests. Zwei erwarteten JavaScript-Dateien, die der Workflow erst nach den Tests baute, drei scheiterten an Unterschieden im installierten Zeitzonenkatalog. Muse hat die Build-Reihenfolge getauscht und die Zeitzonenprüfung unabhängig von bestimmten Host-Aliasen gemacht. Zwischen den beiden Commits lagen 35 Minuten.
So wirklich aufregend spektakulär war keiner dieser Fehler. Gefunden haben sie Reviews und echte Läufe.
Schnell geschrieben, lange geprüft
Bei der Ausgabe fühlte sich Muse Spark 1.3 für mich flott an, aber das ist ein subjektiver Eindruck. Gemessen habe ich nur die Prüfungen, und dort lag die Wartezeit. Ob eine Änderung im Browser funktioniert, nach dem Neustart des Importers und auf einem frischen Linux-System, das dauert so ein Weilchen. Der erste Linux-Lauf brauchte für die Testsuite 4 Minuten und 30 Sekunden und endete mit 1.497 bestandenen und fünf fehlgeschlagenen Tests. Der korrigierte Lauf kam auf 1.503 bestandene Tests in 4 Minuten und 43 Sekunden (siehe erster Linux-Lauf und korrigierter Linux-Lauf).
Gegen Ende habe ich bei Einzelkorrekturen zuerst nur die betroffenen Fälle prüfen lassen. Der gezielte Lauf für den Fehler im Modellverlauf umfasste sechs Tests. Nach 0,58 Sekunden war er durch (Regressionslauf). Die vollständige Suite lief erst für den konsolidierten Stand, Browser-, Container- und Live-Prüfungen kamen separat dazu. Manche Chromium-Starts blockierte die Sandbox von Muse. Diese Browserprüfungen liefen deshalb in einer eigenen, geschützten Umgebung. Im Kleinen ist das übrigens der Punkt, den ich beim Loop Engineering beschrieben habe. Die Arbeit steckt in den Prüfschritten um den Agenten herum und die bestimmen das Tempo.
Die Nacht mit den LogWerk-Funktionen
Am längsten haben die Sessions gedauert, in der ich die Funktionen aus LogWerk in LogCarve nachbauen ließ. Vom Auftakt am 1. November gegen 19:35 Uhr bis zum dokumentierten Abschluss am nächsten Morgen um 10:45 Uhr vergingen gut 15 Stunden, verteilt auf mehrere Muse-Sitzungen. Die Änderungen zogen sich durch das ganze Projekt, betroffen waren Import und Speicherung genauso wie API, Exporte, Oberfläche, GeoIP und Logrotation. Ein Filter musste zum Beispiel im Dashboard, in der API, im Export und beim Assistenten dieselbe Auswahl ergeben.
Mein Fehler war, anfangs zu viele breite Zwischenprüfungen einzuplanen. Ein einzelner Testlauf war in Minuten erledigt. Die Zeit summierte sich in den Schleifen aus Prüfen, Reproduzieren, Korrigieren und erneutem Prüfen, dazu kamen Stopps am Schrittlimit und der Start neuer Sitzungen. Nach einer Pause am Morgen habe ich die Arbeit gebündelt und bis zur gemeinsamen Abschlussprüfung nur noch die geänderten Funktionen testen lassen. Die 15 Stunden sind also die Zeit bis zum geprüften Stand, reine Modellzeit war das also nicht (siehe Verifikationsprotokoll der Paritätsrunde).
Was gut 2 Milliarden Tokens kosten
Für die Entwicklung des aktuellen Stands von LogCarve habe ich 86,05 $ des von Meta bereitgestellten Guthabens verbraucht. Das Meta-Dashboard zeigt für den Zeitraum vom 26. Oktober bis 4. November rund 16.400 Requests, 2,065 Milliarden Input-Tokens und 8,3 Millionen Output-Tokens. Die Cache-Trefferquote beim Input lag bei 97,3 %, in der Input-Summe steckt also auch der Kontext, der aus dem Cache kam.
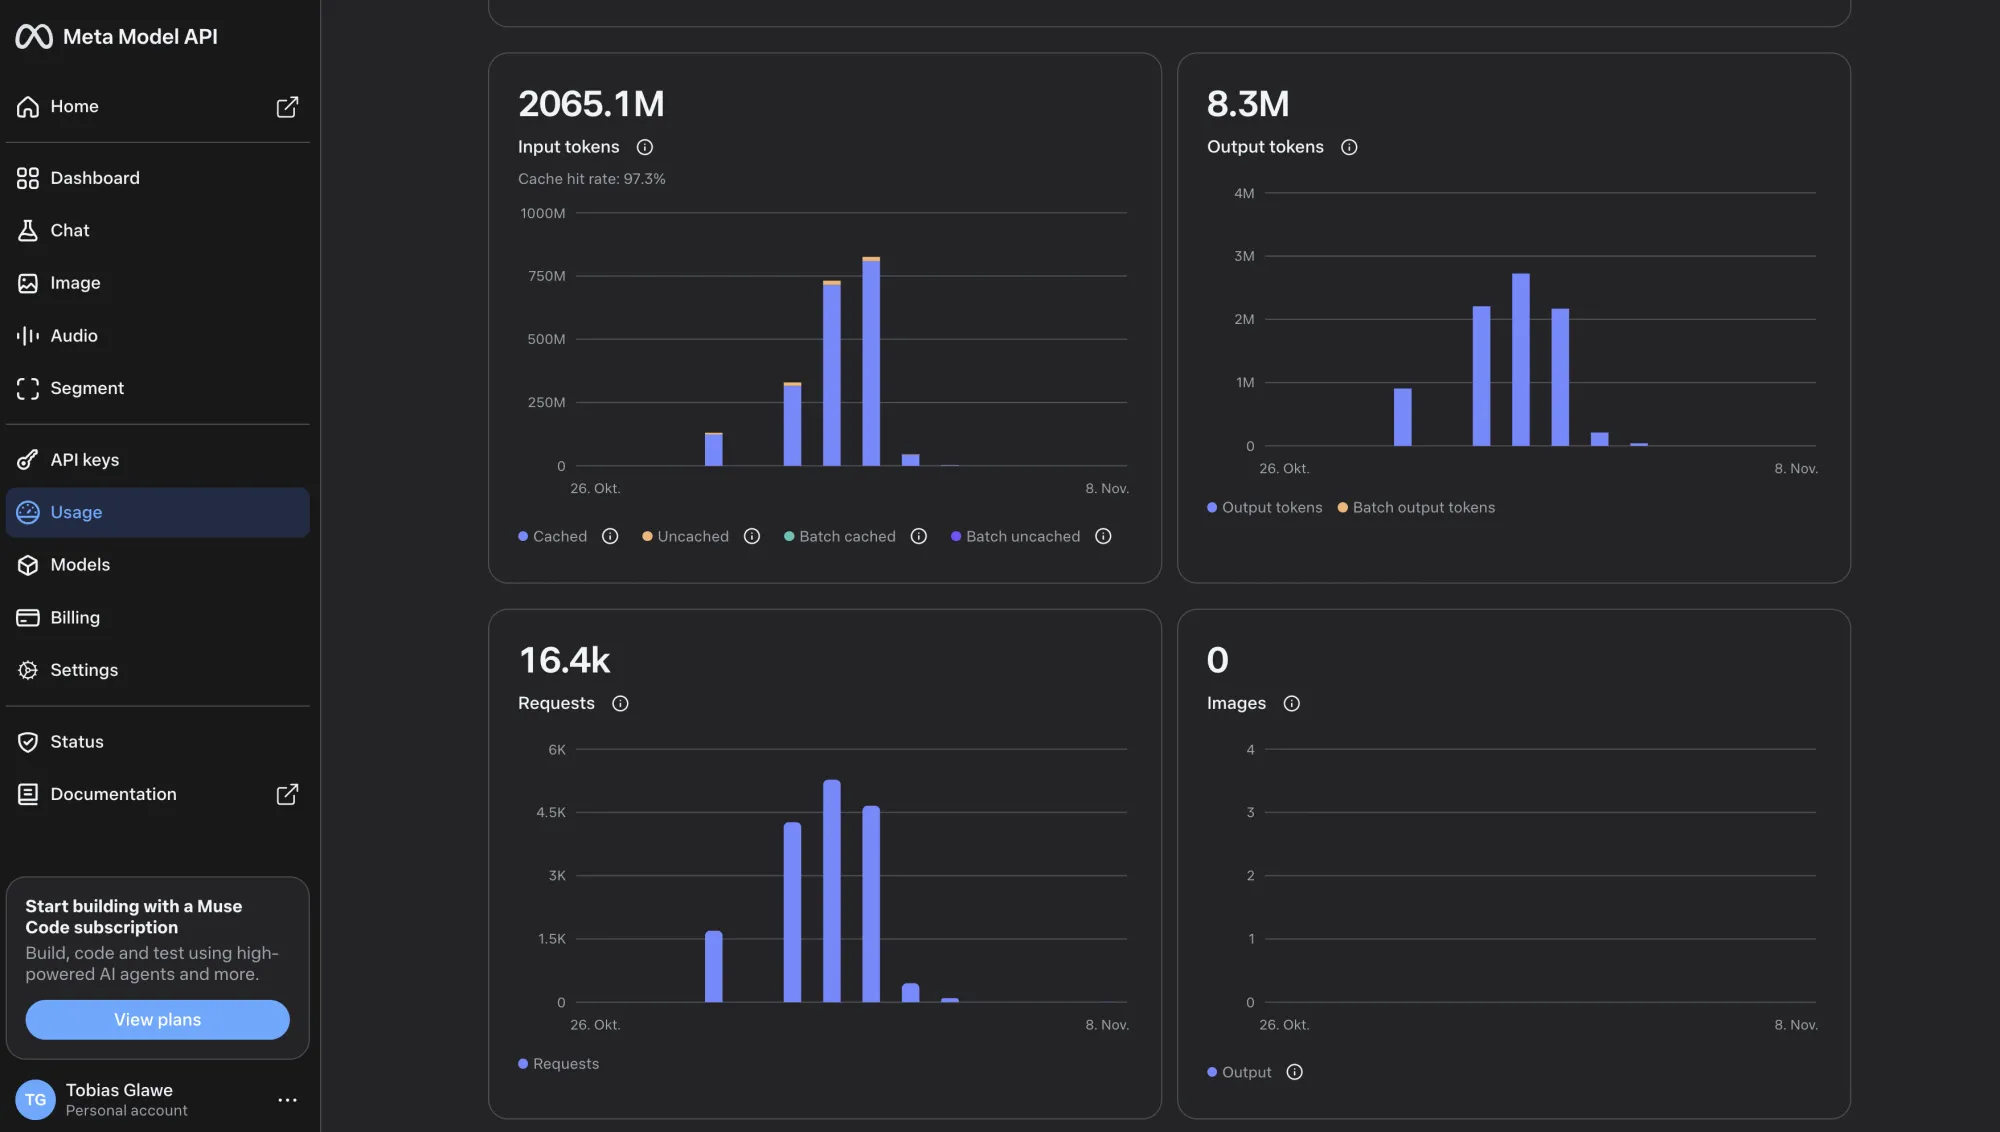
Ohne Cache sähe das anders aus: Wäre jedes Input-Token den vollen Standardpreis von 1,25 $ pro Million in die Berechnung gewandert, stünden allein dafür gut 2.580 $ auf der Rechnung. Mit Cache, aber komplett zum Standardtarif wären es grob 400 $ gewesen. Dass es bei 86 $ blieb, liegt an der Mischung aus Cache und Contributor-Tarif (meine Überschlagsrechnung, keine Abrechnung von Meta). Wie stark Caching bei Agenten durchschlägt, habe ich bei der Token-Effizienz in Claude Code schon einmal auseinandergenommen. Bei Muse ist es so ziemlioch dasselbe Spiel!
Muse Code neben Claude Code und Codex
Wer Claude Code oder Codex kennt, kommt mit Muse Code schnell klar. Alle drei bieten interaktive und skriptbare Sitzungen, die sich fortsetzen lassen, und lesen Projektanweisungen. Ganz ohne Umgewöhnung ging es trotzdem nicht. Gewöhnungsbedürftig waren für mich die leicht anderen Befehle und Flags, die eigenen Freigaberegeln und das Format der Ereignisprotokolle. Die Tabelle bezieht sich auf die dokumentierte Bedienung der jeweiligen CLI, meine Erfahrungen stammen nur aus dem Einsatz von Muse bei LogCarve.
| Aufgabe | Muse Code | Claude Code | Codex |
|---|---|---|---|
| CLI Start | muse |
claude |
codex |
| Prompt aus Datei, Ereignisse als JSONL | muse exec --json --prompt-file aufgabe.txt |
claude -p --verbose --output-format stream-json < aufgabe.txt |
codex exec --json - < aufgabe.txt |
| Letzte Sitzung fortsetzen | muse resume --last |
claude --continue |
codex resume --last |
| Planen und prüfen | /plan, /grill zum Hinterfragen eines Entwurfs |
/plan oder --permission-mode plan |
/plan, /review für Code-Reviews |
| Modell und Reasoning wählen | --model, --reasoning-effort medium |
--model, --effort medium |
-m, -c 'model_reasoning_effort="medium"' |
| Projektanweisungen | AGENTS.md im vertrauten Workspace |
CLAUDE.md, ohne CLAUDE.md auch AGENTS.md |
AGENTS.md |
| Werkzeugzugriff steuern | Approval-Modus und Shell-Sandbox | Permission-Modes, /permissions und Sandbox-Einstellungen |
Sandbox-Modus und Approval-Policy |
Die Angaben stammen aus den jeweiligen Help- bzw. Doku-Dokumenten. Wie ich die Permission-Modes in Claude Code handhabe, steht in meinem Text zum Auto Mode.
Für die späteren Korrekturen war es praktisch, einen abgegrenzten Auftrag per --prompt-file zu starten und mit --max-model-steps zu begrenzen. Im Ereignisprotokoll konnte ich dann nachvollziehen, welche Werkzeuge gelaufen waren. Freigegeben habe ich einen Stand trotzdem nur anhand der geprüften Änderungen und der dokumentierten Testergebnisse. Der Exit-Code von muse exec sagt laut Doku lediglich, wie ein Lauf geendet hat. Ob die Arbeit stimmt, zeigen die Tests.
Mein Take nach zehn Tagen
Muse Code ist am Ende ein gut funktionierender Coding-Agent, der mir zusammen mit Muse Spark 1.3 weniger Kopfschmerzen bereitet hat, als ich im Vorfeld befürchtet hatte. Das Modell, also Muse Spark 1.3, arbeitet flott, ist nicht so eine Labertasche und sowohl für Logs, SQLite und eine FastAPI-App hat mir Wonder an keiner Stelle gefehlt. Mitnehmen werde ich vor allem /grill, weil das Interview offene Punkte geklärt hat, bevor sie im Code teuer geworden wären.
Offen ist aktuell noch die native Installation auf Linux x86-64. Wie LogCarve im Detail funktioniert, folgt in einem eigenen Artikel.