LLM-Datenformate: Wie man mit einem Modell spricht – und in welcher Sprache es antwortet
Es ist eine Geschichte voller Leiden, voller langer Tage und noch viel längerer Nächte. Wer in jüngerer Vergangenheit um drei Uhr morgens debuggt hat, warum
Wie man Modelle so füttert, dass etwas Brauchbares rauskommt. Prompt-Strategien, Context-Engineering und der Aufbau verlässlicher KI-Systeme.
17 Beiträge
Es ist eine Geschichte voller Leiden, voller langer Tage und noch viel längerer Nächte. Wer in jüngerer Vergangenheit um drei Uhr morgens debuggt hat, warum
Das Modell soll vor der Antwort kurz planen, Annahmen offenlegen, Edge Cases benennen. Klingt vernünftig – und war es lange auch. Stand Juni 2026 ist die
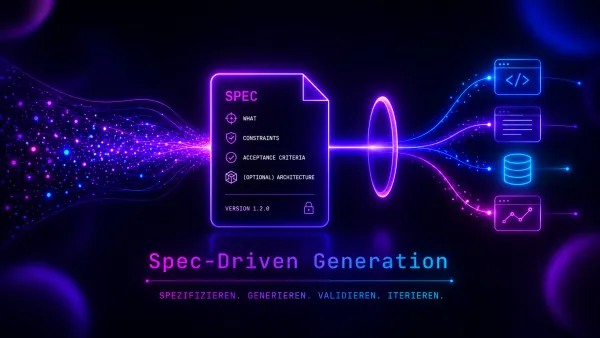
Das wird etwas länger heute – die Recherche war sehr ergiebig und obendrauf kann ich auch noch reichlich eigene Erfahrungswerte beisteuern. Der Holzhammer kurz und bündig:
Ich schreibe diesen Beitrag nicht, weil Persona Prompting ein neues Thema wäre. Ich schreibe ihn, weil die Empfehlung, einem LLM eine Expertenrolle zuzuweisen, in den
CBP: Die Technik, die uns bis Anfang 2025 noch den Popo gerettet hat und nun manchmal im Weg steht. Constraint-Based Prompting, kurz CBP, gehört
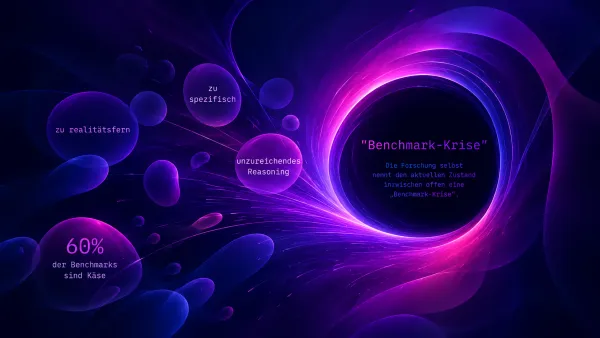
Vorweg: Meine Ausgangsthese war, dass rund 60% der Benchmarks, die zum Vergleich von LLMs herangezogen werden, Käse sind – zu realitätsfern, zu spezifisch, oder bei Reasoning
Ich habe letzte Woche Gemini gebeten, Text-Assets für Google Ads zu generieren. Input: strukturiertes JSON mit Persona, Zielgruppe, USPs, etc. – sauber gebriefed, nichts vergessen